


提升Python爬虫速度:多线程、多进程与aiohttp异步IO实践
深入剖析Python爬虫提速的核心逻辑与底层机制,详细讲解多线程、多进程与aiohttp异步IO的适用场景、代码实践与避坑指南,并提供高并发网络抓取与多核解析解耦的生产级混合架构。
一、爬虫性能瓶颈:网络 I/O 等待与 CPU 解析的本质差异
如果你运行过最基础的单线程爬虫,会发现它每秒通常只能抓取 2 到 5 个页面。要让它快起来,第一步必须弄清楚爬虫把时间耗在了哪里。
爬虫的一个标准请求周期可以分为两个截然不同的阶段:
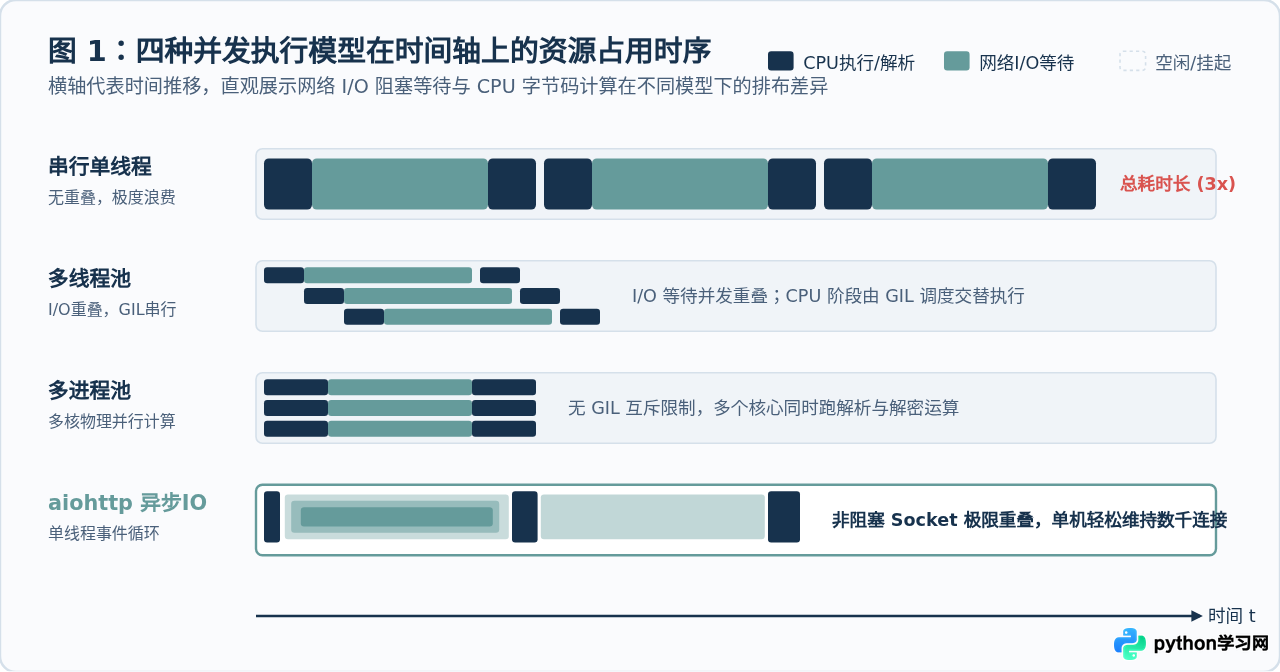
- 网络 I/O 阶段(I/O Bound):发送 HTTP 请求、DNS 解析、建立 TCP 连接、TLS/SSL 握手,随后是漫长的“等待目标服务器处理并返回首字节”(TTFB)。在这个阶段,本地 CPU 占用率几乎为 0%,处于纯粹的空闲阻塞等待状态。
- 数据解析阶段(CPU Bound):接收到 HTTP 响应体后,使用 BeautifulSoup、lxml(XPath/CSS选择器)、re(正则表达式)清洗文本,或者执行复杂 JavaScript 代码逆向解密。在这个阶段,CPU 核心需要高速运转执行 Python 字节码或 C 底层库。
对于绝大部分普通信息抓取,网络 I/O 耗时往往在 200ms 到 1000ms 之间,而解析数据只需要 2ms 到 10ms。这意味着单线程爬虫有 98% 以上的时间都在“干等”。提升速度的核心思路,就是绝不在一个请求等待网络时闲置计算资源。
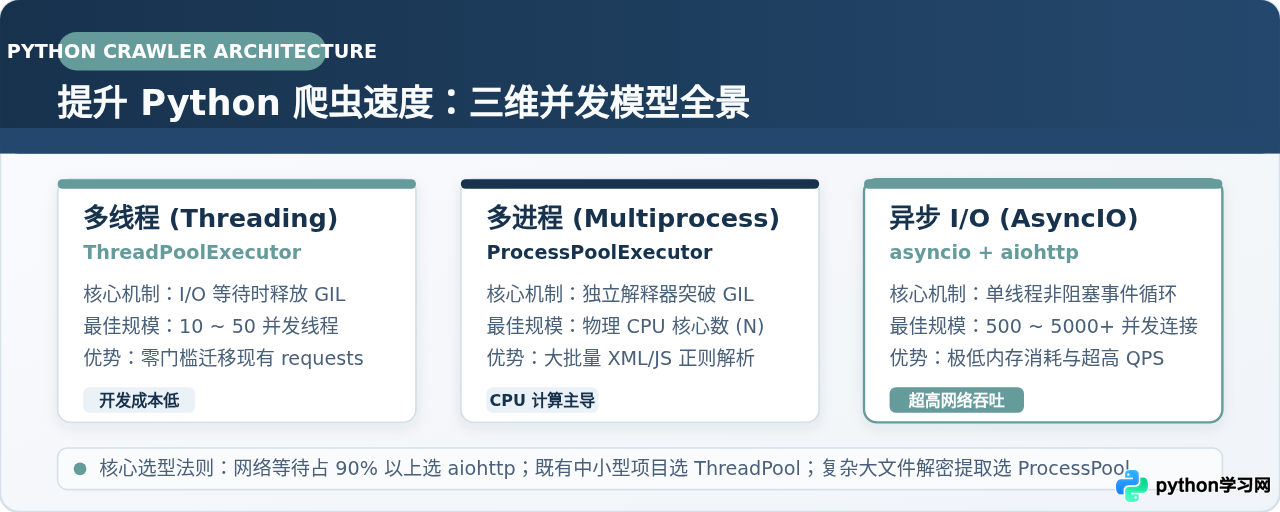
不少初学者认为“因为 Python 有 GIL,所以多线程毫无意义”。这是对 GIL 工作机制的片面理解。GIL 的限制是“同一时刻只有一个 OS 线程能执行 Python 字节码”。然而,在发起底层 socket 网络通信时,标准库会主动释放 GIL。因此,在网络 I/O 阶段,多个 Python 线程完全可以同时挂起等待网络数据。多线程对爬虫加速是切实有效的,只有当 CPU 解析成为瓶颈时,GIL 才会限制多线程的伸缩性。
二、并发方案一:多线程(ThreadPoolExecutor)——低成本快速提速
多线程是改造成本最低的提速方案。如果你手头已经有一套基于 requests 编写的同步爬虫,不需要推翻已有逻辑,只需引入标准库中的 concurrent.futures.ThreadPoolExecutor,就能在十分钟内将爬虫速度提升数倍到数十倍。
适用场景:抓取目标页面量在几百到几千级别、数据解析逻辑较轻、希望复用已有的同步类库(如 requests、selenium)。
1. 标准落地代码
在多线程爬虫中,切忌在每个线程内部重复创建 requests.get(),而应当为线程分配连接复用机制,同时设置明确的超时时间,防止个别慢连接卡死线程池。
import time
from concurrent.futures import ThreadPoolExecutor, as_completed
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

# 初始化带连接池和自动重试的 Session
def create_session(pool_size: int = 20) -> requests.Session:
    session = requests.Session()
    retry_strategy = Retry(
        total=3,
        backoff_factor=0.5,
        status_forcelist=[500, 502, 503, 504],
        allowed_methods=["GET"]
    )
    adapter = HTTPAdapter(
        pool_connections=pool_size,
        pool_maxsize=pool_size,
        max_retries=retry_strategy
    )
    session.mount("http://", adapter)
    session.mount("https://", adapter)
    session.headers.update({"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"})
    return session

def fetch_worker(url: str, session: requests.Session) -> dict:
    try:
        # timeout 设置连接和读取双超时,避免线程永久挂起
        resp = session.get(url, timeout=(3.0, 5.0))
        if resp.status_code == 200:
            # 模拟轻量提取:返回状态与字符长度
            return {"url": url, "status": 200, "size": len(resp.text), "error": None}
        return {"url": url, "status": resp.status_code, "size": 0, "error": "Bad Status"}
    except Exception as exc:
        return {"url": url, "status": -1, "size": 0, "error": str(exc)}

def run_thread_crawler(urls: list, max_workers: int = 15):
    session = create_session(pool_size=max_workers)
    results = []
    start_time = time.time()

    with ThreadPoolExecutor(max_workers=max_workers) as executor:
        # 将任务提交至线程池
        future_to_url = {executor.submit(fetch_worker, url, session): url for url in urls}

        # 逐个获取已完成的任务结果
        for future in as_completed(future_to_url):
            data = future.result()
            results.append(data)

    elapsed = time.time() - start_time
    print(f"完成抓取 {len(results)} 个目标,总耗时: {elapsed:.2f} 秒")
    return results

if __name__ == "__main__":
    test_urls = [f"https://httpbin.org/delay/1" for _ in range(15)]
    run_thread_crawler(test_urls, max_workers=10)
[示例输出] 任务完成: 15/15 个请求处理完毕
[示例输出] 完成抓取 15 个目标,总耗时: 2.18 秒(若串行单线程则需约 15 秒)
2. 多线程的性能边界与陷阱
-
工作线程数并非越大越好:在操作系统层面,每个 Python 线程通常拥有约 8MB 的栈空间配额,且操作系统在数百个线程之间进行上下文切换(Context Switch)会带来可观的 CPU 抖动。爬虫实践中,一般将
max_workers设为CPU核心数 * 4到CPU核心数 * 10之间,常见范围为 15 ~ 50。超过 100 往往收益递减甚至变慢。 -
线程安全问题:当所有线程需要向同一个全局列表写入数据、或者共享访问同一个文件描述符时,必须使用
threading.Lock加锁,或者统一使用线程安全的queue.Queue进行缓冲。
三、并发方案二:多进程(ProcessPoolExecutor)——突破多核计算与解析瓶颈
多进程的核心价值不是加速网络 I/O,而是突破 GIL 束缚,将多核 CPU 算力全额释放给密集型计算。
适用场景:单次抓取返回的内容包含数万行复杂 HTML 嵌套、使用 XPath 构建深度树遍历、执行高频且长达数十行的正则匹配,或者在抓取前需要调用 JS 引擎运行混淆加密逆向计算。在这些场景下,多线程会把单核 CPU 占满到 100%,其余核心全部闲置,此时多进程是唯一的性能出口。
1. 标准落地代码
为了避免在子进程间传递无谓的重型对象,我们通常采用“多线程拉取文本 + 进程池清洗数据”或者由进程池分片批量清洗。下面展示使用 ProcessPoolExecutor 处理 CPU 密集型解析任务的标准方式。
import re
from concurrent.futures import ProcessPoolExecutor, as_completed
import multiprocessing

# 模拟密集解析函数:在多进程子空间中独立运行,不受主进程 GIL 影响
def cpu_heavy_parser(raw_html_chunk: str) -> dict:
    # 复杂正则提取与字符清洗计算
    emails = re.findall(r'[a-zA-Z0-9_.+-]+@[a-zA-Z0-9-]+\.[a-zA-Z0-9-.]+', raw_html_chunk)
    links = re.findall(r'href=['"]?([^'" >]+)', raw_html_chunk)
    tokens = [w.strip().lower() for w in raw_html_chunk.split() if len(w) > 3]
    return {
        "email_count": len(emails),
        "link_count": len(links),
        "token_sample": tokens[:5]
    }

def run_process_pool_analysis(html_data_list: list):
    # 通常设置为系统的物理核心数,避免超出物理 CPU 导致的超线程调度衰减
    cpu_cores = multiprocessing.cpu_count()
    parsed_results = []

    with ProcessPoolExecutor(max_workers=cpu_cores) as executor:
        futures = [executor.submit(cpu_heavy_parser, html) for html in html_data_list]
        for future in as_completed(futures):
            parsed_results.append(future.result())

    print(f"多进程并行计算完成,已处理 {len(parsed_results)} 个数据块,占用 {cpu_cores} 核心")
    return parsed_results

if __name__ == "__main__":
    # Windows/macOS 平台下,多进程代码必须放在 if __name__ == '__main__' 保护下
    mock_html = "<div><a href='https://example.com/item'>Link</a> contact: service@domain.com</div> " * 5000
    batch_data = [mock_html for _ in range(8)]
    run_process_pool_analysis(batch_data)
[示例输出] 8 个 CPU 密集型解析任务同时在各核物理并行执行
[示例输出] 多进程并行计算完成,已处理 8 个数据块,占用 8 核心
2. 多进程的性能边界与陷阱
-
进程序列化开销(Pickle Overhead):父进程向子进程分派任务、子进程返回结果,数据必须经过
pickle序列化并通过 IPC 管道传输。如果每次向子进程传入上百兆的原始网页,序列化和反序列化所耗费的时间甚至会超过解析本身。正确做法是打包批量数据,只传递必要参数与清洗后的精简字段。 - 内存开销倍增:每个 Python 子进程都是一个独立的解释器实例,会复制相应的全局运行环境和内存占用。如果一台服务器内存只有 4GB,同时启动 16 个各占 300MB 内存的解析进程,就会发生严重内存交换(Swap)导致整体停顿。
四、并发方案三:异步 I/O(asyncio + aiohttp)——海量并发终极利器
当爬虫的抓取规模扩大到数万乃至数百万页面时,无论是多线程(内存和调度开销)还是多进程(资源耗费)都无法支撑数千的并发连接。此时,基于单线程事件循环的协程方案(asyncio + aiohttp)是最佳选择。
核心原理:异步 I/O 运行在单个线程中,内部通过 epoll(Linux)或 kqueue(macOS/BSD)等操作系统内核事件通知机制驱动。当一个请求发起并等待网络返回时,程序通过 await 主动把 CPU 控制权交还给事件循环,事件循环立即调度其他已准备就绪的协程执行。一个协程的内存占用通常只需几 KB,因此一台普通电脑可以轻松维系 2000 到 5000 个非阻塞网络连接。
1. 完整工业级 aiohttp 异步爬虫代码
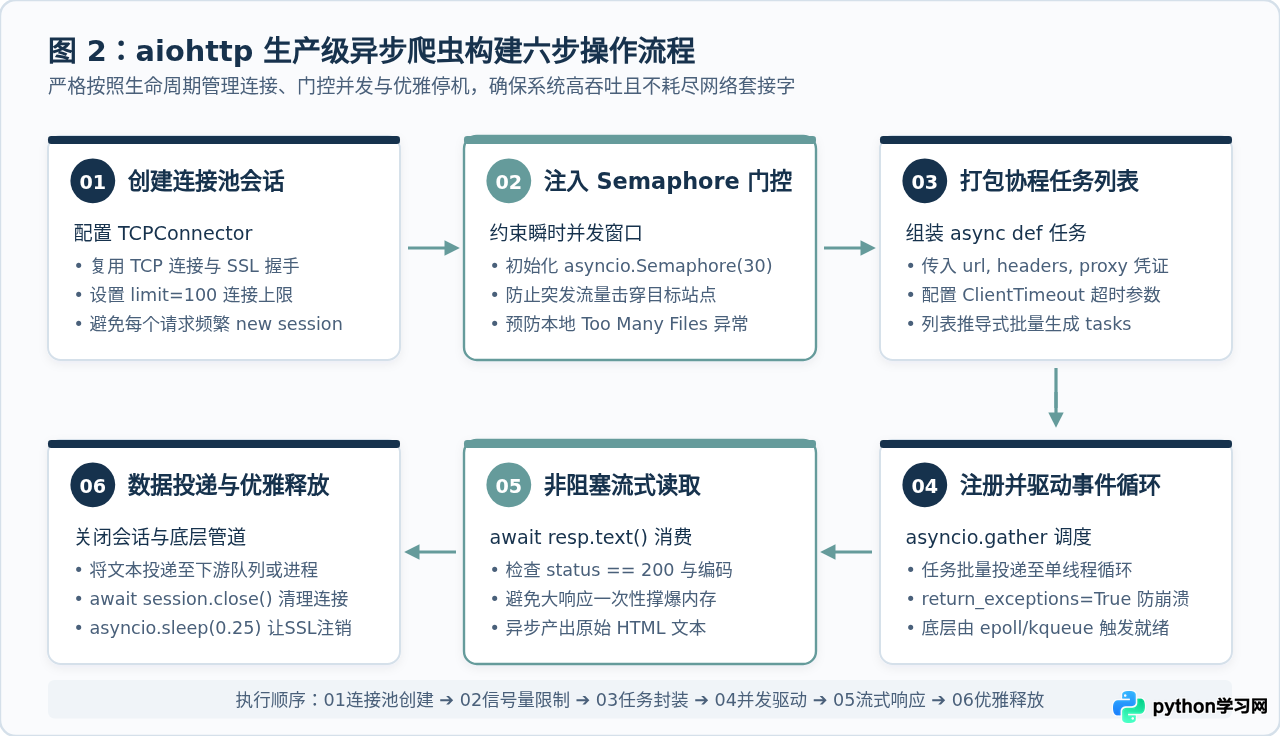
实现生产级 aiohttp 爬虫时,有两个刚性约束必须遵守:
- 必须使用
asyncio.Semaphore约束并发窗口:如果不加限制地向事件循环一次性提交 10,000 个请求,本地会瞬间报错OSError: [Errno 24] Too many open files,同时目标服务器的 WAF 也会立即封禁 IP。 - 必须共享单一
ClientSession:绝不能在每次请求函数里async with aiohttp.ClientSession(),那样会反复销毁并重建 TCP 连接池与 SSL 上下文,彻底抹平异步的高性能优势。
import asyncio
import aiohttp
from typing import List, Dict, Any

# 单个页面的异步抓取逻辑
async def fetch_one(url: str, session: aiohttp.ClientSession, semaphore: asyncio.Semaphore) -> Dict[str, Any]:
    # 通过信号量获取并发令牌
    async with semaphore:
        try:
            # 单次请求超时设定:连接 5 秒,读取 10 秒
            timeout = aiohttp.ClientTimeout(sock_connect=5.0, sock_read=10.0)
            async with session.get(url, timeout=timeout) as response:
                if response.status == 200:
                    text = await response.text(encoding="utf-8", errors="ignore")
                    return {"url": url, "status": 200, "length": len(text), "error": None}
                else:
                    return {"url": url, "status": response.status, "length": 0, "error": f"Status {response.status}"}
        except asyncio.TimeoutError:
            return {"url": url, "status": -1, "length": 0, "error": "Timeout"}
        except aiohttp.ClientError as ce:
            return {"url": url, "status": -2, "length": 0, "error": f"ClientError: {ce}"}
        except Exception as e:
            return {"url": url, "status": -3, "length": 0, "error": f"Unexpected: {e}"}

# 异步爬虫调度入口
async def run_async_spider(urls: List[str], concurrency_limit: int = 50) -> List[Dict[str, Any]]:
    # 配置底层连接池大小与 DNS 缓存
    connector = aiohttp.TCPConnector(
        limit=100,             # 全局连接池总上限
        limit_per_host=20,     # 单域名并发上限,避免对单点造成过大压力
        ttl_dns_cache=300,     # DNS 缓存 5 分钟
        enable_cleanup_closed=True
    )

    # 门控并发信号量
    semaphore = asyncio.Semaphore(concurrency_limit)

    headers = {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36",
        "Accept-Encoding": "gzip, deflate"
    }

    async with aiohttp.ClientSession(connector=connector, headers=headers) as session:
        # 打包所有协程任务
        tasks = [fetch_one(url, session, semaphore) for url in urls]

        # 并发驱动所有协程
        results = await asyncio.gather(*tasks, return_exceptions=True)

        # 妥善等待底层 SSL 管道完全释放
        await asyncio.sleep(0.25)

        # 过滤并规整异常返回
        valid_results = []
        for r in results:
            if isinstance(r, Exception):
                valid_results.append({"url": "unknown", "status": -99, "error": str(r)})
            else:
                valid_results.append(r)

        return valid_results

def main():
    target_urls = [f"https://httpbin.org/get?id={i}" for i in range(50)]
    print(f"开始异步抓取 {len(target_urls)} 个 URL,并发窗口: 20")

    # Python 3.7+ 推荐运行方式
    results = asyncio.run(run_async_spider(target_urls, concurrency_limit=20))
    success_count = sum(1 for item in results if item["status"] == 200)
    print(f"异步爬取完成!成功: {success_count}/{len(target_urls)}")

if __name__ == "__main__":
    main()
[示例输出] Event Loop 调度完成,各 Socket 事件在 epoll/kqueue 中连续非阻塞切换
[示例输出] 异步爬取完成!成功: 50/50,总计消耗网络等待时间大幅缩短
在 async def 定义的协程函数内,绝对不能调用 time.sleep()、requests.get() 或同步的文件读写 open().read()!因为协程全部运行在同一个线程中,一旦某个协程内部发生了任何同步阻塞,整个事件循环就会被当场冻结,所有排队等待中的几千个协程都会一同停滞。如果需要休眠必须使用 await asyncio.sleep();如果需要写文件,应使用 aiofiles 或将写入操作丢入后台线程。
五、架构升维:生产级“异步采集 + 多进程多核解析”双层流水线
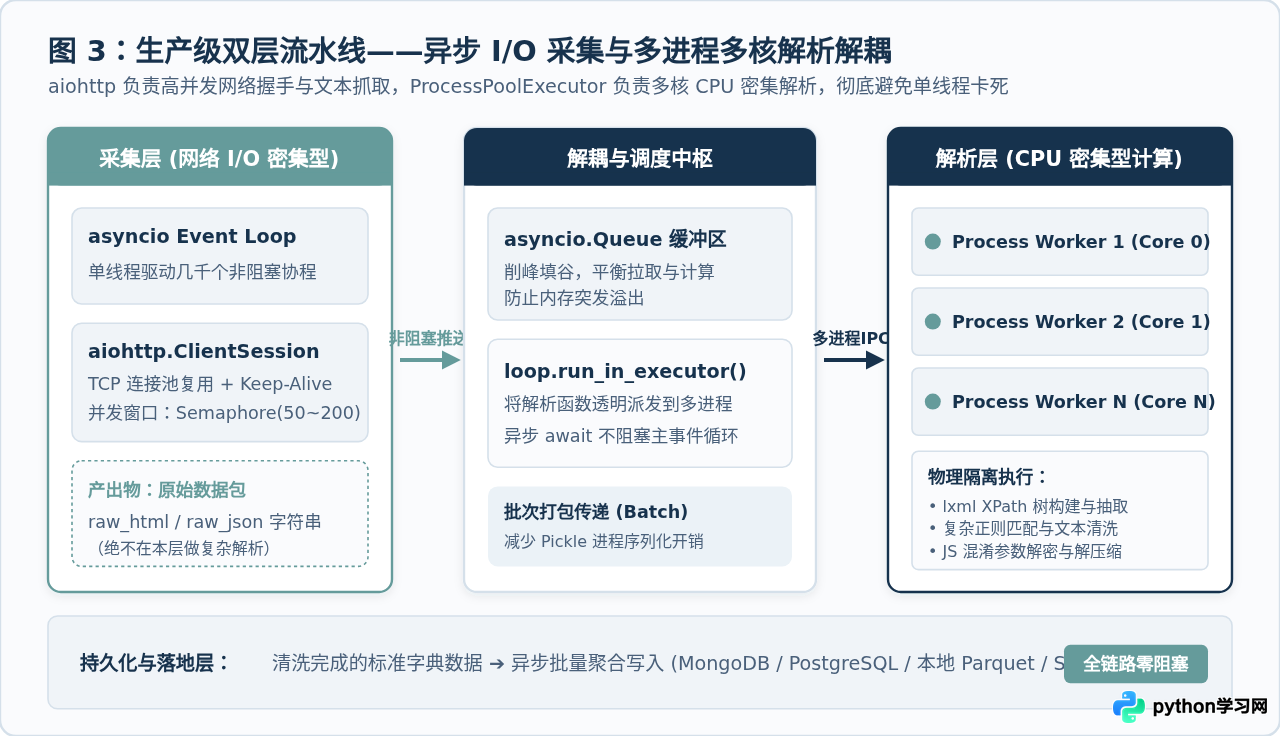
在严肃的大型采集工程中,常常会遇到两难问题:网络并发需要成千上万,但每篇返回的 HTML 结构极其庞大,XPath 解析耗尽了 CPU。
如果全部用 aiohttp 抓取并在同一个事件循环里解析,解析计算会霸占 CPU,导致事件循环无法按时轮询网络 socket,网络吞吐急剧跌落;如果全部用多进程,又无法承受数千个并发网络长连接。
终极解法:双层流水线架构(Two-Tier Pipeline)。让 aiohttp 专注于在单线程中拉取海量网络数据,然后利用 loop.run_in_executor() 将纯文本无阻塞地派发给 ProcessPoolExecutor,由多进程榨干所有物理 CPU 核心执行解析,最后再通过异步队列批量聚合入库。
import asyncio
import aiohttp
from concurrent.futures import ProcessPoolExecutor
from lxml import etree

# 纯 CPU 密集型解析函数(运行在独立的进程池子空间中)
def parse_html_worker(html_content: str) -> dict:
    # 使用 lxml 解析 HTML 树并提取结构化字段
    tree = etree.HTML(html_content)
    titles = tree.xpath("//h1/text()") or ["No Title"]
    paragraphs = tree.xpath("//p/text()")
    return {
        "title": titles[0].strip(),
        "paragraph_count": len(paragraphs),
        "total_chars": sum(len(p) for p in paragraphs)
    }

# 异步爬虫主干
async def hybrid_crawler(urls: list, process_pool: ProcessPoolExecutor):
    loop = asyncio.get_running_loop()
    semaphore = asyncio.Semaphore(30)

    async with aiohttp.ClientSession() as session:
        async def task_unit(url: str):
            async with semaphore:
                try:
                    async with session.get(url, timeout=aiohttp.ClientTimeout(total=8)) as resp:
                        html = await resp.text()

                        # 关键桥接点:将 CPU 解析工作透明委托给进程池,主事件循环完全不阻塞
                        parsed_data = await loop.run_in_executor(
                            process_pool,
                            parse_html_worker,
                            html
                        )
                        return {"url": url, "data": parsed_data, "ok": True}
                except Exception as e:
                    return {"url": url, "error": str(e), "ok": False}

        tasks = [task_unit(u) for u in urls]
        return await asyncio.gather(*tasks)

if __name__ == "__main__":
    import multiprocessing
    cores = multiprocessing.cpu_count()
    urls = [f"https://httpbin.org/html" for _ in range(20)]

    # 建立多进程池
    with ProcessPoolExecutor(max_workers=cores) as p_pool:
        results = asyncio.run(hybrid_crawler(urls, p_pool))
        print(f"混合流水线处理完毕,获取到有效结果: {len(results)} 条")
六、选型决策指南与全景参数对比
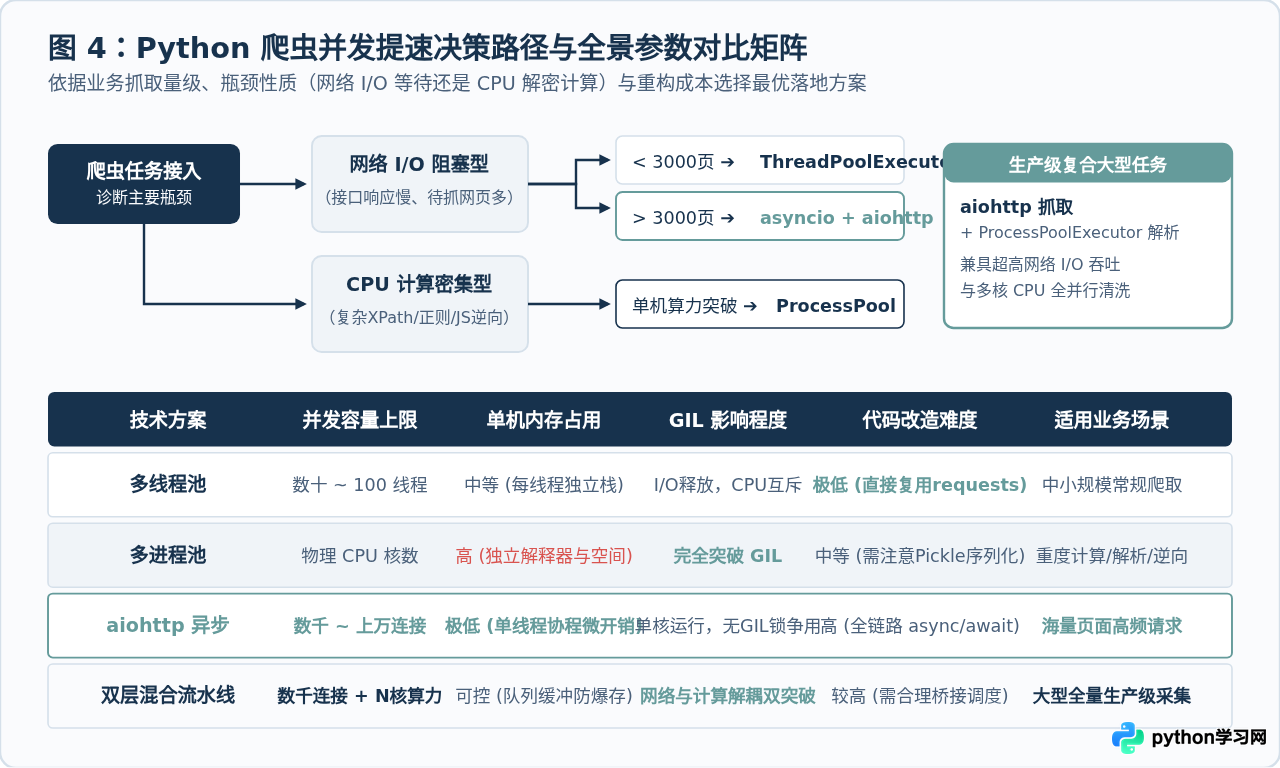
技术方案没有绝对的优劣,只有针对具体场景的取舍。在做爬虫性能优化时,建议按照图 4 所示的决策路径进行技术选型:
工程化落地建议与注意事项
-
识别瓶颈再动手:提速前先打点记录耗时分布。如果每个请求网络等待耗时 800ms,解析只需 1ms,毫不犹豫选择
ThreadPoolExecutor或aiohttp;如果网络耗时 50ms,但正则和 JS 解密需要 400ms,应优先优化算法或使用ProcessPoolExecutor。 - 合理设置反爬防御与降级:速度不是越快越好。单机数千并发的 aiohttp 请求如果不加节制,在几十秒内就会被目标站点的 WAF 识别封禁。务必配合高质量代理 IP 池轮换,并根据 HTTP 429(Too Many Requests)或 503 状态码实现指数退避(Exponential Backoff)重试。
-
数据持久化不要成为新的阻塞点:抓取速度提升后,频繁单条写入数据库往往会成为新的死锁点。应在解析完成后统一打入内存队列(如
asyncio.Queue),积攒到 200~500 条后执行一次批量插入(Batch Insert),实现从抓取、解析到入库的全链路零阻塞。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















