


Python高性能数学计算技巧:为何向量化比for循环更快
深入解析Python中向量化运算(NumPy)与for循环在数学计算中的性能差异,通过原理分析、代码示例和基准测试,帮助你掌握高性能计算的核心技巧。
用Python做数学计算时,把 for 循环替换成NumPy的向量化操作,通常能获得10倍到上百倍的加速。这篇文章解释为什么会有这么大的差距,并用可运行的代码展示如何在实际场景中使用向量化。
一、一个直观的对比
假设我们要计算100万个数的平方和。先看最直觉的写法——用 for 循环逐个累加:
import time

n = 1_000_000
data = list(range(n))

start = time.perf_counter()
total = 0
for x in data:
    total += x * x
elapsed_loop = time.perf_counter() - start
print(f"for循环: {total}, 耗时 {elapsed_loop:.4f}s")
再看向量化版本:
import numpy as np

arr = np.arange(n, dtype=np.int64)

start = time.perf_counter()
total_vec = np.sum(arr * arr)
elapsed_vec = time.perf_counter() - start
print(f"向量化: {total_vec}, 耗时 {elapsed_vec:.4f}s")
在一台普通笔记本上(Python 3.11,NumPy 1.26),典型结果大致是:
| 方式 | 耗时(示例) | 倍率 |
|---|---|---|
| for循环 | ~0.12 s | 1× |
| NumPy向量化 | ~0.002 s | ~60× |
差距来自哪里?不是算法不同——两种方式做的计算完全一样——而是执行过程的底层效率截然不同。
二、for循环为什么慢:Python的逐元素开销
Python是动态类型、解释执行的语言。在 for 循环中每处理一个元素,解释器需要做很多额外工作:
- 类型检查:每次执行
x * x,Python都要查看x是什么类型,找到该类型的乘法方法,再调用。 - 对象封装:Python中每个数值(即使是整数1)都是一个堆上的对象,包含引用计数、类型指针等元信息,占用28字节以上。每次运算都涉及对象创建和销毁。
- 字节码分派:每条Python语句被编译成多条字节码指令,每条指令都要经过解释器的主循环(eval loop)分派,这个循环本身有固定开销。
- 内存不连续:Python的
list存储的是对象指针,实际数据散落在堆上不同位置,CPU缓存命中率很低。
这些开销对单次操作来说微不足道,但循环100万次,每次都重复这些步骤,累积起来就变得显著。
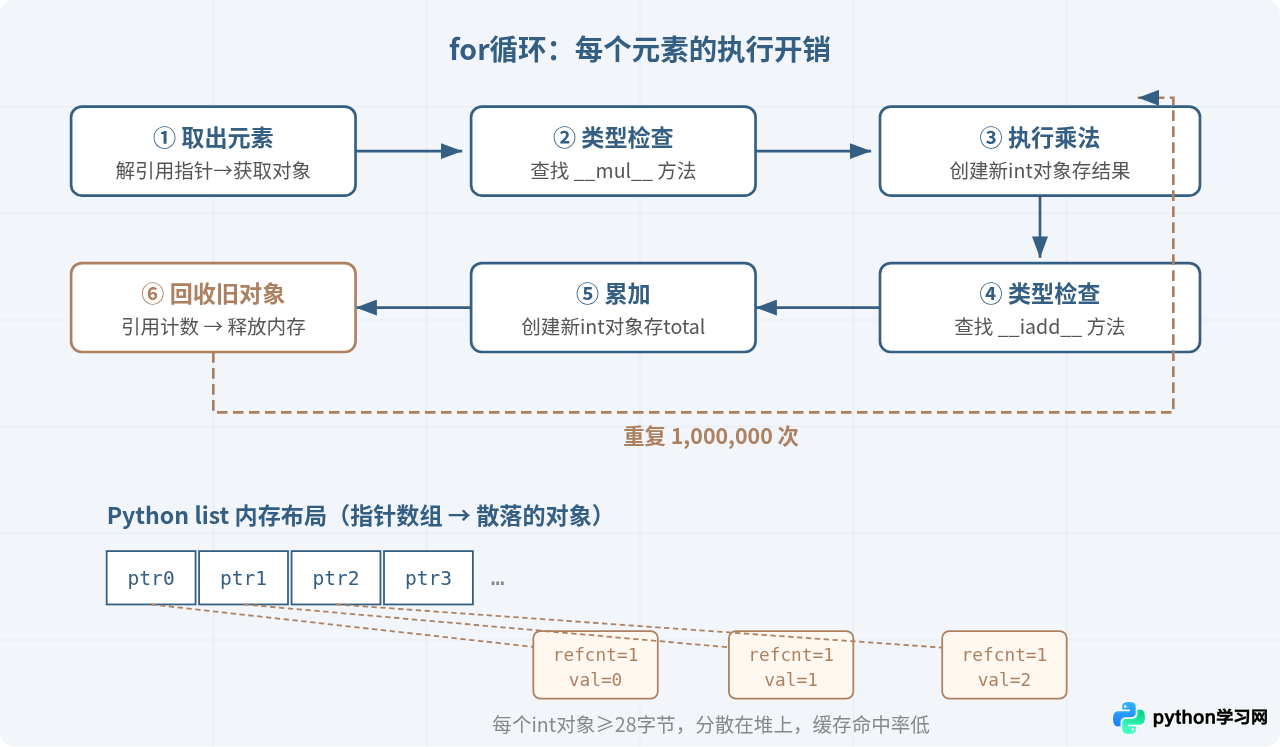
图1:for循环中每个元素经历的完整处理流程及Python list的内存布局
三、向量化为什么快:把循环交给C
NumPy的核心思路是:在Python层面只调用一次函数,把整个数组的循环交给底层编译好的C/Fortran代码去执行。这消除了上面提到的所有逐元素开销:
3.1 连续内存与SIMD
NumPy数组(ndarray)在内存中是一块连续的、类型统一的原始数据缓冲区。一个包含100万个 int64 的数组,就是一段连续的8MB内存,没有任何额外的对象头、引用计数或类型指针。
这种布局有两个直接的性能优势:
- 缓存友好:CPU从内存读取数据时以缓存行(通常64字节)为单位。连续内存意味着读一次就能拿到8个
int64,而Python列表需要先读指针再跳转到散落的对象。 - SIMD指令:现代CPU支持单条指令处理多个数据(例如AVX2一次处理4个64位整数)。NumPy在编译时会启用这些指令,让一条CPU指令完成4个甚至更多元素的运算。
3.2 消除解释器开销
当你写 arr * arr 时,Python解释器只做一件事:调用 ndarray.__mul__ 方法。之后的100万次乘法全部在C代码中的一个紧凑循环里完成,没有类型检查、没有对象创建、没有字节码分派。
可以简单理解为:for 循环是"在Python里做100万次小事",向量化是"用Python说一句话,让C做完100万件事"。
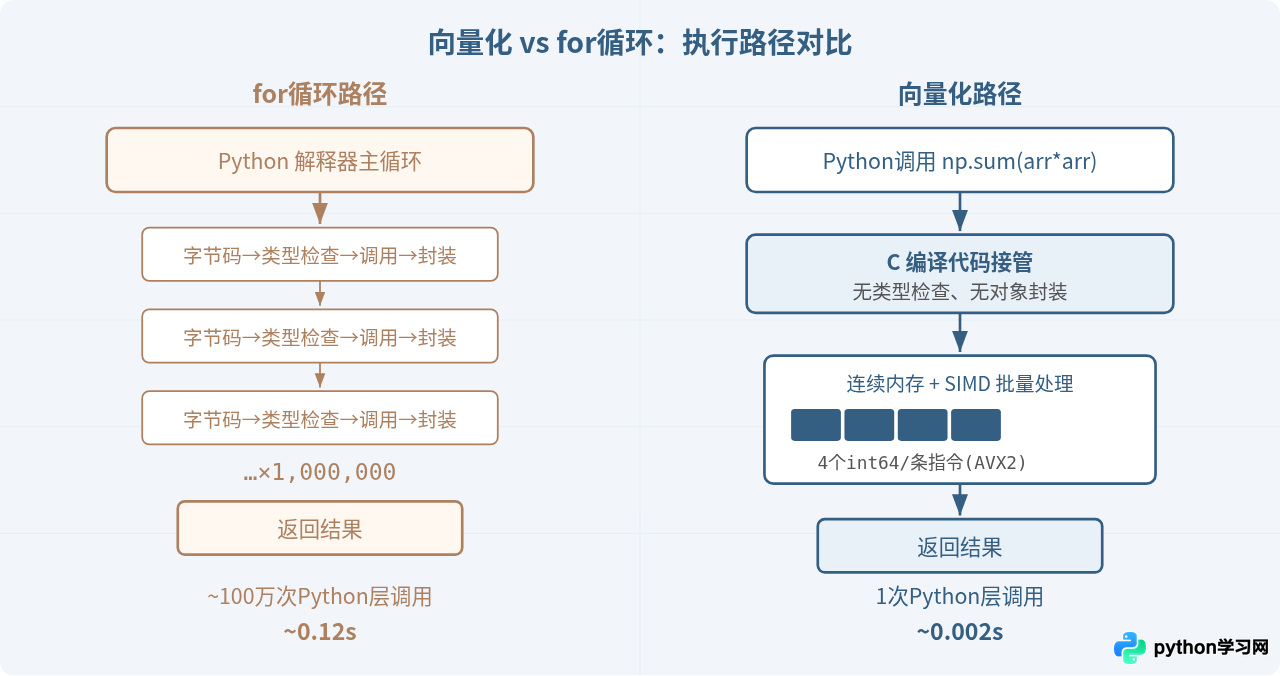
图2:for循环与向量化在执行路径上的根本区别
四、常见场景的向量化改写
了解原理之后,看看几个实用的改写模式。
4.1 逐元素运算
这是最简单的情况。凡是对数组中每个元素做相同数学运算的 for 循环,几乎都可以直接替换:
# 慢:for循环
result = []
for x in data:
    result.append(x ** 2 + 2 * x + 1)

# 快:向量化
arr = np.array(data)
result = arr ** 2 + 2 * arr + 1
NumPy会对整个数组逐元素执行表达式中的每一步运算,返回同形状的新数组。
4.2 条件筛选
用 for 循环加 if 筛选元素,可以用布尔索引替代:
# 慢
selected = []
for x in data:
    if x > 0 and x < 100:
        selected.append(x)

# 快
arr = np.array(data)
selected = arr[(arr > 0) & (arr < 100)]
注意NumPy中用 & 代替 and,用 | 代替 or,条件表达式需要加括号。
4.3 聚合计算
求和、均值、最大值、标准差等统计运算,NumPy都有对应的向量化函数:
arr = np.random.randn(1_000_000)

# 这些都比手写for循环快很多
total = np.sum(arr)
mean = np.mean(arr)
std = np.std(arr)
max_val = np.max(arr)

# 按条件聚合
positive_mean = np.mean(arr[arr > 0])
4.4 矩阵和线性代数
矩阵乘法用 @ 运算符或 np.dot,底层调用BLAS库(如OpenBLAS或MKL),速度远超嵌套循环:
A = np.random.randn(500, 500)
B = np.random.randn(500, 500)

# 一行完成500×500矩阵乘法
C = A @ B
手写三层嵌套 for 循环做同样的矩阵乘法,在这个规模下通常需要几十秒,而 A @ B 只需要几毫秒。
五、向量化的边界与注意事项
向量化不是万能的。了解它的适用边界,才能做出正确的技术选择。
什么时候向量化效果不好
- 数据量很小:数组只有几十个元素时,NumPy函数调用本身的固定开销(参数解析、内存分配、结果封装)可能比计算本身更大。此时for循环反而可能更快或差距可以忽略。
- 计算有前后依赖:如果第
i步的计算依赖第i-1步的结果(比如递推公式),就无法简单并行化。虽然有些情况可以通过np.cumsum、np.cumprod或分段技巧转化,但复杂的递推关系往往需要其他工具(如Numba)。 - 内存不够:向量化通常需要把整个数组加载到内存,还会创建中间数组。如果数据超出可用内存,需要分块处理或使用其他方案。
中间数组的内存开销
一个容易忽视的问题是中间数组。例如:
result = np.sqrt(arr ** 2 + brr ** 2)这行代码实际上创建了三个中间数组:arr ** 2、brr ** 2 和两者之和。对于大数组,可以用 np.add、np.multiply 的 out 参数原地计算来减少内存占用:
temp = np.empty_like(arr)
np.multiply(arr, arr, out=temp)       # temp = arr²
np.multiply(brr, brr, out=result)     # result = brr²(复用result)
np.add(temp, result, out=result)      # result = arr² + brr²
np.sqrt(result, out=result)           # result = sqrt(arr² + brr²)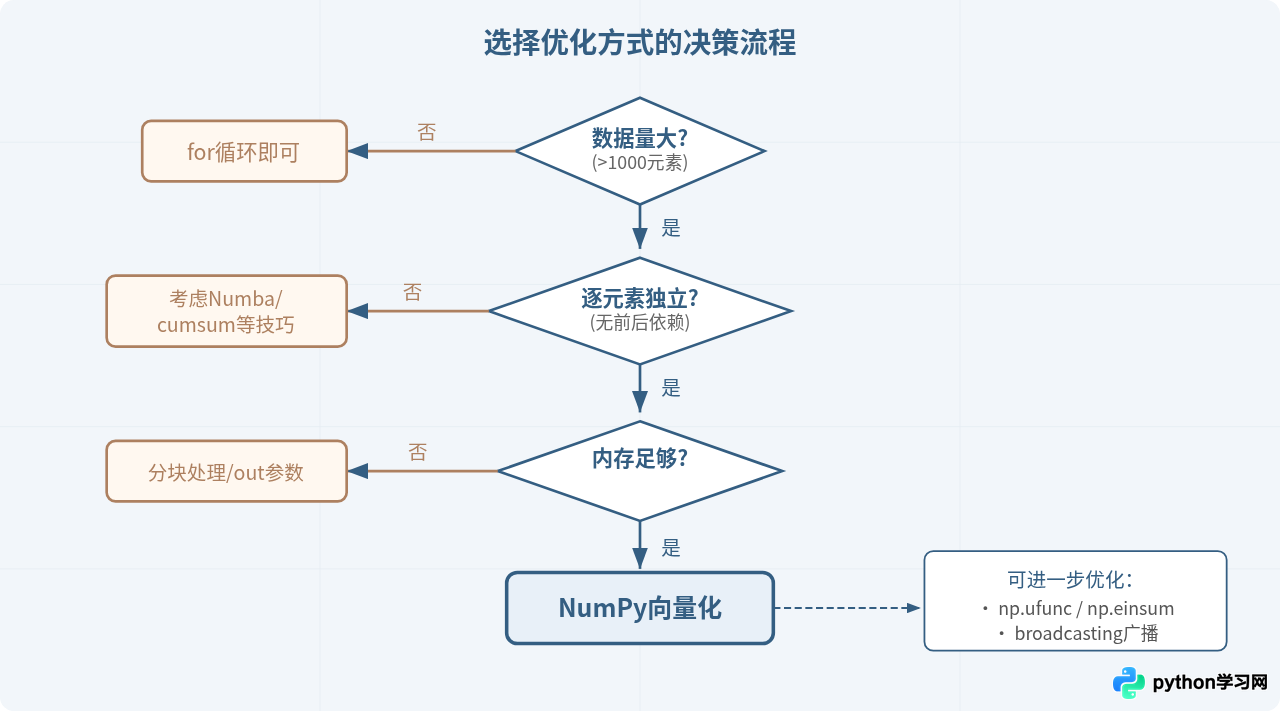
图3:根据实际情况选择优化方式的决策流程
六、一个完整的基准测试
下面的脚本对比了不同数据规模下两种方式的耗时,可以直接复制运行:
import numpy as np
import time

def benchmark(sizes):
    print(f"{'数据量':>12} {'for循环(s)':>12} {'向量化(s)':>12} {'加速比':>8}")
    print("-" * 48)
    for n in sizes:
        data_list = list(range(n))
        data_arr = np.arange(n, dtype=np.float64)

        # for循环
        start = time.perf_counter()
        total = 0.0
        for x in data_list:
            total += x * x
        t_loop = time.perf_counter() - start

        # 向量化
        start = time.perf_counter()
        _ = np.sum(data_arr * data_arr)
        t_vec = time.perf_counter() - start

        ratio = t_loop / t_vec if t_vec > 0 else float('inf')
        print(f"{n:>12,} {t_loop:>12.6f} {t_vec:>12.6f} {ratio:>7.1f}×")

benchmark([1_000, 10_000, 100_000, 1_000_000, 10_000_000])
示例输出(仅供参考,具体数值因硬件和系统环境而异):
        数据量   for循环(s)    向量化(s)    加速比
------------------------------------------------
       1,000     0.000080     0.000006    13.3×
      10,000     0.000790     0.000018    43.9×
     100,000     0.008100     0.000120    67.5×
   1,000,000     0.082000     0.001200    68.3×
  10,000,000     0.830000     0.012000    69.2×
可以看到,数据量越大,加速比越稳定地维持在高水平。数据量很小时加速比相对小一些,因为NumPy的固定调用开销占比更大。
七、总结
向量化比for循环快,根本原因可以归结为三点:
- 消除了Python解释器的逐元素开销——类型检查、对象封装、字节码分派全部省去。
- 利用了连续内存布局——CPU缓存命中率高,还能使用SIMD指令批量处理。
- 将循环下沉到编译好的C代码——编译型语言的紧凑循环比解释型语言快一到两个数量级。
在实际开发中,遵循一条简单原则即可获得大部分收益:凡是对整个数组做相同运算的for循环,先尝试用NumPy的数组运算替代。遇到有前后依赖或内存受限的情况,再考虑分块、原地计算或Numba等工具。
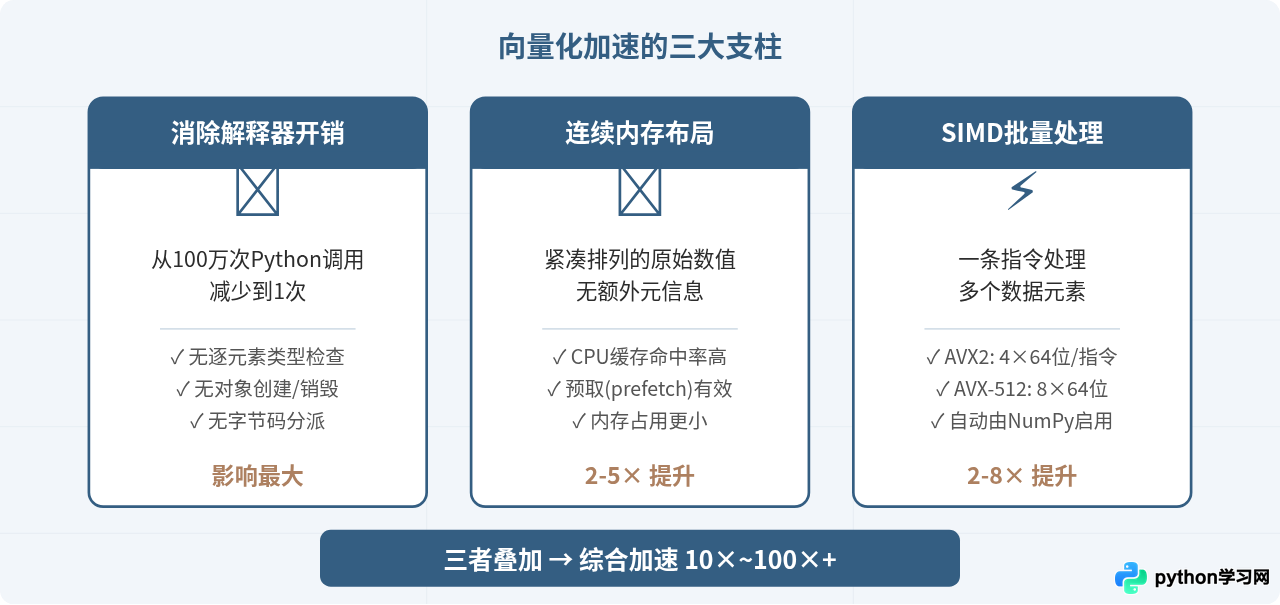
图4:向量化加速的三大核心因素及各自的贡献
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















