


初级与高级Python开发工程师的能力模型区别及晋升要求
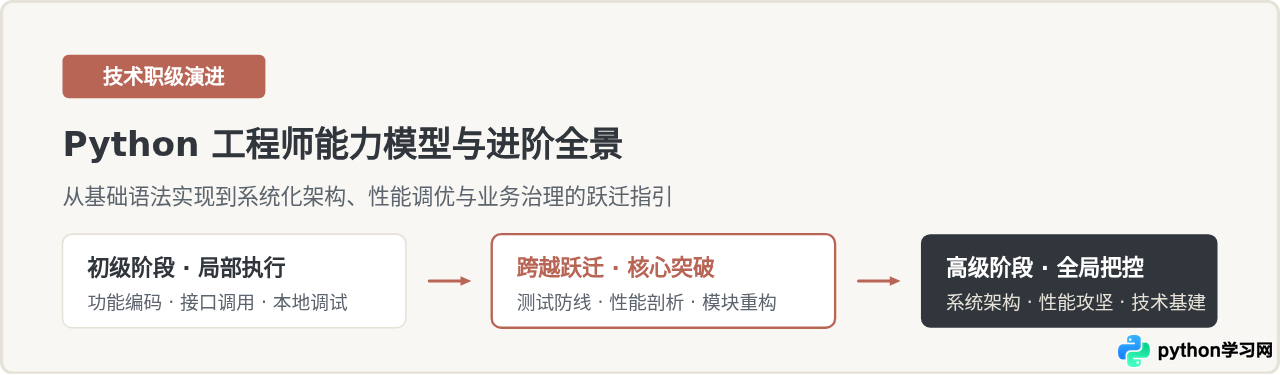
深入解析初级与高级Python开发工程师在底层原理、系统设计、工程质量与团队协作等多维能力模型上的核心区别,并提供具体的进阶步骤、代码实践及晋升答辩要求。
初级与高级Python开发工程师的核心差异,不仅体现在语法掌握与框架调用的熟练度,更体现在对底层运行时机制的理解、系统架构与稳定性治理能力,以及面对不确定性业务时的技术决策力。初级工程师通常在明确指导和限定边界内完成具体函数与模块的编写;高级工程师则需要独立承担端到端技术方案设计、高并发与海量数据场景下的性能攻坚,并建立全链路工程质量保障机制。本文围绕能力模型、代码实践、演进步骤及晋升答辩标准展开详细阐述。
一、初级与高级工程师的四维能力模型对比
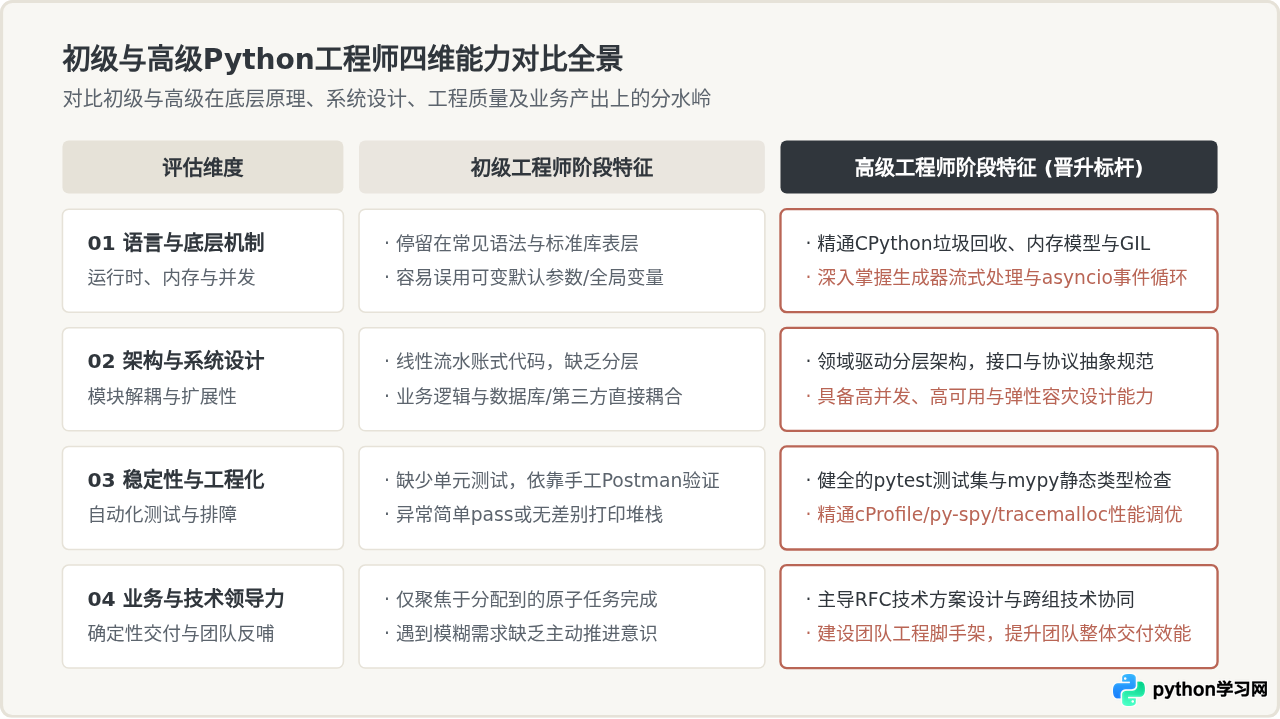
评估一名Python开发工程师的技术层级,通常不能单纯依据从业年限,而应综合考察其在语言与底层机制、架构与工程设计、系统稳定性与测试以及业务协同与技术领导力四个维度的综合表现。
| 能力维度 | 初级开发工程师(Junior) | 高级开发工程师(Senior) |
|---|---|---|
| 语言认知与底层机制 | 熟悉标准库常用模块与Web框架基础语法;能够完成CRUD操作,但对CPython对象模型、引用计数、分代垃圾回收、GIL并发限制理解较浅。 | 深刻理解CPython运行时机制、内存分配池(PyMalloc)、字节码执行机制与异步事件循环;能够精准依据CPU密集或IO密集场景进行技术选型。 |
| 架构与工程设计 | 习惯于面向过程或简单的单体脚本编写;模块之间耦合紧密,缺乏清晰的分层抽象与契约设计,遇到复杂变更时牵一发而动全身。 | 具备领域驱动分层意识与高内聚低耦合设计能力;熟练运用依赖倒置、装饰器工厂与策略模式,兼顾系统可扩展性、可测试性与演进平滑度。 |
| 稳定性与工程化 | 开发依赖本地手工调试与print打印;缺少自动化单元测试与类型约束;对线上异常主要依靠事后报警与临时重启。 | 推行类型批注(typing/mypy)与严格的单元测试/集成测试体系;掌握链路追踪(APM)、指标埋点、健康检查与熔断限流机制。 |
| 业务与技术领导力 | 被动接收拆解后的具体技术任务;关注点局限于单个函数或单条SQL的产出,难以预估代码变动对上下游系统的连带影响。 | 能够独立主导复杂业务的技术选型与技术方案评审;主动识别系统瓶颈与技术债务,沉淀团队通用工具库并对初中级成员提供有效代码审查。 |
二、核心工程实践与代码实现的具体差异
工程能力高低不是抽象的概念,而是直接体现在日常代码组织、资源管理与异常防御的具体细节中。下面通过两个典型生产场景对比初级与高级工程师的实现差异。
场景一:大数据流导出与内存资源控制
当需要从数据库或远程数据源导出海量订单记录并进行加工计算时,初级工程师往往直接使用列表推导式全量拉取数据到内存,极易引发生产环境内存溢出(OOM);高级工程师则会使用生成器、流式分块迭代并配合严格的资源管理上下文。
# 初级工程师实现:全量一次性读取,单批数据量大时导致内存暴涨
def export_orders_junior(order_ids: list[int]) -> list[dict]:
    results = []
    # 假设一次性加载50万条记录
    raw_data = fetch_all_from_db(order_ids)
    for record in raw_data:
        # 缺少异常防御与强类型契约
        results.append({
            "order_id": record["id"],
            "amount": float(record["price"]) * int(record["count"]),
            "status": record.get("status", "unknown")
        })
return results # 占用大量堆内存,高并发请求下极易造成进程被内核OOM Killfrom typing import Iterator, Generator
from contextlib import contextmanager
# 高级工程师实现:利用生成器流式分块处理,内存占用恒定O(1)
def stream_process_orders(
order_ids: list[int],
chunk_size: int = 1000
) -> Generator[dict, None, None]:
"""流式分块获取并清洗订单数据,避免内存峰值"""
if not order_ids:
return
# 按固定分块逐批次读取,限制单次游标驻留内存
for i in range(0, len(order_ids), chunk_size):
chunk_ids = order_ids[i:i + chunk_size]
# 使用流式游标上下文管理
with get_streaming_db_cursor() as cursor:
cursor.execute("SELECT id, price, count, status FROM orders WHERE id = ANY(%s)", (chunk_ids,))
while batch := cursor.fetchmany(chunk_size):
for row in batch:
# 容错转换与健壮防御
try:
yield {
"order_id": row[0],
"amount": round(float(row[1]) * int(row[2]), 2),
"status": str(row[3])
}
except (ValueError, TypeError, IndexError) as parse_err:
# 记录坏数据指标埋点,不中断主流程
record_metric_error("order_parse_failure", str(parse_err))
continue场景二:并发调用与背压防护
处理网络I/O密集型任务(如批量请求第三方接口)时,初级工程师常直接使用简单的 threading.Thread 随意并发,或者不加限制地使用 asyncio.gather(*tasks),一旦任务数量达到数万级,容易耗尽文件描述符并导致远程接口熔断。高级工程师则会使用 asyncio.Semaphore 设置背压并发上限,并配合连接池与重试降级策略。
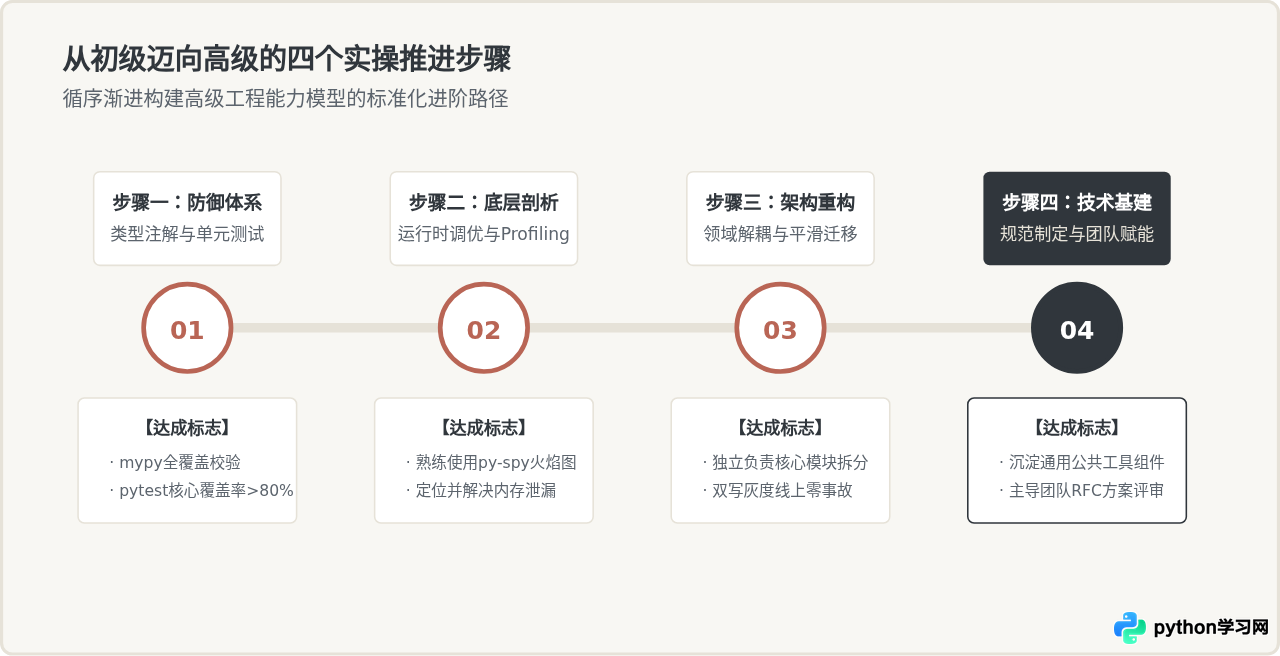
三、从初级向高级晋升的四个关键步骤
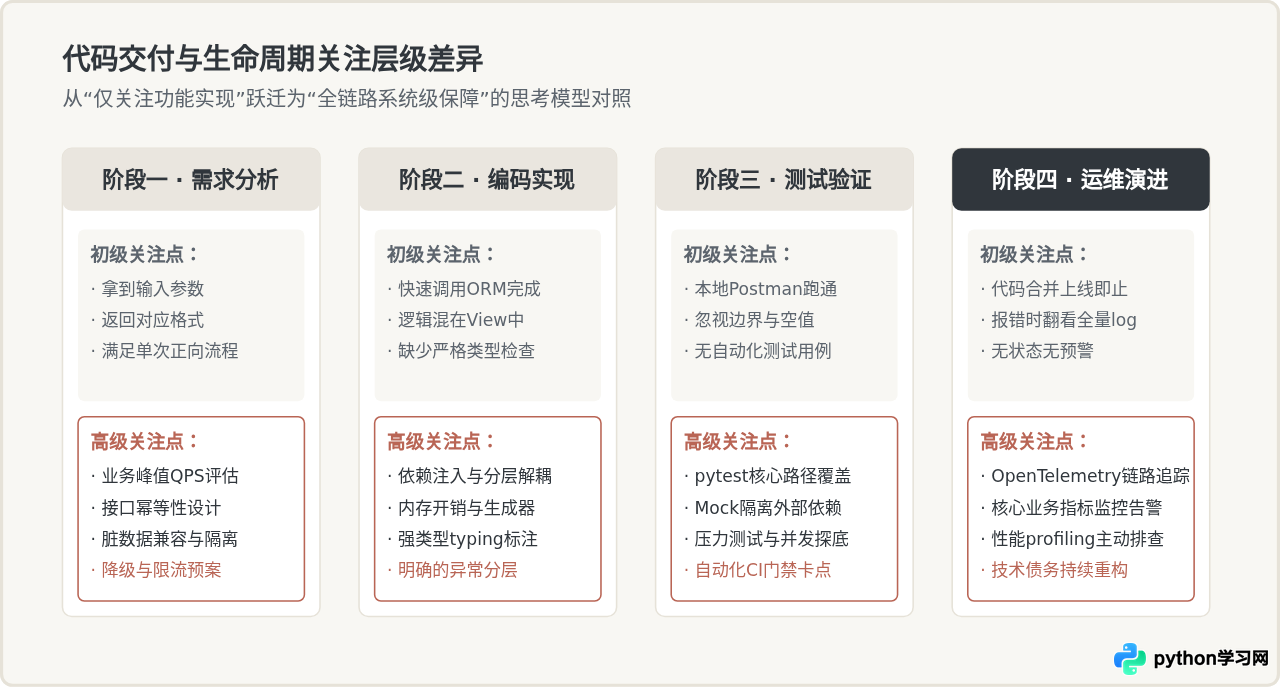
很多工程师长期处于初级或中级瓶颈期,主要原因在于日常工作陷入低水平重复的CRUD。要实现向高级工程师的跨越,需要有条理地在工程实践中完成以下四个关键跃迁步骤。
步骤一:建立严密的防御性工程体系
摆脱“跑通即交付”的初级习惯。在项目中引入严格的类型提示(typing 结合 mypy),使用 pytest 建立覆盖率达到80%以上的关键业务用例。配置 pre-commit 钩子,包含 ruff 代码规范检查与安全审计。测试不仅验证正常数据,更要针对网络波动、数据库超时、下游返回异常格式等边缘边界进行自动化 Mock 验证。
步骤二:深入底层运行时与瓶颈剖析实战
面对慢接口与高负载任务,不再依靠经验猜测。学会使用官方的 cProfile 模块分析函数调用耗时分布;使用 tracemalloc 排查内存对象未被垃圾回收的驻留根源;在生产高负载时使用无侵入性能探针 py-spy 生成火焰图(Flame Graph)。深入理解 Python 全局解释器锁(GIL)对多线程的制约,针对 CPU 密集型任务选用 multiprocessing 或 C/Rust 扩展,针对 I/O 密集型任务选用 asyncio 驱动。
步骤三:主导复杂业务模块的抽象与重构
主动承担包含多种状态转移、多第三方渠道适配或复杂数据计算的核心业务。运用领域分层思想,将数据模型层、业务规则层与外设适配层完全剥离。例如引入策略模式统一收敛支付渠道,利用工厂模式实现不同消息总线的无感切换。在重构过程中遵循“小步快跑、测试护航、双写校验、灰度放量”的工程准则,确保线上零故障迁移。
步骤四:制定工程规范并沉淀可复用技术基建
高级工程师的价值在于放大团队效能。将业务开发中反复编写的通用逻辑(如统一响应包装、Redis分布式锁装饰器、通用分页与签名校验、统一异常处理器)抽象为团队内部标准基础库。主持技术方案 RFC(Request for Comments)评审,输出详尽的设计文档,并在代码评审中向初中级工程师解释“为什么不能这样写”以及“更优雅健壮的替代方案”。
四、高级Python开发工程师的晋升评定要求
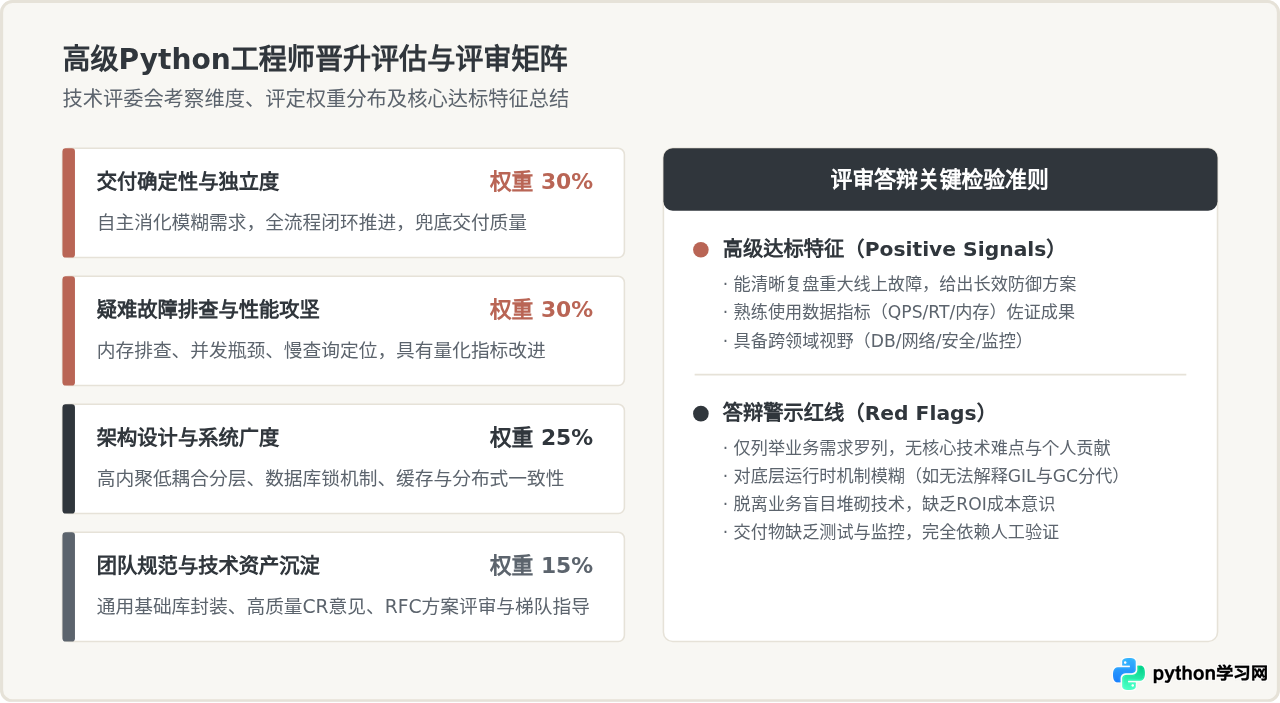
在企业技术职级评审与答辩中,评委重点关注的不是“你日常完成了多少张Jira卡片”,而是你是否展现出高级工程师所具备的交付确定性、深度攻坚力与架构前瞻性。具体评定要求包括以下四个方面:
1. 独立闭环与交付确定性(权重:30%)
高级工程师必须具备“端到端交钥匙”能力。面对产品经理给出的模糊或不完整业务诉求,能够自主推导技术边界,预判跨服务调用依赖,制定项目排期并确保上线确定性。无需主管在方案细节上反复校准,能够对最终业务结果负技术兜底责任。
2. 疑难问题攻坚与性能调优(权重:30%)
晋升材料中必须具备具有说服力的实战攻坚案例。例如:如何定位并解决线上高并发下的 Redis 缓存穿透与雪崩;如何排查 Gunicorn/Uvicorn 进程偶发性无响应假死;如何通过索引优化与 SQLAlchemy 批量改写将报表接口从 12 秒优化至 300 毫秒等。能用清晰的因果链条阐述“排查路径、根因分析、验证对比”。
3. 系统设计与技术广度(权重:25%)
不仅熟练运用 Python 语言本身,更要熟悉配套的系统基础设施。清楚了解 PostgreSQL/MySQL 事务隔离级别与锁机制;理解 Celery/Kafka 等消息队列在可靠消费、幂等防重及死信补偿上的设计;能合理设计分布式会话与缓存失效策略,具备容灾降级意识。
4. 工程规范与团队技术沉淀(权重:15%)
是否主导过团队代码规范的建立与推广;是否编写过高质量的技术设计文档(RFC);在代码评审(Code Review)中是否提出过建设性意见;是否将重复工作抽象为自动化工具,为团队降低整体维护成本。
常见晋升误区与答辩警示
- 警惕“年限等同水平”误区:工作3-5年不等于具备高级工程师能力。如果多年来只是重复编写简单查询接口,没有主导过架构设计或疑难攻坚,在评审中极易被判定为“熟练级初中级工程师”。
- 避免脱离业务价值的过度设计:高级工程师追求的是“在适合的业务阶段给出适度的技术架构”,而不是滥用设计模式或盲目引入复杂中间件。答辩中强调“为什么选这个方案”比“这个方案有多复杂”更重要。
- 答辩论证必须数据化:表述成果时避免使用“大幅提升性能”“明显降低故障”等模糊语言,应使用具体的指标对比,例如“P99延迟由850ms降低至120ms,内存峰值下降60%,单节点承载QPS提升3倍”。
五、总结
从初级Python开发工程师晋升为高级工程师,是一个从“关注代码能否运行”转变为“掌控系统运行风险、质量与效能”的系统化蜕变过程。初级阶段聚焦于单点功能和业务逻辑的落地,而高级阶段要求工程师兼具深厚的CPython底层原理认知、稳健的系统架构视野、严密的工程防御能力以及技术领导力。通过在生产实践中坚持测试防线、深入性能剖析、主动主导重构并沉淀通用资产,工程师能够有效突破经验重复的瓶颈,真正具备承担复杂业务系统架构与技术管理职责的能力。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















