


零基础转行Python开发:技能树梳理与系统学习路径规划
面向零基础转行者的实用指南,系统拆解Python岗位必备技术栈,梳理四大阶段学习路径,并提供防踩坑验证方法与阶段练习方案。
一、明确转行定位:就业市场需要的Python技能树
很多零基础学习者容易陷入“学了八个月语法却写不出一个完整工具”的困境,根本原因是没有把Python语法与真实的岗位技能区分开来。在实际企业环境中,单纯写几行数学运算脚本并不能被称为“开发人员”。初级Python岗位通常要求你能够解决具体的工程问题:要么能编写稳定的业务接口并读写数据库,要么能处理异构数据并自动化运行,要么能维护现有的业务系统。
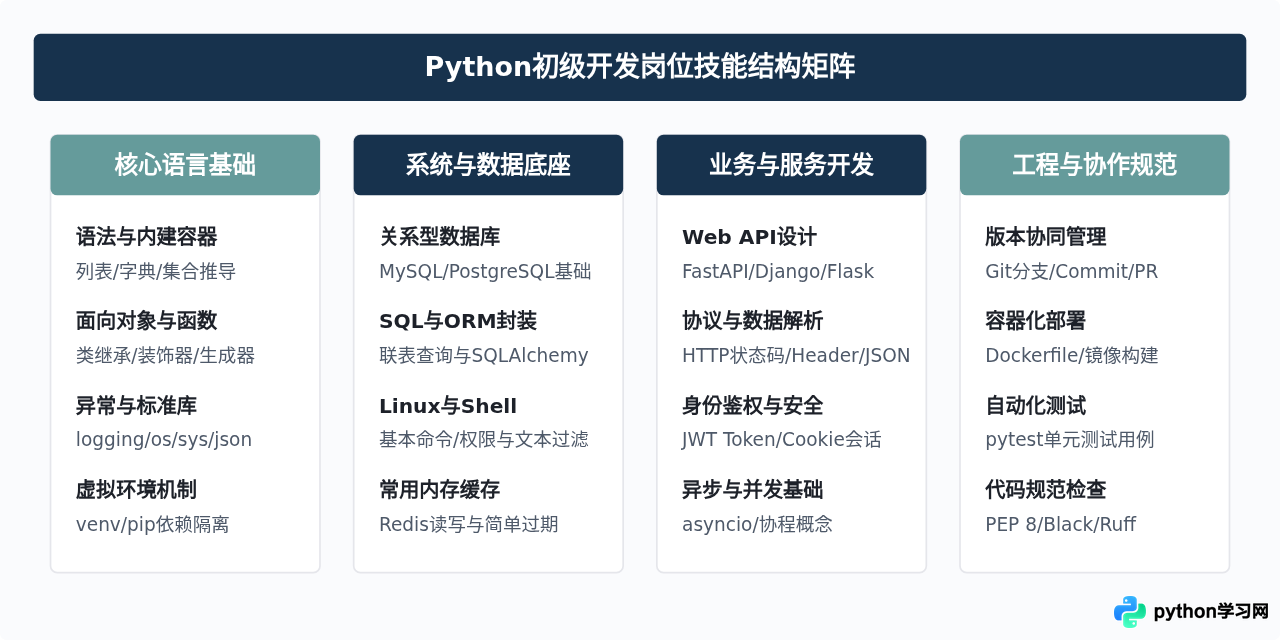
在技能结构上,一名合格的Python初级工程师应当具备四根支柱:核心语法与常用标准库、网络与操作系统底层常识、数据库与持久化存储、以及特定方向的应用框架与工程工具链。盲目扩充冷门库或一上来就挑战复杂的分布式算法,只会拉长战线、消耗信心。
二、转行方向选择:后端服务 vs 自动化与数据处理
零基础学习者在启动学习时,必须尽早选定一个具体方向,因为不同方向对知识深度的要求完全不同。目前市场上对初级转行者相对宽容的方向主要有两个:
- Web后端开发:为网站、小程序或后台管理系统提供API服务。主要打交道的是请求分发、业务校验、SQL编写和权限控制。技术路线清晰,招聘需求稳定。
- 数据爬取与自动化运维/测试开发:编写脚本收集非结构化数据,或者使用Python自动化测试界面、批量处理报表。该方向更强调对HTTP底层机制、自动化工具(如Selenium、Playwright)和系统命令的熟练度。
不要在学习初期试图“两手抓”。建议选择“以Web后端为主线,脚本自动化为辅助手段”的策略,这样可以沉淀出扎实的软件工程基本功,后续转向其他领域也更平滑。
三、分阶段学习路径规划与里程碑交付
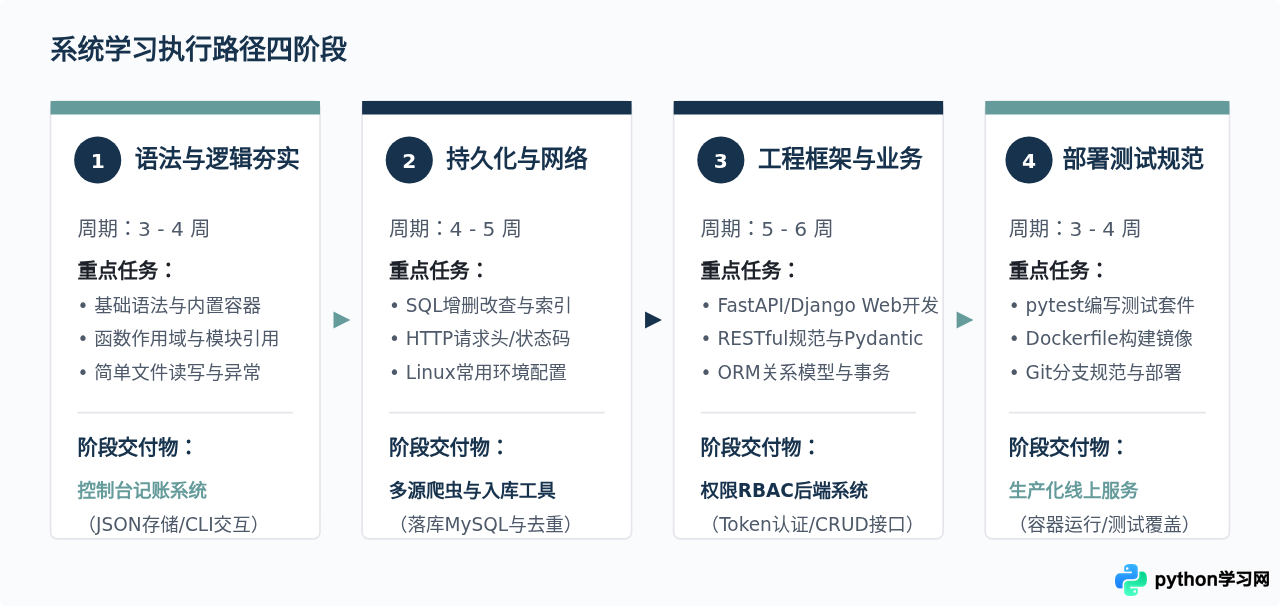
一个适合全职3到5个月、或在职6到8个月的系统学习方案,应当划分为四个线性推进的阶段。每个阶段都需要有可验证的交付物,而不是简单地“刷完了某套视频”。
第一阶段:基础语法脱盲与工程习惯建立
在这个阶段,目标不是学习大量高级特性,而是把变量、列表、字典、循环、函数与异常这几个零件用得像本能一样自然。初学者务必从第一天起就养成在本地终端创建虚拟环境的习惯,而不是把所有第三方库全部无脑安装在操作系统的全局环境里。
下面是一个标准的虚拟环境初始化与环境隔离操作流程:
Execution_Policies权限限制。在开始菜单中搜索PowerShell并右键“以管理员身份运行”,执行Set-ExecutionPolicy -ExecutionPolicy RemoteSigned -Scope CurrentUser即可解决,不要直接放弃虚拟环境去依赖系统全局Python。
第二阶段:数据持久化与外部协议交互
任何真实系统都无法只靠内存运行。在掌握语法后,应该立刻接触关系型数据库(如MySQL或PostgreSQL)。不要一开始就过度依赖可视化的Navicat或DBeaver直接点鼠标建表,一定要亲手书写SQL建表语句,理解主键、索引、外键以及基本的内连接(INNER JOIN)逻辑。
同时,理解HTTP通信是开发后端接口或编写自动化收集工具的前提。你需要清晰理解GET和POST方法的语义区别、常见的响应状态码(200、400、401、403、404、500)以及JSON格式在前后端传递时的解析规则。
第三阶段:框架化业务开发与分层架构
进入这个阶段,你将正式接触现代Web框架。对于新入行的学习者,推荐以FastAPI为首选切入点。相比结构较为庞大冗余的旧式架构,FastAPI具备天生基于Python类型提示(Type Hints)的参数验证能力,能强迫你写出规范、具备类型安全的代码。
在设计一个后端功能时,业界通常采用控制层(Router)、业务逻辑层(Service)与数据持久层(Model/CRUD)分离的方式,而不是把所有逻辑塞进一个函数里。下面是一个基于FastAPI与Pydantic的标准化API开发示例:
启动该服务并在终端中使用cURL进行测试:
第四阶段:工程化交付、单元测试与容器部署
初学者和真正工程师的分水岭,就在于“代码能否在别人电脑或服务器上稳定跑起来”。面试官非常看重应聘者是否具备基本的工程素养:懂得用pytest写单元测试、懂得导出requirements.txt依赖清单、懂得编写标准Dockerfile。
以下是部署上述应用所需的最简工业级Dockerfile配置示例:
四、标准开发调试流程与问题排查推导
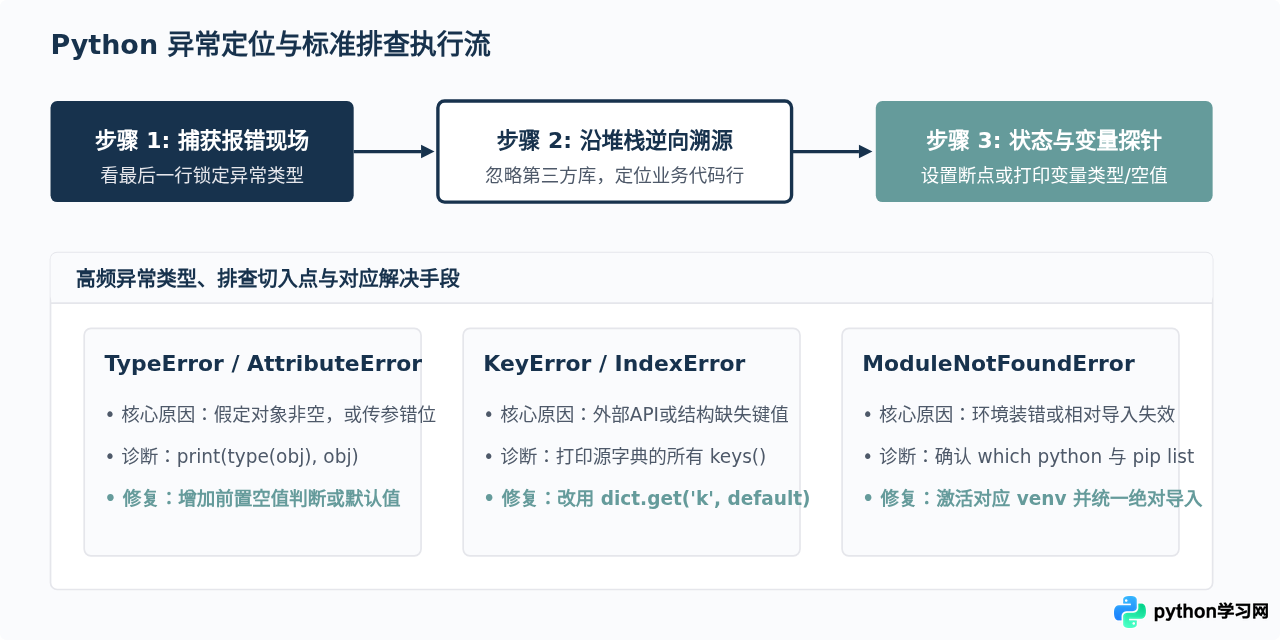
在实际编码过程中,大部分时间都在排查错误。零基础学员最容易在遇到红字报错(Traceback)时感到手足无措。面对程序异常,必须建立一套标准化的定位推导模型,而不是胡乱修改代码碰运气。
五、转行者常见误区与精力分配建议
零基础转行者通常时间紧张,如果把精力投在收益极低的事情上,往往会导致中途放弃。以下是三个最需要警惕的学习误区:
- 误区一:沉迷算法难题,忽视业务开发。对于初级Python职位,算法题考察通常控制在基础链表、哈希表或常见排序。过度死磕中高难度动态规划,不如踏实写好一个处理并发冲突、能做数据校验的真实业务接口。
- 误区二:教程收集癖,只看不敲。跟着视频敲代码时一切顺利,关掉视频连一个空文件都不知道怎么组织。必须强制自己在没有模板的情况下,独立从零搭建出最小可行方案(MVP)。
- 误区三:项目千篇一律,全是照抄。简历里写满“电影评分爬虫”或者“博客系统”,面试官一眼就能看出是网课作业。可以选一个垂直行业场景(例如:仓储库存预警服务、小团队工单流转系统),用真实的数据结构去设计。
六、全流程闭环总结与进阶准备
转行学习不是一个线性的理论考核,而是一个不断通过代码解决具体问题的工程循环。将学习动作规范为“掌握语法规范 → 理解交互协议 → 编码实现业务 → 自动化测试与打包”的流水线,你的技术体系就会非常扎实。
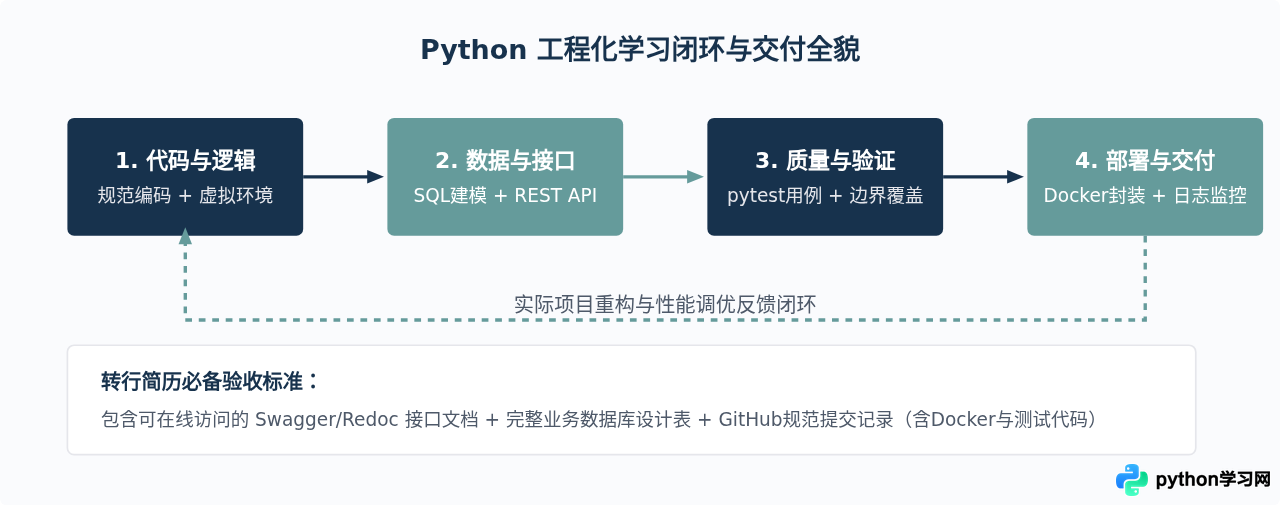
只要按照这套标准路径执行,每一个知识点都用具体的代码和输入输出进行检验,零基础跨行就不是虚无缥缈的口号,而是一套每一步都能看到成果的确定性工程。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















