


Python爬虫新手常见报错解决:连接失败与乱码问题处理
详细解析Python爬虫新手阶段最常遇到的两类拦路虎:网络连接失败与文本内容乱码。本文提供清晰的排查路径、底层原因解析以及可直接运行的代码解决方案。
写 Python 爬虫时,写好请求代码点击运行,最先遇到的阻碍通常不是数据解析,而是两堵高墙:控制台直接抛出一长串红色堆栈导致程序中断,或者好不容易拿到了网页内容,打开一看全是问号、黑块与不规则的“锟斤拷”。本文针对这两种高频问题,梳理出直观的定位思路、成因与可直接复用的修复代码。
一、连接失败(ConnectionError)排查与修复
在使用 requests 或类似库发送 HTTP 请求时,连接失败通常表现为终端抛出 requests.exceptions.ConnectionError、Timeout 或 SSLError。遇到这些报错,意味着你的请求包甚至还没有完整到达目标服务器并接收响应,或者在底层通信握手阶段就被中断了。
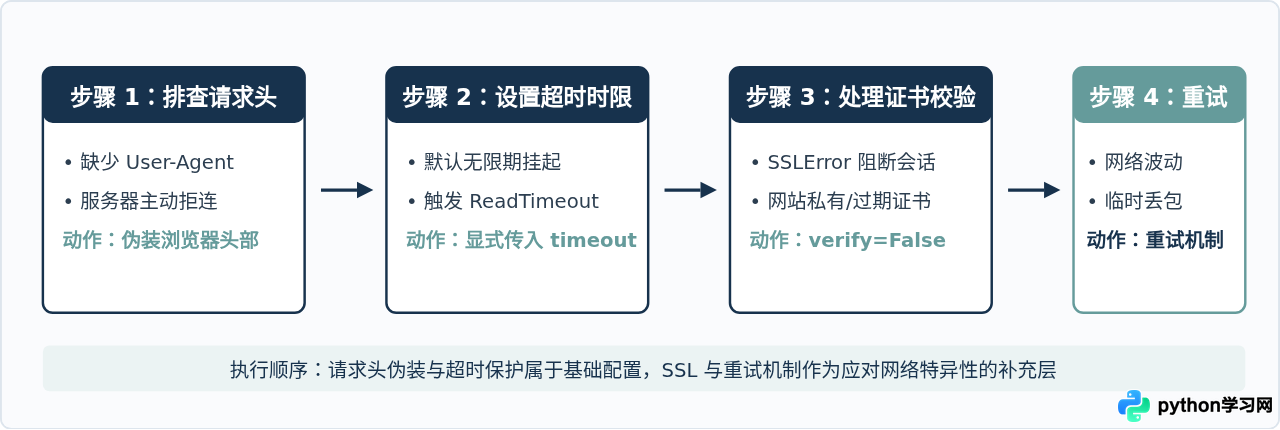
图 1:网络连接失败的标准排查与处置顺序
1. 缺少请求头导致的直接拦截
新手最常写出的代码是 requests.get("https://example.com")。如果未指定 Headers,requests 默认会在请求头中附带 User-Agent: python-requests/x.x.x。大量现代网站会在网关处直接拦截非浏览器标记的 UA,甚至不返回 403 状态码,而是直接重置 TCP 连接(表现为 ConnectionResetError)。
解决方法:在发送请求时,必须显式定义包含现代浏览器标识的字典并作为 headers 参数传入:
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36"
}
response = requests.get(target_url, headers=headers)
2. 未显式设置超时引发程序假死
如果不显式给请求方法传递 timeout 参数,requests 默认不会主动断开连接。当服务器因为流量限制丢弃了你的握手包时,整个 Python 程序将永久卡在请求的那一行,直到系统底层的套接字超时。
解决方法:推荐将 timeout 设置为一个元组,分别明确“连接超时”与“读取超时”。例如 timeout=(3.05, 10),代表等待与目标服务器建立 TCP 握手的最长时限为 3.05 秒,建立后等待数据返回的读取时限为 10 秒。
3. SSL 证书校验异常(SSLError)
访问部分内网测试网站、过期证书站点或未正确配置证书链的小型网站时,底层 OpenSSL 库会抛出 requests.exceptions.SSLError: [SSL: CERTIFICATE_VERIFY_FAILED]。
解决方法:可以在请求中指定 verify=False 临时跳过证书校验。为了避免控制台被频繁输出的 InsecureRequestWarning 干扰,需要引入 urllib3 屏蔽告警:
import requests
import urllib3

urllib3.disable_warnings(urllib3.exceptions.InsecureRequestWarning)

response = requests.get(
    "https://self-signed.badssl.com/",
    headers=headers,
    verify=False,
    timeout=(3, 10)
)verify 校验,否则存在被中间人拦截篡改数据的风险。
4. 结构化处理连接失败的工业级代码模板
在实际编写爬虫时,应使用 requests.Session() 配合内置的 HTTPAdapter 实现失败自动重试,再用 try...except 捕获无法恢复的致命网络错误,以保证单个网页请求失败不会导致整个脚本崩溃。
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

def fetch_page_safely(url):
    session = requests.Session()

    # 定义重试策略:针对连接错误与特定服务器状态码自动重试 3 次
    retry_strategy = Retry(
        total=3,
        backoff_factor=1,  # 重试间隔逐步增加:1s, 2s, 4s
        status_forcelist=[500, 502, 503, 504],
        raise_on_status=False
    )

    adapter = HTTPAdapter(max_retries=retry_strategy)
    session.mount("https://", adapter)
    session.mount("http://", adapter)

    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/122.0.0.0 Safari/537.36"
    }

    try:
        response = session.get(url, headers=headers, timeout=(3.05, 10))
        response.raise_for_status()
        return response
    except requests.exceptions.Timeout:
        print(f"[错误] 连接或读取超时: {url}")
    except requests.exceptions.ConnectionError as e:
        print(f"[错误] 底层网络连接失败或目标拒绝连接: {e}")
    except requests.exceptions.HTTPError as e:
        print(f"[错误] HTTP 状态异常: {e}")
    except requests.exceptions.RequestException as e:
        print(f"[错误] 未预期的请求异常: {e}")

    return None

# 执行示例
result = fetch_page_safely("https://httpbin.org/delay/2")
if result:
    print(f"成功获取页面,状态码: {result.status_code}")
二、网页乱码产生机理与编码冲突分析
解决了连接报错后,第二道常见关卡是文本乱码。使用 print(response.text) 时,页面中的汉字可能会变成类似 这是(双重 UTF-8 误按 Latin-1 解码)、(不可逆的替换字符)或 ??。
要彻底解决乱码,首先需要理解计算机如何处理文本。网络上传输的一切内容本质上都是十六进制的二进制字节序列(Bytes)。Python 内部表示文本使用的是统一的 Unicode 字符(Str)。解码(Decode)就是拿着指定的“字符字典”将字节翻译成可读字符的过程。字典选错,输出就必定变成乱码。
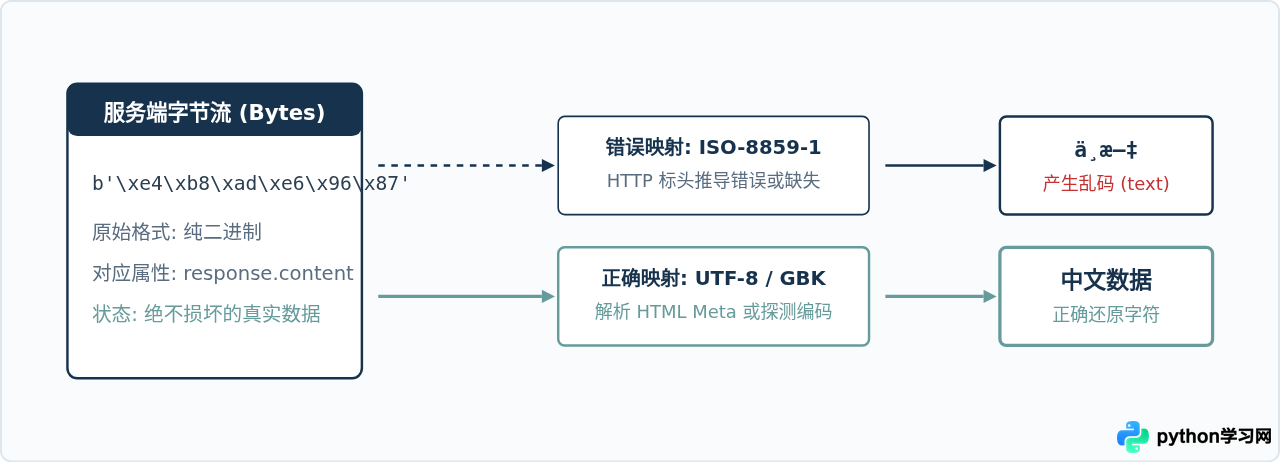
图 2:二进制字节流在不同解码映射下的结果分流
为什么 requests 的 response.text 经常乱码?
这是因为 response.text 并不是直接展示源网页内容,而是在内部依据 response.encoding 的值对原始字节 response.content 做了隐式解码。
requests 推测编码的依据是 HTTP 响应标头中的 Content-Type。如果响应头写着 Content-Type: text/html; charset=utf-8,requests 就能准确将其设为 utf-8。然而国内许多传统网站的响应头只写 Content-Type: text/html,没有指定 charset。依照 HTTP/1.1 标准规范,当没有提供 charset 时,客户端必须使用 ISO-8859-1(即西欧字符集)作为默认编码。拿着西欧字符集的字典去翻译中文字符,自然直接产生了乱码。
三、乱码问题的标准化定位与解决流程
解决乱码无需胡乱猜测,只需要沿着固定的顺序逐步提取编码依据。
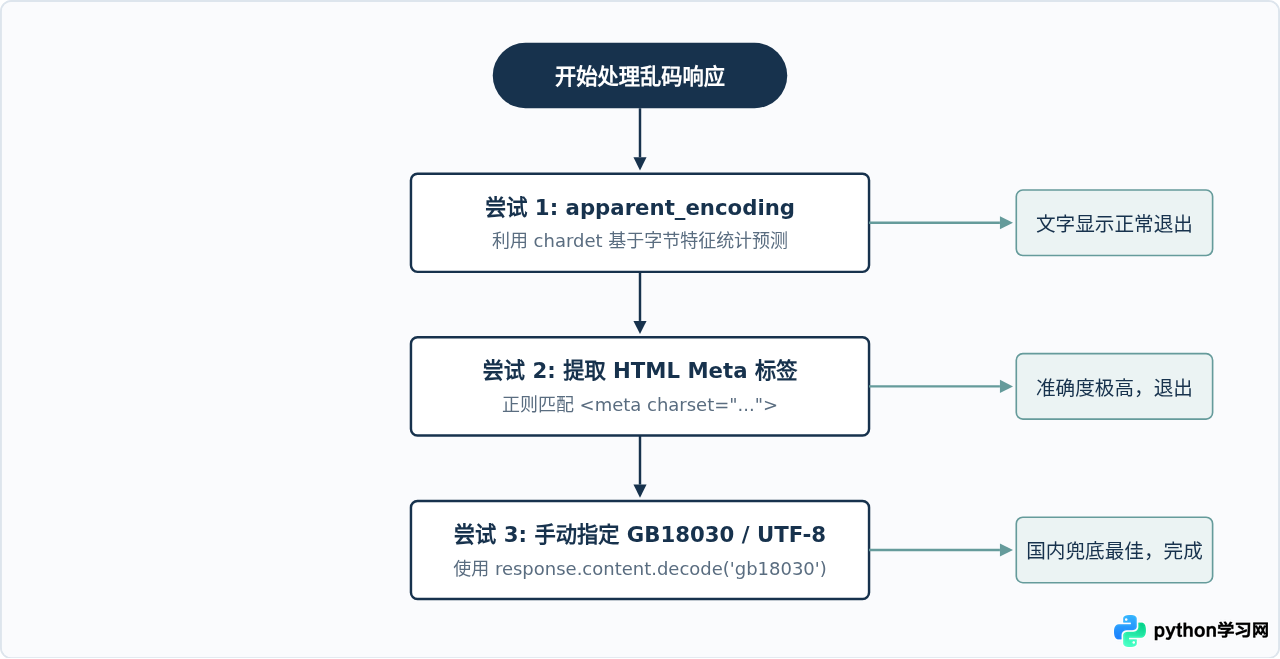
图 3:文本乱码逐级排查与解码流程图
方法一:借助 apparent_encoding 自动修正(最简便)
requests 对象提供了一个内置属性 response.apparent_encoding。它不会读取 HTTP 标头,而是通过内置分析模块(chardet/charset_normalizer)直接扫描字节流的字符分布规律,推测出可信度最高的编码。
import requests

response = requests.get("http://www.example.gov.cn", headers=headers)

# 在读取 text 之前,将推导出的真实编码重新赋值回去
response.encoding = response.apparent_encoding

print(response.text)
这一方法能解决超过 80% 的新手乱码场景。其唯一的缺点是当抓取内容非常大时,全文本的特征探测会有微小的 CPU 运算耗时。
方法二:从 HTML 文档内部提取真实声明(最准确)
大部分没有在 HTTP 标头声明编码的网页,其开发者都会在 HTML 的 <head> 区域写入编码声明,例如 <meta charset="gb2312"> 或 <meta http-equiv="Content-Type" content="text/html; charset=gbk">。
我们可以先用不损坏字节的通用方式取出 HTML 头部,用正则匹配出声明的编码,再对原始字节 content 执行准确解码:
import re
import requests

response = requests.get("http://www.news-site.cn", headers=headers)

# 仅从原始字节中读取前 1024 字节(head 部分必定在前 1KB 内)
header_sample = response.content[:1024].decode('ascii', errors='ignore')

# 匹配 meta charset
match = re.search(r'charset=["\']?([a-zA-Z0-9_-]+)', header_sample, re.IGNORECASE)

if match:
    declared_encoding = match.group(1)
    # 处理国内常见的变体
    if declared_encoding.lower() in ['gb2312', 'gbk']:
        declared_encoding = 'gb18030'
    text = response.content.decode(declared_encoding, errors='replace')
else:
    # 未声明时,使用 apparent_encoding 或 utf-8 兜底
    text = response.content.decode(response.apparent_encoding or 'utf-8', errors='replace')

print(text[:200])
方法三:绕过 response.text,直接手动解码(最彻底)
如果你非常清楚目标网站的类型,完全不需要让 requests 介入解码。使用 response.content 获取原始二进制数据,手动调用 Python 内置的 .decode() 方法是最稳妥且性能最高的做法。
gb18030 替代 gb2312 与 gbk。gb2312 仅收录常用汉字,很多生僻字、人名甚至标点符号会直接引发 UnicodeDecodeError。gb18030 是中国国家标准的最新中文编码,不仅向下完全兼容 gb2312 和 gbk,还包含了所有生僻字及藏、蒙、维等少数民族文字。
# 统一解码规范
try:
    # 优先尝试现代网络标准的 utf-8
    html_content = response.content.decode('utf-8')
except UnicodeDecodeError:
    # 出现解码异常,回退到覆盖最全的中文超集 gb18030
    # errors='replace' 可以保证哪怕有个别坏字符,也会被替换为替代符而不是直接中断程序
    html_content = response.content.decode('gb18030', errors='replace')
四、排查思路与处理模式对照总结
为了在日常编写爬虫遇到异常时能够快速反应,以下将本文涉及的连接异常与乱码特征整理为矩阵清单。
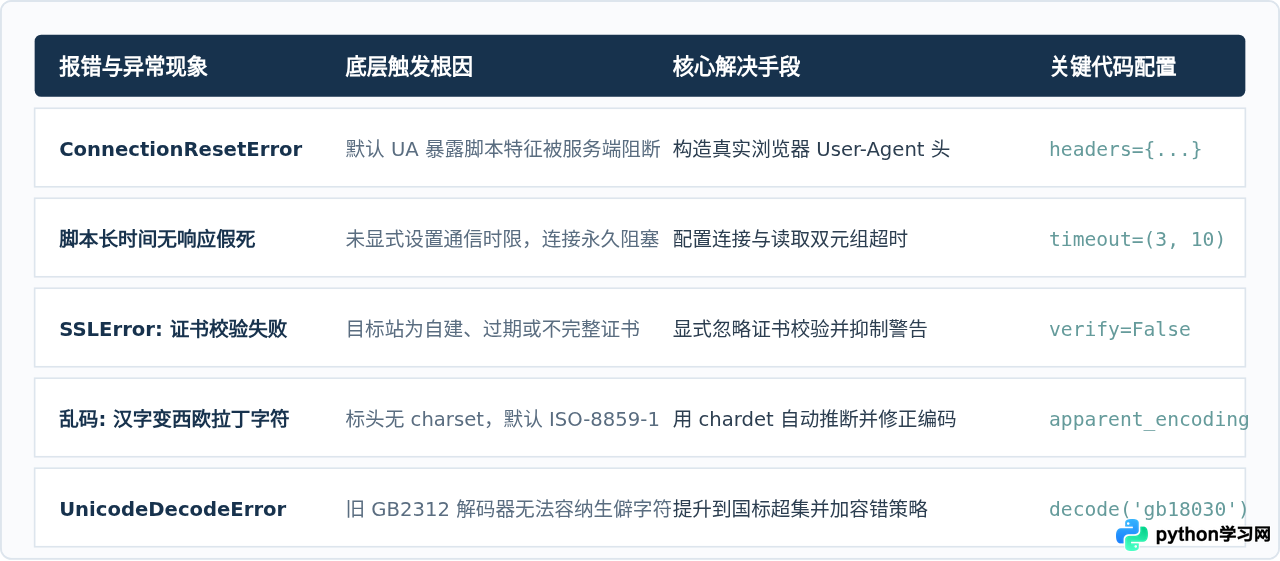
图 4:核心报错现象与解决方案对应速查表
在实际编写爬虫工程时,只要坚持做好三项基础防线——加上规范的请求头、显式定义超时、用 response.content 配合 apparent_encoding 或 gb18030 严谨解码,绝大多数“连接不上”和“看不懂内容”的报错都会在源头得到妥善化解。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















