


Python内置函数大全:68个Built-in Functions分类速查表
完整梳理Python官方标准库定义的全部68个内置函数(Built-in Functions)。按照类型转换、数学运算、容器迭代、反射省视、作用域与运行时等维度进行系统分类与详细解析,附带高清架构图示与易混淆点辨析。
在 Python 的标准运行环境中,解释器预先载入了 68 个可以直接调用的内置函数(Built-in Functions)。它们无需使用 import 导入任何模块,直接存在于全局命名空间的最外层作用域中。本文系统梳理这 68 个函数的具体职责、使用条件与底层行为,将其划分为 7 大核心功能域,并结合图示、对比表格与代码范例,提供一份可以直接查阅和验证的操作参考手册。
一、Built-in 命名空间定位与检索机制
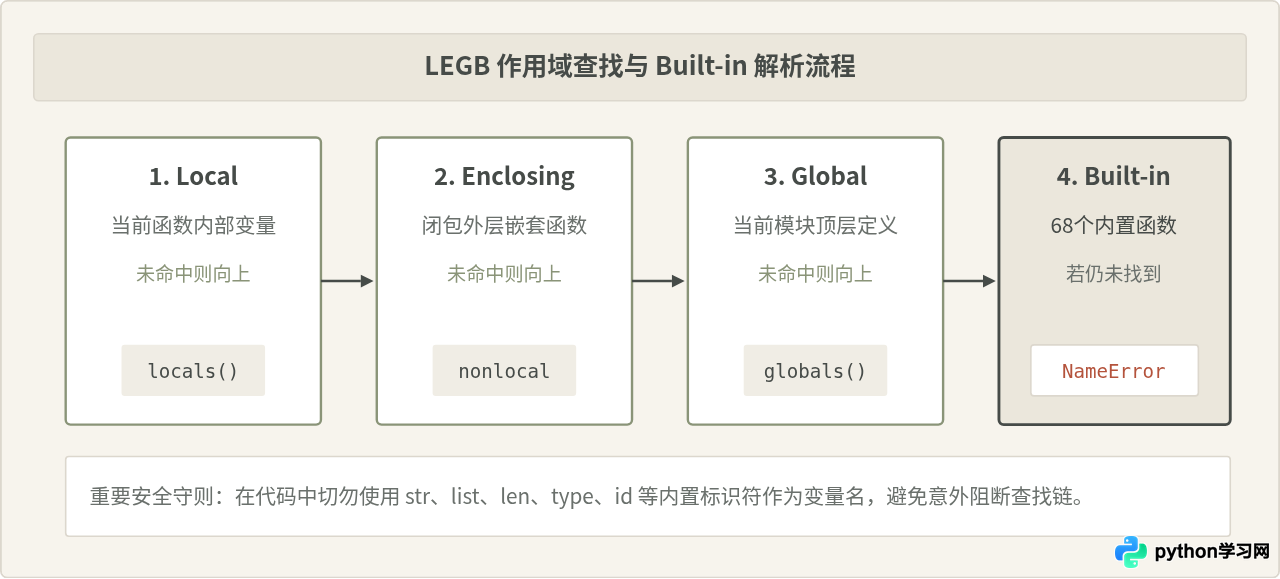
当我们在代码中书写一个标识符(如 len("hello"))时,Python 解释器按照 LEGB 规则 依次向上检索变量名:Local(局部命名空间)→ Enclosing(闭包命名空间)→ Global(当前模块全局命名空间)→ Built-in(内置命名空间)。内置函数正是位于这条查找链的最终端点。
在底层实现中,所有 68 个内置函数都作为属性保存在标准库的 builtins 模块中。如果需要直接查看当前 Python 环境下的全部内置标识符并筛选出内置函数,可以在终端交互界面执行以下代码:
import builtins

# 筛选出属于内置函数或内置类型构造器的对象
builtins_list = [
    name for name in dir(builtins)
    if not name.startswith("_") and callable(getattr(builtins, name))
]

print(f"有效可调用项统计: {len(builtins_list)}")
# 在标准 Python 3.10 及以上环境中,核心内置函数数量严格对应为 68 个
理解这套查找链对于编写稳健代码至关重要。若在局部或全局作用域中声明了同名变量(例如定义了 list = [1, 2] 或 str = "text"),解释器将在较浅的层级完成匹配,从而遮蔽(Shadow)底层内置函数的功能,导致后续调用 list() 报出 TypeError: 'list' object is not callable。
二、68个内置函数核心分类速查表
在 Python 语言规范中,部分内置“函数”在严格的类型系统上其实属于内置类(例如 int、list、dict 的本质是类构造器),但从调用语法和语言规范统一视角出发,它们在官方手册中全部被统一收录在 Built-in Functions 这一词条下。根据实际工程中的用途,我们可以将其清晰划分为 7 大板块:
1. 类型构造与基元转换(15 个)
| 函数名称 | 功能简要说明 | 标准使用示例 |
|---|---|---|
bool(x) |
根据真值测试规则将参数转换为布尔值 | bool(0) # False |
int(x, base=10) |
将字符串或数字转换为整型,支持基数转换 | int("1f", 16) # 31 |
float(x) |
将字符串或数字转换为双精度浮点数 | float("3.1415") # 3.1415 |
complex(r, i) |
构造复数对象:real + imag*1j | complex(2, 3) # (2+3j) |
str(object='') |
返回面向用户的非正式可读字符串形式 | str(100) # '100' |
bytes(source) |
创建不可变的字节序列对象 | bytes([65, 66]) # b'AB' |
bytearray(source) |
创建可变的字节数组序列 | b = bytearray(b"hi"); b[0] = 72 |
memoryview(obj) |
创建对支持缓冲区协议对象的无复制切片视图 | mv = memoryview(b"data") |
list(iterable) |
将可迭代对象构建为普通列表容器 | list("abc") # ['a', 'b', 'c'] |
tuple(iterable) |
将可迭代对象构建为不可变元组容器 | tuple([1, 2]) # (1, 2) |
set(iterable) |
构建去重且无序的可变集合 | set([1, 2, 2, 3]) # {1, 2, 3} |
frozenset(iter) |
构建不可变集合,可作为字典键或存入集合 | frozenset({1, 2}) |
dict(**kwarg) |
创建键值映射字典对象 | dict(a=1, b=2) # {'a': 1, 'b': 2} |
chr(i) |
将 Unicode 整数代码点转换为对应的单字符 | chr(97) # 'a' |
ord(c) |
返回对应 Unicode 字符的整数代码点 | ord('a') # 97 |
2. 数学运算与数值处理(7 个)
| 函数名称 | 功能简要说明 | 标准使用示例 |
|---|---|---|
abs(x) |
返回数字的绝对值或复数的模长 | abs(-5) # 5; abs(3+4j) # 5.0 |
divmod(a, b) |
同时计算并返回商与余数组成的元组 (a // b, a % b) |
divmod(17, 5) # (3, 2) |
pow(base, exp[, mod]) |
快速幂运算,提供三参数时执行高效取模算法 | pow(2, 10, 7) # 2^10 % 7 = 2 |
round(number[, ndigits]) |
四舍六入五成双的浮点舍入(银行家舍入法则) | round(2.5) # 2; round(3.5) # 4 |
sum(iterable, start=0) |
计算数字序列的累计总和 | sum([1, 2, 3], start=10) # 16 |
min(iterable, *[, key, default]) |
返回序列中或参数中的最小值,支持比较键与默认值 | min([1, 4, 2]) # 1 |
max(iterable, *[, key, default]) |
返回序列中或参数中的最大值,支持自定义权重键 | max(["a", "abc"], key=len) # 'abc' |
3. 序列、迭代器与容器生成(12 个)
| 函数名称 | 功能简要说明 | 标准使用示例 |
|---|---|---|
len(s) |
返回容器对象的元素数量(调用 __len__) |
len("Python") # 6 |
range(start, stop[, step]) |
创建按等差规律生成的不可变数字序列 | list(range(0, 5, 2)) # [0, 2, 4] |
enumerate(iterable, start=0) |
生成带索引计数的二元组迭代器 | list(enumerate(['a', 'b'])) # [(0,'a'), (1,'b')] |
zip(*iterables, strict=False) |
并行组合多个可迭代对象的对应元素为元组 | list(zip([1, 2], ['a', 'b'])) # [(1,'a'), (2,'b')] |
iter(object[, sentinel]) |
获取对象的迭代器,或配合哨兵值持续获取输入 | it = iter([1, 2]); next(it) # 1 |
next(iterator[, default]) |
推进迭代器并返回下一项,耗尽时可返回兜底默认值 | next(it, -1) # 2; next(it, -1) # -1 |
filter(function, iterable) |
筛选使判定函数为 True 的元素并返回惰性迭代器 | list(filter(lambda x: x > 0, [-1, 2])) # [2] |
map(function, *iterables) |
将函数映射到可迭代序列的每个元素上并惰性求值 | list(map(str.upper, ['a', 'b'])) # ['A', 'B'] |
sorted(iterable, *[, key, reverse]) |
将可迭代对象作为新列表返回排好序的结果 | sorted([3, 1, 2]) # [1, 2, 3] |
reversed(seq) |
返回反向遍历序列的反向迭代器 | list(reversed([1, 2, 3])) # [3, 2, 1] |
all(iterable) |
如果序列中所有元素皆为真值(或为空)则返回 True | all([True, 1, "ok"]) # True |
any(iterable) |
只要序列中存在至少一个真值元素则返回 True | any([0, False, "data"]) # True |
4. 对象省视、反射与面向对象支持(13 个)
| 函数名称 | 功能简要说明 | 标准使用示例 |
|---|---|---|
isinstance(object, classinfo) |
检测对象是否为指定类型或其派生子类的实例 | isinstance(True, int) # True |
issubclass(class, classinfo) |
检测某类是否为目标类的派生子类 | issubclass(bool, int) # True |
type(object) / type(name, bases, dict) |
获取对象的直接类型,或以三参数动态创建新类 | type(10) # <class 'int'> |
id(object) |
返回对象在内存生命周期内的唯一整数标识(内存地址) | id(x) # 140733856230480 |
hash(object) |
计算并返回不可变对象的哈希整数值 | hash("token") # 78129037149 |
getattr(object, name[, default]) |
以字符串形式反射获取对象的属性值 | getattr(obj, "x", None) |
setattr(object, name, value) |
动态向对象属性注入新值 | setattr(obj, "status", 200) |
hasattr(object, name) |
检测对象是否包含指定名称的属性 | hasattr(obj, "close") # True |
delattr(object, name) |
动态删除对象的指定属性 | delattr(obj, "temporary_field") |
dir([object]) |
返回当前作用域名称列表或对象所具备的全部可用属性 | dir([]) # 列出列表所有魔术方法与可用操作 |
callable(object) |
检测对象是否可以被调用(如函数、类或实现了 __call__) |
callable(print) # True |
property(fget=None, fset=None, ...) |
创建托管属性特性的描述符,常以装饰器形式使用 | @property def val(self): return self._v |
super([type[, object-or-type]]) |
根据方法解析顺序(MRO)委派父类方法调用 | super().__init__() |
5. 作用域分析与底层运行时交互(8 个)
| 函数名称 | 功能简要说明 | 标准使用示例 |
|---|---|---|
globals() |
返回代表当前模块全局符号表的真实字典 | globals()['_custom_var'] = 42 |
locals() |
更新并返回当前作用域局部变量的字典拷贝 | current_vars = locals() |
vars([object]) |
返回模块、类、实例或任何具有 __dict__ 的对象的字典属性 |
vars(self) # 获取实例所有字段键值对 |
classmethod(fn) |
将方法转为类方法,第一个参数隐式绑定为 cls | @classmethod def create(cls): ... |
staticmethod(fn) |
将方法转为静态方法,不接收隐式的 self 或 cls | @staticmethod def util(): ... |
__import__(name) |
解释器底层的导入钩子,由 import 语句直接调用 |
math = __import__('math') |
compile(source, ...) |
将源码字符串解析为代码对象(Code Object)以备执行 | c = compile("a + 1", "<str>", "eval") |
help([object]) |
调起内置的交互式帮助系统,查阅文档字符串 | help(sorted) |
6. 动态执行与格式化输入输出(7 个)
| 函数名称 | 功能简要说明 | 标准使用示例 |
|---|---|---|
print(*objects, ...) |
将对象格式化输出至流(默认为 sys.stdout) | print("结果:", val, sep=" ", end="\n") |
input([prompt]) |
从控制台读取一行输入,末尾换行符被去除并返回字符串 | name = input("请输入姓名: ") |
open(file, mode='r') |
打开操作系统文件并返回对应的文件流流对象 | with open("log.txt", "w", encoding="utf-8") as f: ... |
format(value[, spec]) |
根据格式化说明符将数值转换为格式化文本 | format(1234.567, ",.2f") # '1,234.57' |
repr(object) |
返回对象的规范字符串表达(通常满足 eval(repr(x)) == x) |
repr("hello") # "'hello'" (带引号) |
eval(expression, ...) |
解析并计算一段 Python 表达式并返回计算结果 | eval("2 * 3 + 1") # 7 |
exec(object, ...) |
动态执行 Python 复杂语句块与控制流 | exec("for i in range(2): print(i)") |
7. 调试、系统配置与特殊协议(6 个)
| 函数名称 | 功能简要说明 | 标准使用示例 |
|---|---|---|
breakpoint(*args) |
下发调试断点,底层调用 sys.breakpointhook()(自 3.7 加入) |
breakpoint() # 自动进入 pdb 调试模式 |
ascii(object) |
类似于 repr(),但通过 \x、\u 将非 ASCII 字符转义 |
ascii("中文") # "'\\u4e2d\\u6587'" |
bin(x) |
将整数转换为带有 0b 前缀的二进制字符串 |
bin(10) # '0b1010' |
oct(x) |
将整数转换为带有 0o 前缀的八进制字符串 |
oct(10) # '0o12' |
hex(x) |
将整数转换为带有 0x 前缀的十六进制小写字符串 |
hex(255) # '0xff' |
slice(start, stop[, step]) |
构造切片对象,等价于扩展索引语法 [start:stop:step] |
s = slice(0, 5, 2); "abcdef"[s] # 'ace' |
15(类型构造) + 7(数学计算) + 12(序列迭代) + 13(反射与对象) + 8(作用域与运行时) + 7(输入输出与执行) + 6(系统与编码) = 68 个官方内置函数。全部成员均在此列,无遗漏与无中生有项。
三、核心内置函数工作机理与典型场景
1. 集合聚合与短路求值:all() 与 any()
all() 和 any() 用于快速判断可迭代对象中元素的逻辑真假。这两个函数均原生具备短路求值特性:any() 一旦扫描到首个 True 元素,便立即终止后续生成器的迭代;all() 一旦遇到 False 元素,也会立即返回,不再继续向后取值。
# 场景:检测文件列表中是否存在危险扩展名(具备短路保护)
filenames = ["app.py", "main.py", "exploit.sh", "data.csv"]
dangerous_exts = {".sh", ".exe", ".bin"}

has_risk = any(file.endswith(ext) for file in filenames for ext in dangerous_exts)
print(f"安全风险命中: {has_risk}")  # 输出: True
2. 双向解构与并行配对:zip(*iterables, strict=False)
在 Python 3.10 之后,zip 引入了 strict=True 参数。当传入的多个可迭代序列长度不一致时,若未显式要求,旧版本会默默在最短序列结束时停止截断,这往往会掩盖逻辑缺陷。开启 strict=True 后,长度不吻合将直接抛出 ValueError,极大增强了数据管道处理时的健壮性。
keys = ["host", "port", "timeout"]
values = ["127.0.0.1", 8080]

# 严格模式保证长度必须对齐
try:
    config = dict(zip(keys, values, strict=True))
except ValueError as e:
    print(f"数据源未对齐: {e}")  # 捕获异常,阻断脏数据生成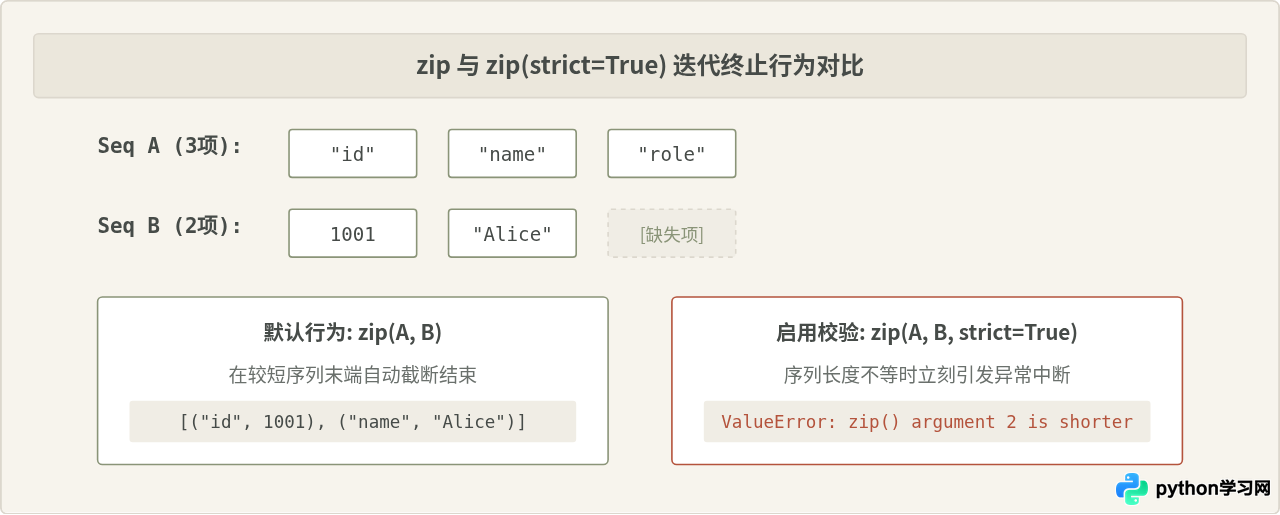
四、常见概念辨析与易混淆点纠偏
1. 误区辨析:isinstance() 与 type() 的适用界限
很多初学者倾向于用 type(obj) == target_type 来做类型断言。这种做法在绝大多数面向对象场景下是不严谨的。
- 为什么看似合理:对于非继承体系的基元对象(如
type(10) == int),返回结果完全符合预期。 - 何时会失效:在存在继承关系的模型中,
type()只检查对象的精确类类型,不考虑继承链。由于 Python 中的bool是int的派生子类,isinstance(True, int)为 True,而type(True) == int则会判定为 False。 - 修正建议:除非你明确要求“排除一切派生子类、必须是该类本身”,否则一律优先使用
isinstance(obj, ClassInfo)。
class CustomList(list):
    """自定义带业务特性的列表子类"""
    pass

c = CustomList([1, 2, 3])

# type() 判定会抹杀多态特性
print(type(c) == list)         # 结果为 False

# isinstance() 能够正确识别继承关系
print(isinstance(c, list))     # 结果为 True
2. 误区辨析:round() 遵循的是简单“四舍五入”吗?
常规认知里的“四舍五入”(如小学数学口诀)遇到 .5 时始终向上进位。但在 Python 的内置 round() 实现中,遵循的是 IEEE 754 标准中的银行家舍入法(Half to Even):当被舍弃部分正好为 0.5 时,向最近的偶数取整。
print(round(2.5))  # 输出 2 (2 是离它最近的偶数)
print(round(3.5))  # 输出 4 (4 是离它最近的偶数)
print(round(4.5)) # 输出 4 (4 是离它最近的偶数)保留原做法合理性的边界:在大量浮点数聚合统计中,这一规则可以消除由于始终向上舍入带来的累积系统正偏差;如果业务上(如金融账目)强制要求固定向上舍入,应转为使用 decimal 模块中的 ROUND_HALF_UP 策略,而不是直接依赖内置 round()。
3. 误区辨析:eval() 是处理用户输入数据的“万能解析器”吗?
eval() 可以快速把类似 "[1, 2, 3]" 的字符串转为真正的列表,这让一些人习惯直接用它来解析用户输入的字典或数组。
潜在危害:eval() 会以当前运行权限执行字符串中的任意 Python 表达式。恶意用户只需输入 __import__('os').system('rm -rf /') 便可破坏系统。对于数据反序列化场景,应使用标准库中的 ast.literal_eval() 替代,后者仅解析纯数据字面量(列表、字典、基础标量),彻底规避代码执行漏洞。
五、总结:内置函数高效选用与排障流程
掌握这 68 个内置函数的目的,是为了写出更加符合 Python 习惯(Pythonic)的代码,用 CPython 内部高度优化的 C 语言底层实现替代我们在 Python 层重复手写的低效逻辑。
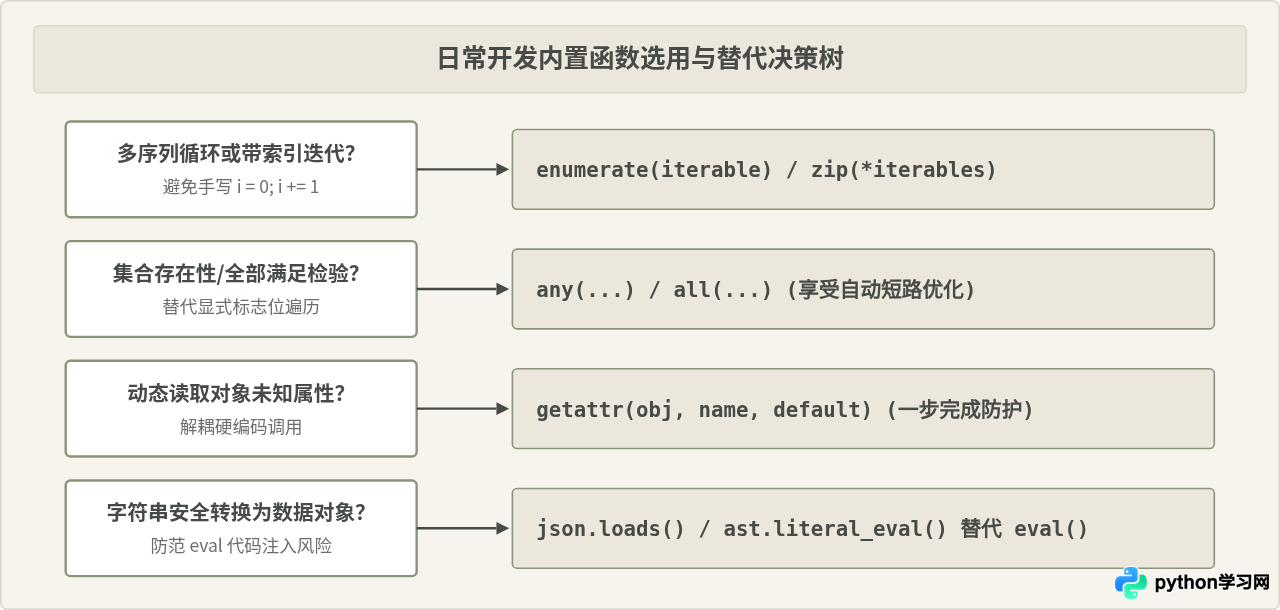
在日常开发过程中,建议牢记以下 3 条落地准则:
- 命名绝对保护:严禁使用
id、type、list、dict、str、max、min等高频内置标识符为自己的临时变量命名。 - 反射优先设防:调用
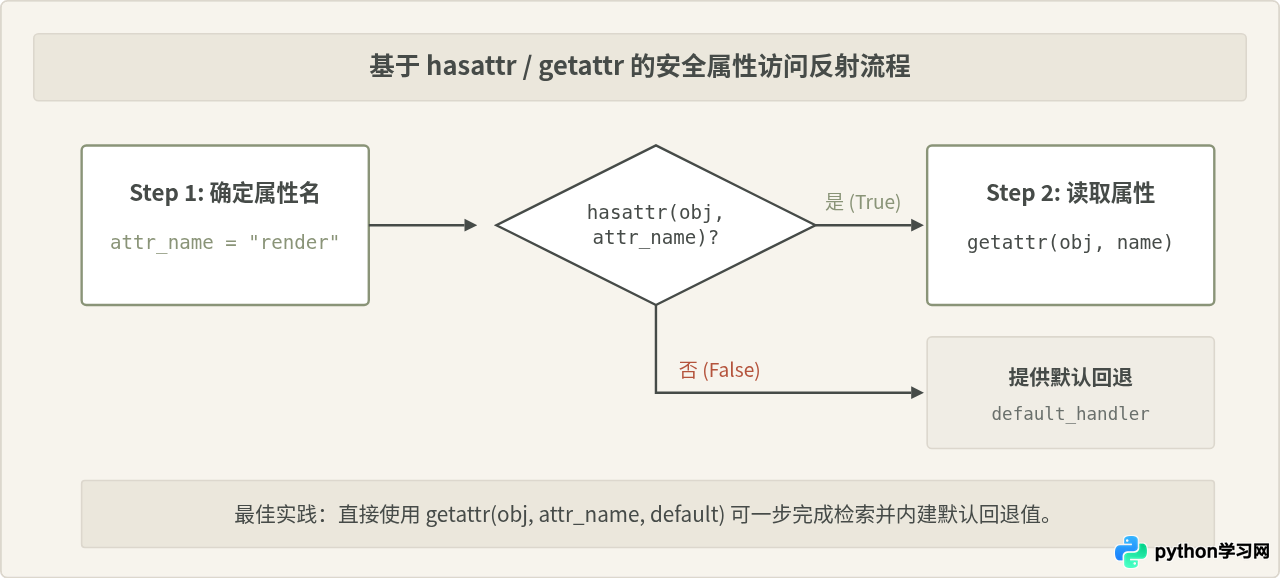
getattr()时,养成始终传入第三个参数作为默认值的习惯,防止触发AttributeError导致程序异常终止。 - 惰性优先思想:对于
map()、filter()、zip()等返回生成器/迭代器的内置函数,只有真正需要落地为具体容器时再使用list()解包,在数据流管道中应保留其惰性求值特性以节省内存。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















