


Python在线编译器运行超时怎么办?优化建议与替代方案
Python在线编译器运行超时时,如何判断是死循环、算法效率、输入输出、网络请求还是平台资源限制,并给出代码优化、排查步骤以及本地环境和其他运行方式的替代方案。
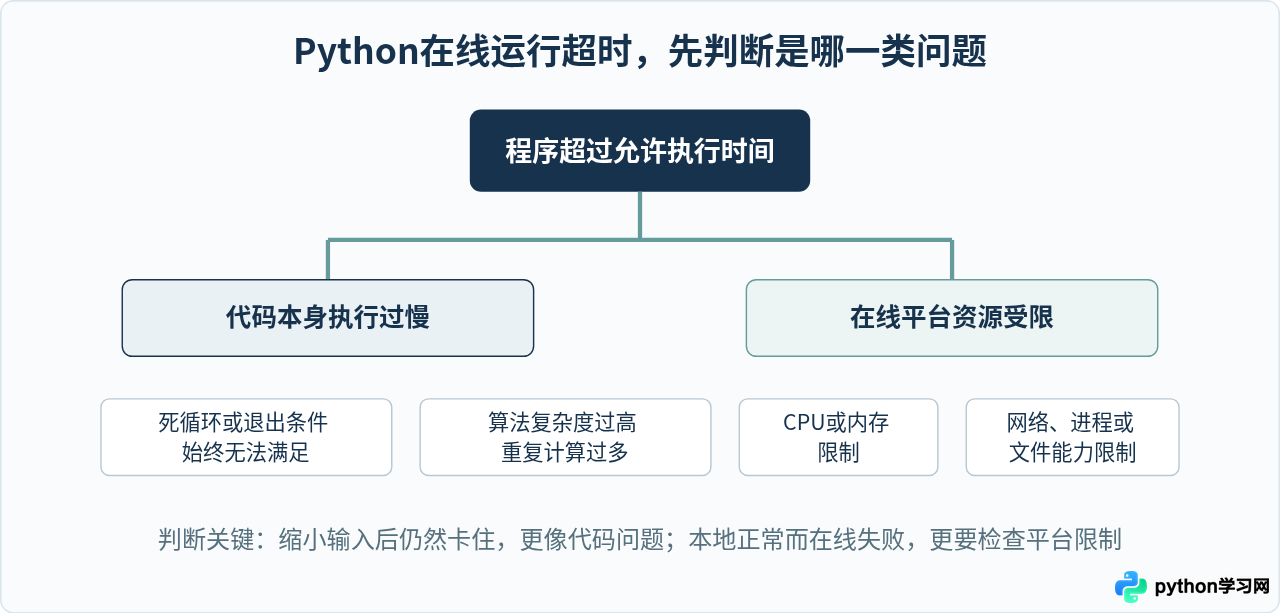
Python在线编译器出现“运行超时”时,不一定是代码写错了。常见原因可以归为两类:一类是代码本身执行时间过长,例如死循环、算法复杂度太高或大量重复计算;另一类是在线平台对CPU时间、内存、网络访问或输入输出进行了限制。处理时不要一看到超时就反复点击运行,而应该先缩小问题范围,再决定优化代码还是换运行环境。
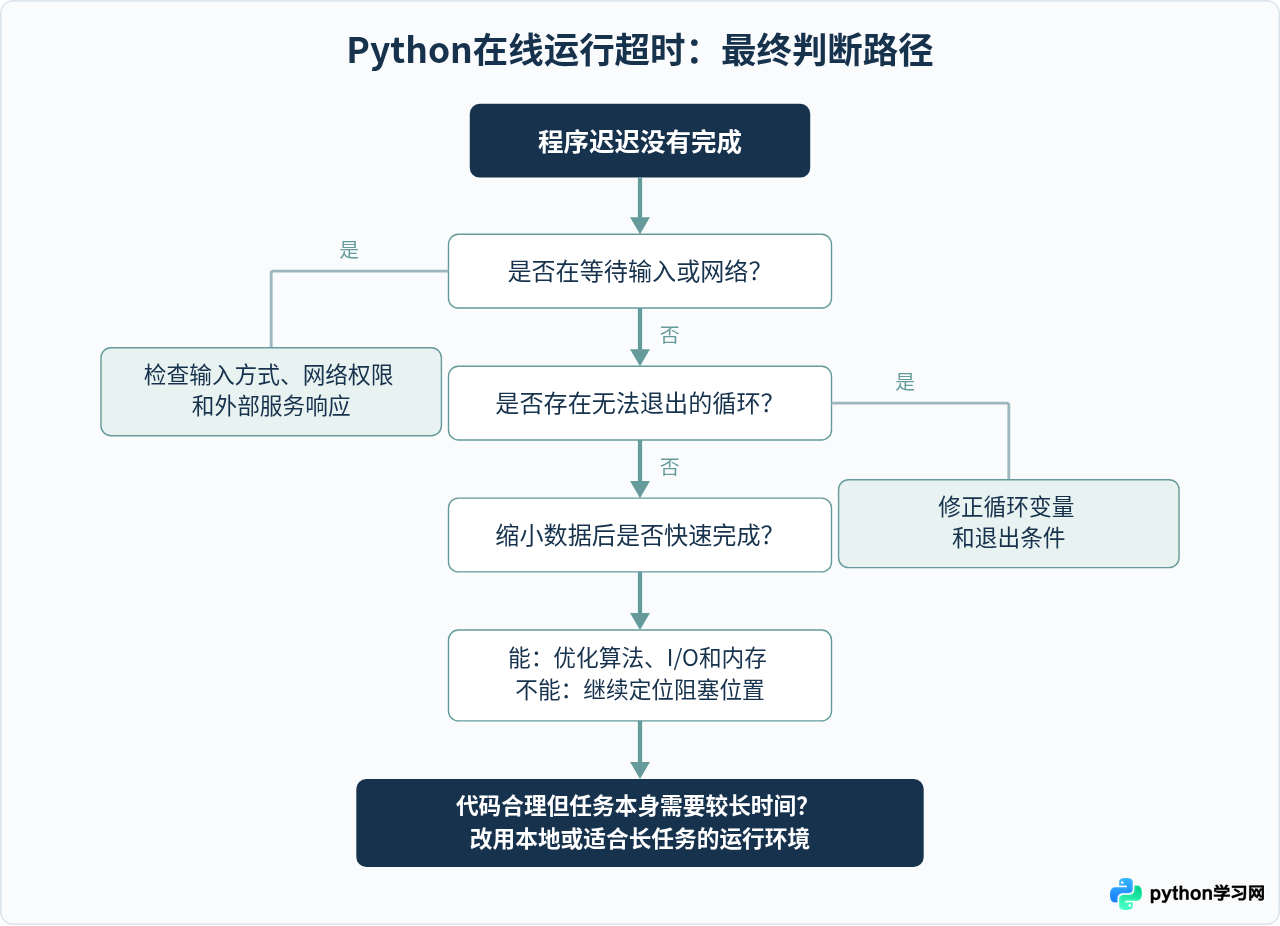
比较实用的处理顺序是:先检查循环和输入,再减少数据规模定位慢点,然后优化算法和I/O;如果代码本身合理,只是任务确实需要较长时间,就不应继续强行塞进在线编译器,而应改用本地Python环境或其他允许长时间运行的环境。
一、先确认是不是真的“运行超时”
在线Python环境出现问题时,页面上可能同时存在多种表现,例如长时间没有结果、被强制终止、提示执行时间超过限制,或者进程直接结束。真正排查之前,先区分“程序仍在等待”和“程序计算太慢”。
一个常见情况是程序正在等待输入:
name = input("请输入姓名:")
print("你好," + name)
如果所使用的在线环境没有明显的交互输入区域,程序可能看起来一直没有完成。此时并不是Python计算速度慢,而是在等待 input()。
调试时可以先把输入临时改成固定值:
name = "Tom"
print("你好," + name)
如果这样能够立即输出结果,就应该检查在线环境提供输入数据的方式,而不是去优化Python执行性能。
另一个容易混淆的问题是网络等待。例如:
import urllib.request

response = urllib.request.urlopen("https://example.com", timeout=5)
data = response.read()
print(len(data))
这段程序依赖外部网络。部分在线运行环境会禁止、限制或代理网络请求。如果程序涉及HTTP请求、数据库连接、Socket或其他外部服务,应当先确认平台是否允许这些操作。
二、第一项重点检查:有没有死循环
对于短小的Python程序,如果在线编译器运行几秒甚至更久仍没有结果,最先应该检查循环退出条件。因为死循环不会随着等待时间增加而自动完成。
例如下面的程序:
count = 0

while count < 10:
print(count)count从未增加,所以条件 count < 10 永远成立。正确写法应该更新循环变量:
count = 0

while count < 10:
    print(count)
    count += 1
还要特别留意那些退出条件隐藏在多个分支中的代码:
while True:
    command = input("请输入命令:")

    if command == "quit":
        break

    print("收到:", command)
这段代码本身并不是错误的死循环,因为输入 quit 后可以退出。但如果在线环境无法提供交互输入,它就不适合直接运行。
三、按照固定顺序排查,通常比反复修改更快
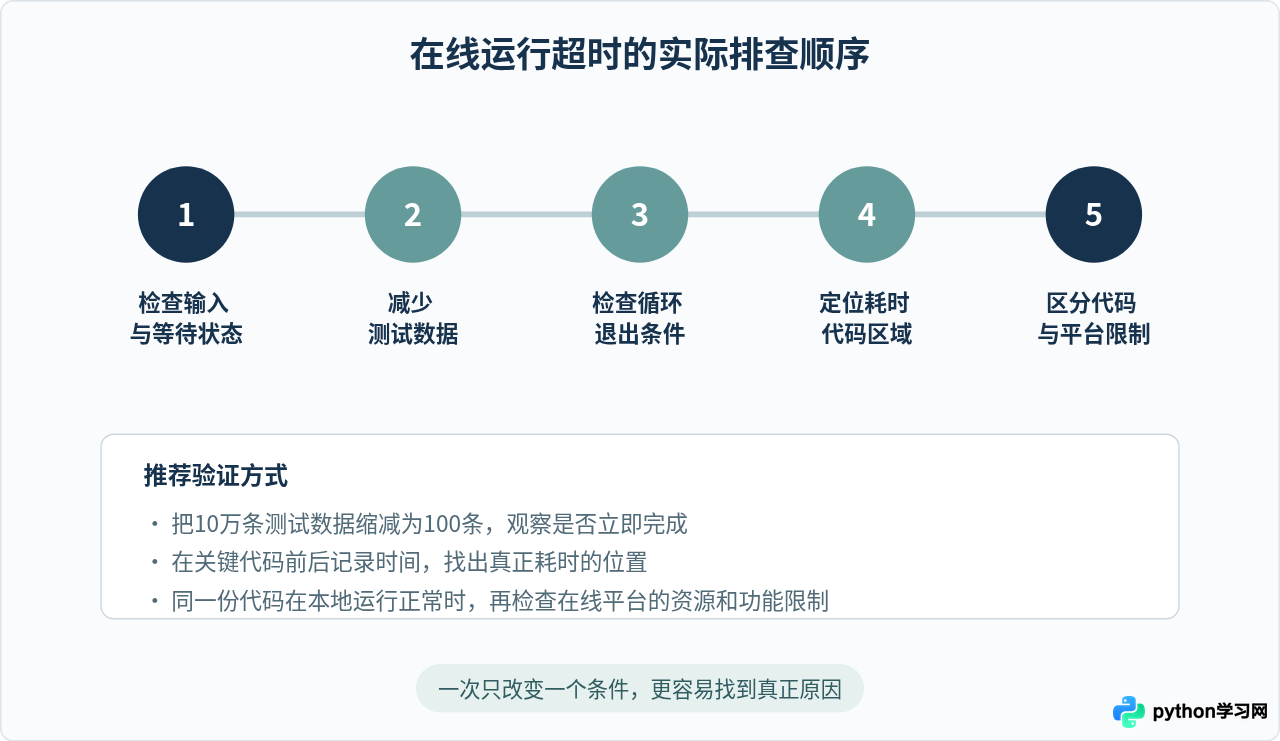
遇到超时时,可以把程序简化到最小可运行范围。比较稳妥的办法不是一开始就重写整个程序,而是按下面的顺序逐项确认。
1. 先把数据量缩小
假设代码需要处理10万条数据,可以先改成100条:
data = list(range(100))

for item in data:
    result = item * item

print("处理完成")
如果100条可以快速完成,而数据增大以后迅速变慢,问题大概率与计算量有关。如果连很小的数据都无法完成,则更应该检查死循环、等待输入或外部资源。
2. 在关键位置测量耗时
可以使用Python标准库中的 time.perf_counter() 做简单定位:
import time

start = time.perf_counter()

total = 0
for i in range(1_000_000):
    total += i

end = time.perf_counter()

print("结果:", total)
print("耗时:", end - start, "秒")
这里的重点不是追求一个固定的耗时数值,而是确定“哪一段代码最慢”。在线平台的机器负载和资源配置可能不同,因此不要把一次测出的时间当成所有环境下的固定结果。
四、检查算法复杂度,避免不必要的重复遍历
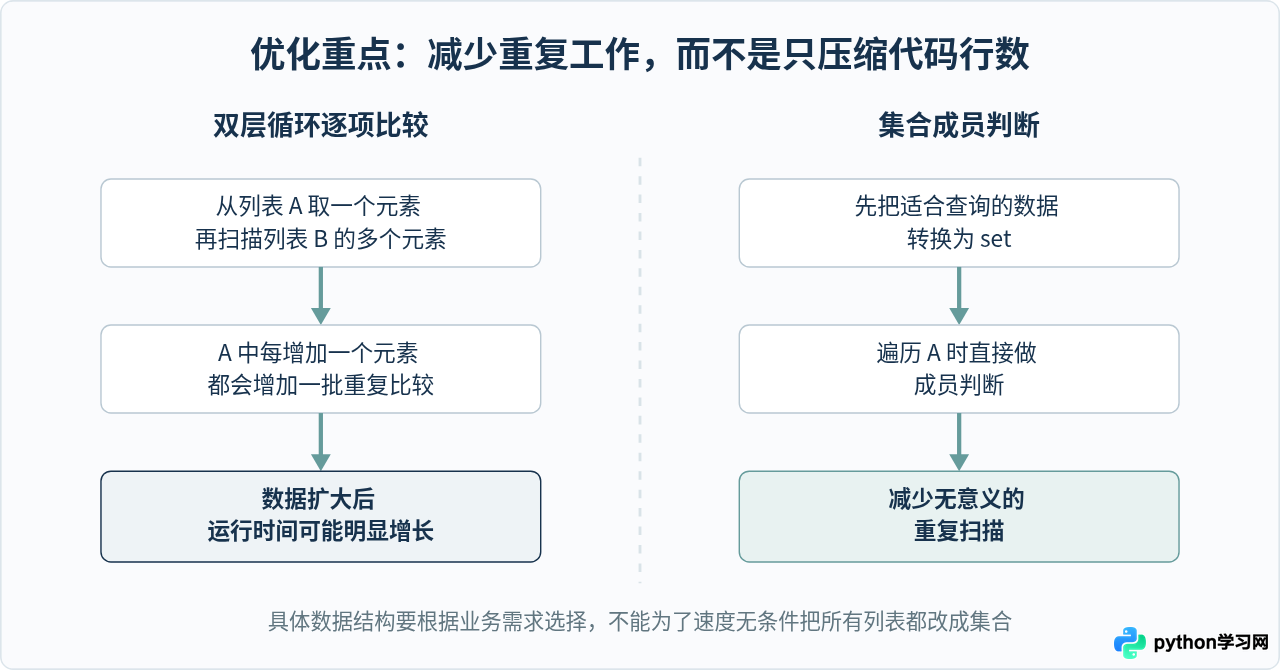
有些程序没有死循环,但算法随着数据规模增长会迅速变慢。在线环境执行时间有限,这类问题更容易暴露出来。
例如,要判断两个列表中有哪些共同元素,下面这种双层循环虽然直观,但数据较大时需要进行大量比较:
a = list(range(5000))
b = list(range(2500, 7500))

common = []

for x in a:
    for y in b:
        if x == y:
            common.append(x)

print(len(common))
如果只是进行成员判断,可以根据数据特点改用集合:
a = list(range(5000))
b = list(range(2500, 7500))

b_set = set(b)
common = []

for x in a:
    if x in b_set:
        common.append(x)

print(len(common))
或者在符合需求的情况下直接进行集合运算:
a = set(range(5000))
b = set(range(2500, 7500))

common = a & b

print(len(common))
示例输出:
2500这里真正值得优化的不是Python语法写得长还是短,而是查找方式。对列表逐项搜索与利用集合进行成员判断,其执行成本并不相同。
五、减少循环中的频繁输出
在线运行环境通常需要把程序输出传回浏览器。如果循环中执行大量 print(),真正拖慢程序的可能不是计算,而是输出过程。
例如:
for i in range(100000):
    print("正在处理:", i)
如果只是确认程序有没有继续执行,没有必要输出每一次循环。可以改成间隔输出:
for i in range(100000):
    if i % 10000 == 0:
        print("当前进度:", i)
对在线环境尤其如此。大量终端输出既增加I/O开销,也可能使浏览器页面需要渲染大量文本。
六、避免在循环内重复执行相同计算
如果某个结果不会随着循环改变,就应该尽量放到循环外计算。
下面的写法会反复求同一个列表的总和:
numbers = list(range(10000))

for i in range(10000):
    total = sum(numbers)
    result = total + i
更合理的方式是:
numbers = list(range(10000))
total = sum(numbers)

for i in range(10000):
    result = total + i
两段代码得到的计算逻辑相同,但后者避免了重复执行 sum(numbers)。
类似情况还包括:
- 在循环里反复读取同一个文件;
- 反复编译同一个正则表达式;
- 反复解析不会变化的配置;
- 反复创建可以复用的数据结构;
- 多次请求实际上不会变化的外部数据。
七、数据量很大时,不要一次性全部装入内存
在线Python环境除了执行时间限制,还可能存在较严格的内存限制。即使CPU计算并不复杂,一次性创建非常大的列表也可能导致程序被终止。
例如下面的写法会先创建完整列表:
numbers = [i * i for i in range(10_000_000)]

total = sum(numbers)
print(total)
如果后续只需要依次读取这些值,可以考虑使用生成器表达式:
numbers = (i * i for i in range(10_000_000))

total = sum(numbers)
print(total)
这样不需要同时把全部平方值保存为一个列表。当然,是否能使用生成器仍然取决于后续处理方式:如果程序必须随机访问全部结果,或者需要多次遍历数据,就不能简单地把列表全部替换成生成器。
八、为什么本地能运行,在线编译器却会超时
这是很常见的情况。在线Python运行环境通常面向代码练习、语法验证、教学演示和小型计算,它与自己的电脑不是同一种运行场景。
在线平台可能对下面这些资源设置限制:
- 单次程序的最长执行时间;
- 可使用的CPU资源;
- 进程可占用的内存;
- 终端输出的数据量;
- 可创建的线程或子进程;
- 文件读写范围;
- 外部网络连接;
- 可以安装或导入的第三方库。
这些限制没有一个适用于所有在线编译器的统一数值,不同平台、不同账户类型甚至不同运行模式都可能不一样。因此,如果某个平台明确显示“Execution timed out”之类的信息,应直接查看该平台当前的运行限制说明,而不是套用其他网站的时间限制。
九、怎样判断是代码慢,还是在线平台限制
可以设计一个很简单的对照测试。
假设原程序需要处理较大数据,先只处理很小的一部分:
def process_item(x):
    return x * x

data = range(100)

results = []

for item in data:
    results.append(process_item(item))

print(results[:10])
示例输出:
[0, 1, 4, 9, 16, 25, 36, 49, 64, 81]如果100条数据正常,1000条也正常,而数据扩大后才超时,通常应该优先分析算法效率和任务规模。
如果很小的数据仍然超时,则重点检查死循环、阻塞、网络和平台功能限制。
如果同一份代码在本地Python中能够按预期完成,而在线环境很快被终止,则更应该查看在线平台的资源限制。不过,本地可以完成并不等于代码没有优化空间,只能说明它在当前本地资源条件下可以运行。
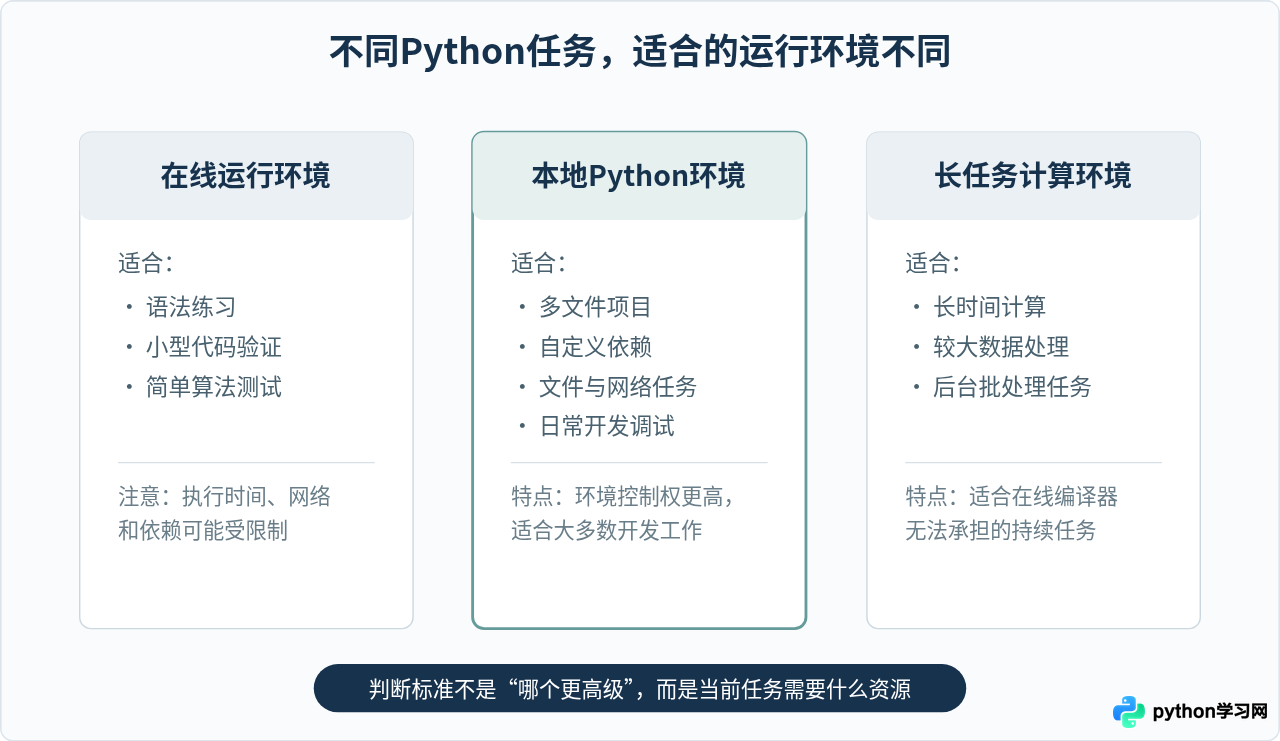
十、什么时候不应该继续使用在线编译器
在线编译器非常适合验证一小段代码。例如测试列表操作、学习循环、检查函数返回值,或者快速复现一个简单错误。但有些任务从一开始就更适合本地环境。
| 任务类型 | 在线环境是否合适 | 更合理的处理方式 |
|---|---|---|
| 几行到几十行的语法练习 | 通常合适 | 直接在线运行 |
| 简单算法题、小规模数据 | 通常合适 | 先在线验证逻辑 |
| 处理大量本地文件 | 通常不方便 | 使用本地Python |
| 长时间数据分析 | 容易受运行时间限制 | 本地环境或适合长任务的计算环境 |
| 大量网络请求 | 取决于平台权限 | 确认网络策略,必要时本地执行 |
| 需要特殊第三方库 | 取决于平台支持 | 使用虚拟环境自行安装依赖 |
| 多文件项目或长期开发 | 通常不适合作为主要开发环境 | 本地IDE或完整开发环境 |
十一、替代方案一:改用本地Python运行
如果程序本身需要持续计算、频繁访问文件,或者依赖较多第三方库,本地运行通常是最直接的替代方案。
假设已经安装Python,可以先在终端检查:
python --version部分系统使用:
python3 --version然后建立项目目录。例如:
mkdir python-timeout-demo
cd python-timeout-demo
创建虚拟环境:
python3 -m venv .venv在macOS或Linux中启用:
source .venv/bin/activate在Windows命令提示符中通常可以使用:
.venv\Scripts\activate随后把程序保存为 main.py:
import time

start = time.perf_counter()

total = sum(range(1_000_000))

end = time.perf_counter()

print("结果:", total)
print("耗时:", end - start, "秒")
在项目目录中运行:
python3 main.pyWindows等环境如果Python命令为 python,则运行:
python main.py本地环境的优势不是“代码一定更快”,而是你通常能够更自由地控制Python版本、依赖、文件、网络和运行时间,也更方便使用性能分析工具。
十二、替代方案二:需要长时间运行时,把任务从交互环境中拆出来
有些程序本身就不是几秒钟能够结束的,例如大量文件转换、批量图片处理、数据清洗或长时间抓取。即使不断优化,它仍然可能需要较长执行时间。
这种任务不适合把“浏览器打开着直到程序结束”作为主要运行方式。更合理的思路是把任务写成独立Python脚本,让程序能够记录进度和错误。
例如:
from pathlib import Path
import time

files = list(Path("./data").glob("*.txt"))

for index, file in enumerate(files, start=1):
    text = file.read_text(encoding="utf-8")

    # 在这里处理文件
    result = text.strip()

    print(f"[{index}/{len(files)}] 已处理:{file.name}")

print("全部处理完成")
对于真正需要持续运行的生产任务,还应考虑日志、失败重试、任务队列、进度保存等机制,而不是单纯提高在线编译器的超时时间。
十三、哪些“优化”其实没有解决问题
反复点击运行
如果代码存在死循环或者复杂度太高,重新执行并不会使它更容易完成。相反,每次运行都会重复同样的问题。
把所有代码压缩成一行
代码行数少不等于执行更快:
result = [x * y for x in range(10000) for y in range(10000)]虽然只有一行,但计算和内存开销仍然非常大。判断性能时应该关注实际执行了多少工作,而不是源码占多少行。
盲目使用多线程
多线程不是所有超时问题的通用解决方案。任务类型、Python实现、网络I/O、CPU计算方式以及平台是否允许创建线程都会影响结果。如果连基本瓶颈都没有定位,就直接增加线程,反而会让程序更难调试。
只想办法提高超时时间
如果程序正常情况下只应该运行几秒,却因为算法错误跑了几分钟,那么增加平台的超时时间只是掩盖问题。只有确认任务本来就需要长时间执行以后,才应该考虑换更适合的运行环境。
十四、一个实用的超时排查示例
假设下面的程序需要从一个列表中找出重复数字:
numbers = list(range(10000)) + [100, 200, 300]

duplicates = []

for i in range(len(numbers)):
    for j in range(i + 1, len(numbers)):
        if numbers[i] == numbers[j]:
            duplicates.append(numbers[i])

print(duplicates)
它没有死循环,但采用了嵌套比较。数据变大以后,需要执行大量比较操作。
如果目的只是找出重复值,可以改成维护“已经见过”和“重复”的集合:
numbers = list(range(10000)) + [100, 200, 300]

seen = set()
duplicates = set()

for number in numbers:
    if number in seen:
        duplicates.add(number)
    else:
        seen.add(number)

print(sorted(duplicates))
示例输出:
[100, 200, 300]这种修改不是为了迎合在线编译器,而是从算法本身减少重复比较。即使以后把程序放到本地运行,也仍然能够从这种优化中受益。
十五、最后按这张判断图处理即可
总结
Python在线编译器运行超时,处理重点并不是单纯想办法“让平台多等一会儿”,而是先判断程序为什么没有在预期时间内完成。
可以把整个处理过程归纳为几个明确的判断:
- 确认程序是不是在等待
input()、网络请求或其他外部资源。 - 检查
while、for等循环是否存在错误的退出逻辑。 - 把输入数据缩小,判断运行时间是否随数据规模迅速增加。
- 定位真正耗时的代码,减少嵌套循环、重复计算和频繁输出。
- 数据较大时关注内存占用,能流式处理时不要无条件一次性加载所有数据。
- 同一程序本地正常而在线失败时,再检查平台的CPU、执行时间、网络、文件和依赖限制。
- 如果任务本身就需要长时间运行,不要把在线编译器当成长期计算环境,改用本地Python或更适合持续任务的运行方式。
对于学习阶段的小程序,在线编译器依然很方便;但当代码开始涉及大量数据、文件处理、第三方依赖、网络请求或持续计算时,运行超时往往也是一个信号:问题可能不再是“怎么让在线编译器跑完”,而是应该优化程序结构,或者把任务迁移到更合适的执行环境。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















