


Python爬虫解析豆瓣电影数据并存入MySQL数据库完整步骤
详细讲解使用Python爬取豆瓣电影Top250榜单数据、解析字段并安全存储到MySQL数据库的完整步骤,包含数据表设计、请求防护与防重写入处理。
完成豆瓣电影数据抓取与入库的核心路径分为四步:使用 requests 构造带有合规请求头的 HTTP 请求以获取 HTML 源码;利用 BeautifulSoup 解析 DOM 树提取电影具体字段;在 MySQL 中建立适配清洗结果的数据表;最后通过 pymysql 建立事务驱动的数据库连接,完成格式转换与防重写入。本文将依序实现这一完整链路。
1. 系统全链路架构与运行环境
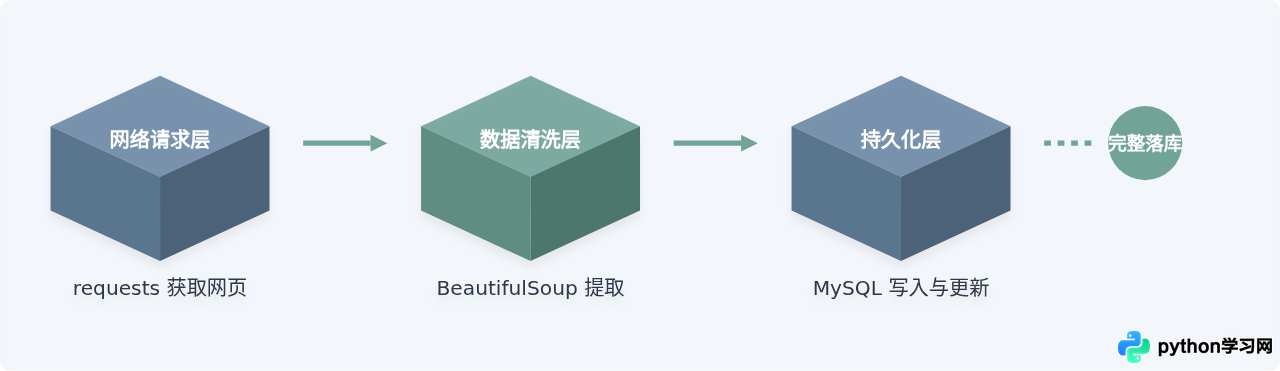
在编写代码前,需要明确程序的数据流动路线。数据流从豆瓣服务器发出,经过本地解析层清洗后,以结构化元组形式推送到本地或远程的 MySQL 实例。该过程中的各个模块各自独立,降低耦合度以便于错误排查。
环境依赖通过终端执行以下命令进行安装:
pip install requests beautifulsoup4 pymysql2. 设计并创建 MySQL 目标数据库与数据表
为什么要在写抓取代码前先建表?因为目标字段的类型、长度限制直接约束了爬虫阶段的数据清洗逻辑。如果不预先明确字段规范,很容易在抓取完成后因字段超出长度或编码异常导致写入失败。
针对豆瓣电影 Top250,我们提取以下关键信息:排名、电影名称、详情页链接、上映年份、评分、评价人数以及经典短评。由于电影名称可能包含中文、外文副标题或特殊符号,字符集统一指定为 utf8mb4。
-- 登录 MySQL 后执行以下 SQL 语句
CREATE DATABASE IF NOT EXISTS douban_db DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_unicode_ci;

USE douban_db;

CREATE TABLE IF NOT EXISTS movies (
    id INT AUTO_INCREMENT PRIMARY KEY COMMENT '自增主键',
    movie_rank INT NOT NULL COMMENT '排名',
    title VARCHAR(150) NOT NULL COMMENT '电影中文标题',
    detail_url VARCHAR(255) NOT NULL UNIQUE COMMENT '电影链接(唯一键防重)',
    pub_year VARCHAR(10) COMMENT '上映年份',
    rating DECIMAL(3, 1) NOT NULL COMMENT '豆瓣评分',
    votes INT NOT NULL COMMENT '评价人数',
    quote VARCHAR(255) COMMENT '短评摘要',
    created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP COMMENT '抓取时间'
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4;
在这里,我们将 detail_url 声明为 UNIQUE。豆瓣每部电影的 URL 都带有独立的数字 ID,天然具备唯一性。这个设置是后续执行“存在即更新、不存在即插入”操作的底层基础。
3. 分析网页结构并使用 Python 抓取与解析
豆瓣电影 Top250 列表页 URL 的分页规律非常明确:第 1 页的 start=0,第 2 页的 start=25,每一页展示 25 部电影,通过修改 start 参数即可遍历全量列表。
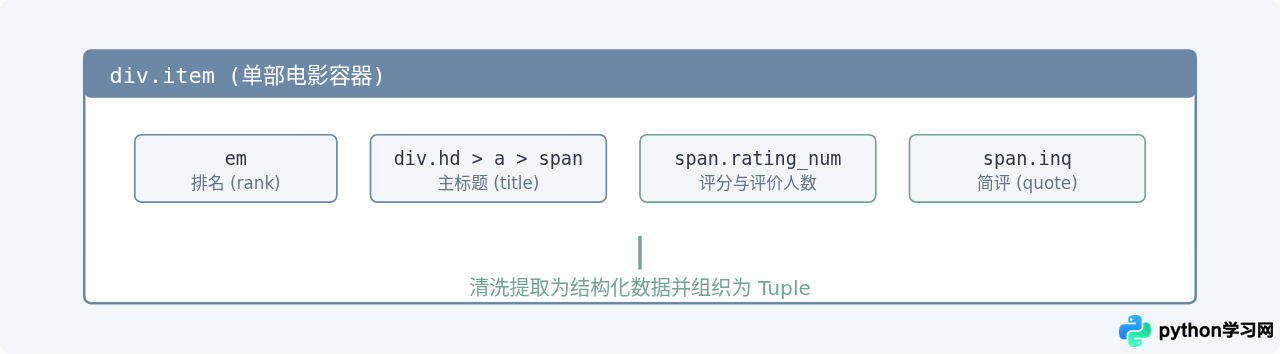
编写爬虫函数解析网页时,需要特别处理两个问题:
- 反爬虫拦截:豆瓣对未附带
User-Agent的请求会直接返回 418 或 403 状态码,必须完整传递浏览器标识。 - 空字段容错:部分电影可能没有经典短评(即页面中不存在
<span class="inq">节点),直接使用.text会抛出AttributeError,应采用三元表达式做空值处理。
import re
import requests
from bs4 import BeautifulSoup

HEADERS = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36'
}

def fetch_movie_page(start_offset):
    url = f"https://movie.douban.com/top250?start={start_offset}&filter="
    try:
        response = requests.get(url, headers=HEADERS, timeout=10)
        if response.status_code == 200:
            return response.text
        print(f"请求失败,HTTP 状态码: {response.status_code}")
        return None
    except requests.RequestException as e:
        print(f"网络请求异常: {e}")
        return None

def parse_html(html_text):
    soup = BeautifulSoup(html_text, 'html.parser')
    movie_cards = soup.find_all('div', class_='item')
    parsed_data = []

    for card in movie_cards:
        # 提取排名
        rank = int(card.find('em').text.strip())

        # 提取标题与链接
        hd_div = card.find('div', class_='hd')
        title = hd_div.find('span', class_='title').text.strip()
        detail_url = hd_div.find('a')['href']

        # 提取主体文本中的上映年份(使用正则匹配连续4位数字)
        bd_p = card.find('div', class_='bd').find('p').text
        year_match = re.search(r'\b(19\d{2}|20\d{2})\b', bd_p)
        pub_year = year_match.group(1) if year_match else "未知"

        # 提取评分与评价人数
        rating = float(card.find('span', class_='rating_num').text.strip())
        votes_str = card.find('div', class_='star').find_all('span')[-1].text
        votes_match = re.search(r'\d+', votes_str)
        votes = int(votes_match.group()) if votes_match else 0

        # 提取推荐语,避免 None 导致异常
        quote_tag = card.find('span', class_='inq')
        quote = quote_tag.text.strip() if quote_tag else ""

        parsed_data.append((rank, title, detail_url, pub_year, rating, votes, quote))

    return parsed_data
4. 编写 MySQL 数据库连接与批处理入库模块
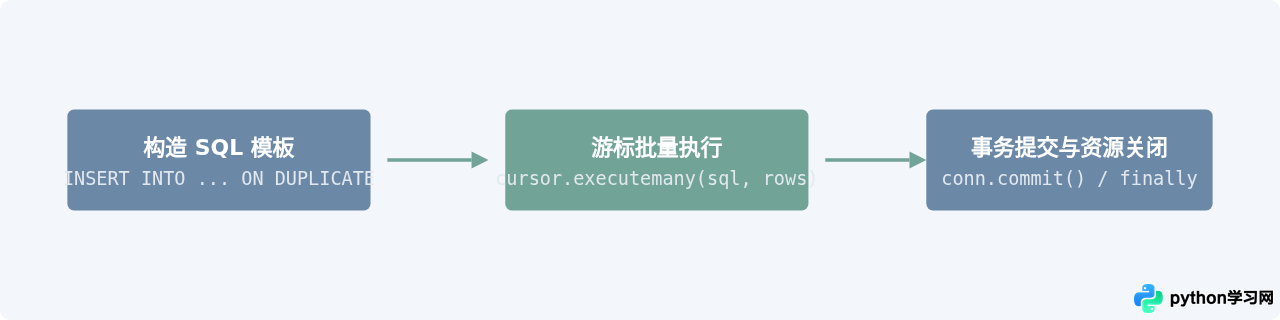
在数据持久化环节,逐行插入会带来频繁的网络 I/O 与事务开销,效率极低。推荐的做法是:单页提取完毕后,使用 executemany 进行批量插入。
同时,为了防止多次重复运行脚本导致数据表中出现重复记录或抛出主键冲突错误,SQL 语句使用 ON DUPLICATE KEY UPDATE。当检测到相同的 detail_url 时,自动更新其评分、评价人数和短评,实现幂等写入。
import pymysql

# 依据本地 MySQL 配置修改连接参数
DB_CONFIG = {
    'host': 'localhost',
    'port': 3306,
    'user': 'root',
    'password': 'your_password',
    'database': 'douban_db',
    'charset': 'utf8mb4'
}

def save_movies_to_mysql(movie_records):
    if not movie_records:
        return

    insert_sql = """
    INSERT INTO movies (movie_rank, title, detail_url, pub_year, rating, votes, quote)
    VALUES (%s, %s, %s, %s, %s, %s, %s)
    ON DUPLICATE KEY UPDATE
        movie_rank = VALUES(movie_rank),
        rating = VALUES(rating),
        votes = VALUES(votes),
        quote = VALUES(quote);
    """

    connection = None
    try:
        connection = pymysql.connect(**DB_CONFIG)
        with connection.cursor() as cursor:
            # 批量写入数据集合
            cursor.executemany(insert_sql, movie_records)
        # 显式提交事务
        connection.commit()
        print(f"成功保存/更新 {len(movie_records)} 条记录到数据库。")
    except pymysql.MySQLError as err:
        print(f"MySQL 写入失败,触发回滚: {err}")
        if connection:
            connection.rollback()
    finally:
        if connection and connection.open:
            connection.close()
5. 串联完整调度程序与运行验证
将抓取逻辑、解析逻辑与存储逻辑统一整合到主循环中。为防止对目标服务器造成过大瞬时压力,抓取每一页后需设置适当的等待时间(推荐 1.5 到 3 秒)。
import time
import random

def run_spider():
    print("开始抓取豆瓣电影 Top250 数据...")
    # Top250 一共有 10 页,每页 25 部
    for page in range(0, 250, 25):
        page_num = page // 25 + 1
        print(f"正在处理第 {page_num} 页 (offset={page})...")

        html_content = fetch_movie_page(page)
        if not html_content:
            print(f"第 {page_num} 页抓取中断,进入下一页。")
            continue

        data = parse_html(html_content)
        save_movies_to_mysql(data)

        # 控制抓取节奏,避免被封 IP
        sleep_time = random.uniform(1.5, 3.0)
        time.sleep(sleep_time)

    print("全部抓取任务完成。")

if __name__ == '__main__':
    run_spider()
执行该主程序后,可以在 MySQL 终端中查询数据,验证入库结果:
USE douban_db;
-- 查看入库总数
SELECT COUNT(*) FROM movies;
-- 查看前 5 条样本
SELECT movie_rank, title, rating, votes, pub_year FROM movies ORDER BY movie_rank ASC LIMIT 5;
正常情况下,终端将显示 250 条记录完整存入,评分与年份等信息均已完成清洗规整。
6. 流程执行要点与常见问题总结
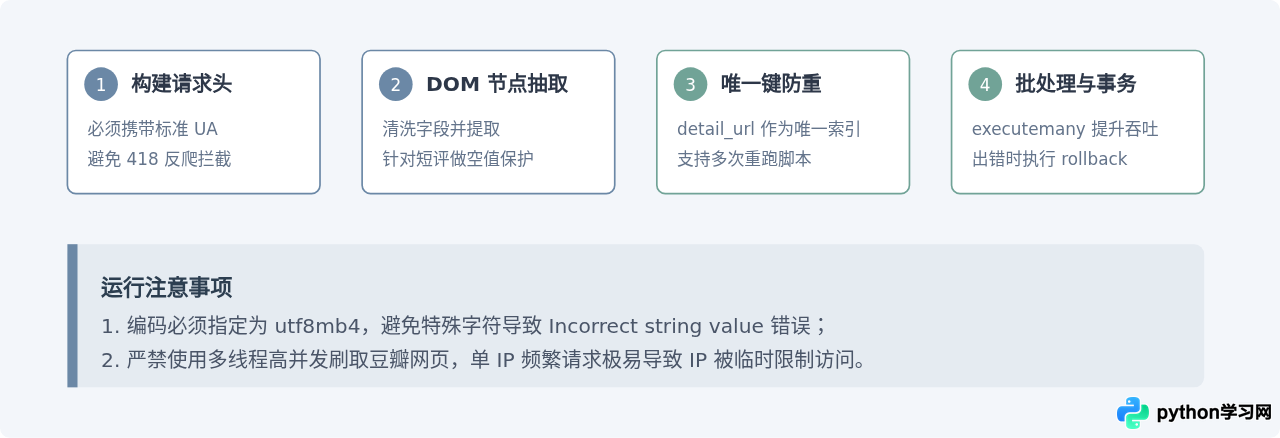
InternalError: (1366, "Incorrect string value..."),说明 MySQL 数据库或表的字符集未正确设置为 utf8mb4。执行 ALTER TABLE movies CONVERT TO CHARACTER SET utf8mb4; 即可修复。
按照上述步骤配置后,整个程序便具备了网络请求重试基础、DOM 容错提取能力以及稳定的数据库幂等持久化机制,能够独立完成豆瓣电影数据的端到端抓取与安全存储。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















