


Python定义数组(列表)的5种常用方法
全面解析在Python中定义数组与列表的5种常用方法:方括号字面量、list()构造函数、乘法运算符重复、列表推导式以及标准库array模块。深入分析一维与多维初始化原理及内存引用机制,助你写出高效、无Bug的代码。
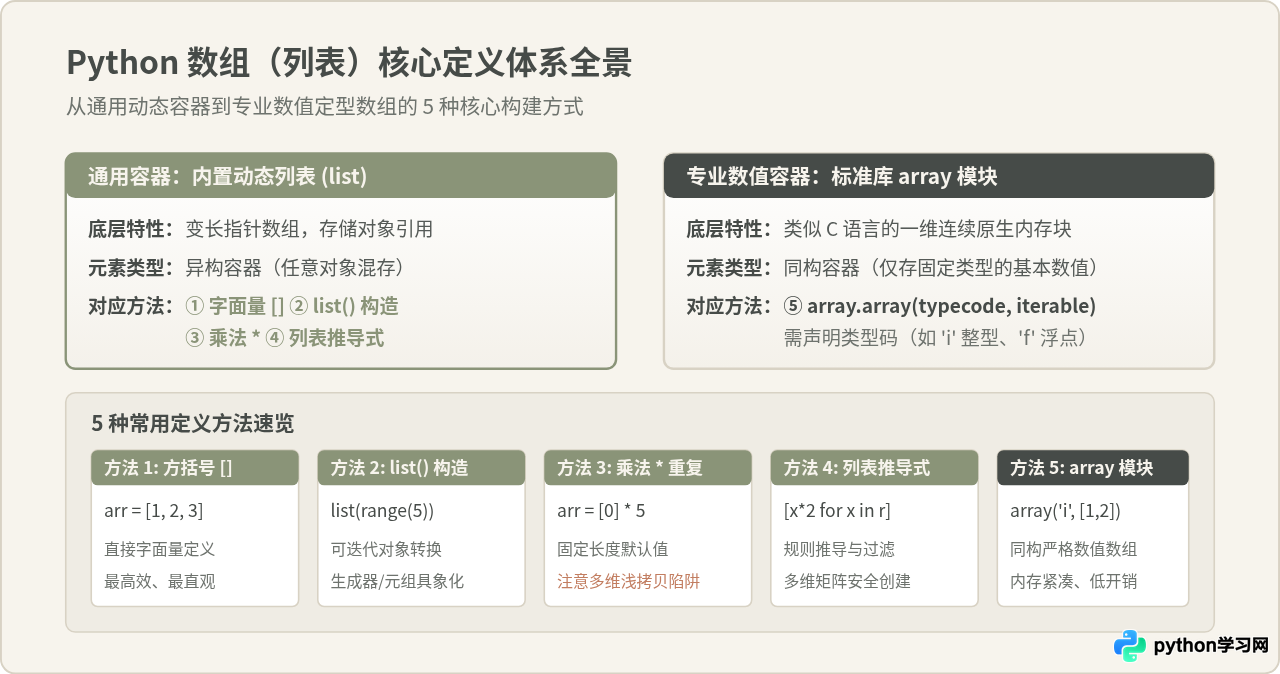
array 关键字;日常开发中被广泛当作“数组”使用的是功能强大的动态可变序列 列表(list)。本文直接聚焦这一核心需求,完整讲解定义一维与多维数组(列表)的 5 种常用方法,剖析每种方式的语法、内存机制及多维嵌套陷阱,帮助读者根据具体场景写出安全高效的代码。
一、概念澄清:Python 中的“列表”与“数组”
初学 Python 时容易产生一个疑问:“Python 究竟有没有数组?”有观点认为“Python 只有列表,完全没有数组”,也有观点认为“列表就是数组”。这两种说法都有其观察视角,但需要结合具体上下文来理解。
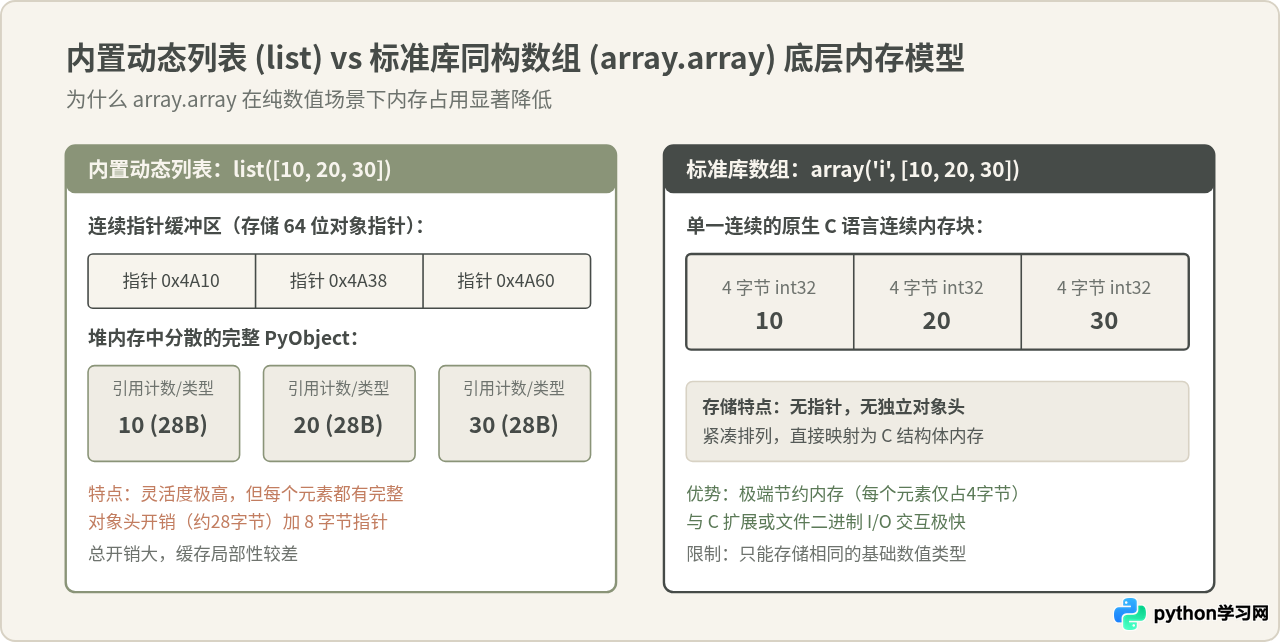
在绝大多数业务逻辑、算法练习与通用脚本中,Python 的内置 list 是连续指针缓冲区的动态实现,不仅支持按索引常数时间 \(O(1)\) 随机访问,还自带动态扩容机制。因此,开发者通常直接将 list 当作一维或多维数组使用。然而,list 是异构容器,列表中存放的并非直接的紧凑原始数据,而是指向具体对象的指针。如果程序需要处理数以千万计的纯数字,或者需要与底层的 C 库进行内存级交互,Python 标准库还专门提供了 array 模块,第三方生态中亦有成熟的 numpy.ndarray。保留这一概念区分,有助于我们根据性能与类型需求做出清晰的选择。
二、方法一:方括号字面量定义(最直接的基础方式)
使用方括号 [] 是 Python 中最直观、也是语法解析开销最低的定义方式。Python 编译器会将其直接编译为高效的专用字节码(BUILD_LIST),无需额外的函数名查找和入栈开销。
1. 具体操作与代码示例
# 1. 定义一个初始为空的数组(列表)
empty_arr = []

# 2. 定义包含初始整数的一维数组
numbers = [10, 20, 30, 40, 50]

# 3. 定义直接包含子列表的二维数组(矩阵)
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]

print("空数组长度:", len(empty_arr))
print("一维数组首元素与末元素:", numbers[0], numbers[-1])
print("二维数组第2行第3列:", matrix[1][2])一维数组首元素与末元素: 10 50
二维数组第2行第3列: 6
适用场景:已知初始元素内容、定义空容器以便后续通过 append() 追加,或直接书写固定尺寸的静态多维数据。
三、方法二:使用 list() 内置构造函数
list() 是 Python 的内置类型构造器。与方括号相比,它的核心价值在于将任意可迭代对象(如 range、元组、字符串、集合、生成器)强制转换为列表实体。
1. 具体操作与代码示例
# 1. 构造一个空列表
arr_empty = list()

# 2. 将 range 迭代器转换为连续整数数组
arr_range = list(range(1, 8))

# 3. 将不可变的元组转换为可修改的数组
tuple_data = (100, 200, 300)
arr_from_tuple = list(tuple_data)

# 4. 将字符串拆解为字符数组
chars = list("Python")

print("连续整数数组:", arr_range)
print("由元组转换得到:", arr_from_tuple)
print("字符数组:", chars)由元组转换得到: [100, 200, 300]
字符数组: ['P', 'y', 't', 'h', 'o', 'n']
list = [1, 2, 3]。这样做会遮蔽(Shadow)全局命名空间中的内置构造函数,导致后续调用 list() 时抛出 TypeError: 'list' object is not callable 错误。
四、方法三:乘法运算符生成固定长度数组及多维陷阱
当需要预先分配一个长度已知、初始值相同的数组作为缓冲区时,使用乘法运算符 * 能够快速初始化。然而,这种写法在一维与多维情况下有着截然不同的内存行为,极易引发难以察觉的连锁修改错误。
1. 一维列表的安全乘法
在定义一维定长列表时,乘法复制的是元素本身。对于不可变类型(如整数 0、浮点数或 None),后续修改某个槽位只会让该索引指向新的对象,互不干扰:
# 创建长度为 6、初始值全为 0 的一维数组
arr_fixed = [0] * 6
arr_fixed[0] = 99

print("一维修改结果:", arr_fixed)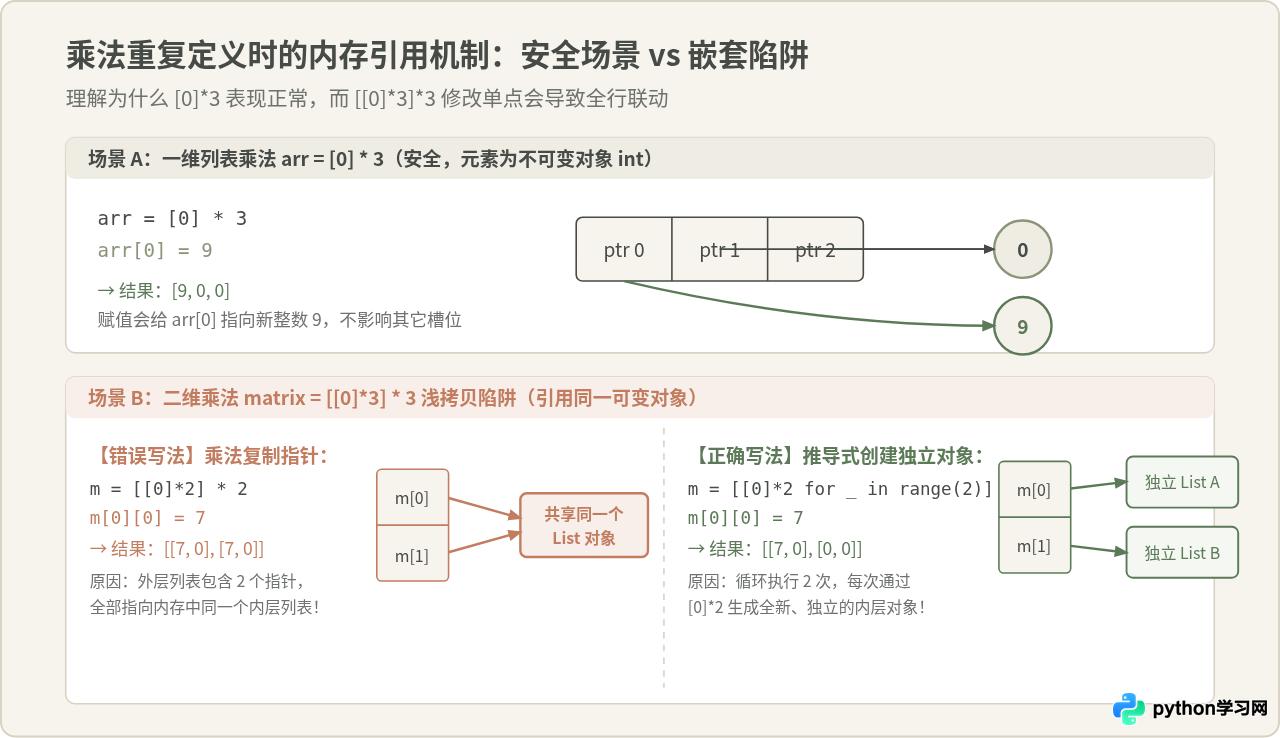
2. 二维列表的“浅拷贝”陷阱与反例剖析
许多开发者在尝试创建一个 3 行 3 列全 0 矩阵时,会下意识地写出 [[0] * 3] * 3。这种写法看似简洁,但外层的 * 3 复制的不是独立的内层列表,而是同一个内层列表的引用指针:
# 【错误写法反例】
matrix_wrong = [[0] * 3] * 3

# 修改第 0 行第 0 列的值
matrix_wrong[0][0] = 7

# 查看输出,会发现每一行的第 0 列全部变成了 7!
print("错误定义的矩阵结果:")
for row in matrix_wrong:
print(row)[7, 0, 0]
[7, 0, 0]
[7, 0, 0]
matrix_wrong[0]、matrix_wrong[1] 和 matrix_wrong[2] 实际指向内存中的同一块地址(id(matrix_wrong[0]) == id(matrix_wrong[1]) 返回 True)。如果要安全创建多维矩阵,必须使用下文介绍的方法四(列表推导式),确保每次外层循环都调用构造逻辑生成全新对象。
五、方法四:列表推导式(灵活规则与安全多维矩阵)
列表推导式(List Comprehension)是 Python 最具特色的语法之一。它不仅语义凝练,而且由于循环与追加过程在 CPython 虚拟机底层高度优化,执行速度通常优于手动编写的 for 循环加 append()。
1. 规则生成与条件过滤示例
# 1. 计算 0 到 5 的平方数数组
squares = [x ** 2 for x in range(6)]

# 2. 结合条件过滤:仅提取 1 到 20 之间的偶数
evens = [x for x in range(1, 21) if x % 2 == 0]

print("平方数数组:", squares)
print("偶数筛选数组:", evens)偶数筛选数组: [2, 4, 6, 8, 10, 12, 14, 16, 18, 20]
2. 安全构建多维矩阵的标准范式
要构建一个 \(3 imes 4\) 的独立二维数组,正确的标准写法是在外层使用推导式:
rows, cols = 3, 4

# 外层循环保证每次都重新评估 [0] * cols,创建独立的内层列表
matrix_safe = [[0] * cols for _ in range(rows)]

# 验证单点赋值
matrix_safe[0][0] = 88
print("正确构建的安全矩阵:")
for row in matrix_safe:
print(row)[88, 0, 0, 0]
[0, 0, 0, 0]
[0, 0, 0, 0]
此时 matrix_safe[0] 与 matrix_safe[1] 彼此完全隔离,赋值操作符合预期。
六、方法五:使用 array 模块定义严格类型的同构数组
如果业务场景要求处理大量基本数据(例如从传感器读取的数百万个整数),且对内存开销有严苛要求,Python 标准库自带的 array.array 是最契合原生“数组”定义的组件。
1. 语法规则与类型代码
array.array(typecode, [initializer]) 在初始化时必须指定一个字符作为类型代码(Type Code),代表底层的 C 语言基本数据类型。常见的类型代码包括:
'b'/'B':带符号/无符号 1 字节整数(signed/unsigned char)'i'/'I':带符号/无符号 4 字节整数(signed/unsigned int)'f':4 字节单精度浮点数(float)'d':8 字节双精度浮点数(double)
2. 具体操作与代码示例
import array

# 1. 定义一个有符号 32 位整型数组(类型码 'i')
int_arr = array.array('i', [10, 20, 30, 40])

# 2. 支持追加元素(必须为整数)
int_arr.append(50)

# 3. 定义双精度浮点数组(类型码 'd')
float_arr = array.array('d', [1.5, 2.7, 3.14159])

print("整数数组:", int_arr)
print("数组元素类型字节数:", int_arr.itemsize, "字节")
print("浮点数组:", float_arr)

# 类型检查保护演示:若存入错误类型将直接报错
try:
    int_arr.append(3.14)  # 尝试向整型数组插入浮点数
except TypeError as e:
print("触发类型约束错误:", e)数组元素类型字节数: 4 字节
浮点数组: array('d', [1.5, 2.7, 3.14159])
触发类型约束错误: 'float' object cannot be interpreted as an integer
七、5 种定义方式的核心特性对比与选型决策
为了让不同场景下的选型更加清晰明确,下表总结了 5 种定义方式的语法特征、适用边界及性能表现:
| 方法 | 典型语法形式 | 数据类型约束 | 主要应用场景 | 核心注意事项 |
|---|---|---|---|---|
| 1. 方括号字面量 | [1, 2, 3] 或 [] |
异构(无约束) | 静态已知数据、空列表初始化 | 执行速度最快,无函数开销 |
| 2. list() 构造 | list(range(10)) |
异构(无约束) | 可迭代对象转列表、不可变类型具象化 | 避免将自定义变量命名为 list |
| 3. 乘法运算符 | [0] * 100 |
异构(无约束) | 一维已知长度缓冲区 | 切勿直接用于二维矩阵创建(浅拷贝) |
| 4. 列表推导式 | [x*2 for x in seq] |
异构(无约束) | 公式生成、条件过滤、多维独立矩阵 | 保持嵌套不超过 2 层以保证可读性 |
| 5. array 模块 | array('i', [1, 2]) |
同构(强数值类型) | 超大数据集、二进制I/O、内存敏感场景 | 需导入标准库,无法混存非数值对象 |
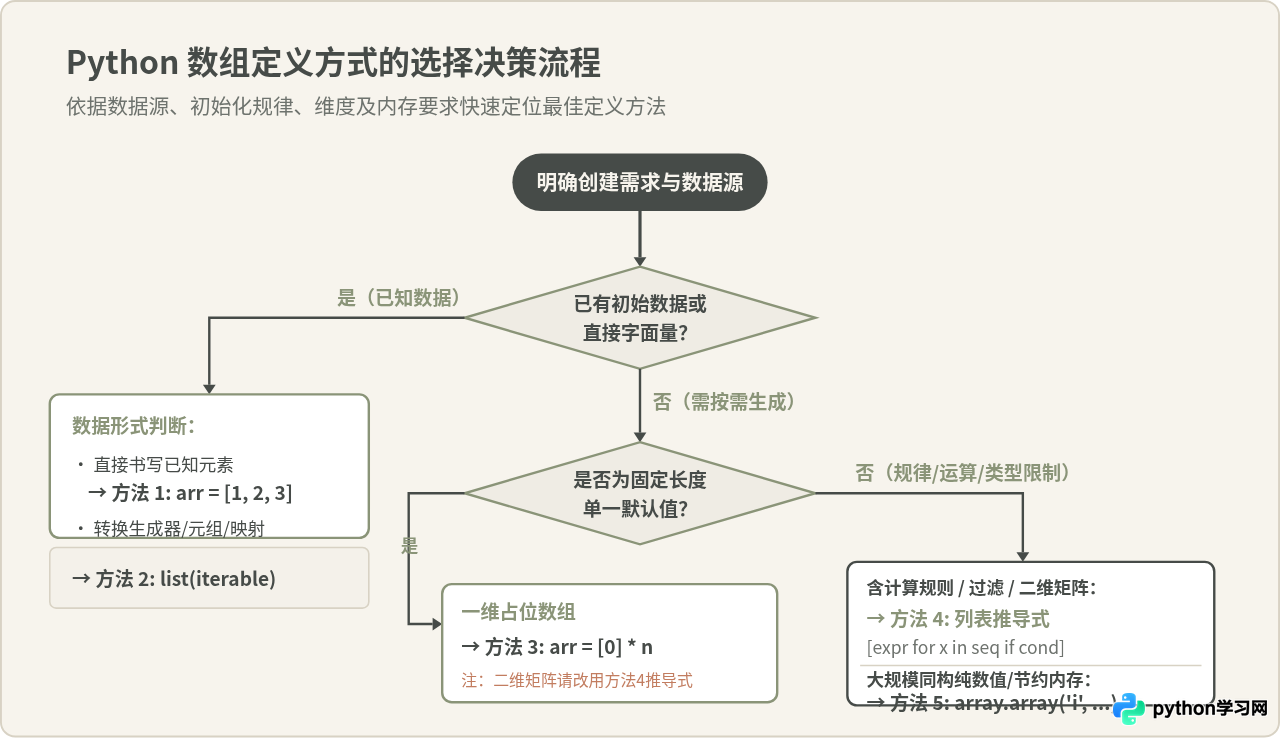
八、总结与避坑速查
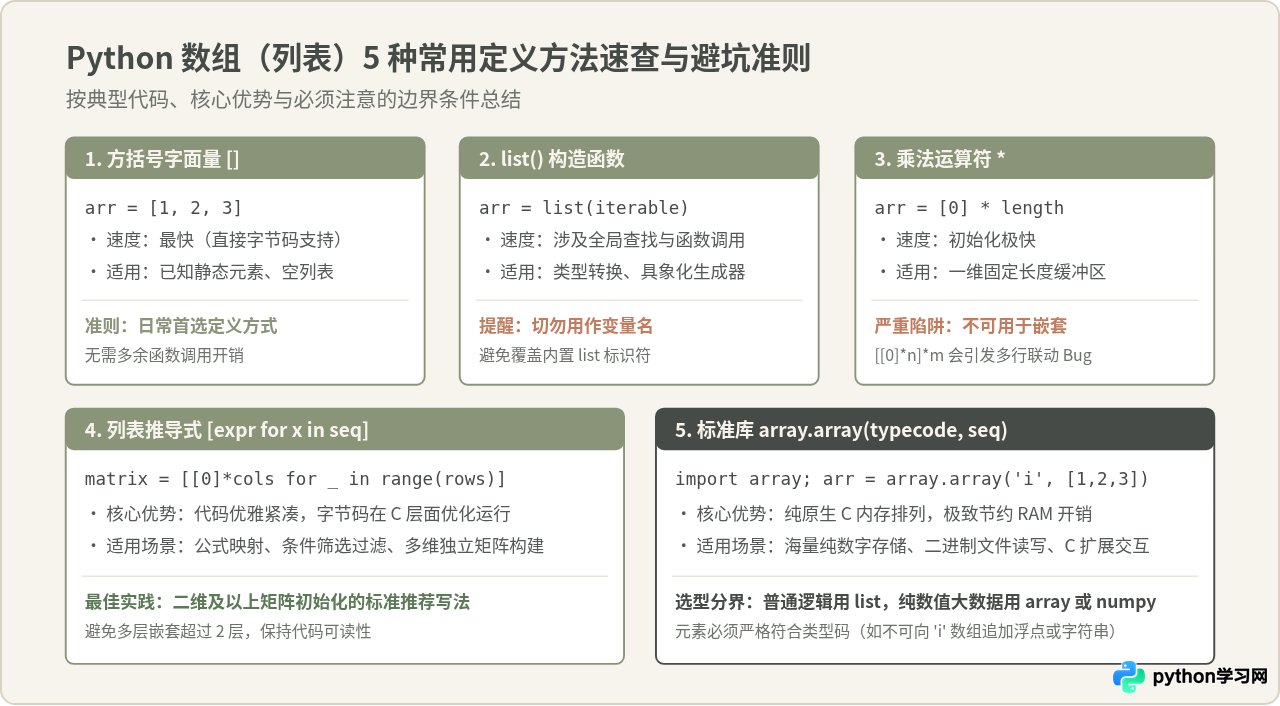
在 Python 日常编程中,定义数组或列表并非只有单一解法。掌握这 5 种方式的核心差异,可以让我们在面对不同需求时游刃有余:
- 定义日常通用一维数据时,优先使用简洁高效的方括号
[]。 - 处理已有序列或生成器转换时,采用标准的
list()构造器。 - 分配一维连续占位缓冲区时,使用
[None] * n或[0] * n最为简练。 - 初始化多维矩阵或带有逻辑运算的数据时,务必使用列表推导式
[[0]*cols for _ in range(rows)]规避浅拷贝风险。 - 在面对百万级别以上的纯数值计算且不引入第三方重量级库时,选择
array.array能够带来数倍的内存节约与更高的传输性能。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















