


Python multiprocessing共享内存:Value、Array与Manager的使用指南

在 Python 多进程编程中,由于每个进程都拥有独立的内存空间与专有的 Python 解释器状态,常规全局变量在子进程中被独立复制,无法直接通过变量赋值实现跨进程数据共享。针对需要多进程协作读写统一状态的场景,标准库 multiprocessing 提供了两大核心解决路径:基于底层操作系统共享内存的 Value 与 Array,以及基于独立服务器进程代理模型的 Manager。本文将系统剖析它们的核心原理、典型操作范式、同步锁防护机制及生产选型权衡。
一、进程内存隔离与共享状态机制解析
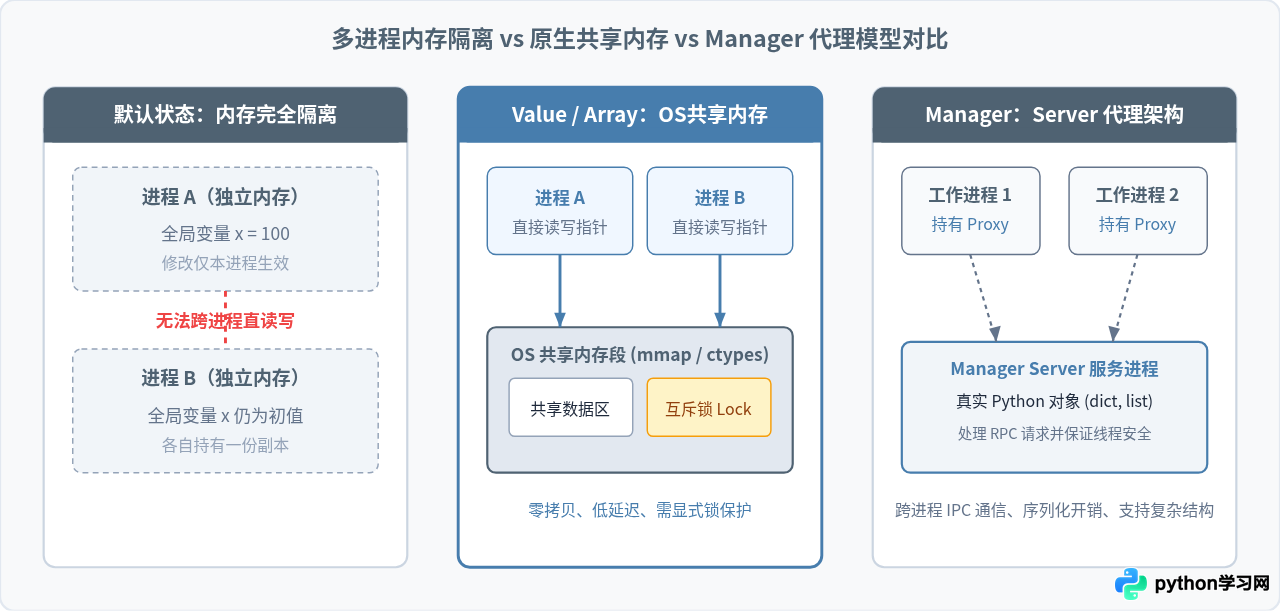
为克服全局解释器锁(GIL)对 CPU 密集型任务的并发限制,Python 采用多进程架构。操作系统赋予每个子进程独立的虚拟内存页表,使得进程空间在物理和逻辑层面均严格隔离。当需要在多个进程间协同更新同一指标(如全局计数器、模型参数权重、任务进度字典)时,必须借助明确的跨进程同步机制。
在 multiprocessing 内部,主要存在两种截然不同的共享机制:
- 原生共享内存(Value / Array):通过操作系统的匿名映射区(如 POSIX 共享内存或
mmap)开辟连续物理内存块,直接绑定为 C 语言底层的ctypes结构。子进程直接通过内存地址进行物理映射,数据访问零拷贝且无需序列化,读写吞吐极高。 - 托管代理机制(Manager):启动一个独立的后台服务端管理进程(Server Process),真实 Python 对象(如
dict、list)仅驻留在该服务端中。工作进程持有的只是一个轻量级的代理对象(Proxy Object),所有方法调用均通过管道或本地 Socket 序列化为 RPC 请求派发执行。
二、轻量高效的底层共享内存:Value 与 Array
当需要共享的数据属于基础数值类型(如整数、浮点数、字符)或固定长度的一维数组时,multiprocessing.Value 与 multiprocessing.Array 是性能最高、资源占用最小的选择。
1. 底层类型码与定义规范
Value 与 Array 依赖底层 C 语言的 ctypes 存储。定义共享对象时,第一个参数必须是标准的数据类型码(Type Code)或 ctypes 类型对象:
| 类型码 | 对应 C 语言类型 | Python 等价类型 | 常见应用场景 |
|---|---|---|---|
'i' |
signed int | int(32位带符号整数) | 并发全局任务计数器、状态标志位 |
'd' |
double | float(64位双精度浮点) | 全局累计耗时、浮点权重累加 |
'c' |
char | 长度为 1 的 bytes | 单字符通信协议标志 |
'b' |
signed char | int(8位整数) | 布尔值或轻量级枚举状态 |
2. Value 与 Array 的基本语法
访问和修改 Value 实例必须通过其 .value 属性进行;而 Array 表现为一个具有固定长度的可迭代对象,支持类似列表的索引与切片操作:
from multiprocessing import Process, Value, Array

# 声明一个初始值为 0 的共享整型变量
counter = Value('i', 0)

# 声明一个长度为 5、初始值均为 0.0 的双精度共享数组
scores = Array('d', [0.0] * 5)

# 读取与修改
counter.value += 1
scores[0] = 98.5
3. 竞态条件与锁保护机制(get_lock)
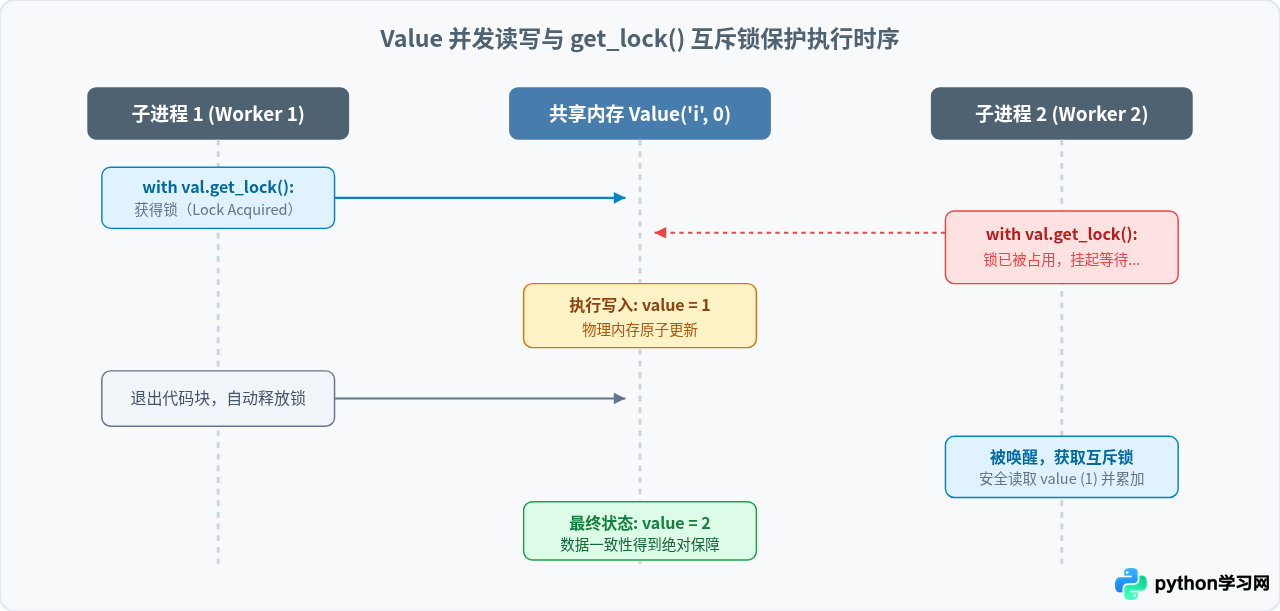
尽管多个进程访问的是同一块物理内存,但类似 counter.value += 1 的操作在底层并非原子指令(它包含“读取内存”、“寄存器递增”、“写回内存”三步)。如果两个进程同时读取到旧值,就会发生写回覆盖,造成丢失更新(Lost Updates)。
Value 和 Array 默认均内置了一个互斥锁(multiprocessing.RLock)。在进行复合读写时,必须通过上下文管理器 with obj.get_lock(): 获取该锁,以保证操作的原子性与排他性。
4. 完整代码示例:并发计数与 Array 协同
from multiprocessing import Process, Value, Array
import time

def worker_task(proc_id, shared_val, shared_arr):
    # 对共享标量累加 1000 次(使用互斥锁防丢失更新)
    for _ in range(1000):
        with shared_val.get_lock():
            shared_val.value += 1

    # 每个进程负责独立填充数组的特定插槽
    shared_arr[proc_id] = (proc_id + 1) * 10.5

if __name__ == '__main__':
    # 实例化共享变量:整型初值 0,双精度浮点数组长度 4
    total_count = Value('i', 0)
    result_array = Array('d', [0.0] * 4)

    processes = []
    for i in range(4):
        p = Process(target=worker_task, args=(i, total_count, result_array))
        processes.append(p)
        p.start()

    for p in processes:
        p.join()

    print(f"最终累计计数值: {total_count.value}")
print(f"各进程产出的数组内容: {list(result_array)}")最终累计计数值: 4000
各进程产出的数组内容: [10.5, 21.0, 31.5, 42.0]三、灵活高级的托管对象:Manager 详解
Value 与 Array 仅局限于单一数值与连续扁平数组,无法支持 Python 中丰富的原生数据结构(如字典 dict、列表 list、集合 set 或自定义类)。multiprocessing.Manager() 提供了高阶方案,允许在进程间共享任意 Python 原生容器。
1. Server-Proxy 协作架构
当执行 manager = multiprocessing.Manager() 时,主进程会创建一个独立的后台服务端子进程。工作进程使用 manager.dict() 或 manager.list() 时,服务端在本地内存中实例化对应的真实对象,并返回给工作进程一个代理对象(Proxy Object)。
代理对象截获所有的公有方法调用(如 __getitem__, __setitem__, append 等),利用 IPC 管道与服务端通信,在服务端执行真实修改并将结果返回。因此,即使数据结构极度复杂,工作进程也可以如同操作本地对象一般安全使用。
2. 致命陷阱:嵌套容器修改失效
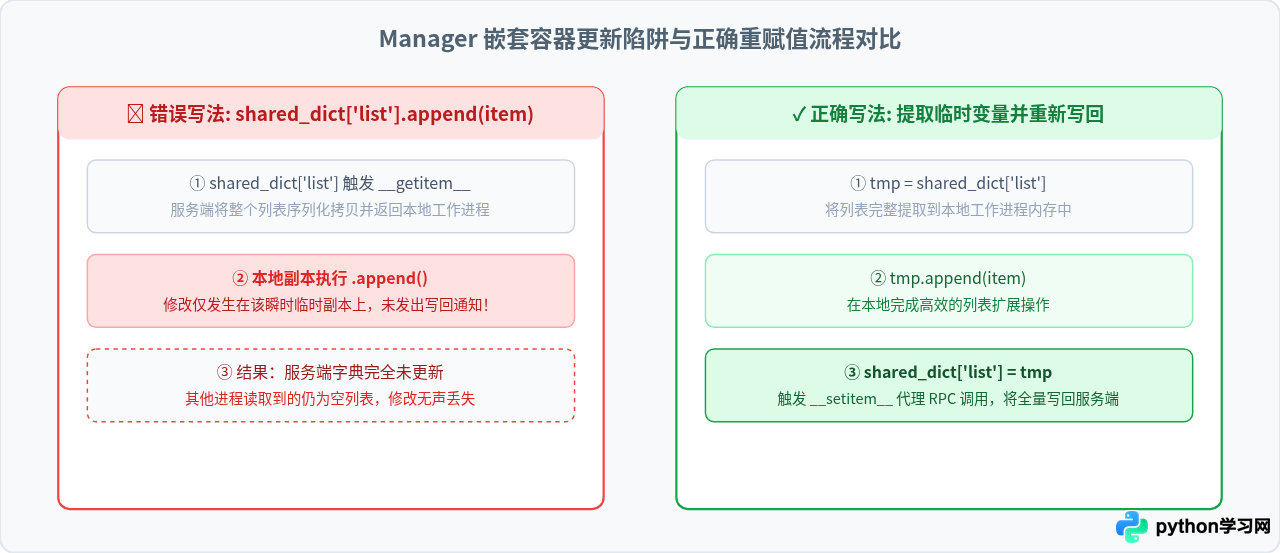
在开发中使用 Manager 最常见、最隐蔽的 Bug 是对嵌套可变对象(Mutable Object)的原地修改不会同步生效。
例如,若字典的值是一个列表:shared_dict['items'] = []。当执行 shared_dict['items'].append(100) 时,Python 首先调用 shared_dict['items'],代理对象通过网络拉取了一份列表的深拷贝本地副本,随后在本地副本上执行了 .append(),并没有触发字典本身的 __setitem__ 代理钩子。最终服务端中的真实字典毫发无损,数据悄然丢失。
3. Manager 完整实操:任务收集与状态统计
from multiprocessing import Process, Manager
import time

def process_worker(task_name, shared_metrics, shared_log):
    # 模拟耗时任务
    time.sleep(0.1)

    # 顶层键值修改直接触发代理 RPC 更新
    shared_metrics[task_name] = f"SUCCESS (pid={task_name})"

    # 对嵌套列表的正确更新:提取 -> 修改 -> 赋值写回
    current_logs = shared_log['all_records']
    current_logs.append(f"Task {task_name} executed successfully")
    shared_log['all_records'] = current_logs

if __name__ == '__main__':
    # 推荐使用上下文管理器安全管理 Manager 服务生命周期
    with Manager() as manager:
        metrics = manager.dict()
        logs = manager.dict({'all_records': []})

        procs = []
        for name in ['Task-A', 'Task-B', 'Task-C']:
            p = Process(target=process_worker, args=(name, metrics, logs))
            procs.append(p)
            p.start()

        for p in procs:
            p.join()

        print("任务运行指标 dict:")
        for k, v in metrics.items():
            print(f"  {k}: {v}")

        print("\n累计汇总日志 list:")
        for entry in logs['all_records']:
print(f" - {entry}")任务运行指标 dict:
Task-A: SUCCESS (pid=Task-A)
Task-B: SUCCESS (pid=Task-B)
Task-C: SUCCESS (pid=Task-C)
累计汇总日志 list:
- Task Task-A executed successfully
- Task Task-B executed successfully
- Task Task-C executed successfully四、进阶扩展:Python 3.8+ shared_memory 模块
在 Python 3.8 及之后版本中,标准库新增了 multiprocessing.shared_memory 模块。该模块提供更为底层的原始共享内存块分配能力(SharedMemory),专门用于解决数值科学计算(如 NumPy 多维数组)在多进程传递时的序列化瓶颈:
- 与 Array 的差异:
Array基于固定 C 基础类型的一维线性结构,而SharedMemory申请的是原始字节缓冲区(Raw Byte Buffer)。 - 与 NumPy 零拷贝结合:通过
np.ndarray(shape, dtype=..., buffer=shm.buf),多个子进程可以直接在该内存块上构造矩阵视图,执行矩阵乘法或特征提取时无需复制哪怕 1 字节数据。
五、全景选型决策指南与生产避坑要点
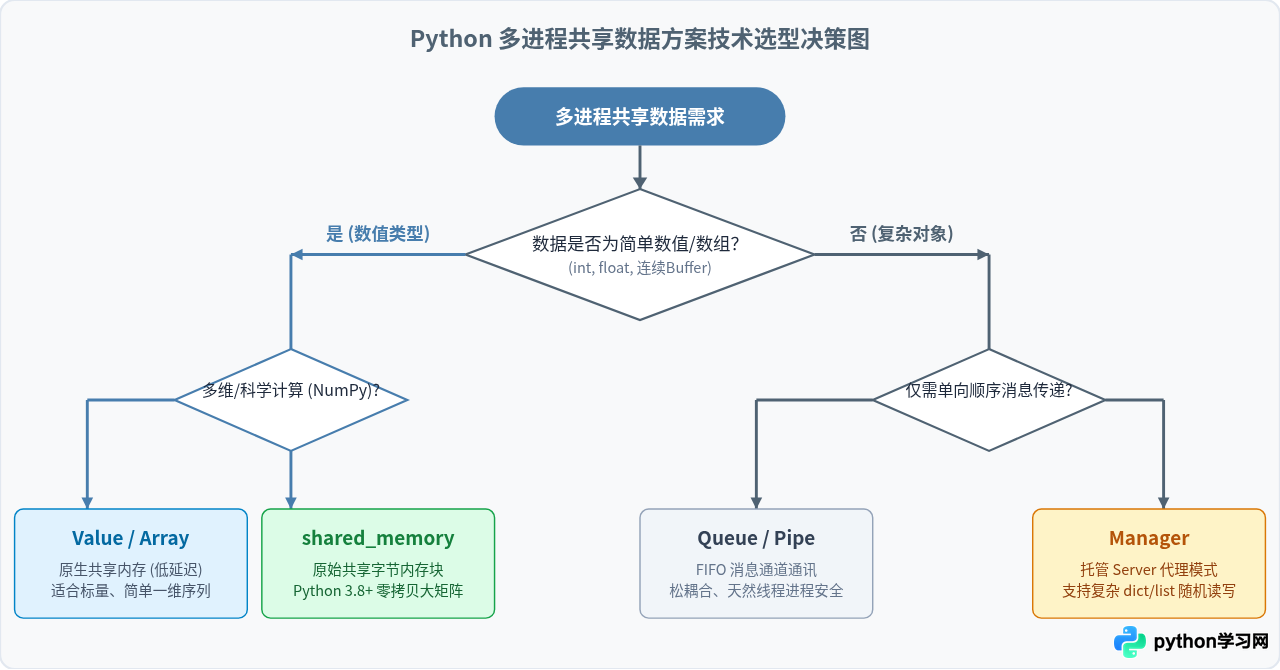
为了在实际架构设计中做出最佳技术选型,可通过以下决策树与特性矩阵进行快速判定:
1. 三大共享方案横向特性对比
| 对比维度 | Value / Array | Manager (dict / list) | SharedMemory (Python 3.8+) |
|---|---|---|---|
| 底层机制 | POSIX mmap 映射区 + ctypes | 独立 Server 服务进程 + Proxy RPC | OS 原生命名/匿名共享内存段 |
| 读写性能 | 极高(纳秒/微秒级,零拷贝) | 中等(毫秒级,存在序列化与 IPC) | 最高(零拷贝直接访问物理字节) |
| 支持类型 | 基本 C 数值类型、固定一维数组 | 任意可序列化的 Python 对象容器 | 原始字节流、NumPy 多维张量 |
| 同步与锁 | 内置 Lock,复合更新需手动加锁 | 代理内置线程锁,嵌套对象需重赋值 | 完全无内置锁,需外置 Lock/Semaphore |
| 生命周期 | 跟随主进程分配,随进程退出释放 | 跟随 Manager 服务进程,建议 with 管理 | 需显式 shm.close() 与 unlink() |
2. 生产环境避坑清单
- 入口安全保护(Windows & macOS spawn 模式):在非 Linux 平台或设置了
spawn启动模式的运行环境中,主入口必须包含if __name__ == '__main__':。否则在子进程导入主模块时会递归再次创建进程,引发进程树雪崩。 - 避免死锁(Deadlock):当在同一个临界区内同时获取多个
Value的锁时,务必在所有进程中按严格一致的顺序申请锁,或者合并为单一的全局multiprocessing.Lock统一管理。 - 资源泄露排查:对于
Manager实例,应始终优先使用with Manager() as manager:语法块;如果脱离上下文手工实例化,在任务终止阶段必须显式调用manager.shutdown(),以确保操作系统正确终止后台 Server 守护进程并销毁 socket 句柄。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















