


Python读取非标准分隔符CSV文件技巧
深入解析Python读取非标准分隔符CSV文件的核心技巧,系统梳理单字符、多字符、不定长空白及未知定界符的解析方案,对比标准库csv与Pandas底层引擎机制,并提供生产环境避坑实践。
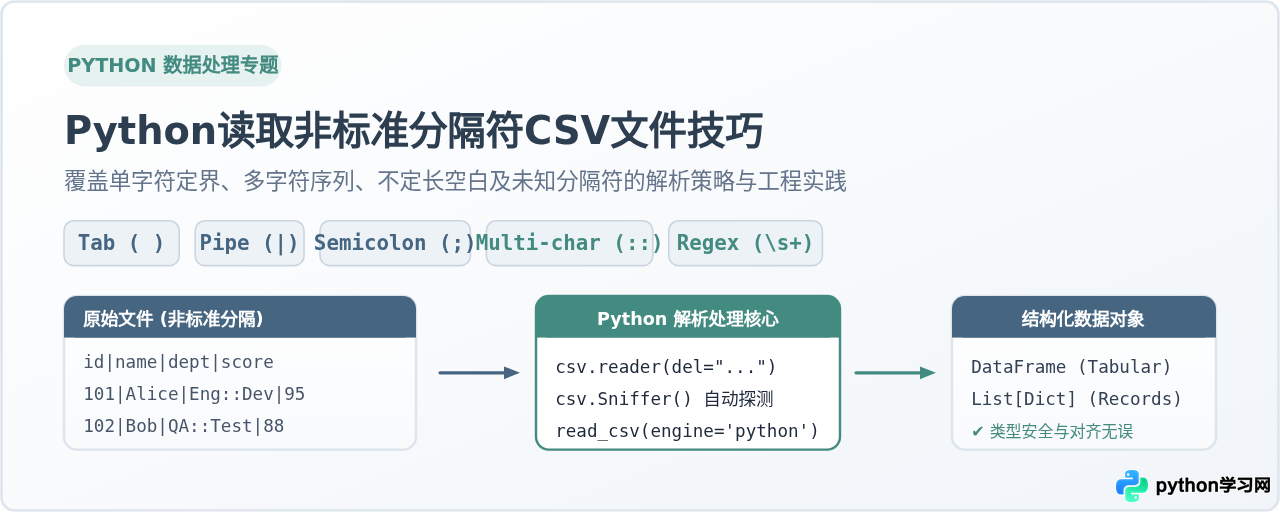
在日常数据分析和后台流水线开发中,CSV(Comma-Separated Values)文件并不总是以英文半角逗号作为定界符。为了防止文本字段内部的逗号干扰分列,或者为了兼容旧版数据库导出工具、Linux 命令行日志及不同国家地区的软件规范,数据工程师经常会遇到使用制表符( )、竖线(|)、分号(;)、多字符序列(如 :: 或 ###)甚至连续变长空格的“变种 CSV”文件。如果直接使用默认配置调用 pd.read_csv() 或标准库 csv.reader(),整行内容往往会被错误地解析为单一列,导致后续字段映射与类型转换全面崩溃。
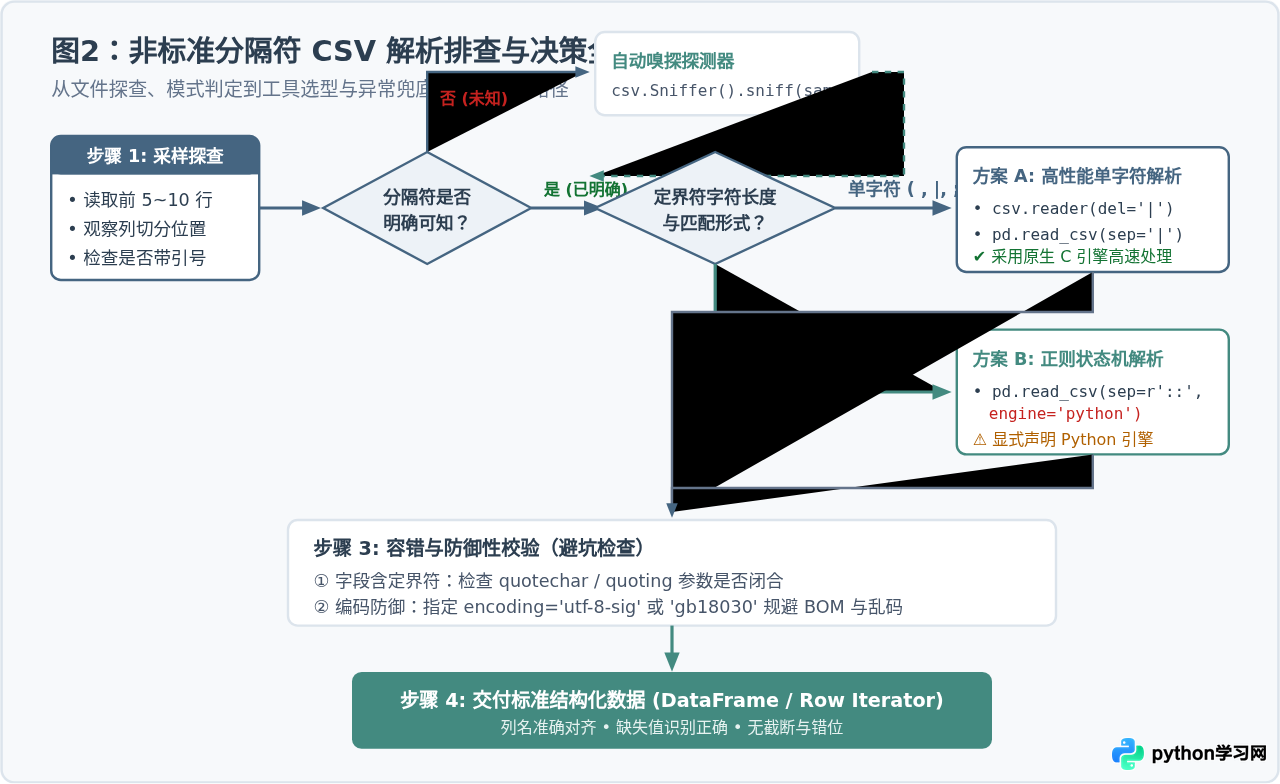
处理此类文件的核心路径非常明确:对于已知的常见单字符分隔符,直接通过标准库 csv.reader(file, delimiter='...') 或 Pandas 的 sep='...' 参数显式指定;对于多字符或复杂正则空白,必须在 Pandas 中显式指定 sep=r'...' 并配合 engine='python' 引擎;对于完全未知的定界符,则可以通过标准库内置的 csv.Sniffer() 工具或 Pandas 的 sep=None 进行动态特征嗅探。理解这几类定界符的特征与底层引擎的差异,是准确、高效处理非标准结构化数据的基本功。
一、常见非标准分隔符类型与解析工具支持矩阵
非标准分隔符 CSV 文件根据定界符的构造规则,通常可分为四种主要形态:
- 单字符非逗号定界符:最典型的是制表符 TSV 文件(
|)、欧洲标准表格使用的分号(;,因欧洲很多地区将逗号作为浮点数小数点),以及插入符(^)。 - 固定多字符序列:多见于分布式日志收集系统或特殊中间件。为了彻底规避正文内部的标点符号,工程师会选用
::、||或@@@作为定界标记。 - 变长不规则空白:在解析终端命令行输出(如
ps aux、df -h)或按列对齐的固定宽度文本时,列与列之间由一个或多个连续空格分隔,甚至混杂了制表符。 - 动态未知分隔符:用户或外部接口推送的批量文件,扩展名统一为
.csv或.txt,但各个批次的具体分隔符并不固定,需要程序自适应推断。
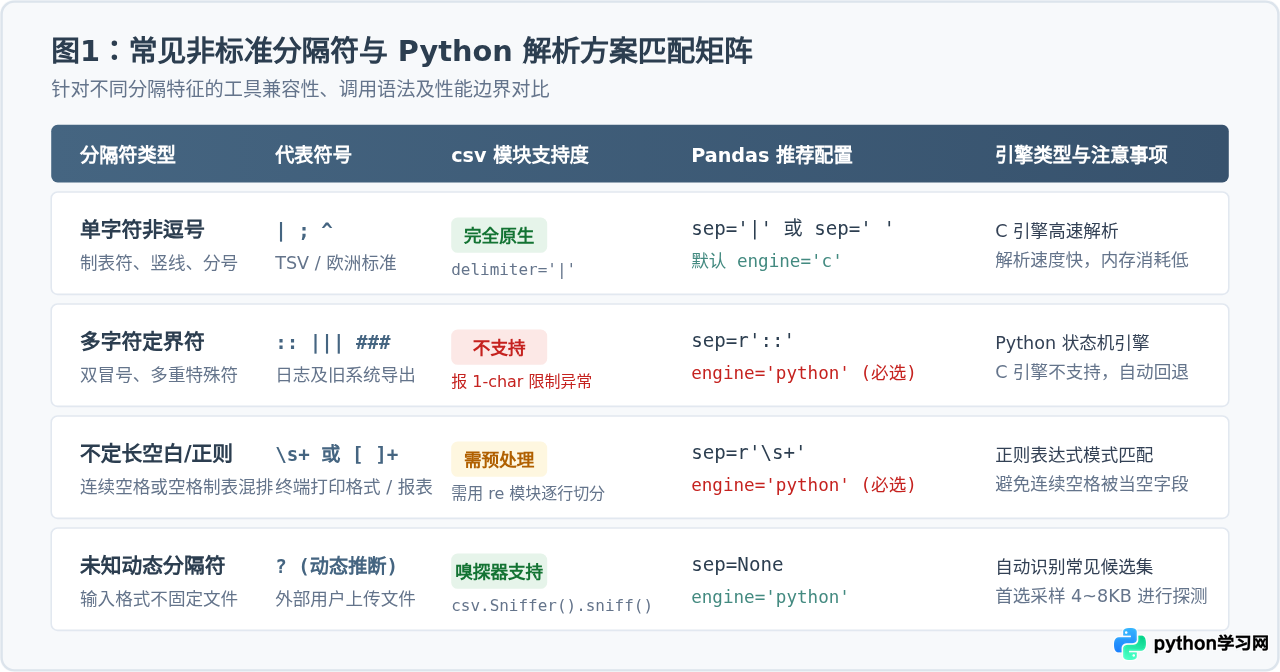
从上图的矩阵可以看出,Python 标准库的 csv 模块由于底层基于 C 语言标准接口编写,其 delimiter 参数严格要求必须为长度为 1 的单个字符。如果传入多字符字符串,程序会立即抛出 TypeError: "delimiter" must be a 1-character string 异常。因此,面对多字符或正则定界符时,Pandas 的 Python 引擎是最灵活、开箱即用的解决方案。
二、标准库 csv 模块实战技巧:轻量化与单字符解析
在不引入外部第三方依赖、仅需要做轻量数据清洗或流式逐行消费的脚本中,Python 标准库自带的 csv 模块是首选工具。针对单字符非标准分隔符,只需在初始化 reader 对象时传入 delimiter 命名参数即可。
1. 使用 csv.reader 与 csv.DictReader 指定分隔符
假设我们有一个以竖线(|)分隔的员工明细文件 staff.csv,内容如下:
emp_id|name|department|salary
1001|张三|技术研发部|18500.00
1002|李四|产品运营部|15200.00
1003|王五|数据分析部|16800.00
读取该文件的完整示例如下:
import csv

# 示例代码:使用 csv.reader 读取竖线分隔符文件
file_path = "staff.csv"

with open(file_path, mode="r", encoding="utf-8") as f:
    # 核心:通过 delimiter 参数显式指定分隔符
    reader = csv.reader(f, delimiter="|")
    header = next(reader)
    print(f"[表头解析]:{header}")

    for row_idx, row in enumerate(reader, start=1):
        # row 是一个规整的 Python 列表
        emp_id, name, dept, salary = row
        print(f"第 {row_idx} 行:ID={emp_id}, 姓名={name}, 部门={dept}, 薪资={salary}")
[表头解析]:['emp_id', 'name', 'department', 'salary']
第 1 行:ID=1001, 姓名=张三, 部门=技术研发部, 薪资=18500.00
第 2 行:ID=1002, 姓名=李四, 部门=产品运营部, 薪资=15200.00
第 3 行:ID=1003, 姓名=王五, 部门=数据分析部, 薪资=16800.00
如果希望每一行直接映射为字典结构,可以使用 csv.DictReader(f, delimiter="|"),它会自动将首行作为字典的键,提升代码的可读性。
2. 动态未知分隔符的自动探测:csv.Sniffer
当面对未知文件时,不需要通过肉眼去打开文件检查。标准库提供了 csv.Sniffer 类,它会通过统计分析文本采样块中不同标点符号的出现频次与一致性,推断出最可能的分隔符及是否存在表头。
import csv

def auto_detect_and_read(file_path):
    with open(file_path, mode="r", encoding="utf-8") as f:
        # 读取前 4096 字节用于采样推断(避免读取全量大文件消耗内存)
        sample_chunk = f.read(4096)
        # 将文件指针重置回文件开头
        f.seek(0)

        # 实例化探测器并推断方言(Dialect)
        sniffer = csv.Sniffer()
        try:
            dialect = sniffer.sniff(sample_chunk)
            has_header = sniffer.has_header(sample_chunk)
            print(f"[探测结果] 识别到的分隔符为: {repr(dialect.delimiter)}, 是否含表头: {has_header}")
        except csv.Error as err:
            # 样本不足或规则混乱时的防御性兜底
            print(f"[探测失败] 无法识别方言,回退默认逗号: {err}")
            dialect = csv.excel

        # 传入推断出的方言对象进行正常读取
        reader = csv.reader(f, dialect=dialect)
        for row in reader:
            print(row)
采样数据量建议在 2KB 到 8KB 之间。如果样本太小(例如仅读取了 1 行),由于字段内可能恰好包含其他符号,推断容易产生偏差;如果样本过大,则会增加不必要的 I/O 负担。此外,调用 f.read() 后必须使用 f.seek(0) 将游标归零,否则后续 reader 将从截断处开始读取。
三、Pandas 高效解析实战:多字符定界符与正则匹配
在数据科学与复杂分析场景中,Pandas 的 pd.read_csv() 是使用频率最高的函数。它不仅支持单字符,还天然支持正则表达式与多字符分割。
1. 读取单字符非逗号文件
对于制表符文件(TSV)、竖线或分号文件,只需直接设置 sep 参数(或别名 delimiter):
import pandas as pd

# 读取竖线分隔符
df_pipe = pd.read_csv("data_pipe.csv", sep="|")

# 读取制表符 TSV 文件
df_tsv = pd.read_csv("data_tab.tsv", sep="\t")

# 读取欧洲分号分隔符文件
df_semi = pd.read_csv("data_euro.csv", sep=";")
在上述单字符场景下,Pandas 会默认使用基于 C 编写的底层解析器(engine='c'),具备极高的数据吞吐能力。
2. 多字符固定分隔符(如 :: 或 ###)
许多企业历史归档系统或多模块日志常采用 :: 作为列定界符,以避免单字符标点带来的冲突。例如如下格式:
timestamp::server_ip::event_type::status_code
2026-11-01 08:30:12::192.168.1.10::LOGIN::200
2026-11-01 08:31:05::192.168.1.15::QUERY::404
2026-11-01 08:31:40::192.168.1.10::LOGOUT::200
如果直接运行 pd.read_csv("logs.txt", sep="::"),终端会打印出一条警告:ParserWarning: Falling back to the 'python' engine because the 'c' engine does not support regex separators (separators > 1 char and different from '\s+' are interpreted as regex); you can avoid this warning by specifying engine='python'.
因此,在处理多字符定界符时,规范的做法是显式声明 engine='python':
import pandas as pd

# 正确规范:显式声明 sep 为多字符,并指定 engine='python'
df_logs = pd.read_csv(
    "logs.txt",
    sep="::",
    engine="python",
    encoding="utf-8"
)

print(df_logs.head())
timestamp server_ip event_type status_code
0 2026-11-01 08:30:12 192.168.1.10 LOGIN 200
1 2026-11-01 08:31:05 192.168.1.15 QUERY 404
2 2026-11-01 08:31:40 192.168.1.10 LOGOUT 200
3. 处理不规则空白符:正则表达式切分
当列与列之间由一个或多个连续空格隔开时,如果指定 sep=" ",那么两个连续空格之间就会被解析出一个空字符串,造成严重的列错位。此时,应该利用正则表达式的 \s+ 匹配一个或多个空白字符:
import pandas as pd

# 使用正则表达式匹配任意连续空白字符
df_spaces = pd.read_csv(
    "fixed_width_report.txt",
    sep=r"\s+",
    engine="python"
)
在编写正则表达式分隔符时,必须在字符串前面添加 r(例如 sep=r'\s+'),防止 Python 解释器在编译期将反斜杠当作常规转义字符处理,从而导致正则语法失真。
四、深度剖析:C 解析引擎与 Python 解析引擎的差异
很多开发者会有疑问:为什么 Pandas 默认的 C 引擎无法直接处理双冒号 :: 这样的简单多字符?这需要从两个引擎的底层架构来分析。
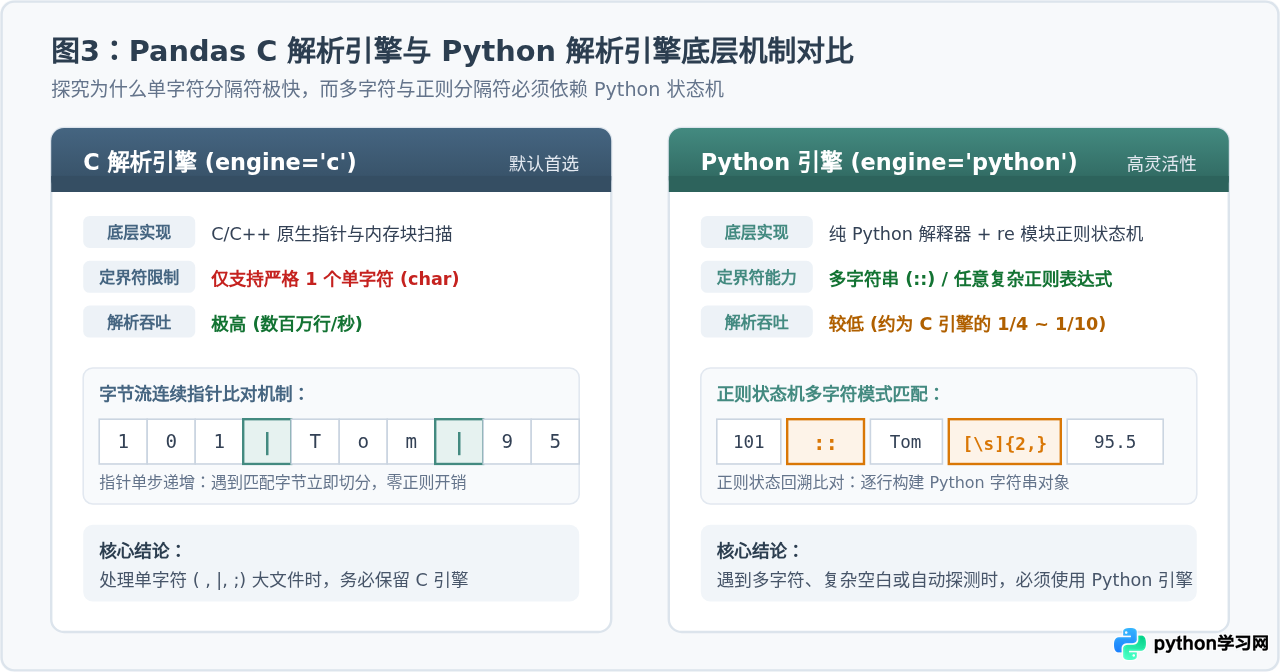
两者的核心区别体现在以下几个维度:
- 内存与比对机制:C 引擎采用紧凑的原生数组结构,内部维护了字节流指针。在遍历数据流时,它只需要用 1 个字节指令逐个对比当前字符是否等于定界字符(例如
*ptr == delimiter),速度极快,不会产生额外的中间对象。而一旦定界符是多个字符(如::),就需要维护前缀匹配状态树或回溯指针,这在纯 C 高性能流式解析器中实现难度大且容易退化。 - 正则表达式支持:Python 引擎本质上封装了 Python 的
re模块。它可以无缝支持r'\|\|'、r'\s+'甚至任意复杂的组合模式,但在逐行匹配时涉及 Python 虚拟机字节码解释、GIL 调度以及字符串对象的频繁分配,导致解析速度相比 C 引擎通常慢 3 到 10 倍。 - 容错与回退:当未指定
engine且使用了多字符sep时,Pandas 会尝试自动退化到 Python 引擎并弹出警告。但在批量化作业中,依赖自动回退会使得程序行为不够透明,因此在涉及多字符或正则时应主动指定engine='python'。
五、常见陷阱排查与生产环境避坑指南
即使正确指定了分隔符,在实际生产环境中依然可能遇到各种非预期的解析异常。以下是三个最常踩坑的场景及应对策略。
陷阱 1:文本内部含有定界符与引号嵌套
例如,某个竖线分隔的文件中,某列文本内容本身包含了竖线,此时规范的导出工具通常会使用双引号将该字段完整包裹:
id|description|status
1|"模块A | 接口错误"|FAILED
2|"正常流程"|SUCCESS
如果使用 sep="|" 读取,必须确保 quotechar 参数处于开启状态(默认即为双引号 ")。如果该文件使用了单引号进行包裹,或者使用了反斜杠转义,则需显式配置:
import pandas as pd

# 显式配置引号字符与转义字符
df_safe = pd.read_csv(
    "quoted_data.csv",
    sep="|",
    quotechar="'",       # 若使用单引号包裹字段
    escapechar="\\",     # 若使用了反斜杠转义内部符号
    engine="python"
)
陷阱 2:编码不一致与 Windows BOM 导致的“首列名异常”
在 Windows 环境下使用 Excel 或旧系统导出的 CSV 文件常带有 UTF-8 BOM 标记()。使用常规 encoding='utf-8' 读取时,BOM 标记会被视作首列列名的一部分,导致 df['id'] 抛出 KeyError: 'id',实际上列名变成了 'id'。
解决方案:在读取可能来自 Windows 环境的非标文件时,统一将编码指定为 utf-8-sig。Python 解释器会自动剥离开头的 BOM 标记:
# 自动消除 BOM 头的标准姿势
df = pd.read_csv("export.csv", sep="|", encoding="utf-8-sig")
陷阱 3:海量数据下的多字符分隔符性能瓶颈
如果有一个 20GB 的巨型日志文件采用了 :: 分隔,使用 engine='python' 一次性读取不仅极慢,而且极易触发 OOM(内存溢出)。针对此场景,推荐两种工程优化方案:
- 分块流式迭代(Chunking):利用
chunksize参数分批载入内存,按块处理并持久化。 - 外部前置预处理(降维打击):在调用 Python 之前,利用 Linux 极速流处理命令
sed或tr,将多字符定界符替换为单字符(如制表符或逗号),然后再交由 Pandas 的c引擎高速解析。
import pandas as pd

# 优化策略 1:分块流式处理海量多字符文件
chunk_size = 50000
for chunk_df in pd.read_csv("huge_log.txt", sep="::", engine="python", chunksize=chunk_size):
    # 对每个分块进行清洗计算
    process_chunk(chunk_df)
六、核心总结与全景速查
面对各种来源不一、格式多样的非标准定界符文件,关键在于根据定界符的特征与业务性能诉求选择正确的工具与参数组合:
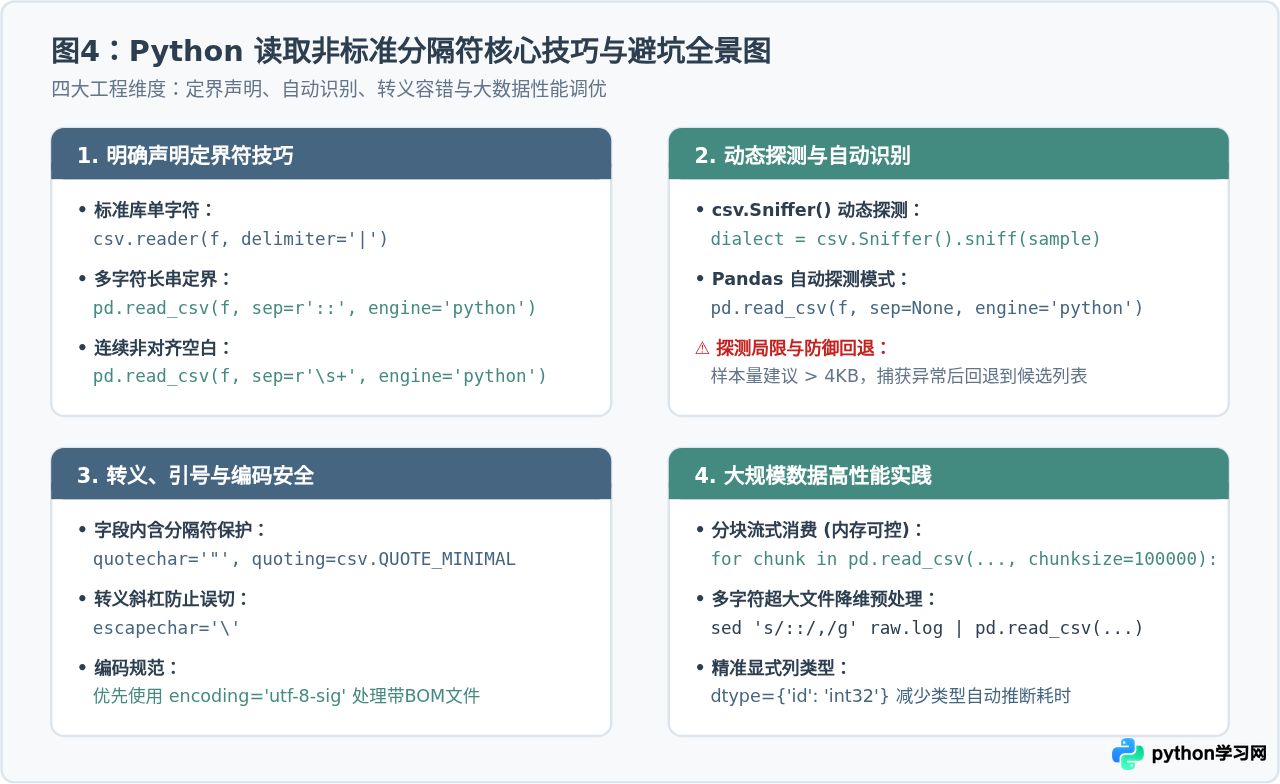
| 场景需求 | 推荐方案 | 核心参数配置 | 典型收益 / 限制 |
|---|---|---|---|
| 标准单字符( , |, ;) | Pandas read_csv |
sep='|' (默认 engine='c') |
解析吞吐最高,适合千万级大数据文件 |
| 无三方库依赖环境 | 内置 csv.reader |
delimiter='|' |
原生轻量,内存开销极小,仅限单字符 |
| 固定多字符(::, ###) | Pandas read_csv |
sep=r'::', engine='python' |
避免列切分歧义,但需注意吞吐开销 |
| 连续空格/终端打印排版 | Pandas read_csv |
sep=r'\s+', engine='python' |
正则模式匹配,有效防止空列误判 |
| 未知或混合分隔符 | csv.Sniffer / sep=None |
sep=None, engine='python' |
自适应探测,提升通用自动化任务健壮性 |
在实际工程落地中,养成“先采样观察、再明确参数、最后校验列数一致性”的习惯,能够帮助开发者在面对各类离奇的数据导出格式时游刃有余,从源头上保障数据流通管道的健壮与稳定。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















