


Python内置函数与标准库函数的区别是什么
深入对比Python内置函数与标准库函数的区别,解析加载机制、命名空间、LEGB作用域、底层实现与定位差异,配有完整内联SVG图解与实用避坑指南。
print(len([10, 20, 30])) 便能直接获得结果;但当你想计算数值的平方根时,直接调用 sqrt(9) 却会立即抛出 NameError: name 'sqrt' is not defined,只有先加上 import math 并写成 math.sqrt(9) 才能顺利运行。两者都是 Python 官方默认提供的原生功能,为什么一个随叫随到,另一个却必须显式导入?它们的本质区别究竟在何处?
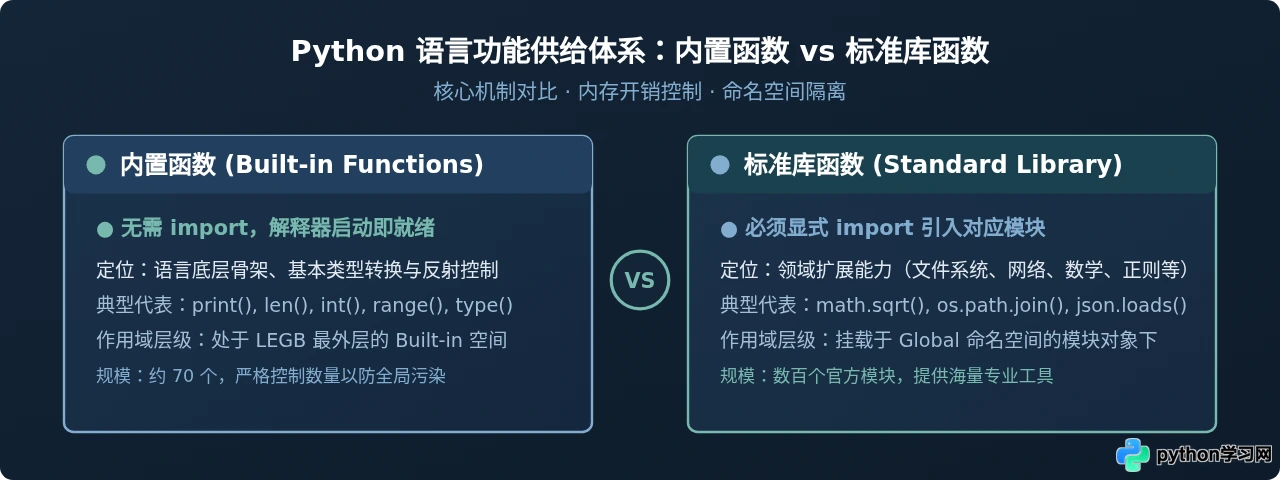
一句话总结两者的核心区别:内置函数(Built-in Functions)是随 Python 解释器启动自动装入最底层全局可用命名空间的极简基础函数,无需任何声明直接可用;而标准库函数(Standard Library Functions)是官方随解释器一起捆绑分发、但被组织在各个独立模块文件中的工具集,必须先通过 import 语句载入才能调用。
表面上看,这似乎只是“写不写 import”的语法差别,但背后关系到 Python 运行时的加载机制、命名空间查找规则、内存分配哲学以及系统架构设计。本文将通过具体代码、机制对比与运行链路,拆解两者的真实边界。
一、加载机制与内存开销:常驻就绪 vs 按需装载
理解两者的第一道分水岭在于:函数对象何时进入计算机内存并绑定到解释器上下文中。
1. 内置函数的装载过程
当 Python 解释器(例如最常用的 CPython)被执行的那一刻,底层 C 代码会首先初始化核心运行环境,创建名为 builtins 的特殊内部模块,并将最基础的类型定义(如 int、list、dict)与基础函数(如 len()、print()、enumerate())直接注册进全局符号表中。
即使你执行一个完全为空的 empty.py 文件,这些内置函数也早已就绪。你可以通过以下代码查看当前环境下的内置符号总数:
import builtins

# 获取 builtins 模块中所有不以下划线开头的公开内置函数与类型
built_in_items = [name for name in dir(builtins) if not name.startswith("_")]
print("公开内置名称数量:", len(built_in_items))
print("部分内置名称:", built_in_items[:10])公开内置名称数量: 158
部分内置名称: ['ArithmeticError', 'AssertionError', 'AttributeError', 'BaseException', 'BaseExceptionGroup', 'BlockingIOError', 'BrokenPipeError', 'BufferError', 'BytesWarning', 'ChildProcessError']在所有公开名称中,真正的纯内置函数(Callable Function)约有 70 个,其余为内置异常类和基础对象类型。由于数量极少,它们常驻内存并不会对系统产生负担。
2. 标准库函数的装载过程
标准库函数虽然同样随 Python 安装在本地磁盘(通常位于 Python 安装目录下的 Lib/ 文件夹中),但在未执行 import 之前,它们只是静静躺在磁盘上的 .py 脚本或编译好的动态链接库(如 .so / .pyd 文件)。
当你执行 import math 时,解释器才会启动完整的导入链路:
- 在
sys.modules缓存字典中检查是否已经加载过math; - 若未加载,则通过模块查找器从文件系统找到对应的编译模块;
- 执行该模块的代码,构建新的命名空间对象并存入
sys.modules; - 在当前作用域中创建变量名
math,并指向该模块对象。
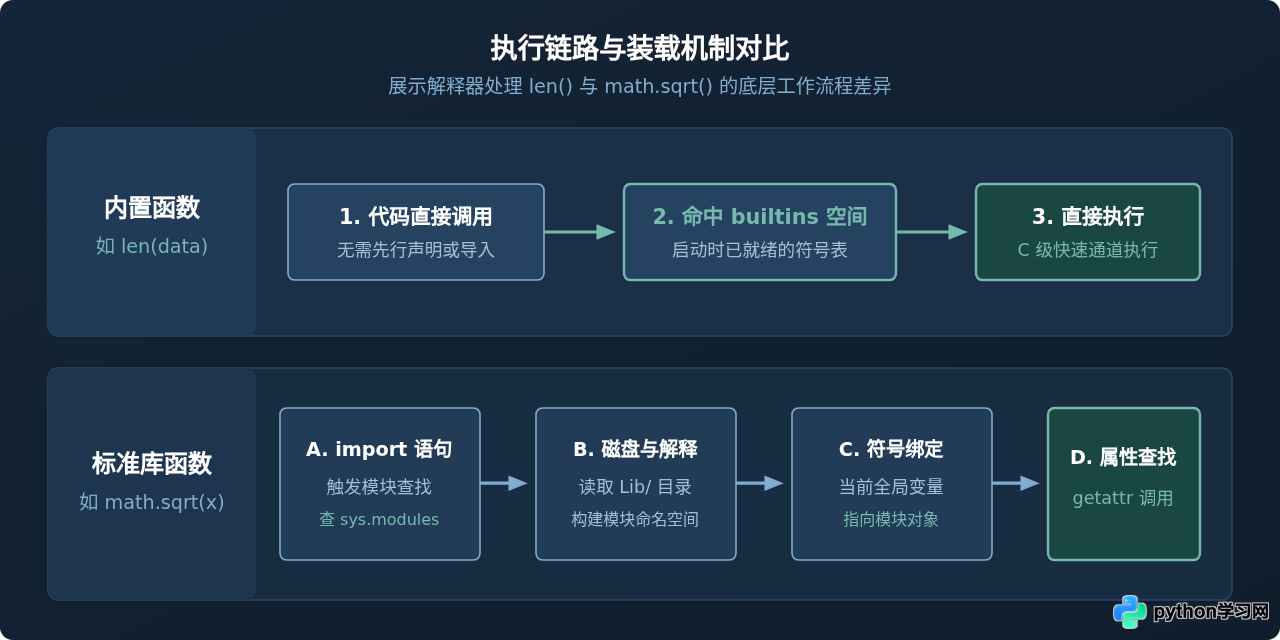
如果 Python 将标准库的数百个模块(如 sqlite3、urllib、email、multiprocessing 等)全部在启动时预先载入内存,解释器的冷启动时间将从数毫秒骤增到数百毫秒,内存基线占用也会膨胀数十倍。按需 import 既保证了极速的轻量级启动,又通过命名空间隔离避免了成千上万个函数名称发生严重冲突。
二、命名空间与 LEGB 作用域:兜底层 vs 模块属性
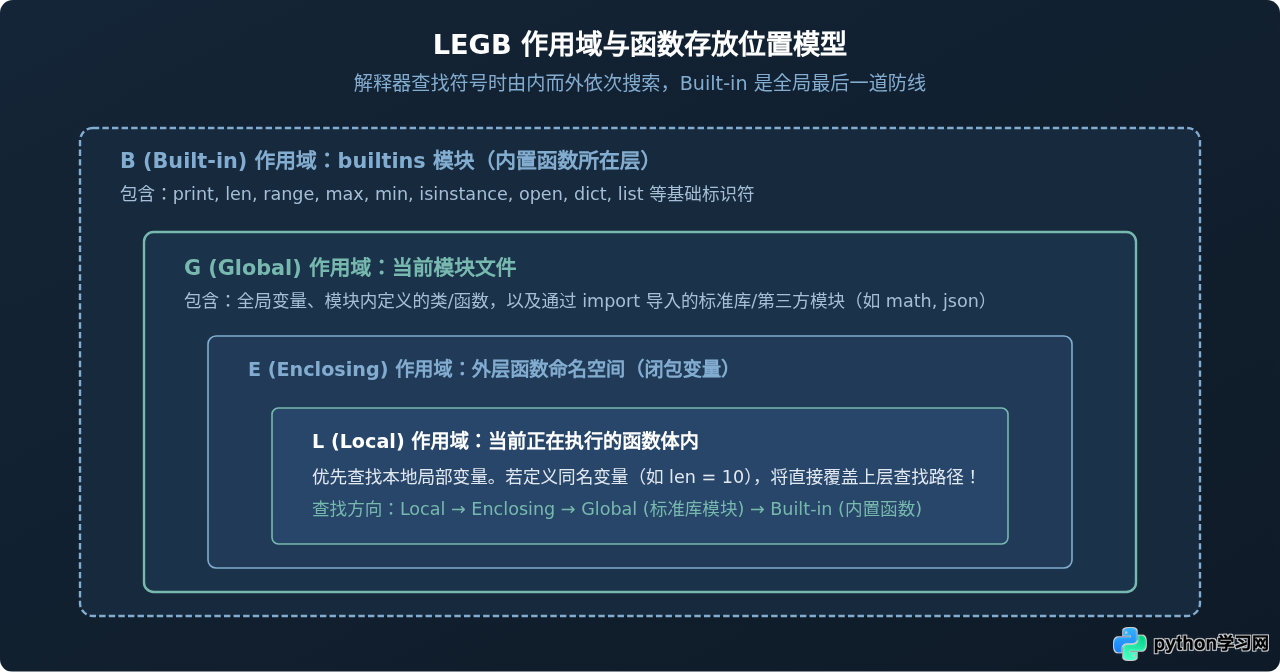
Python 解释器在遇到一个未限定前缀的名称(例如 func())时,会严格遵循 LEGB 查找规则:
- L (Local):当前函数内部的局部变量与参数;
- E (Enclosing):外层嵌套函数的闭包命名空间;
- G (Global):当前
.py模块文件的全局作用域; - B (Built-in):底层
builtins命名空间。
内置函数永远是“兜底者”
内置函数位于 LEGB 链条的最底层(Built-in)。这意味着只有在 Local、Enclosing 和 Global 都找不到某个标识符时,解释器才会去 builtins 字典中匹配。这种设计的直接后果是:内置函数极易被用户自定义的变量名意外遮蔽(Variable Shadowing)。
# 错误示例:将自定义变量命名为内置函数名 list
numbers = [1, 2, 3]
list = numbers  # 此时 Global 作用域中新增了变量 'list',遮蔽了内置的 list 类型构造器

# 稍后在其他位置尝试将元组转为列表
new_list = list((4, 5, 6))  # 抛出 TypeError: 'list' object is not callable!
相反,标准库函数由于通常以 模块名.函数名(如 math.sqrt、os.listdir)的形态调用,或者通过具名导入使用,它的命名空间归属始终明确,只要避免覆盖模块名本身,就不会干扰其他层级的符号系统。
三、设计定位、规模与底层实现机制
除了表层的调用语法与作用域位置,内置函数与标准库函数在 Python 语言架构中承担着截然不同的工程职责。
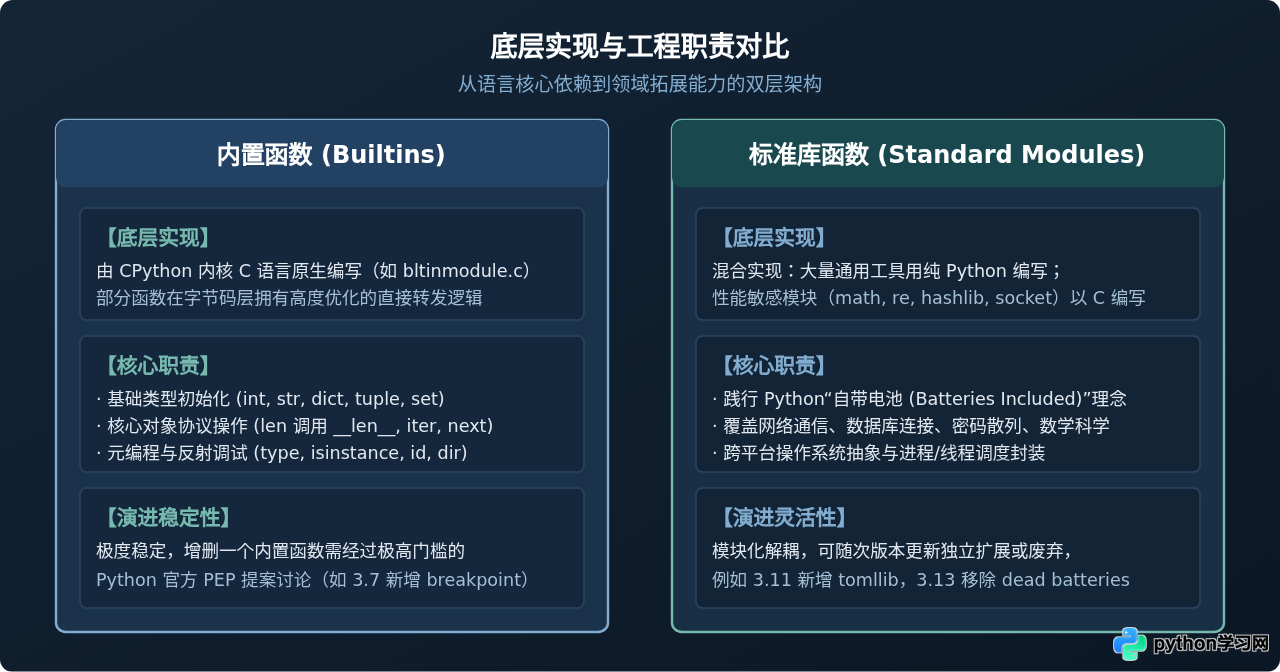
详细维度对照表
| 对比维度 | 内置函数 (Built-in) | 标准库函数 (Standard Library) |
|---|---|---|
| 调用前置条件 | 无需 import,任何作用域直接调用 |
必须先 import 模块 或 from 模块 import 函数 |
| 存在载体 | builtins 内部模块,已内嵌进解释器内核 |
独立的 .py 脚本或 .so/.pyd/.dll 模块文件 |
| 数量规模 | 非常精简,约 70 个常用函数 | 极其庞大,包含数百个模块、数千个专业函数 |
| LEGB 作用域层级 | 最外层的 B (Built-in) 兜底层 |
导入后进入当前文件的 G (Global) 命名空间 |
| 底层代码实现 | 绝大部分为纯 C 语言编写,深度契合解释器 | 纯 Python 与 C 扩展模块混合,按功能领域拆分 |
| 典型代表 | print(), len(), isinstance(), range() |
math.sin(), os.walk(), datetime.now() |
| 主要设计定位 | 提供语言运转最必需的微观操作与类型桥梁 | 提供无需第三方安装的开箱即用行业级工具包 |
四、选型判断与开发避坑指南
在日常开发中,如何清晰理智地运用这两类函数?以下是三条行之有效的实践法则:
1. “由内向外”的功能检索原则
当需要完成某个特定操作时,推荐的思考路径是:内置函数优先 > 标准库模块次之 > 第三方库(PyPI)兜底。
- 如果要对列表进行去重、切片、排序或长度统计,直接使用
set()、sorted()、len(); - 如果要进行排列组合计算,不要自己手写循环,先看标准库
itertools.permutations(); - 如果要进行深度科学矩阵运算,标准库无法胜任时,再安装第三方库
numpy。
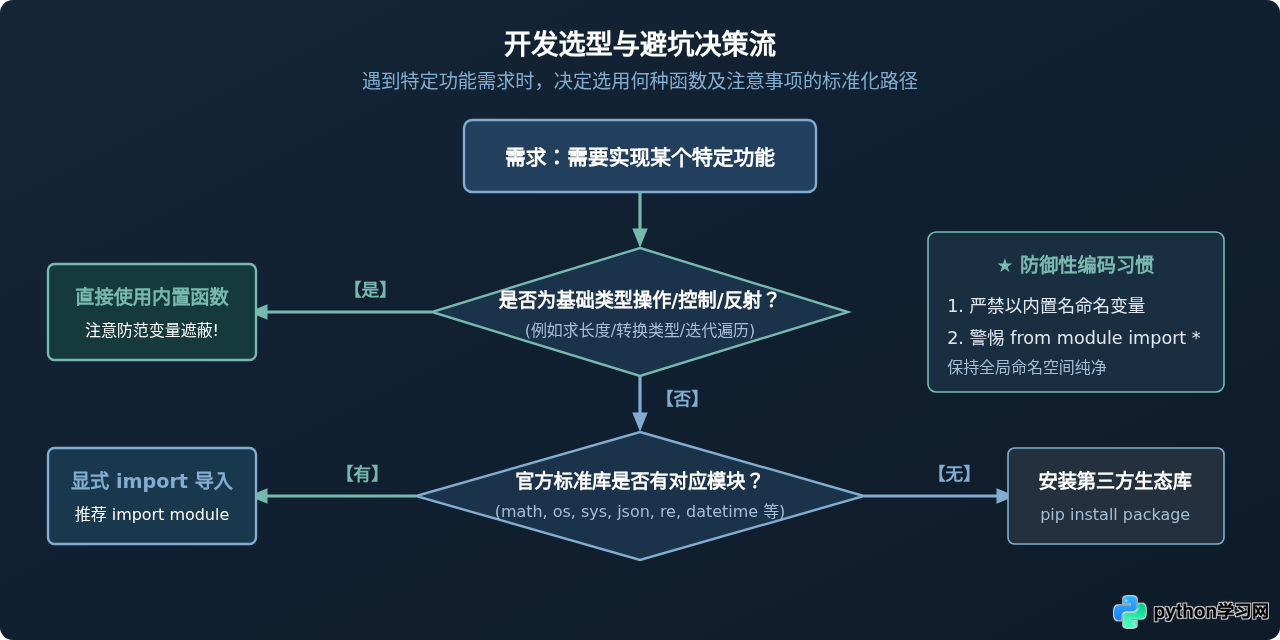
2. 谨慎对待 from module import *
标准库函数有严格的模块作用域界限,但如果你在代码开头写了通配符导入:
from math import *该模块下的所有公开函数(如 sin、cos、pow 等)将一口气涌入当前文件的 Global 命名空间。这不仅会使得代码难以追踪其真实来源,还会悄无声息地覆盖原有的内置函数。例如,math.pow 会直接覆盖 Python 内置的 pow(),而两者的精度处理与参数签名(内置 pow 支持三参数模运算,而 math.pow 只支持两参数浮点运算)存在细微却致命的差异:
# 内置 pow 支持三参数高效模幂运算:(2 ** 10) % 7
print(pow(2, 10, 7))  # 正常输出:2

from math import *
# 此时 pow 已变为 math.pow,只接受两个参数并转为浮点数
print(pow(2, 10, 7)) # 抛出 TypeError: pow expected 2 arguments, got 3在工程实践中,始终优先使用 import math(调用时写 math.sqrt())或显式指定名称 from math import sqrt。这样既保证了代码的可读性,也能彻底杜绝无意间的命名空间污染。
总结
回顾核心问题:“Python 内置函数与标准库函数的区别是什么”:
- 使用上:内置函数全天候即时可用,标准库函数需按需引入。
- 机制上:内置函数常驻
builtins并在 LEGB 中承担最底层的兜底查找;标准库模块以文件形式独立解耦,导入后挂载在全局命名空间。 - 架构上:内置函数维持核心精简与极速冷启动;标准库则以“自带电池”的模块化姿态,提供海量工业级功能支撑。
理解这一区别,不仅能帮助初学者摆脱 NameError 与 TypeError 的困扰,更能从宏观上理解 Python 是如何在轻量级解释器性能与庞大功能生态之间达成优雅平衡的。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















