


Python数据分析环境怎么配?Anaconda安装与Jupyter使用指南
针对初学者的实用指南:详解 Python 数据分析环境搭建过程,包括原生 Python 与 Anaconda 的选型对比、Anaconda 跨平台安装决策、Conda 独立虚拟环境管理与 Jupyter 内核绑定,以及 Jupyter Notebook 高频快捷键与常见排错方法。
当你拿到一份业务表格或传感器日志,准备用 Python 计算汇总指标或绘制趋势图时,最先面对的往往不是具体的统计代码,而是环境配置问题。初学者常直接在操作系统中安装标准 Python 解释器,随后在终端连续输入 pip install pandas matplotlib,接着便遭遇缺失本地 C++ 编译环境、底层数学运算库(BLAS/LAPACK)动态链接失败或依赖包相互锁死等报错。解决这些底层依赖冲突常常耗费数小时,甚至直接打消了继续学习的念头。
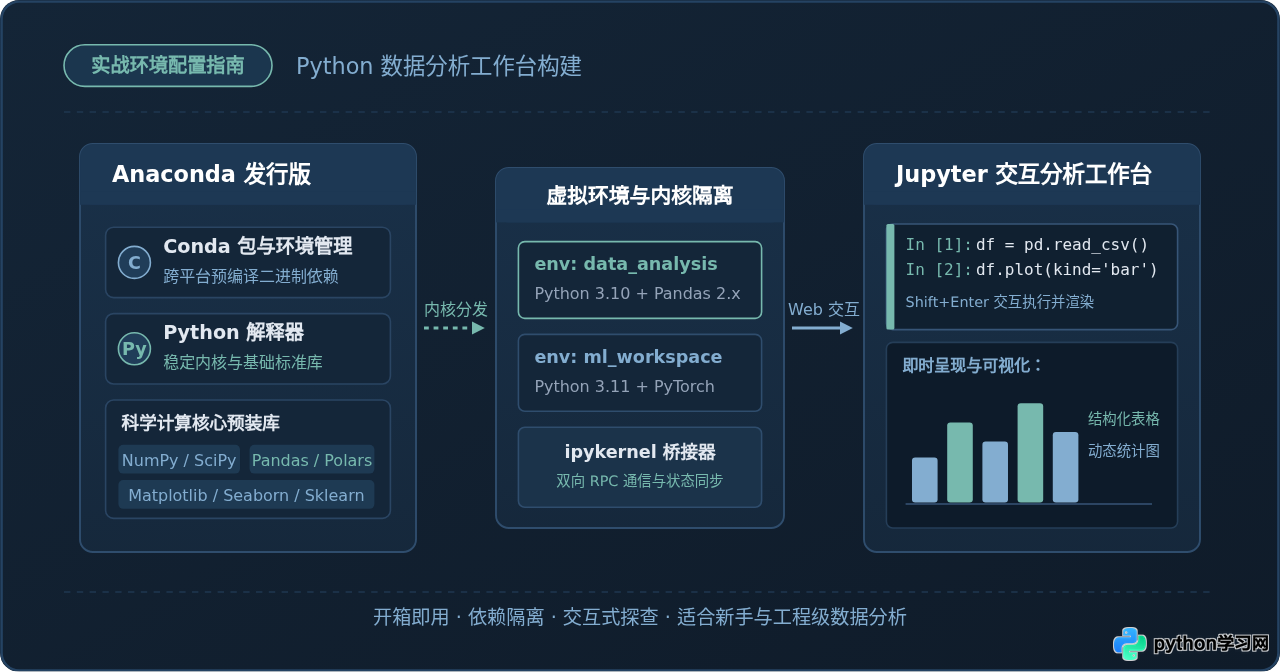
搭建 Python 数据分析环境的高效可靠解法,是使用 Anaconda 发行版 配合 Jupyter Notebook。Anaconda 将 Python 解释器、Conda 二进制包与环境管理器,以及数据分析高频使用的数百个核心计算库打包整合;而 Jupyter 则提供了单元格交互执行、分析过程与图表即时呈现的轻量级工作台。本文将依序拆解选型依据、安装关键细节、虚拟环境隔离规范、Jupyter 实操技巧及常见报错排查,帮助你建立一套整洁、可控且开箱即用的数据分析开发环境。
一、为什么数据分析优先选用 Anaconda?
在探讨如何安装之前,先厘清 Anaconda 与原生 Python 的本质区别。标准 Python(从 python.org 下载的版本)仅包含基础解释器与轻量标准库。在通用后端开发中,通过 pip 安装纯 Python 模块通常十分顺畅。然而,数据分析和机器学习库(如 NumPy、SciPy、Pandas)底层包含大量经过底层硬件优化的 C、C++ 以及 Fortran 代码。
当通过 pip 安装这些科学计算包时,如果官方预编译轮子(Wheel)与当前系统的编译运行时不匹配,pip 就会尝试调用本地编译器现场编译源码。一旦操作系统缺少对应的构建套件或底层基础库,安装过程就会立刻中断并弹出大段晦涩的编译报错。
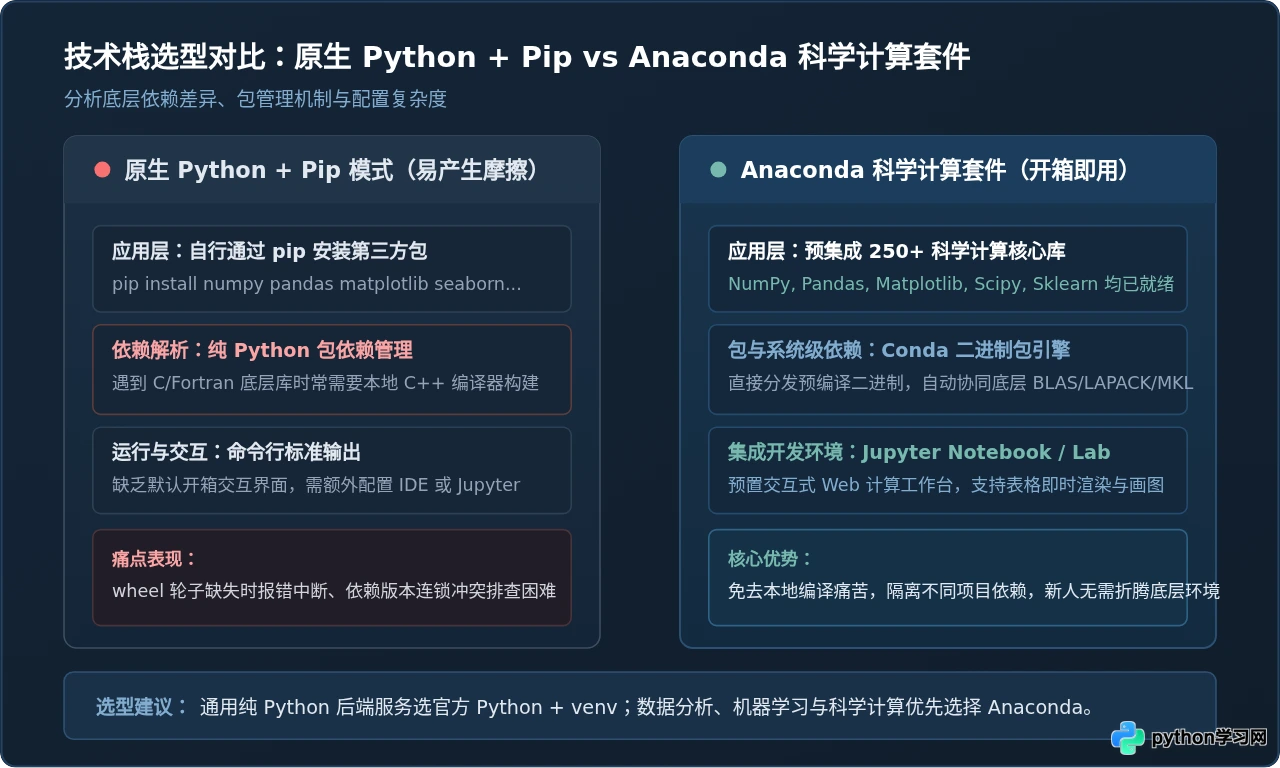
Anaconda 针对这一痛点,内置了专门面向科学计算的 Conda 包管理引擎:
- 预编译二进制分发:Conda 分发的包全部经过统一编译与依赖锁定,安装 NumPy 时会自动拉取匹配的 Intel MKL 或 OpenBLAS 高性能线性代数库,完全不需要在本地配置编译工具链。
- 系统级依赖解析:Conda 不仅管理 Python 包,还能管理系统级非 Python 依赖(如 HDF5、CUDA 运行时、动态链接库等),这是纯 Python 包管理器
pip所不具备的。 - 开箱即用的科学全家桶:安装完 Anaconda 后,NumPy、Pandas、Matplotlib、Seaborn、Scikit-learn 等 250 多个数据处理、统计建模与绘图库均已就绪,初学者无需再逐一检索安装。
二、Anaconda 下载与跨平台安装关键步骤
安装 Anaconda 本身并不复杂,但在安装向导中有几个关键配置项直接决定了后续日常使用的稳定性。遵循以下规范可以规避大部分由于路径或权限引发的偶发问题。
1. 获取安装包与架构匹配
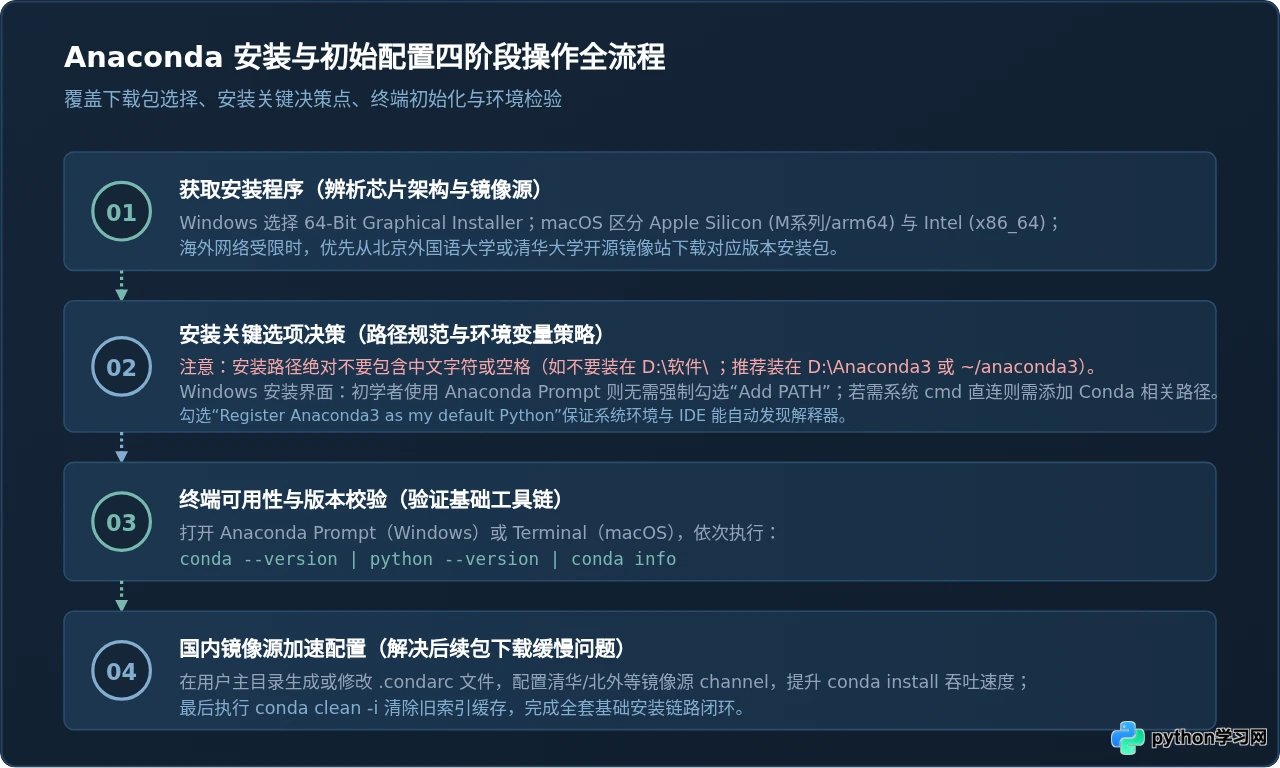
前往 Anaconda 官方网站下载页面,根据你的操作系统选择对应安装程序:
- Windows 系统:下载
Windows 64-Bit Graphical Installer(.exe 文件)。 - macOS 系统:注意区分芯片架构。搭载 M1/M2/M3 等 Apple Silicon 芯片的设备请下载
Apple Silicon (M-series / arm64) Graphical Installer;搭载 Intel 芯片的机型请下载Intel (x86_64) Graphical Installer。若选错架构,后续运行效率将大打折扣甚至出现兼容报错。 - 国内镜像加速建议:若官网下载吞吐速率较低,可访问北京外国语大学或清华大学开源软件镜像站的
anaconda/archive/目录,直接拉取当期版本的安装包,下载速度通常可以达到数十兆每秒。
2. 关键安装选项决策
启动图形化安装向导后,在“Select Destination Folder(选择安装目录)”和“Advanced Installation Options(高级选项)”页面需要格外谨慎:
安装目标路径必须全为英文、数字或下划线。在 Windows 上建议修改为 D:\Anaconda3 或 C:\Anaconda3,切勿安装在诸如 C:\Program Files\(带空格)或包含个人中文字符的用户文件夹下,否则部分第三方 C 扩展库在加载绝对路径时会发生静默解析失败。
在高级选项(Advanced Options)界面中:
- Add Anaconda3 to my PATH environment variable:安装向导会标红提示不推荐勾选。如果你习惯使用 Anaconda 专门提供的“Anaconda Prompt”命令行终端,保持不勾选是安全的做法,这能避免 Anaconda 覆盖系统全局的原生 Python;若你需要在系统自带的 Windows PowerShell 或 CMD 中随时调用
conda,则可以勾选,或在安装完成后手动将D:\Anaconda3、D:\Anaconda3\Scripts和D:\Anaconda3\Libraryin三个目录添加到系统环境变量Path中。 - Register Anaconda3 as my default Python:建议保持勾选状态。这允许 VS Code、PyCharm 以及系统关联工具自动将 Anaconda 识别为主 Python 解释器。
3. 验证安装结果
安装结束后,打开 Anaconda Prompt(Windows)或系统 Terminal(macOS / Linux),执行以下基础检验指令:
执行命令:conda --version
python --versionconda 24.1.2
Python 3.11.7 (tags/v3.11.7:fa7a2f2, Dec 4 2023, 19:24:47) [MSC v.1937 64 bit (AMD64)]若两个命令均能正常打印出版号,说明基础运行环境与 Conda 管理链已配置成功。
三、虚拟环境管理:为什么必须学会用 conda env?
许多初学者的不良习惯是将所有后续任务涉及的包一股脑通过 conda install 或 pip install 塞入默认的 base 环境中。随着项目推进,A 项目需要旧版 Pandas 1.5 处理遗留格式,而 B 项目要求升级到 Pandas 2.2 使用最新的 PyArrow 引擎。在单一环境中强行混用不同版本的依赖,最终必然导致包依赖关系死锁。
因此,保持 base 环境纯净,按项目划分独立虚拟环境 是专业数据分析的必备规范。
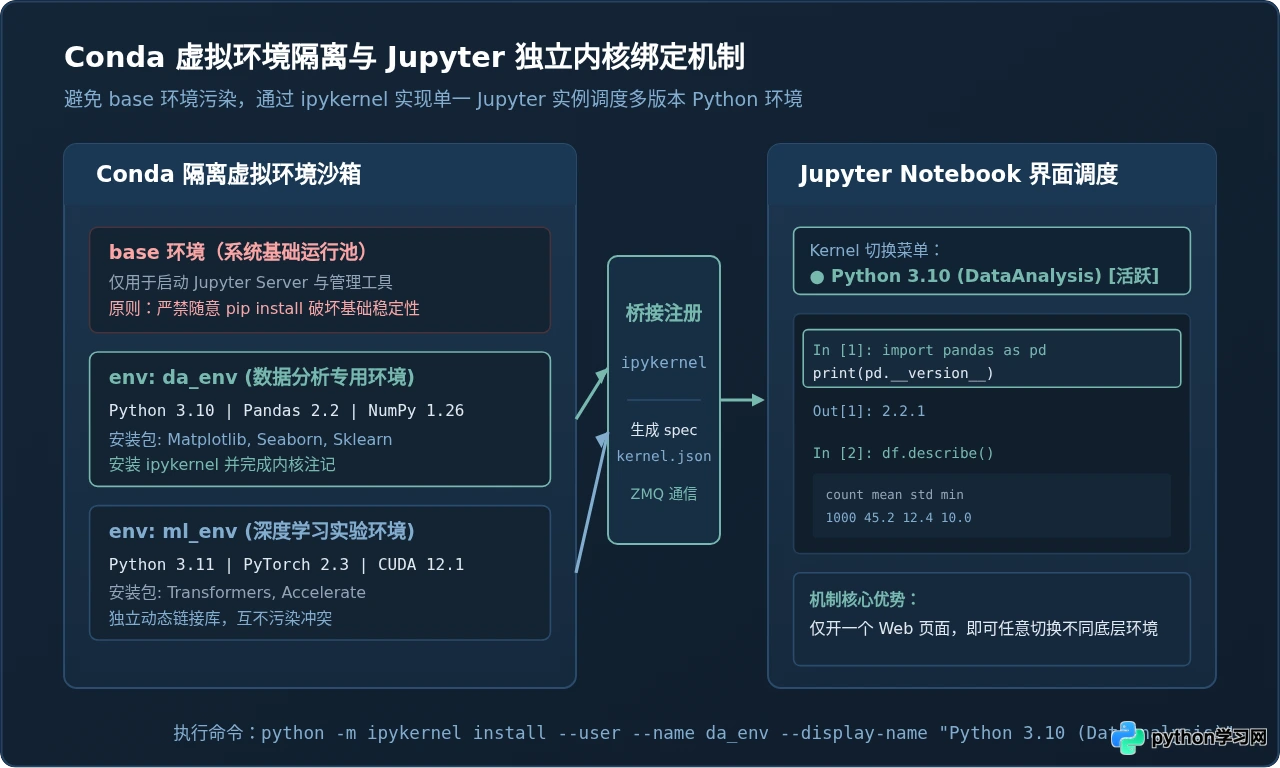
1. 虚拟环境核心操作指令
在终端中,通过几条直观的命令即可实现环境的完整生命周期管理:
创建指定 Python 版本的独立环境:# 创建名为 da_env 的虚拟环境,指定使用 Python 3.10
conda create -n da_env python=3.10 -y# 激活进入该环境
conda activate da_env
# 激活后命令行最左侧括号会由 (base) 变为 (da_env)
# 退出当前环境返回系统默认
conda deactivate# 激活后,在环境内部安装核心科学库
conda install numpy pandas matplotlib seaborn scikit-learn -yconda env list# conda environments:
#
base * C:/Anaconda3
da_env C:/Anaconda3/envs/da_env
ml_project C:/Anaconda3/envs/ml_project2. 将虚拟环境注册为 Jupyter 的可用内核
创建了 da_env 之后,在默认启动的 Jupyter Notebook 中是无法直接选择该环境运行代码的。我们需要借助 ipykernel 将该虚拟环境注记为一个可调度的计算内核(Kernel):
# 1. 确保激活目标虚拟环境
conda activate da_env

# 2. 安装内核桥接工具 ipykernel
conda install ipykernel -y

# 3. 将本环境写入 Jupyter 的内核配置清单
python -m ipykernel install --user --name da_env --display-name "Python 3.10 (DataAnalysis)"Installed kernelspec da_env in C:/Users/YourUser/AppData/Roaming/jupyter/kernels/da_env此时,无论你在哪个目录下打开 Jupyter Notebook,顶部的 Kernel 菜单中都会出现名为 Python 3.10 (DataAnalysis) 的选项,点击即可让代码完全运行在该隔离环境中。
四、Jupyter Notebook 实战指南与高频快捷键
Jupyter Notebook 采用基于 Web 的交互式计算模型(Literate Computing),它将文字说明(Markdown)、分析代码(Code)、表格数据以及图表可视化无缝串联在同一个 .ipynb 文档中。这种“写一段代码、看一次结果、调一次参数”的即时反馈特性,是数据清洗与探索性数据分析(EDA)不可替代的利器。
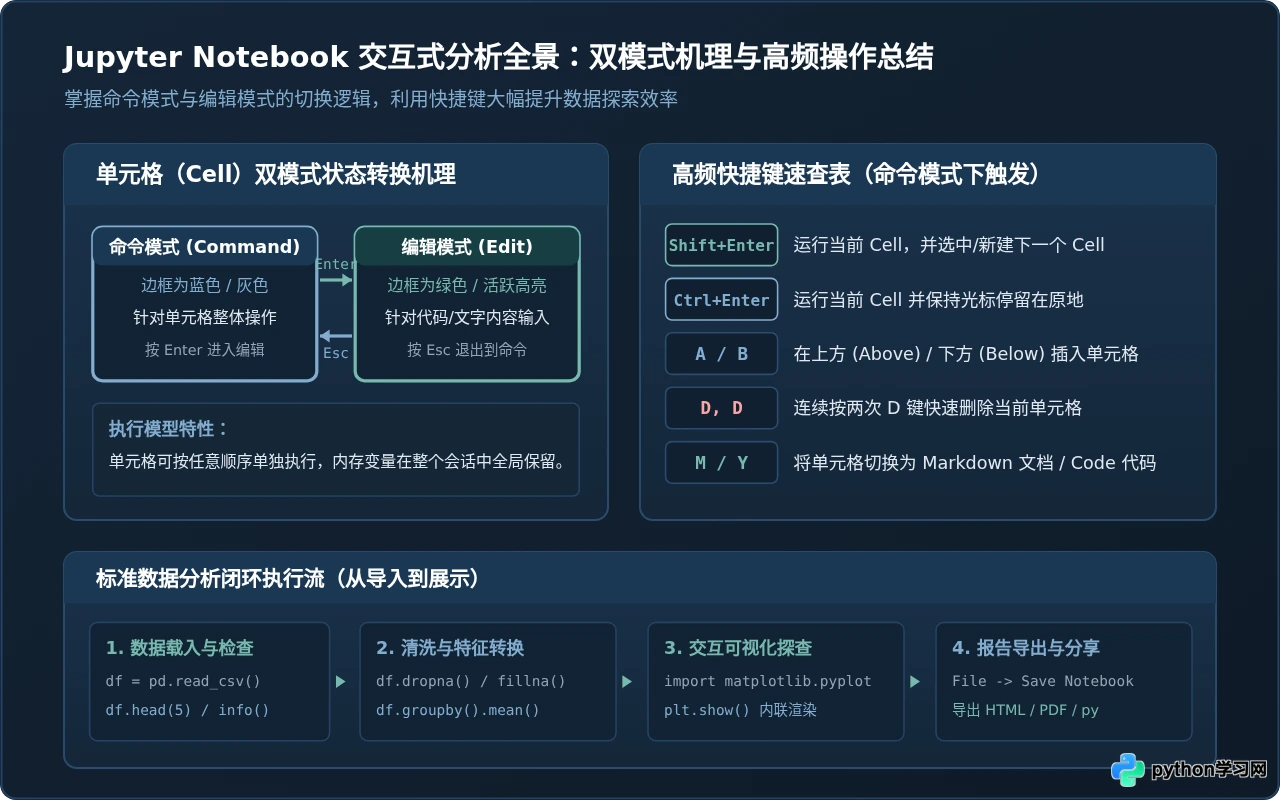
1. 启动 Jupyter Notebook
不要在杂乱的默认用户根目录下直接启动。建议先用终端 cd 切换到你的具体数据分析项目文件夹,再唤起 Jupyter:
# 切换到你的代码存放目录
cd D:/DataAnalysisProjects/SalesAnalysis

# 启动 Jupyter 服务
jupyter notebook
# 或者使用更现代的多标签页交互界面:
jupyter lab
执行后终端会打印出本地本地 Web 服务地址(通常是 http://localhost:8888/tree),并自动在系统默认浏览器中弹出工作界面。
2. 核心机理:命令模式与编辑模式
初学者使用 Jupyter 最容易困惑的是按键没反应或者意外删除了代码。这是因为 Jupyter 的单元格(Cell)具有严格的两种工作状态:
- 编辑模式(Edit Mode):单元格处于文本输入状态,边框通常为高亮绿色(或明显的激活框)。此时键盘输入的所有字符都会直接输入到代码或文字中。在命令模式下按
Enter键,或直接用鼠标左键单击单元格内部即可进入。 - 命令模式(Command Mode):单元格处于结构控制状态,边框为蓝色或灰色,光标不闪烁。此时按键会被当作快捷指令(如添加、删除单元格)。在编辑模式下按
Esc键,或单击单元格左侧的空白边框即可退回命令模式。
3. 高频快捷键速查
熟练运用快捷键是摆脱鼠标频繁点击、提高分析专注度的关键。以下操作均在命令模式(Command Mode,按 Esc 之后)下触发:
| 按键 / 组合键 | 对应功能与作用场景 |
|---|---|
Shift + Enter |
运行当前单元格,执行完毕后自动聚焦或新建下一个单元格(最常用运行键)。 |
Ctrl + Enter |
就地运行单元格,执行完毕后光标仍然停留在当前单元格,适合反复调试同一段代码。 |
A |
在当前单元格上方(Above)插入一个空白单元格。 |
B |
在当前单元格下方(Below)插入一个空白单元格。 |
D, D |
连续按两次字母 D 键,直接删除当前聚焦的单元格。 |
M |
将当前单元格切换为 Markdown 文本格式,用于书写分析结论、注释或标题。 |
Y |
将当前单元格切换回 Code 代码格式。 |
0, 0 |
连续按两次数字 0 键,快速重启当前 Python 内核(清空全部内存中暂存的变量)。 |
I, I |
连续按两次字母 I 键,中断当前正在执行的单元格(死循环或运行过久时紧急制动)。 |
4. 极简实战样例:5 行代码探查与画图
在新建的 Notebook 中,选择前面绑定的 Python 3.10 (DataAnalysis) 内核,在一个 Code 单元格中写入以下代码,体会数据交互的流畅度:
import pandas as pd
import matplotlib.pyplot as plt

# 构造模拟月度销售数据
data = {"月份": ["1月", "2月", "3月", "4月", "5月"], "销售额(万)": [45, 52, 68, 61, 85]}
df = pd.DataFrame(data)

# 打印表格并直接内联绘制柱状图
display(df)
df.plot(x="月份", y="销售额(万)", kind="bar", color="#77b9ae", grid=True)
plt.title("2024 年上半年销售趋势", fontproperties="Microsoft YaHei")
plt.show()
按下 Shift + Enter 后,单元格下方将瞬间渲染出规整的 HTML 结构化表格以及清晰的彩色柱状图。这种代码与视觉产物紧密伴生的反馈循环,正是数据分析工作流的核心魅力所在。
五、常见问题与排错手册
1. 终端提示“conda 不是内部或外部命令”或“command not found”
原因排查:安装时未勾选将 Anaconda 添加到环境变量,且使用了操作系统普通的 CMD 或 PowerShell,导致系统找不到 conda.exe 的可执行路径。
解决办法:
- 推荐方案:无需修改系统变量,在开始菜单中搜索并打开
Anaconda Prompt,该终端默认加载了完整的 Anaconda 环境变量。 - 手动补齐 Path:在系统“高级系统设置” -> “环境变量” -> 系统变量
Path中,添加以下三条绝对路径(以安装在D:/Anaconda3为例):D:/Anaconda3D:/Anaconda3/ScriptsD:/Anaconda3/Library/bin
保存后重新启动终端即可识别conda指令。
2. Jupyter 中找不到刚才创建的虚拟环境
原因排查:很多初学者误以为 conda create 完成后 Jupyter 会自动发现。实际上,只有当该环境内安装了 ipykernel 并显式执行了内核注册命令,Jupyter 才能读取到对应的 kernel.json 规格定义文件。
解决办法:重新激活该环境并运行注册命令:
conda activate 你的环境名
conda install ipykernel -y
python -m ipykernel install --user --name 你的环境名 --display-name "自定义显示名称"
刷新浏览器中的 Jupyter 页面,在菜单栏 Kernel -> Change Kernel 中即可看到新内核。
3. 国内网络环境下 conda install 下载缓慢或连接中断
原因排查:默认情况下 Conda 会连接海外官方源,在网络波动较大时容易触发 HTTP 连接超时。
解决办法:配置国内镜像源。以配置清华开源镜像为例,在终端中依次输入:
conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/main/
conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/pkgs/free/
conda config --add channels https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud/conda-forge/
conda config --set show_channel_urls yes
配置后,执行 conda clean -i 清除本地索引缓存,后续下载速度将大幅改善。
4. 单元格左侧常驻 In [*],代码长时间没有输出
原因排查:In [*] 表示当前内核正在繁忙计算中。如果计算逻辑简单却一直保持星号状态,通常是因为代码陷入了死循环、正在下载大文件、或后台弹出了未被关闭的 GUI 窗口导致线程挂起。
解决办法:在菜单栏点击 Kernel -> Interrupt Kernel(快捷键 I, I)强制中断执行;若无响应,可直接点击 Kernel -> Restart Kernel(快捷键 0, 0)重启内核清空上下文,重新排查引起阻塞的代码段。
六、日常使用工作流总结
完成全套环境配置后,在日常的数据分析工作中,建议建立并遵守以下标准工作流:
- 按业务创建环境:新开启一个独立分析项目时,先用
conda create -n 项目名 python=3.10建立专属沙盒。 - 挂载内核:在该环境中安装
ipykernel并向 Jupyter 注册项目内核。 - 终端定位项目目录:先在终端
cd进入项目代码文件夹,再执行jupyter notebook或jupyter lab唤起开发界面。 - 选用对应 Kernel:在新建的
.ipynb页面右上角选择该项目专属的内核,展开探索性分析与可视化。 - 导出环境清单:项目交付或迁移时,通过
conda env export > environment.yml将当前所用到的全部库版本固化,其他协作者只需一条conda env create -f environment.yml即可在另一台设备上百分之百完整重现分析环境。
定期清理 Conda 下载缓存与未使用的包版本,可以使用命令 conda clean --all,这能为你的硬盘释放数个 G 的无用缓存空间,让系统始终保持清爽。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















