


为什么科学计算要把Python List转为NumPy Array
本文通过代码对比Python列表与NumPy数组在乘法、加法及多维统计中的行为差异,揭示转换的核心价值在于统一运算语义而非单纯提升性能。文章分析了向量化计算的适用边界,指出在动态收集和不规则数据场景下保留列表的合理性,帮助开发者根据后续操作需求做出准确的数据结构选择。
在科学计算中,把规则数值列表转成NumPy数组,首先改变的是运算语义,而不只是让程序“更快”。如果你希望每个数都乘二,列表的乘法恰好不会做这件事。下面以Python 3.12、NumPy 2.3.5核验过的小例子,说明转换解决什么问题,以及何时没有必要转。
列表乘二是在重复,数组乘二才是逐元素计算
先看同一组数字:
import numpy as np

values = [1, 2, 3]
print(values * 2)
a = np.array(values, dtype=np.float64)
print(a * 2)
核验输出:
[1, 2, 3, 1, 2, 3]
[2. 4. 6.]
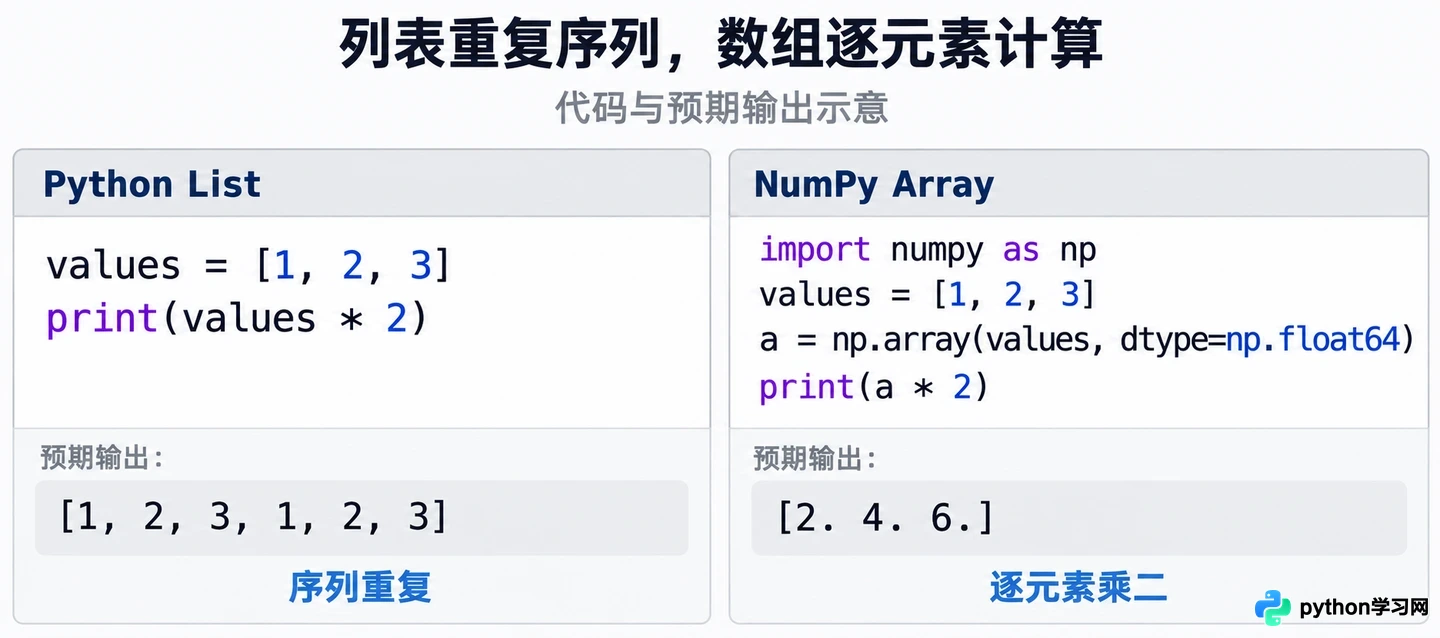
列表乘法导致序列重复,数组乘法实现逐元素运算
列表是通用序列,乘整数表示重复序列。数值数组则把乘法应用到各个元素。如果下游要的是测量值翻倍,列表写法没有报错,却已经得到错误含义;转换为数值数组后,表达式才对应预期计算。
类似地,values + 1会触发TypeError,而a + 1得到逐元素加一的结果。本例核验的数组结果为[2. 3. 4.]。不能只因语法长得像,就把Python序列运算和数值运算视为同一种规则。
shape和axis让二维统计的含义明确
科学数据常包含多个样本和多个指标。把规则的嵌套列表转换后,可以用shape表达结构,再按轴做计算:
m = np.array([[1., 2.], [3., 4.]])
print(m.sum(axis=0))
print(m.sum(axis=1))
核验输出:
[4. 6.]
[3. 7.]
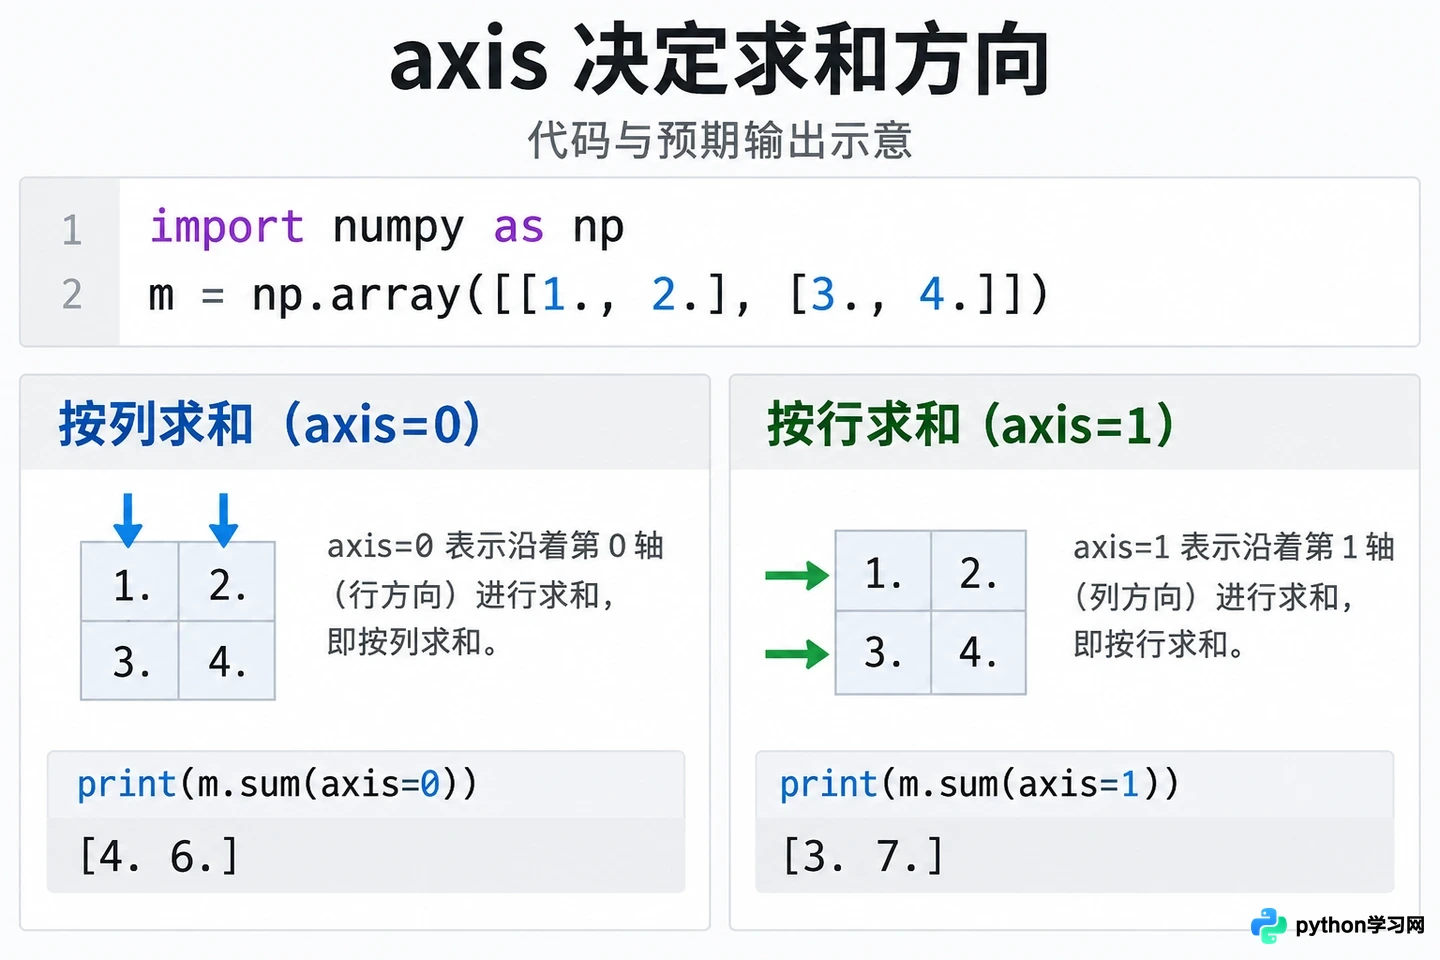
axis参数决定统计方向,需结合业务含义理解
axis=0沿行方向合并,留下每列的和;axis=1合并每行的列,留下每行的和。把行约定为样本、列约定为指标后,这种写法能直接表达统计方向。转换本身不会替你定义业务含义,若行列理解反了,数组计算也会稳定地产生不符合需要的结果。
二维数组要求规则结构。每行长度不同的数据,应先判断是缺失记录、需要补值,还是本来就是变长对象;不能为了让程序通过就随意补零。补零改变的可能是测量含义,而不只是数据格式。
性能来自批量数值处理,也有转换成本
NumPy为数组提供向量化运算,许多数值计算在编译后的实现中处理,减少逐个操作Python对象的解释器开销。对大量规则数值,这种方式通常比自己在Python里写逐元素循环更合适,也让代码更接近计算公式。
但把列表转成数组需要创建相应数据结构。若在循环中反复把同一份列表转换、只算一个很小的结果,再转回列表,转换和分配可能抵消收益。更合理的流程是进入数值处理阶段时统一转换,在连续计算中保留数组,真正需要普通列表接口时再转换出去。
这里没有做速度基准,也不提供快多少倍的承诺。数据规模、dtype、内存访问和计算方式都会影响结果;“用了NumPy”不能替代测量。中间运算还可能分配额外数组,大数据处理仍需关注内存。
不规则对象和动态收集,不一定该立即转
列表可以方便地追加元素、保存不同对象。日志记录、字符串片段和异构业务对象,并不会因为套上np.array就自动获得规则数值计算的好处。使用object数组也不等于获得了普通数值dtype的同样优势。
同样,在采集数据时用列表逐步收集,收集完成后再转换,是合理分工。没有必要为了遵守“科学计算必须用数组”的口号,在每次追加后都重新创建数组。若只做少量容器操作,保留列表可能更简单。
最终应按下一步的操作判断:需要形状、按轴统计和逐元素数值计算,就在明确dtype与结构后转成数组;需要动态收集和通用对象管理,就先用列表。转换的价值在于让数据结构与计算语义一致,性能则要在具体任务中验证。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















