


Python机器学习入门教材推荐:从基础语法到scikit-learn实战

学习Python机器学习最常遭遇的困境不是数学太深,而是学习链路割裂:初学者往往在纯语法书中耗费数月,转入算法时面对特征矩阵、交叉验证和scikit-learn面向对象的API时依然束手无策。本文针对这一痛点,构建一条从“Python核心编程规范”到“数据清洗矩阵化”,再到“scikit-learn端到端建模”的四阶段学习链路,精选经久验证的权威教材,并明确各阶段必须掌握的最小知识集与实战边界。
一、全流程学习链路与教材定位
学习机器学习不需要通读厚重的算法理论专著,也不需要先成为全栈Python工程师。一个务实的学习策略是以工程落地为牵引:掌握语法中面向对象与迭代器的核心机制,熟悉数据处理中多维数组与表格的操作习惯,最后直接进入scikit-learn的标准模型流水线。
从学习逻辑上看,这分为四个紧密相连的阶段。每个阶段对应一本定位精准的教材,确保读者投入的每一小时都直接为后续算法建模提供支撑。
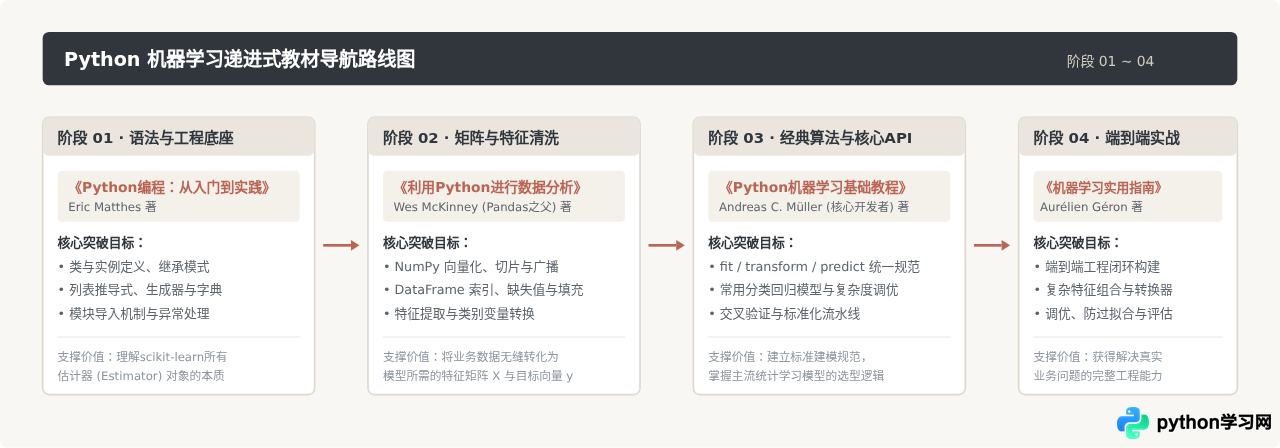
二、四部核心教材深度解读与阅读指南
许多初学者学完语法却无法进入机器学习,原因是基础教学过于碎片化。这本书上半部分的真正价值在于让初学者迅速掌握函数封装、列表推导、字典组织以及面向对象编程(类与方法)。
- 重点章节:第 9 章(类)、第 8 章(函数)、第 10 章(文件和异常)。必须透彻理解
self的含义、构造函数__init__、方法调用与属性绑定。 - 跳读建议:下半部分的“外星人入侵”Pygame 项目和“Web 应用程序”Django 项目可暂时跳过,直接将精力投入第 15~17 章关于数据可视化的练习上。
scikit-learn 不接受未整理的原始文本或杂乱的字典列表,它要求输入严密的二维特征矩阵(通常是 NumPy ndarray 或 Pandas DataFrame)。本书由 Pandas 库的创始人亲笔撰写,是目前市面上讲解 NumPy 向量化运算与 Pandas 高性能数据重塑最为详实规范的著作。
- 核心必须掌握:NumPy 的数组切片、形状重塑(
reshape)、类型转换(astype)与广播机制;Pandas 的loc/iloc索引、缺失值检测与填充(fillna/dropna)、类别变量转换(pd.get_dummies)。 - 关键认知转化:告别 Python 原生的
for循环,学会使用向量化操作处理批量数据。这直接决定了后续特征预处理的代码质量与执行效率。
第一作者 Andreas Müller 曾长期担任 scikit-learn 项目的核心维护者。本书不堆砌高深复杂的数学推导,而是紧紧围绕“如何正确选择模型、如何使用 scikit-learn API 正确拟合、如何合理解释输出”展开。
- 核心突破:透彻理解 Estimator 对象的
fit(拟合)、predict(预测)以及 Transformer 对象的fit_transform机制。 - 必读篇章:第 6 章“算法链与管道(Pipeline)”。这一章是初学者避免“数据泄露”的分水岭,演示了如何将数据缩放与分类模型封装在一个严密的管道中。
本书(通常简称为 Hands-On ML)是全球公认的机器学习工业界实战圣经。虽然书名包含了深度学习框架,但其第一部分(前 1~9 章)完全聚焦于经典机器学习与 scikit-learn 的高级实战。
- 必读核心:第 2 章“端到端机器学习项目”(加州房价预测)。它完整演示了一个工业界数据科学家从创建测试集(分层抽样)、数据探索、编写自定义数据清洗转换器(
BaseEstimator和TransformerMixin)、管道编排、网格搜索(GridSearchCV)到模型评估与特征重要性分析的完整闭环。 - 精读章节:第 3 章(分类任务中的精确率、召回率、ROC-AUC 折衷)与第 4 章(梯度下降、正则化逻辑回归)。
三、scikit-learn 核心工作流与标准代码骨架
为了让读者在阅读《Python机器学习基础教程》和《机器学习实用指南》时能直接对照实操,下面给出一个符合工业界工程规范的最小闭环工作流。任何常规的表格数据机器学习任务,都应遵循下图所示的流水线进行组织:
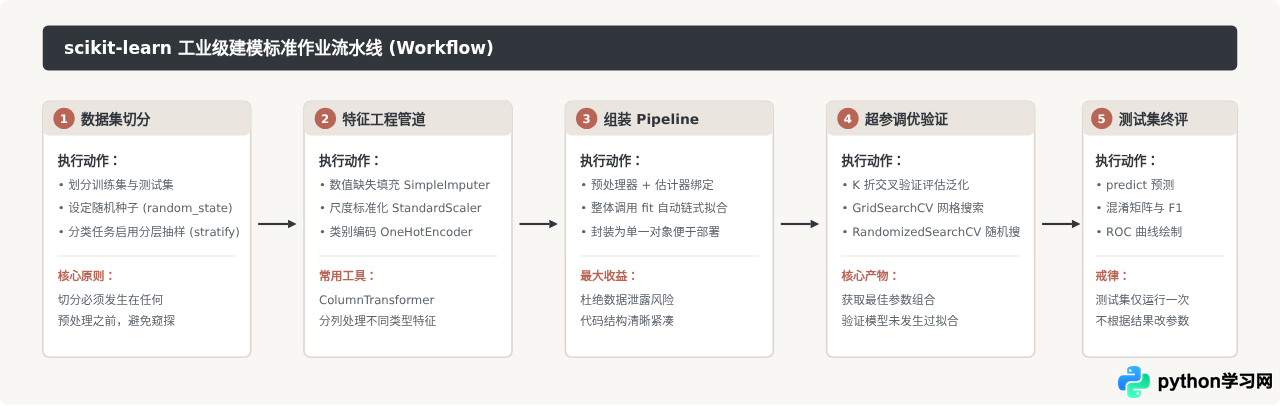
以下是配合《Python机器学习基础教程》第 6 章阅读时的标准参考代码,完整展示了预处理与分类器在 Pipeline 中的联合封装:
# 导入必要模块(环境要求:Python 3.9+, scikit-learn 1.2+)
import numpy as np
from sklearn.datasets import load_breast_cancer
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.svm import SVC
from sklearn.metrics import classification_report

# 1. 加载数据并立即隔离测试集
data = load_breast_cancer()
X, y = data.data, data.target
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 2. 组装流水线:预处理与估计器串联,避免数据泄露
pipe = Pipeline([
    ('scaler', StandardScaler()),
    ('svm', SVC())
])

# 3. 配置网格搜索参数空间(注意参数前缀为 pipeline 中的组件名 + 双下划线)
param_grid = {
    'svm__C': [0.1, 1, 10, 100],
    'svm__gamma': [0.001, 0.01, 0.1, 1]
}

# 4. 在训练集上执行 5 折交叉验证调优
grid = GridSearchCV(pipe, param_grid=param_grid, cv=5, scoring='f1')
grid.fit(X_train, y_train)

# 5. 在未参与任何训练和调优的测试集上进行最终验证
best_model = grid.best_estimator_
y_pred = best_model.predict(X_test)

# 输出评估报告(示例结构)
print("最佳超参数:", grid.best_params_)
print("\n测试集分类报告:\n", classification_report(y_test, y_pred, target_names=data.target_names))
四、读者背景与教材搭配选型矩阵
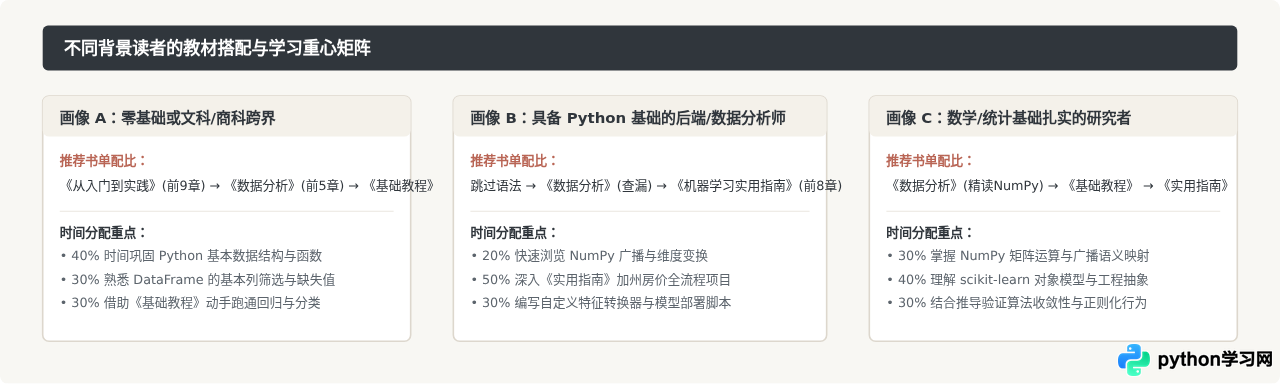
不同读者的知识储备和学习目的不同,机械地通读全部书籍并不高效。下表与图示梳理了常见的三类学习者画像及其最适配的教材组合方式:
| 教材名称 | 核心侧重 | 数学理论深度 | 代码实战比例 | 建议用时 |
|---|---|---|---|---|
| 《Python编程:从入门到实践》 | 基础语法、类与对象、编程思维 | 无数学要求 | 90% 实战演练 | 2 ~ 3 周 |
| 《利用Python进行数据分析》 | NumPy 高性能计算、Pandas 表格清洗 | 初等代数概念 | 85% 数据操作 | 3 ~ 4 周 |
| 《Python机器学习基础教程》 | 算法核心直觉、scikit-learn API、管道编排 | 直观概念为主,轻公式 | 80% 建模实操 | 3 ~ 4 周 |
| 《机器学习实用指南》(Hands-On ML) | 端到端工业项目闭环、模型深度调优 | 中等(含损失函数推导) | 75% 完整工程 | 5 ~ 6 周 |
五、入门阶段必须警惕的四个核心误区
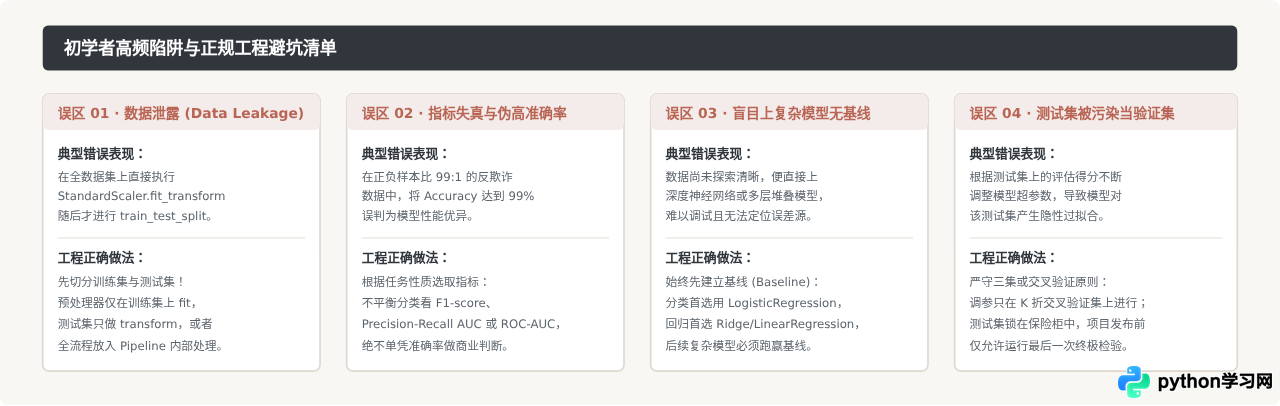
很多初学者在阅读教材和尝试跑代码时,看似代码无报错且准确率高达 99%,实际上模型在生产环境中毫无泛化能力。结合教材中的注意事项,必须警惕以下四个最易发生的隐蔽错误:
六、高效阅读与实操推进建议
学习机器学习技术,最忌讳“像读小说一样通读全书”。真正高效的学习者都采用“以项目闭环倒逼概念查阅”的模式。建议按以下步骤安排学习节奏:
- 前两周完成最小代码语法集:跟随《Python编程:从入门到实践》完成变量、列表、字典、函数和类的练习,能够独立手写一个带有属性和方法的类。
- 第三至四周掌握数组与表格重塑:使用《利用Python进行数据分析》中的加州人口或鸢尾花数据集,熟练使用 Pandas 筛选列、处理 NaN 缺失、提取统计均值并将数据导出为 NumPy 数组。
- 第五至七周精通 scikit-learn 常用 API:以《Python机器学习基础教程》为底本,逐一跑通 KNN、逻辑回归、支持向量机、决策树与随机森林。务必在第 6 章“管道与参数搜索”停留一周,直到自己能闭卷写出
Pipeline和GridSearchCV的标准骨架。 - 第八周完成一个工业级端到端课题:完整复现《机器学习实用指南》第 2 章的端到端项目,不跳过其中的数据探索(直方图与相关系数分析)、自定义转换器编写与模型误差分析。
通过这套层层递进的书单组合与严格的工程规约,初学者可以在两个月内建立起扎实、规范、无明显短板的 Python 经典机器学习实战能力,为后续进阶集成学习(XGBoost/LightGBM)或深度学习(PyTorch)奠定坚实的工程底座。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















