


Python @property装饰器与property()函数写法有什么区别
深入对比Python中@property装饰器与property()函数的写法区别、底层描述符实现机制、语法糖展开过程、继承重写行为差异及动态属性工厂的选型实践。
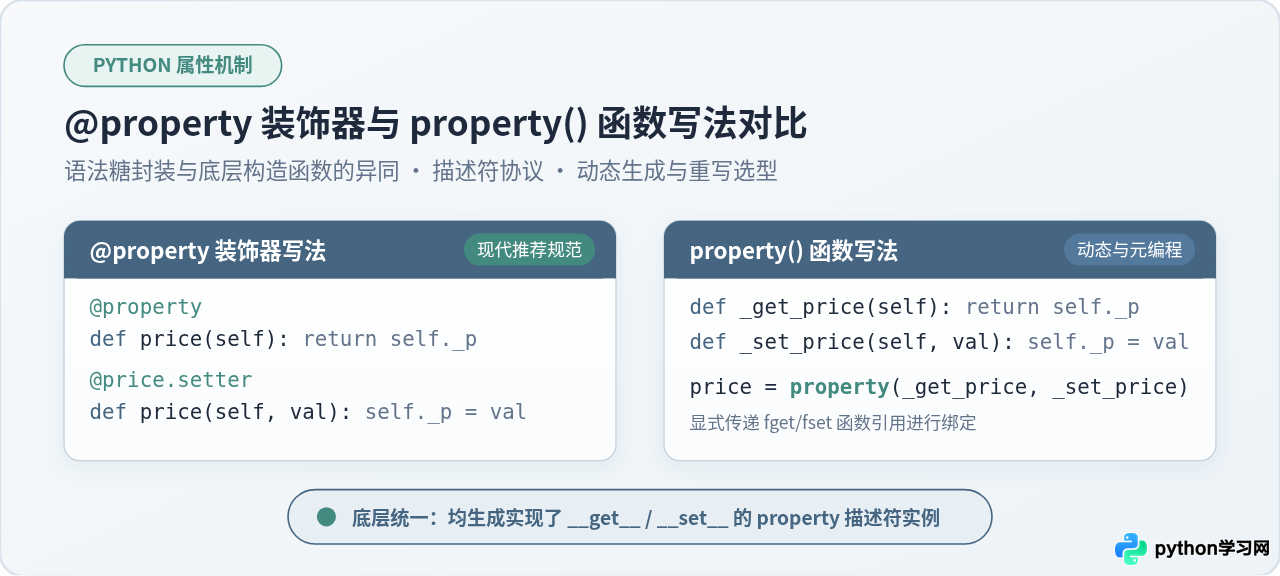
核心答案:在 Python 中,@property 装饰器与 property() 函数在底层完全基于同一机制运作——它们创建的都是内置描述符类型 property 的实例。两者的本质差异在于语法形式、代码组织结构与适用场景:@property 是 Python 2.4 引入的现代语法糖,它将属性的读、写、删逻辑紧凑地约束在同名方法下,不污染类命名空间,是日常面向对象开发中的首选;而 property() 则是直接调用构造函数显式绑定函数引用,其不可替代的优势在于运行期动态元编程、批量生成属性以及重构兼容遗留代码。
一、两种写法的基本形式与代码结构对比
为了直观感受代码组织形态的不同,我们以一个电商领域中常见的商品模型 Product 为例,该模型需要对单价 price 属性进行非负数校验。
1. 函数式写法:property() 显式传递参数
在 Python 早期版本(以及如今的动态构建逻辑中),定义一个受控属性的标准方式是先编写常规的辅助方法,然后在类体末尾调用内置 property() 函数完成实例化与属性绑定:
class ProductByFunc:
    def __init__(self, price: float):
        self._price = price

    # 1. 定义独立的 getter 辅助方法
    def _get_price(self) -> float:
        return self._price

    # 2. 定义独立的 setter 辅助方法
    def _set_price(self, value: float) -> None:
        if value < 0:
            raise ValueError("价格不能为负数")
        self._price = value

    # 3. 定义独立的 deleter 辅助方法
    def _del_price(self) -> None:
        del self._price

    # 4. 在类命名空间中集中组装并暴露公开属性
    price = property(
        fget=_get_price,
        fset=_set_price,
        fdel=_del_price,
        doc="商品的单价(元),自动校验非负"
)这种写法的特点是逻辑相对分散:_get_price、_set_price 等函数名称存在于类的作用域内。即使开发者约定俗成地加上单下划线前缀,它们依然作为独立的实例方法暴露在对象字典中。
2. 装饰器写法:@property 原位标注
现代 Python 代码中普遍推荐采用装饰器语法。此时所有存取方法的名称与公开属性完全同名,通过不同的修饰符区分职能:
class ProductByDec:
    def __init__(self, price: float):
        self._price = price

    @property
    def price(self) -> float:
        """商品的单价(元),自动校验非负"""
        return self._price

    @price.setter
    def price(self, value: float) -> None:
        if value < 0:
            raise ValueError("价格不能为负数")
        self._price = value

    @price.deleter
    def price(self) -> None:
        del self._price
在外部调用时,两种写法的表现完全一致:无论是 p.price 触发读取,p.price = 99.5 触发写入校验,还是 del p.price 触发删除,外部使用者均感受不到底层实现的区别。
二、底层机制:@property 是如何等价展开的?
许多初学者会产生一个疑问:在装饰器写法中,为什么 getter、setter 和 deleter 必须使用一模一样的函数名?为什么定义了 @price.setter 之后,前面的函数不会被简单粗暴地覆盖丢弃?
理解这个问题的关键,在于了解 property 对象的不可变设计以及 Python 解释器对装饰器的去糖(Desugaring)过程。
1. 逐步推导展开过程
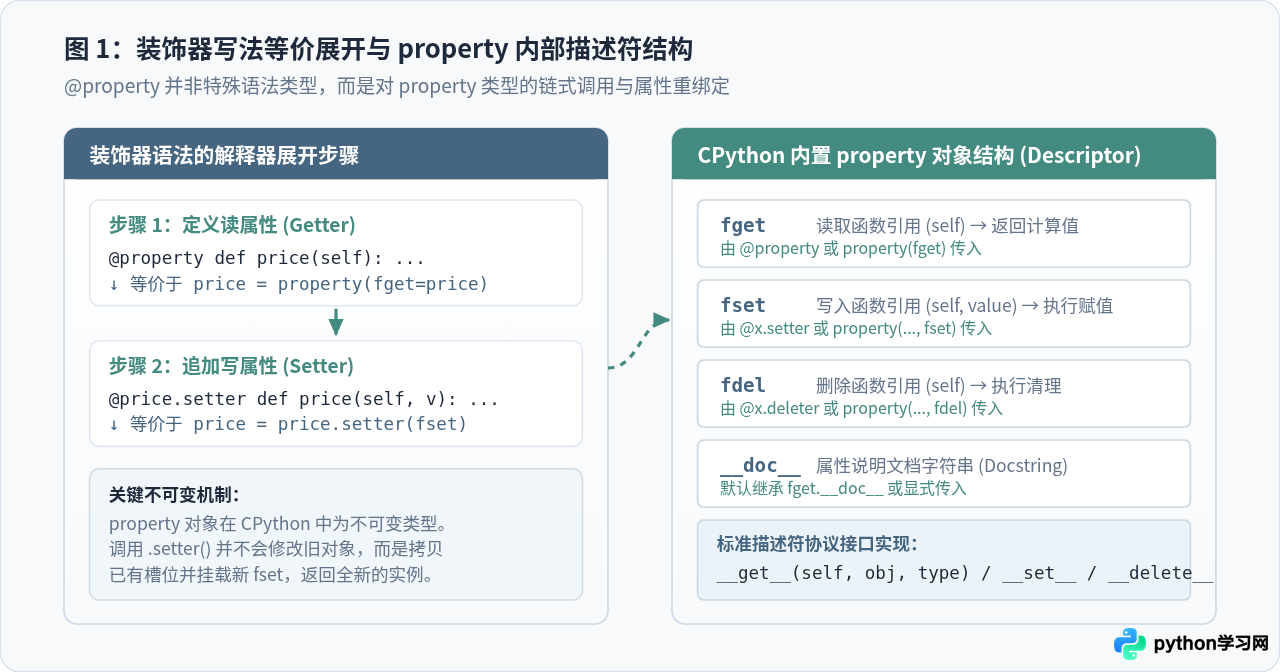
当 Python 解释器解析 ProductByDec 类定义体时,发生了如下连续计算:
- 创建只读属性:执行
@property def price(self): ...时,解释器先创建普通函数price,随后执行price = property(price)。此时,变量price已经不再是一个函数,而是一个property类型的描述符实例,它的fget槽位保存了该函数的引用,同时自动提取其文档字符串。 - 挂载写入逻辑:接着遇到
@price.setter def price(self, value): ...。这里的price正是第一步产生的描述符对象。该对象拥有内置方法.setter(fset)。 - 返回新描述符并重新赋值:在 CPython 源码中,
property对象是不可变的(Immutable)。调用price.setter(...)绝不会就地修改原对象,而是重新分配一个全新的property实例,该实例拷贝了原先的fget、fdel和__doc__,并将新的fset填入对应槽位。最后,由于函数名依然是price,新生成的描述符再次赋值给类变量price,完成了无缝替换。
不可变设计保证了属性定义过程中的线程安全与引用隔离。如果 .setter() 采取原地修改,在多继承或者多次属性复用时可能引发隐蔽的副作用。这也解释了为什么必须使用同名函数接收返回值:如果不写成 def price(...),新生成的完整描述符就无法重新绑定到 price 类变量上。
三、运行期执行:描述符协议与调用拦截
当我们在业务逻辑中通过实例访问属性时,Python 解释器究竟是如何介入并分发调用的?这就涉及到 Python 面向对象的核心骨架——描述符协议(Descriptor Protocol)。
1. 属性查找优先级与拦截原理
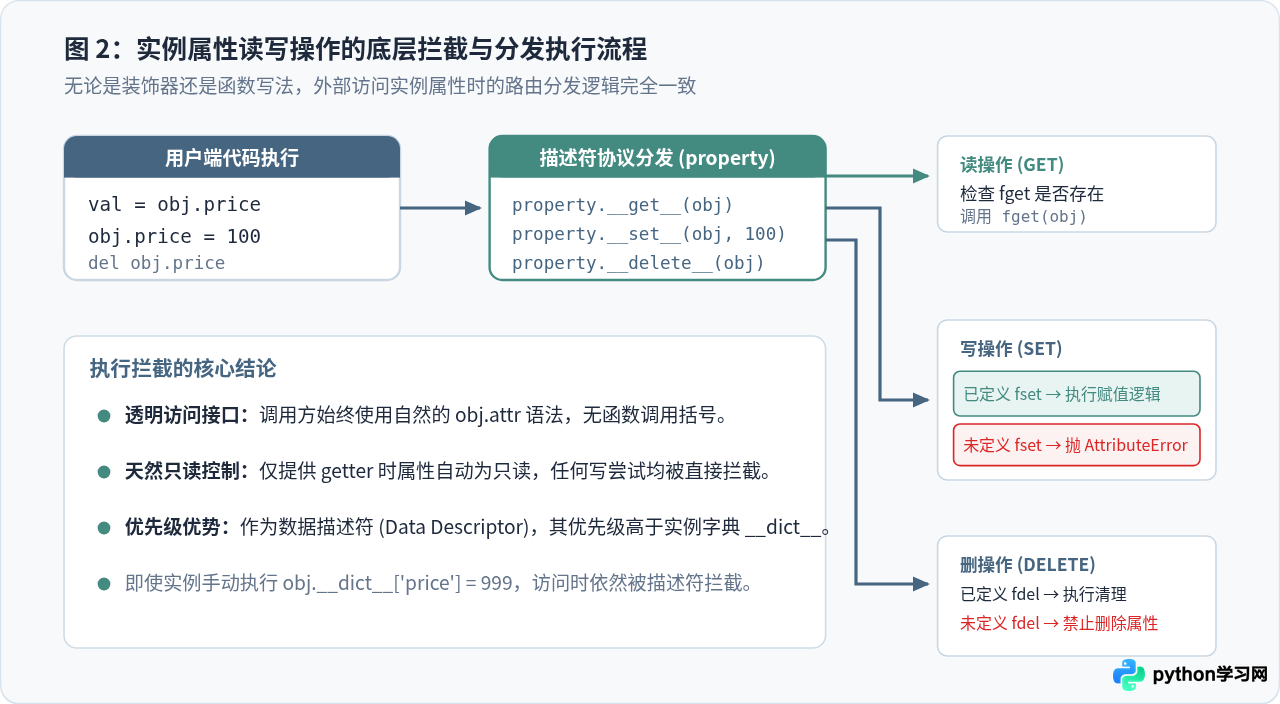
任何实现了 __get__、__set__ 或 __delete__ 特殊方法的对象都被称为描述符。当一个描述符同时实现了 __get__ 和 __set__ 时,它被称为数据描述符(Data Descriptor)。
在 Python 的对象模型中,数据描述符的查找优先级严格高于实例自身的字典(__dict__)。这意味着:
- 当执行
obj.price时,解释器检测到类属性price是一个带有__get__的描述符,因此直接调用Product.price.__get__(obj, Product),进而触发绑定的fget(obj)。 - 当执行
obj.price = 100时,解释器直接调用Product.price.__set__(obj, 100)。若该描述符没有配置fset(例如仅使用了@property的只读属性),描述符内部会直接抛出AttributeError: can't set attribute。 - 即使恶意代码试图通过
obj.__dict__['price'] = -50绕过校验注入实例字典,下一次直接访问obj.price时,解释器依然会优先走__get__逻辑,从而确保内部状态的严密防护。
四、继承与子类重写:常见的失效陷阱与解决方案
在类的继承体系中,针对属性的重写是两种写法产生认知分化、也是开发者最容易踩坑的场景之一。
1. 常见陷阱:直接用 @property 重写导致 setter 丢失
假设我们有一个基础商品类,子类 DiscountProduct 想要在读取价格时计算折扣,但希望沿用父类的价格写入校验逻辑。许多人会习惯性地写出如下代码:
class DiscountProductBad(ProductByDec):
    @property
    def price(self) -> float:
        # 尝试仅重写 getter,打八折
        return super().price * 0.8

# 运行测试
p = DiscountProductBad(100.0)
print(p.price)      # 输出: 80.0(正常读取)
p.price = 200.0 # 报错!AttributeError: can't set attribute原因剖析:子类中的 @property def price(self) 重新执行了 price = property(fget),完全新建了一个不包含 fset 的全新描述符,把父类继承而来的完整描述符彻底覆盖了!
2. 正确解决方案:借由父类描述符追加或重写
如果希望在子类中单独重写或保留某一个维度的行为,必须明确引用父类的描述符:
class DiscountProductGood(ProductByDec):
    # 方案 A:在子类中重写 getter,同时复用父类的 setter
    @ProductByDec.price.getter
    def price(self) -> float:
        return self._price * 0.8

    # 方案 B:如果子类只重写 setter,则借由父类描述符挂载
    # @ProductByDec.price.setter
    # def price(self, value: float) -> None:
    #     super(DiscountProductGood, type(self)).price.fset(self, value)
而如果使用 property() 函数写法,由于各环节均是显式的普通方法,重写通常体现为重写 _get_price() 方法,然后在子类中重新定义 price = property(_get_price, Parent._set_price)。相比之下,装饰器写法的 @BaseClass.prop.getter 在语义上更为直白精确。
五、动态元编程:property() 函数不可替代的独特优势
既然 @property 装饰器语义优美、内聚度高,那么原始的 property() 函数写法是否已经沦为过时的历史包袱?
答案是否定的。在动态生成属性、属性工厂模式以及批量元编程场景下,property() 函数是不可或缺的核心利器。因为装饰器语法依赖于 def 静态语法节点,无法直接放置在循环或动态构建流程中。
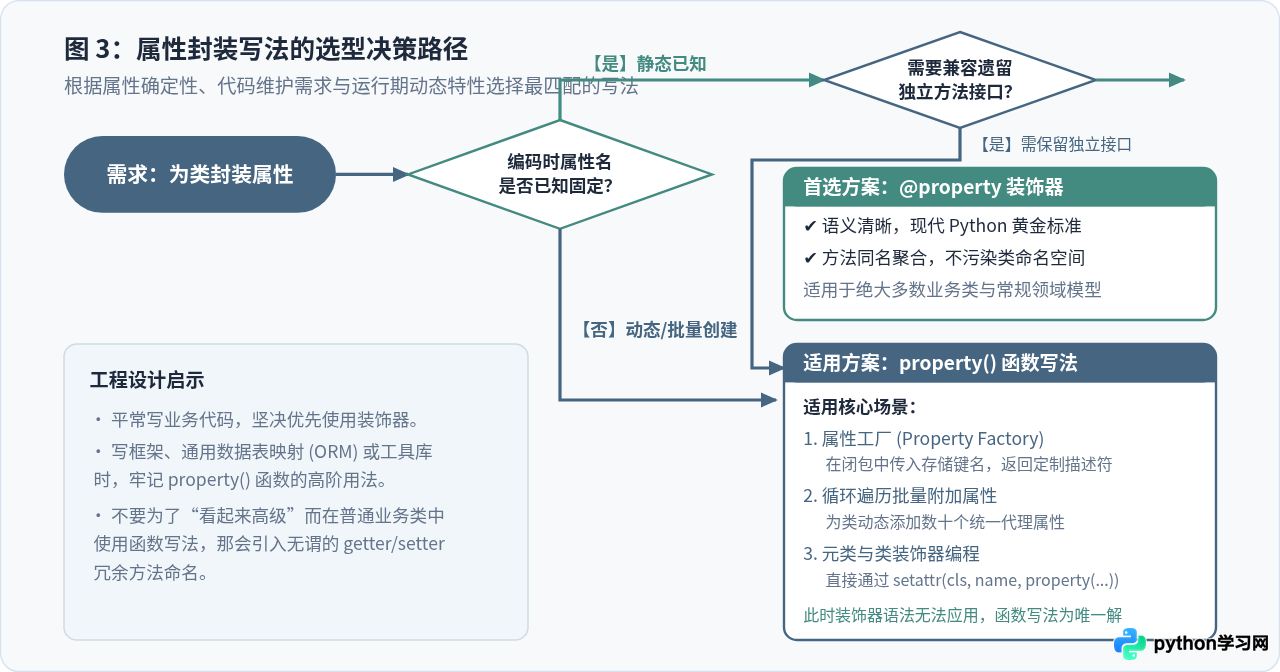
典型实战:通用属性工厂(Property Factory)
假设我们正在开发一个配置对象或 ORM 框架,需要为数十个字段提供统一的“非空字符串校验”与“私有存储代理”。如果使用 @property 装饰器,必须机械地复制粘贴数十次几乎相同的代码模板;而使用 property() 函数式工厂,只需几十行代码即可优雅实现:
def string_field(storage_name: str, doc: str = ""):
    """动态生成属性描述符的闭包工厂函数"""
    def fget(self):
        return getattr(self, storage_name, "")

    def fset(self, value):
        if not isinstance(value, str) or not value.strip():
            raise ValueError(f"属性必须为非空字符串")
        setattr(self, storage_name, value.strip())

    # 直接返回动态构建的 property 实例
    return property(fget, fset, doc=doc)


class UserProfile:
    # 使用工厂动态声明,无需编写任何冗余的 getter/setter 函数体
    username = string_field("_username", doc="用户昵称")
    email = string_field("_email", doc="联系邮箱")
    company = string_field("_company", doc="所属组织")

    def __init__(self, username: str, email: str, company: str):
        self.username = username
        self.email = email
self.company = company在上述案例中,property() 作为一等公民函数直接在闭包中装配并返回。这种动态配置在元类(Metaclass)、类装饰器以及批量绑定字段时发挥着巨大威力,这恰恰是静态的 @property 语法糖难以实现的。
六、全方位特性对比与开发规范总结
为了帮助大家在日常架构设计与代码评审中迅速决策,我们将两种写法的关键差异总结如下:
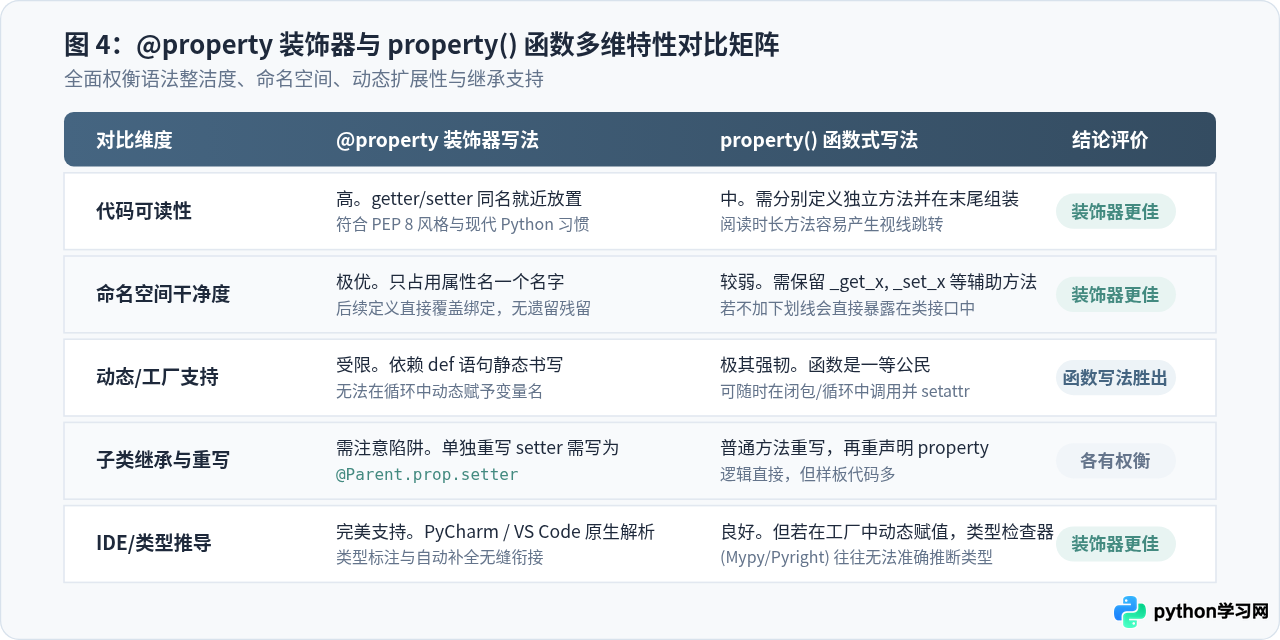
| 考量维度 | @property 装饰器写法 | property() 函数式写法 | 开发选型建议 |
|---|---|---|---|
| 语法可读性 | 极高。方法名称一致且紧凑排列,视觉焦点集中。 | 中等。需要单独定义辅助函数并在末尾集中赋值。 | 日常业务类与领域模型首选装饰器。 |
| 命名空间污染 | 无污染。仅在类中暴露属性名称自身。 | 存在污染。必须保留类似 _get_x 的额外方法。 |
注重 API 纯净度时优先选择装饰器。 |
| 动态生成能力 | 弱。语法受限于固定的 def 声明语句。 |
极强。可在循环、闭包及元类中随意调用与绑定。 | 框架设计、动态字段映射必须使用函数式写法。 |
| IDE 与类型支持 | 极其完备。主流 IDE 能精确识别类型标注并进行代码补全。 | 良好。但在工厂动态赋值时类型推导可能弱化。 | 对强类型检查(Mypy/Pyright)友好的项目首选装饰器。 |
| 文档字符串处理 | 自然继承 @property 修饰的 getter 函数的 docstring。 |
支持通过 doc 参数显式传入字符串。 |
两者均能满足文档工具(如 Sphinx)的提取需求。 |
常规编码用装饰器,框架与动态装配用函数式。日常业务开发中,遵守 PEP 8 推荐规范,统一采用 @property、@x.setter、@x.deleter;在需要编写属性工厂、批量代理字段或元类注入属性等高阶场景下,果断借助 property() 函数的函数式特性,发挥 Python 动态语言的最大灵活性。
本文深入解析了 Python 内置属性封装机制的底层原理与工程实践,所有代码示例均可在 Python 3.8+ 标准运行环境中直接验证。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















