


怎么正确获取Python远程执行Shell命令的退出码和错误日志?
详细讲解在 Python 中远程执行 Shell 命令时正确获取退出状态码(Exit Code)与标准错误日志(STDERR)的核心方法。深入剖析 SSH 通道传输机制、PTY 伪终端导致错误流合并的陷阱,以及管道缓冲区满载引发的死锁问题,并给出生产级代码实践与对比。
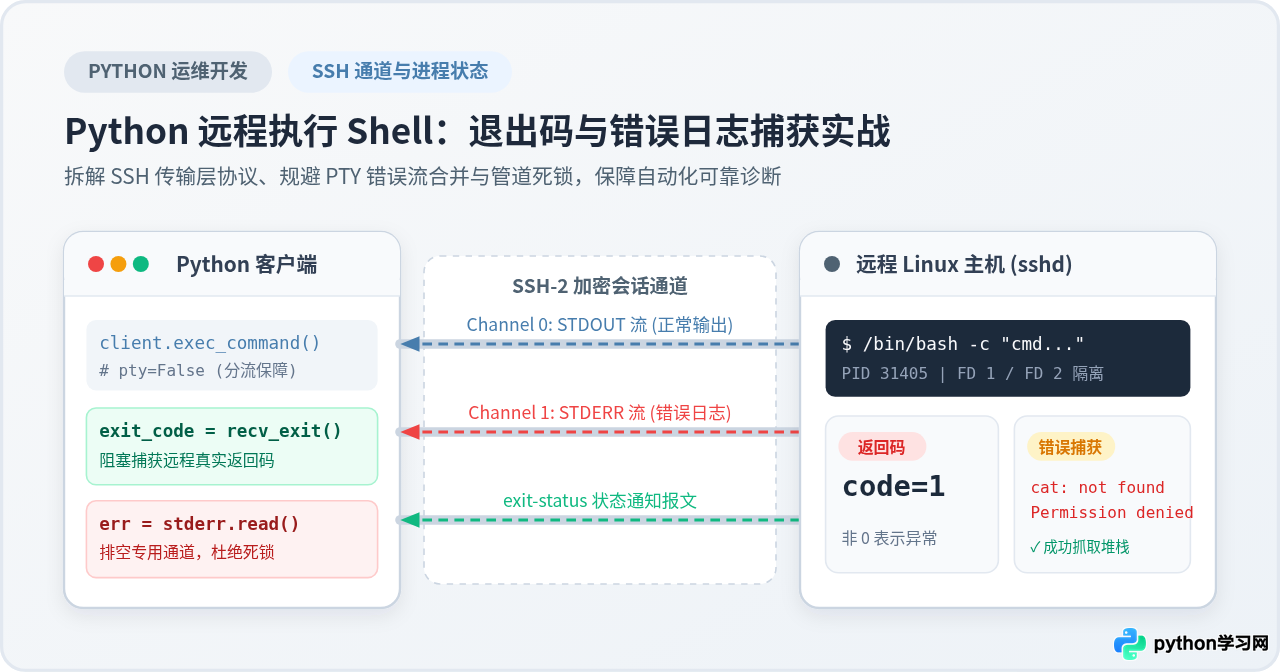
核心解决路径:在 Python 远程执行 Shell 命令时,很多开发者经常遭遇“命令报错但错误日志为空”或者“大输出量时程序无故卡死挂起”的问题。正确捕获退出码与错误日志的关键在于三点:一是非交互命令严禁开启伪终端(get_pty=False),否则远程终端驱动会将标准错误(STDERR)强行合并到标准输出(STDOUT),导致 stderr.read() 永远为空;二是必须先排空或并发读取输出流,杜绝直接阻塞等待退出码,防止远程 Linux 系统的 64KB 管道缓冲区溢满而陷入双向死锁;三是通过正确的协议接口(如 Paramiko 的 channel.recv_exit_status() 或 Fabric 的 result.exited)提取真实退出码,并配合 set -o pipefail 保障多级管道命令的真实报错状态有效回传。
一、SSH 远程通道的退出码与错误流传输机制
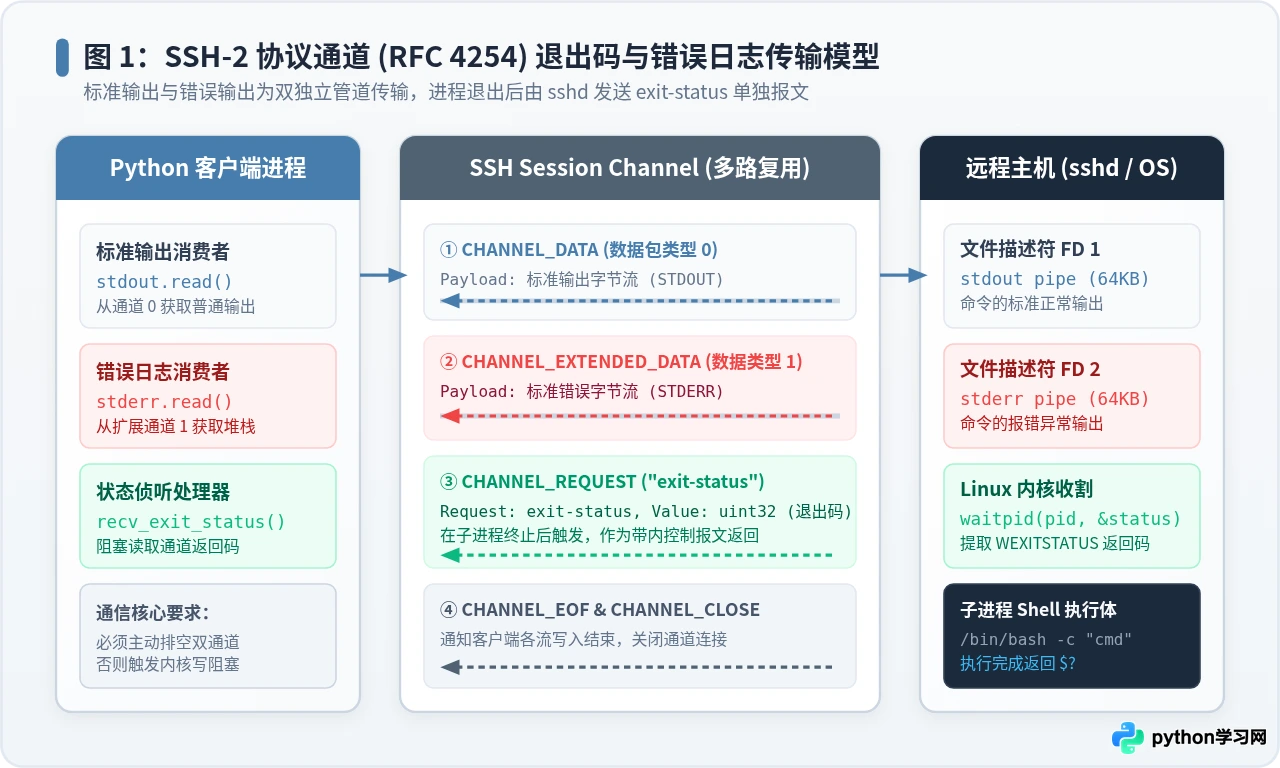
在本地终端执行 Shell 命令时,进程的文件描述符 FD 1(标准输出)与 FD 2(标准错误)直接打印在屏幕上,命令退出后父进程通过系统的 waitpid() 获取返回值。然而,在 Python 通过 SSH 协议连接远程主机执行命令时,底层传输依托于 RFC 4254(SSH-2 Connection Protocol) 的会话通道(Session Channel)。
当 Python 客户端向远程 sshd 守护进程发送 exec 请求时,SSH 会建立一个逻辑通道并在网络层严格拆分数据类型:
- 标准输出通道(Channel Data):携带数据类型为 0 的普通业务输出字节流(STDOUT)。
- 扩展错误通道(Channel Extended Data):携带数据类型为 1 的标准错误字节流(STDERR),用于传输远程命令输出的异常堆栈与警告日志。
- 退出状态控制报文(exit-status Request):远程 Shell 进程终止后,远程系统内核的
waitpid()捕获到进程退出码,sshd 服务端将其封装为一个独立的带内控制报文SSH_MSG_CHANNEL_REQUEST(请求类型为exit-status),其中包含一个 32 位无符号整数(通常为 0~255)。随后服务端向客户端发送CHANNEL_EOF和CHANNEL_CLOSE。
许多刚接触远程执行的开发者容易误将 stderr 当作一个已经就绪的字符串变量直接读取。实际上,它在 Python 内存中表现为一个网络套接字数据流包装对象,必须经过底层 I/O 消费才能完整获取。如果传输机制理解有误,不仅会导致错误日志丢失,还会破坏整个进程生命周期。
二、Paramiko 的标准实现与两大高频暗坑
Paramiko 是 Python 生态中最经典的纯 Python SSH 客户端库。在实际生产代码中,很多程序都采用 client.exec_command()。然而,正是这个看似简单的接口,暗藏了两个导致大量线上脚本故障的高频暗坑。
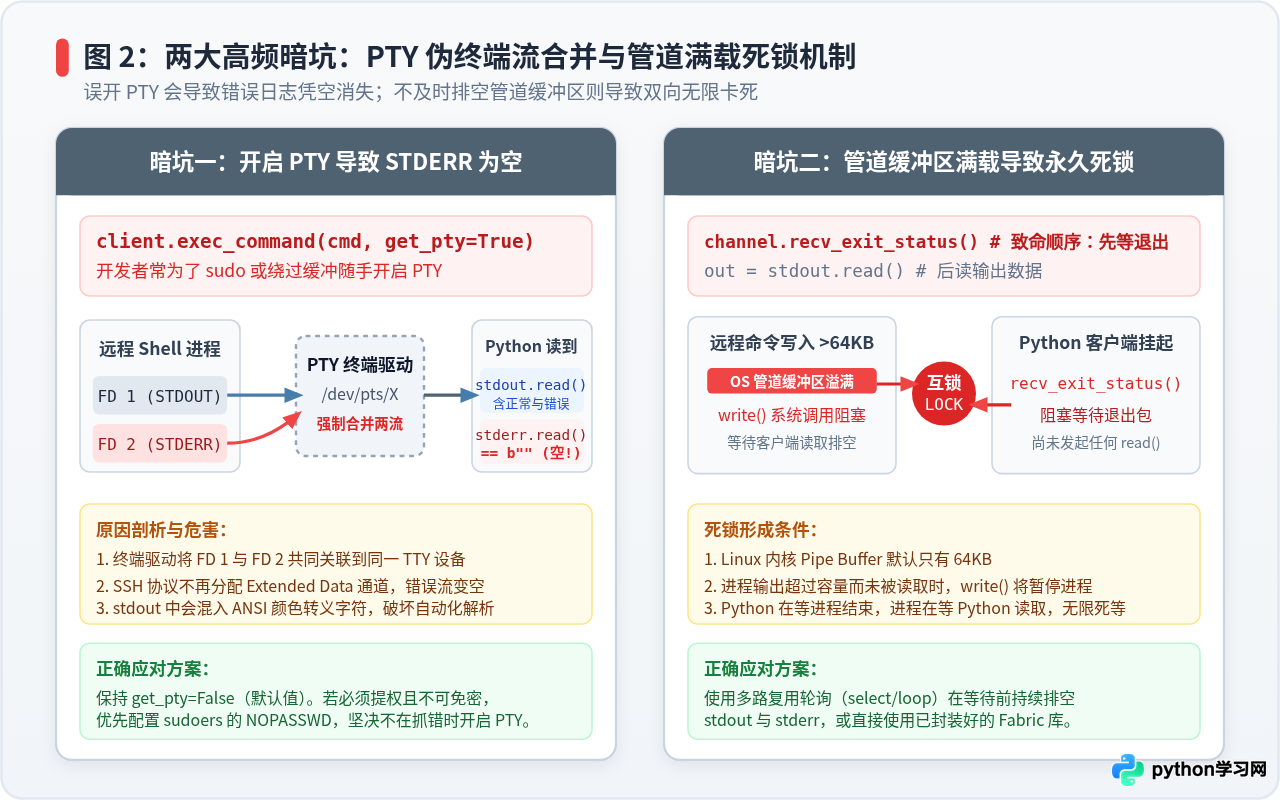
暗坑一:误开伪终端 get_pty=True 导致 STDERR 被彻底吃掉
很多开发者为了执行需要 sudo 提权的命令,或者为了防止远程程序产生输出缓冲,习惯性地在调用时传入 get_pty=True:
# 错误示例:误开 PTY 会导致 stderr 永远为空!
stdin, stdout, stderr = client.exec_command("ls /not_exist_file", get_pty=True)
exit_code = stdout.channel.recv_exit_status()
err_msg = stderr.read().decode('utf-8')
print(f"Code: {exit_code}, Error: '{err_msg}'")
# 输出结果:Code: 2, Error: '' (错误日志离奇失踪!)当开启 PTY 时,远程 Linux 内核会分配一个伪终端驱动设备(如
/dev/pts/X)。在 Unix 终端驱动规范中,终端会将挂载在其上的进程的标准输出(FD 1)和标准错误(FD 2)全部定向并混合到同一个从属 TTY 设备中。sshd 因而只向 SSH 客户端建立单一的 CHANNEL_DATA 流,而不再分配 CHANNEL_EXTENDED_DATA 流!其后果是:所有的错误日志都被混入到了 stdout 中,并混杂着终端特有的 ANSI 颜色转义字符;而 stderr.read() 永远只能读出空字节 b""。
暗坑二:缓冲区占满导致进程双向死锁(Deadlock)
第二个极其隐蔽的问题是调用顺序导致的死锁。很多新手写出如下代码:
# 致命顺序:大输出量时将陷入永久卡死
stdin, stdout, stderr = client.exec_command("find / -name '*.log'", get_pty=False)
exit_code = stdout.channel.recv_exit_status()  # 先阻塞等命令结束
out = stdout.read()                            # 后读取输出
err = stderr.read()                            # 后读取错误
在 Linux 系统中,内核为标准输出和标准错误分配的单端管道缓冲区(Pipe Buffer)默认仅为 64KB。如果远程命令输出了大量数据(例如查找文件、编译日志或大文本提取),一旦输出填满了 64KB 的管道缓冲区,远程进程调用 write() 时就会被操作系统内核挂起,等待读取端消费数据;而此时 Python 客户端却正通过 recv_exit_status() 阻塞等待远程进程退出。远程进程在等客户端读,客户端在等远程进程退,双方形成经典的相互等待,脚本陷入永久死锁!
Paramiko 生产级健壮封装实现
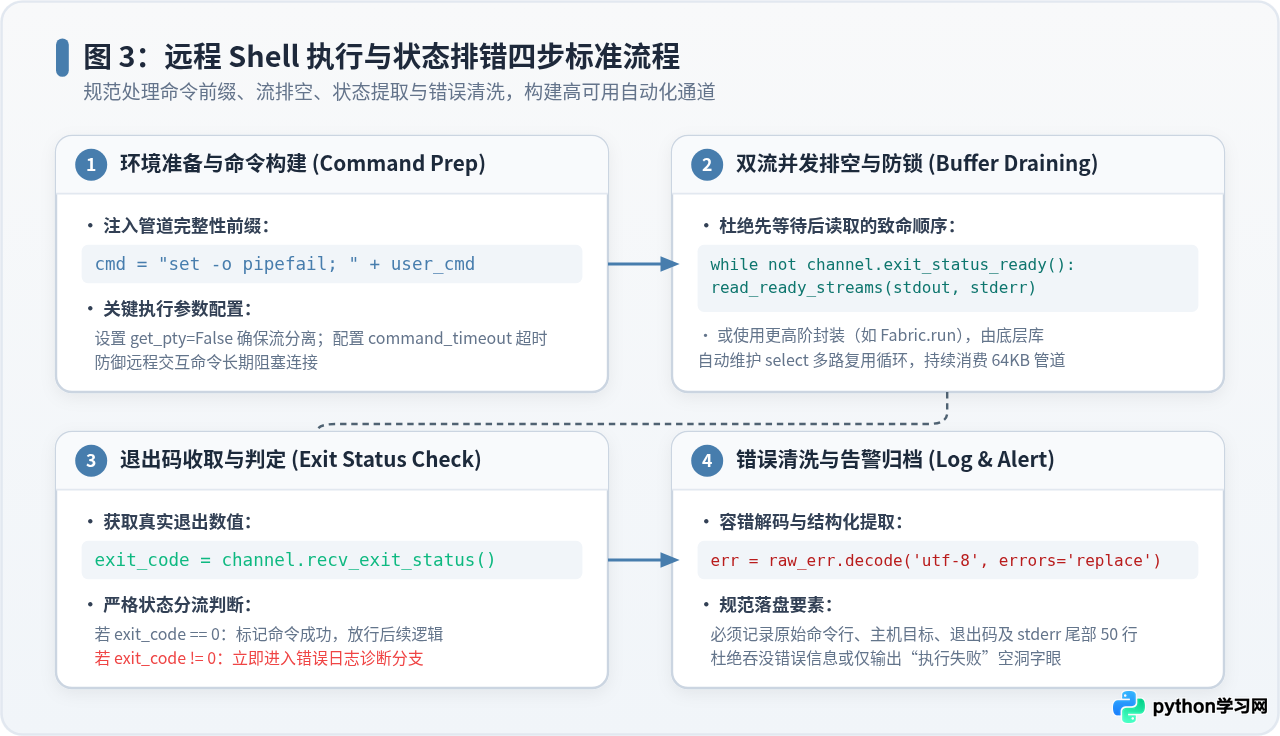
要正确且安全地使用 Paramiko 获取退出码和错误日志,必须:① 保持 get_pty=False;② 在等待退出码的同时或之前,循环抽空 stdout 和 stderr 缓冲区。以下是标准的线程安全封装代码:
import paramiko
import select

def run_remote_command_safe(ssh_client, command, timeout=30):
    """
    安全执行远程 Shell 命令,流式排空双通道,避免死锁并精准获取退出码与错误日志
    """
    # 1. 严格设置 get_pty=False 保障 stderr 分流
    transport = ssh_client.get_transport()
    channel = transport.open_session()
    channel.set_combine_stderr(False)
    channel.settimeout(timeout)
    channel.exec_command(command)

    stdout_chunks = []
    stderr_chunks = []

    # 2. 循环轮询排空缓冲区,杜绝管道溢满死锁
    while True:
        # 监听通道可读事件
        read_ready, _, _ = select.select([channel], [], [], 0.5)
        if read_ready:
            if channel.recv_ready():
                data = channel.recv(4096)
                if data:
                    stdout_chunks.append(data)
            if channel.recv_stderr_ready():
                data = channel.recv_stderr(4096)
                if data:
                    stderr_chunks.append(data)

        # 3. 检查命令是否退出且所有网络缓冲区均已处理完毕
        if channel.exit_status_ready():
            # 彻底收尾残留流
            while channel.recv_ready():
                stdout_chunks.append(channel.recv(4096))
            while channel.recv_stderr_ready():
                stderr_chunks.append(channel.recv_stderr(4096))
            break

    # 4. 提取退出状态码与解码错误日志
    exit_code = channel.recv_exit_status()
    stdout_text = b"".join(stdout_chunks).decode('utf-8', errors='replace')
    stderr_text = b"".join(stderr_chunks).decode('utf-8', errors='replace')
    channel.close()

    return exit_code, stdout_text, stderr_text
三、现代化替代方案:Fabric 与 AsyncSSH 的简洁实践
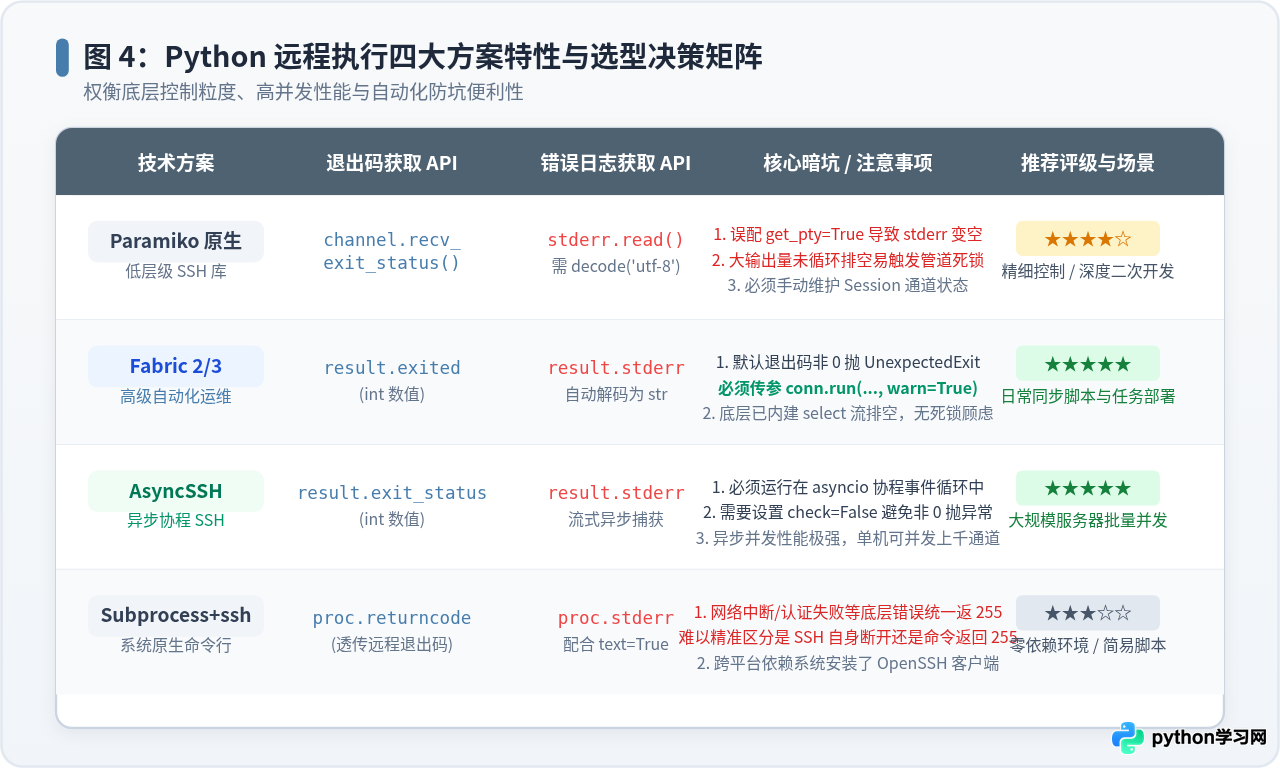
虽然 Paramiko 底层功能强大,但手动处理 select 循环和缓冲区管理的代码较为冗长。在现代 Python 自动化运维体系中,推荐使用经过充分封装的高级库。
方案一:Fabric 2/3(同步脚本与部署任务推荐)
Fabric 是基于 Paramiko 和 Invoke 构建的高层库,它在底层自动封装了异步多路复用与流排空循环,使用起来极为简明。必须注意:Fabric 默认在命令退出码非 0 时会抛出 UnexpectedExit 异常,如果希望由代码自行处理错误分支,必须显式设置 warn=True:
from fabric import Connection

def fabric_exec_demo(host, user, cmd):
    with Connection(host=host, user=user) as c:
        # warn=True 允许命令失败而不中断,pty=False 确保 stderr 不被吞没
        res = c.run(cmd, warn=True, pty=False, hide=True)

        exit_code = res.exited  # 获取退出码 (int)
        stdout_msg = res.stdout  # 标准输出 (str)
        stderr_msg = res.stderr  # 错误日志 (str)

        if exit_code != 0:
            print(f"[ERROR] 执行失败,退出码: {exit_code}")
            print(f"[STDERR 错误详情]:
{stderr_msg}")
        else:
            print(f"[SUCCESS] 执行成功:
{stdout_msg}")
        return exit_code, stderr_msg
方案二:AsyncSSH(大规模高并发运维首选)
如果需要在 Python 中同时管理上百台服务器,同步的 Paramiko/Fabric 会占用大量系统线程。AsyncSSH 深度集成了 Python asyncio 协程框架,具备极高的并发性能:
import asyncio
import asyncssh

async def asyncssh_exec_demo(host, cmd):
    async with asyncssh.connect(host, username='deploy') as conn:
        # check=False 避免非 0 退出码引发 ProcessError 异常
        result = await conn.run(cmd, check=False)

        exit_code = result.exit_status  # 退出码
        err_msg = result.stderr         # 错误日志字符串
        out_msg = result.stdout         # 标准输出

        return exit_code, err_msg
方案三:Subprocess 调用系统 OpenSSH(零外部依赖)
在某些受限环境中无法安装第三方 pip 模块,可以直接利用 Python 内置的 subprocess 调用本机的 ssh 客户端命令:
import subprocess

def system_ssh_exec(host, cmd):
    proc = subprocess.run(
        ["ssh", "-o", "BatchMode=yes", "-o", "ConnectTimeout=10", host, cmd],
        capture_output=True,
        text=True
    )
    exit_code = proc.returncode
    err_log = proc.stderr

    # 注意:ssh 命令遇到网络/认证失败时固定返回 255
    if exit_code == 255:
        print(f"[SSH 连接/认证异常]: {err_log}")
    elif exit_code != 0:
        print(f"[远程命令报错 退出码 {exit_code}]: {err_log}")
return exit_code, err_logset -o pipefail在执行诸如
cat /not_exist | grep "pattern" | awk '{print $1}' 这类复合管道命令时,Linux 默认的退出码只取决于管道中最后一个命令(awk)!即使前置命令 cat 严重报错,只要 awk 正常退出了,最终返回值依然是 0,导致 Python 误判任务成功。解决规范:在传入任何复合命令前,主动在命令字符串开头注入
set -o pipefail; (例如 cmd = "set -o pipefail; " + user_command),确保管道链路中任何一个指令失败都能向后传递报错状态码。
四、生产环境规范与方案选型矩阵
在实际生产系统中,除了捕获退出码与日志之外,还必须引入防御性编程规范:
- 字符集容错解码:远程服务器可能包含非 UTF-8 编码的特殊字符或二进制输出,解码时务必使用
errors='replace'或errors='backslashreplace',坚决杜绝因UnicodeDecodeError导致诊断逻辑崩溃。 - 错误截断与日志归档:异常时若错误日志超过数千行,盲目全量打印可能会打爆监控日志存储。应截取最后 50~100 行关键堆栈(
stderr.splitlines()[-50:]),并保留关联的主机 IP、原始命令及耗时。 - 远程超时保护机制:务必配置
timeout或通道超时时间。若远程进程误入交互等待或死循环,未设超时的连接将永久占用连接池资源。
总结检查清单
| 排查项目 | 规范标准 | 常见错误表现 |
|---|---|---|
| 伪终端开关 | 抓取错误日志时必须保持 get_pty=False |
stderr.read() 为空,错误混入 stdout |
| 管道缓冲区 | 必须循环流式排空或使用 Fabric 封装 | 输出量大(>64KB)时脚本无响应死锁 |
| 退出码检查点 | 读取退出码前确保流已排空完毕 | 提前调用 recv_exit_status() 引发互锁 |
| 复合命令管道 | 在执行命令前追加 set -o pipefail; |
前面指令报错但最终退出码仍为 0 |
| 字符集解码 | 始终传入 errors='replace' |
远程二进制杂质导致 Python 崩溃 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















