


Python装饰器本质:高阶函数与闭包的理论应用
深入剖析Python装饰器的底层本质,从一等公民函数、高阶函数代数重写到词法作用域闭包与堆内存cell对象,结合生命周期推导与带参工厂完整掌握装饰器的理论与工程应用。
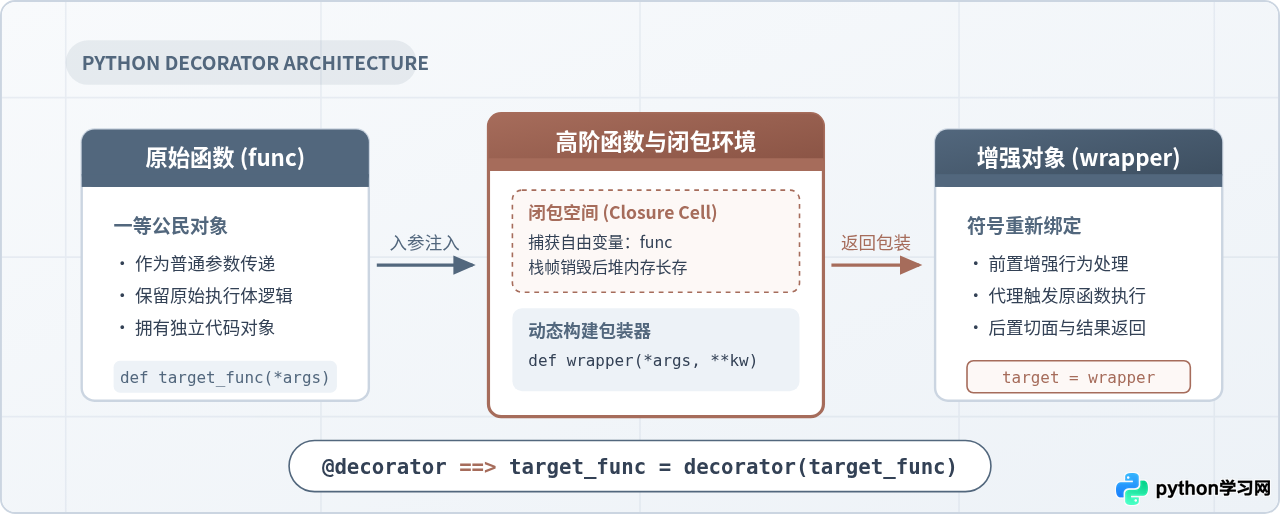
@decorator 语法糖,但在 Python 虚拟机的执行语义中,它并不是一种独立存在的控制结构。它的核心本质非常单纯:“高阶函数(Higher-Order Function)”与“词法闭包(Lexical Closure)”在语法糖层面的代数组合。这一机制的核心代数展开式即为 target = decorator(target)。本文将从函数一等公民的内存模型出发,彻底拆解装饰器的两层理论支柱,展示闭包底层如何利用堆中的 cell 对象逃逸栈帧销毁,并推导装饰器在编译装配与运行执行两个阶段的完整生命周期。
一、基石之一:一等公民函数与高阶函数的代数转换
理解装饰器的第一步,是破除对“函数是特殊控制流程”的陈旧认识。在 Python 中,一切皆为对象,函数被设计为一等公民(First-Class Citizens)。这意味着函数实体与整数、字符串、列表具有完全平等的运行时地位:它们拥有明确的内存地址(id)、类型(<class 'function'>),可以被作为实参传递给另一个函数,也可以作为一个计算结果被 return 返回。
只要一个函数满足“接收一个或多个函数作为参数”或者“返回一个函数作为结果”,在计算理论中它就被称为高阶函数(Higher-Order Function)。装饰器正是严格满足这两项条件的高阶函数典型代表。
# 示例代码:脱离 @ 语法糖,观察高阶函数的原生运作
def raw_logger(func):
    """高阶函数:接收函数对象,打印后原样返回或返回包装"""
    print(f"[定义装配时刻] 成功接收函数对象: {func.__name__}, 内存地址: {hex(id(func))}")
    return func

def add(x, y):
    return x + y

# 显式传递与赋值
add = raw_logger(add)
print(f"[调用时刻] 执行结果: {add(3, 5)}")
输出示例:
[定义装配时刻] 成功接收函数对象: add, 内存地址: 0x7f8e30b0
[调用时刻] 执行结果: 8
上面的示例证明了:高阶函数具备拦截并接管另一个函数引用的能力。当我们在函数定义上方书写 @my_decorator 时,Python 解释器在编译完成该函数对象后,会在当前作用域立刻执行一次赋值操作:func_name = my_decorator(func_name)。此时,变量标识符被重新绑定到了高阶函数的返回结果上。
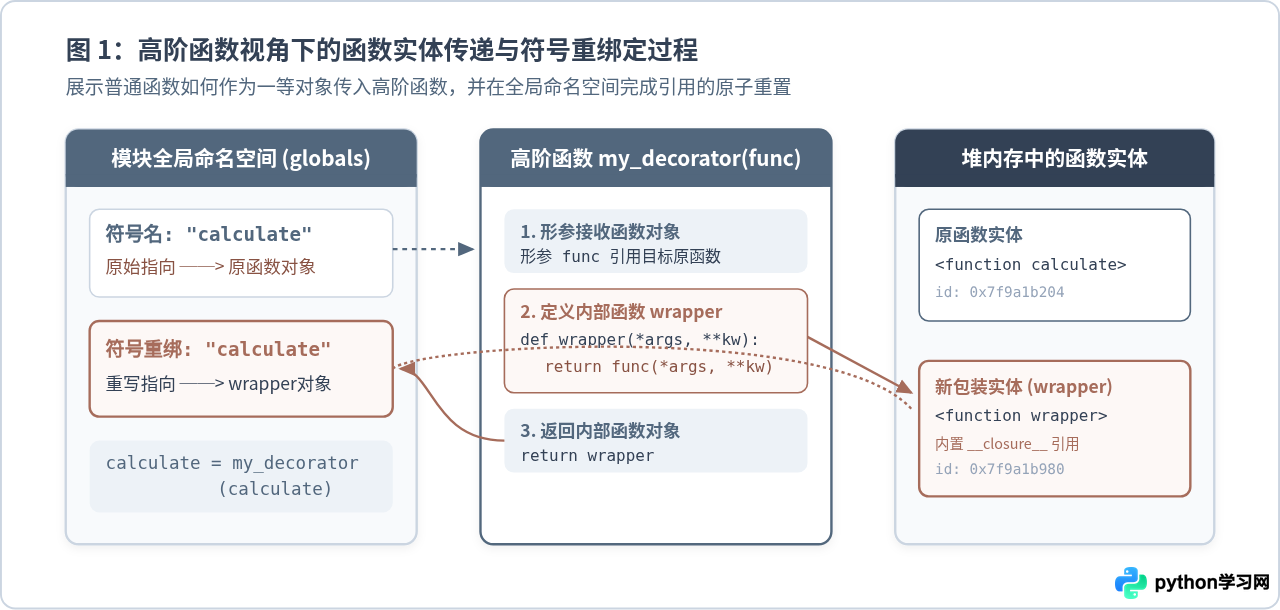
二、基石之二:词法作用域与堆内存 Cell 对象的闭包机制
仅有高阶函数尚不足以实现功能增强。如果高阶函数仅仅接收原函数并直接返回它,函数体内的行为无法被动态拦截;如果高阶函数直接执行逻辑并返回一个全新的普通函数,那么新函数在被调用时将无法找到最初被装饰的原函数。这就引出了装饰器的第二根核心支柱:词法闭包(Closure)。
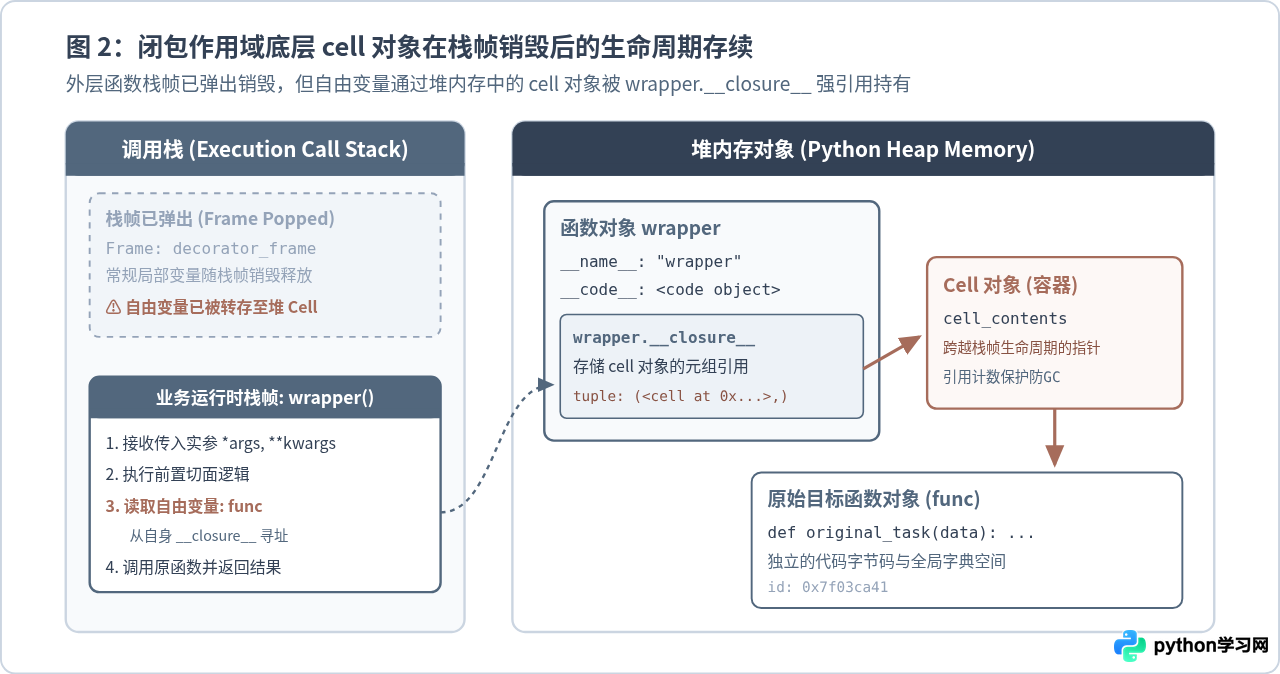
根据传统的过程式调用栈模型,当一个函数(例如外层的 decorator)执行完毕并返回时,其在调用栈中的栈帧(Stack Frame)会立即被弹出并销毁,栈内分配的局部变量也将随之释放。然而在闭包模式下,内部函数 wrapper 引用了外部函数作用域中的变量 func(在内部函数视角中,func 被称为自由变量 / Free Variable)。
为了解决“外层栈帧已死,内层未来还要访问自由变量”的生命周期冲突,Python 编译器在语法分析期会侦测出自由变量,并在堆内存中为其开辟一个专门的 cell 对象。外层函数将该变量存储到 cell 中,随后内部函数对象的 __closure__ 属性会绑定一个包含该 cell 引用的元组。因此,即使外层函数早已退出,原函数的引用依然在堆中存活。
# 深入探查闭包底层的 __closure__ 与 cell 对象
def trace_decorator(func):
    def wrapper(*args, **kwargs):
        return func(*args, **kwargs)
    return wrapper

def compute(x):
    return x * 2

# 完成装饰与符号重绑
compute = trace_decorator(compute)

# 探测 wrapper 对象的闭包属性
print("wrapper 的闭包属性元组:", compute.__closure__)
cell_obj = compute.__closure__[0]
print("cell 对象类型:", type(cell_obj))
print("cell 中保存的内容:", cell_obj.cell_contents)
print("是否严格指向原函数:", cell_obj.cell_contents.__name__ == "compute")
输出示例:
wrapper 的闭包属性元组: (<cell at 0x7f9a10204d90: function object at 0x7f9a102031f0>,)
cell 对象类型: <class 'cell'>
cell 中保存的内容: <function compute at 0x7f9a102031f0>
是否严格指向原函数: True如果一个嵌套函数内部没有引用任何外部作用域的局部变量,Python 不会为其创建闭包,该函数的 __closure__ 属性将为 None。装饰器之所以能在运行时准确调用原始逻辑,全靠 __closure__ 中的 cell 容器在堆内存中提供了跨越生命周期的长期锚定。
三、运行期推导:装配时刻与执行时刻的双阶段生命周期
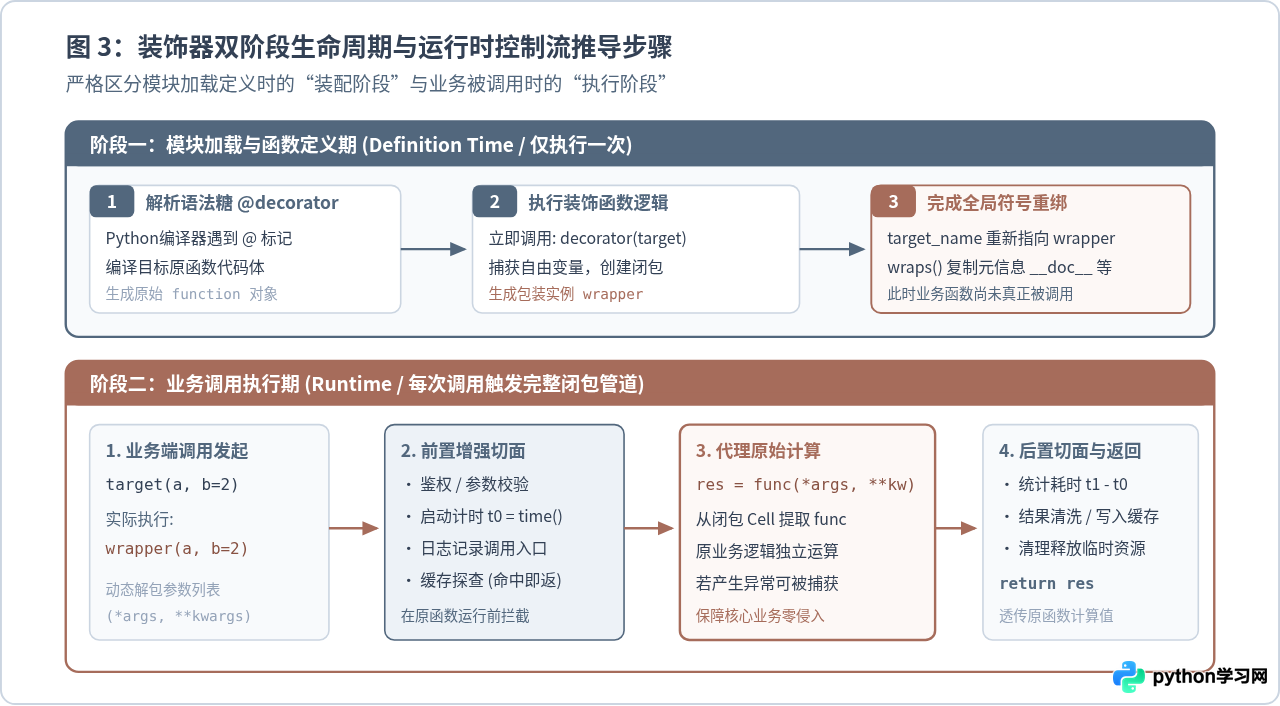
在工程开发中,对装饰器最常见的误解之一是“每次调用被修饰的函数时,装饰器都会被重新执行一遍”。通过前述的高阶函数与闭包模型,我们可以清晰地推导出装饰器的双阶段执行生命周期:
- 阶段一:定义/装配时刻(Definition / Import Time):当 Python 模块被解释器载入、或执行到
def语句块时,@decorator立即被求值。外层装饰器函数被调用,原函数作为实参传入,内部wrapper闭包被创建,全局符号表完成重写。这个阶段只发生一次。 - 阶段二:业务调用时刻(Runtime Execution Time):在后续业务代码中每一次调用
target_func(...),实际上都在直接执行已缓存的wrapper(...)。它从闭包cell提取原函数,完成前置拦截、执行原计算并返回结果。这个阶段会根据业务调用频次执行任意多次。
通用参数透传与元信息保护
编写高质量工业级装饰器时,必须保证被装饰函数在签名和调用契约上的完全透明。这包含两个必不可少的要素:
- 参数与返回值透明透传:
wrapper(*args, **kwargs)必须完整捕获所有位置参数与关键字参数,并将其原封不动地解包传递给func(*args, **kwargs),同时必须将原函数的返回值显式return出去,不可因为编写切面逻辑而造成返回值丢失。 - 元信息伪装(
functools.wraps):由于函数名已经被重绑定为wrapper,默认情况下原函数的__name__、__doc__以及类型注解__annotations__都会被覆盖为wrapper,这会导致反射、日志框架以及 Sphinx/IDE 自动文档提取失效。functools.wraps本身也是一个装饰器,其底层通过遍历复制属性字典,将原始函数的标识信息完整同步回wrapper。
import functools
import time

def execution_timer(func):
    """标准的工业级通用计时装饰器"""
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        start_time = time.perf_counter()
        # 1. 代理调用原函数并捕获结果
        result = func(*args, **kwargs)
        duration = time.perf_counter() - start_time
        print(f"[METRIC] 函数 {func.__name__} 执行耗时: {duration:.6f}s")
        # 2. 保证返回值透明透传
        return result
    return wrapper

@execution_timer
def fetch_user_data(user_id: int):
    """根据用户ID查询资料"""
    time.sleep(0.05)
    return {"user_id": user_id, "status": "active"}

# 验证元信息保留
print("函数名:", fetch_user_data.__name__)
print("文档字符串:", fetch_user_data.__doc__)
data = fetch_user_data(1001)
输出示例:
函数名: fetch_user_data
文档字符串: 根据用户ID查询资料
[METRIC] 函数 fetch_user_data 执行耗时: 0.051203s
四、理论进阶:带参装饰器工厂与闭包状态维护
掌握了双层嵌套的标准装饰器后,面对需要接收自定义参数的场景(例如指定重试次数 @retry(max_attempts=3)),很多初学者会对“三层嵌套函数”感到困惑。只要用代数展开式推导,其本质一目了然:
带参装饰器并不是装饰器本身,而是一个装饰器工厂(Decorator Factory)。根据 Python 语法规则:
@retry_factory(max_attempts=3)
def request_api():
    pass

# 等价于分步代数调用:
# 步骤 1:先执行工厂函数,传入配置参数,返回一个纯粹的单参装饰器
# real_decorator = retry_factory(max_attempts=3)
# 步骤 2:再把原函数传入这个单参装饰器中
# request_api = real_decorator(request_api)在内存中,这形成了两层闭包嵌套:最外层工厂捕获配置参数 max_attempts 并存入第一个 cell;中层装饰器捕获目标函数 func 并存入第二个 cell;最内层的 wrapper 则同时享有对这两个自由变量的访问权。
# 三层嵌套带参装饰器实现
def retry_factory(max_attempts=3):
    """第一层:装饰器工厂,接收配置参数"""
    def actual_decorator(func):
        """第二层:纯粹的高阶函数,接收被装饰函数"""
        @functools.wraps(func)
        def wrapper(*args, **kwargs):
            """第三层:运行时的代理执行体"""
            attempts = 0
            while attempts < max_attempts:
                try:
                    return func(*args, **kwargs)
                except Exception as err:
                    attempts += 1
                    print(f"执行失败 ({attempts}/{max_attempts}): {err}")
                    if attempts >= max_attempts:
                        raise
        return wrapper
    return actual_decorator
利用 nonlocal 在闭包中保持持久状态
普通局部变量在函数调用结束后就销毁,而全局变量又会污染命名空间。闭包为函数提供了一个独立的私有持久化状态空间。通过结合 nonlocal 关键字,装饰器可以在内存中维护调用计数、限流窗口或本地缓存,而无需依赖全局变量或类属性。
def call_counter(func):
    """利用闭包变量实现无副作用的私有计数器"""
    count = 0  # 自由变量:持久化保存在 cell 中

    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        nonlocal count
        count += 1
        print(f"[AUDIT] {func.__name__} 已累计被调用 {count} 次")
        return func(*args, **kwargs)
    return wrapper

@call_counter
def process_order(order_id):
    return f"Order {order_id} processed."

process_order(101)
process_order(102)
输出示例:
[AUDIT] process_order 已累计被调用 1 次
[AUDIT] process_order 已累计被调用 2 次
五、总结:装饰器技术选型与全景矩阵
通过以上的推导与验证,我们可以将 Python 装饰器的各种形式与其背后的理论机制系统性地归纳为下表与选型图:
| 实现形式 | 嵌套深度 | 闭包依赖机制 | 典型应用场景 | 核心设计注意事项 |
|---|---|---|---|---|
| 标准无参函数装饰器 | 2 层函数嵌套 | 单 Cell 闭包:捕获原函数 func |
日志记录、耗时度量、静态权限拦截 | 必须显式返回执行结果并附加 @wraps |
| 带参装饰器工厂 | 3 层函数嵌套 | 双重 Cell 闭包:分别持有配置参数与 func |
动态重试 @retry(n)、频率限制、角色鉴权 |
明确区分工厂调用时刻与函数装配时刻 |
| 基于闭包的状态装饰器 | 2 层函数嵌套 | Cell 变量 + nonlocal 关键字修改 |
私有调用计数、轻量级本地结果缓存 (Memoization) | 注意多线程并发场景下的变量竞态安全 |
基于类的装饰器 (__call__) |
1 个 Class 定义 | 利用实例属性 self.attr 代替词法闭包 |
需要向外部暴露管理方法(如清理缓存、状态重置) | 用于类的方法装饰时需谨慎处理 self 绑定 |
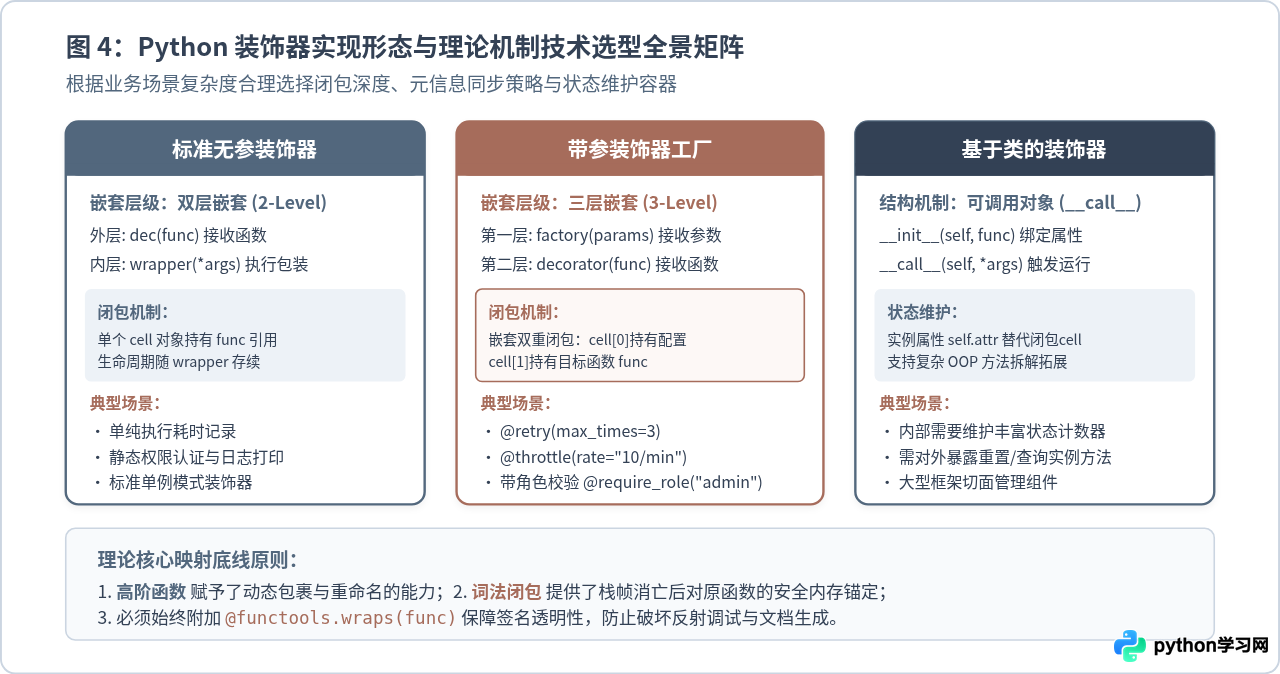
总而言之,Python 装饰器并不是凭空产生的复杂概念,而是语言设计者将“函数作为第一类对象”与“词法作用域闭包”两项经典计算机科学理论,通过简洁的 @ 语法进行的一场工程实践化融合。理解了高阶函数负责引用的接管与重置、闭包 cell 负责堆内存中环境上下文的存续,任何复杂的装饰器结构都可以通过基础的代数展开式完成解构与掌控。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















