


Python装饰器实战:实现日志记录与性能计时
深入浅出讲解Python装饰器的底层工作原理,完整手把手实现通用的日志记录与性能计时装饰器,并解析多层装饰器堆叠与异常处理规范。
在Python工程开发中,为函数添加调用日志和执行耗时统计是最常见的通用需求。直接在每个业务函数内部插入时间戳计算或打印语句,不仅会导致样板代码泛滥,还会严重污染核心业务逻辑。Python装饰器提供了一种优雅的非侵入式解决方案,通过函数式包装让关注点分离落到实处。本文将直入核心,解析装饰器的运作本质,并手把手构建健壮的性能计时与日志记录装饰器。
一、装饰器的核心机制与包装模型
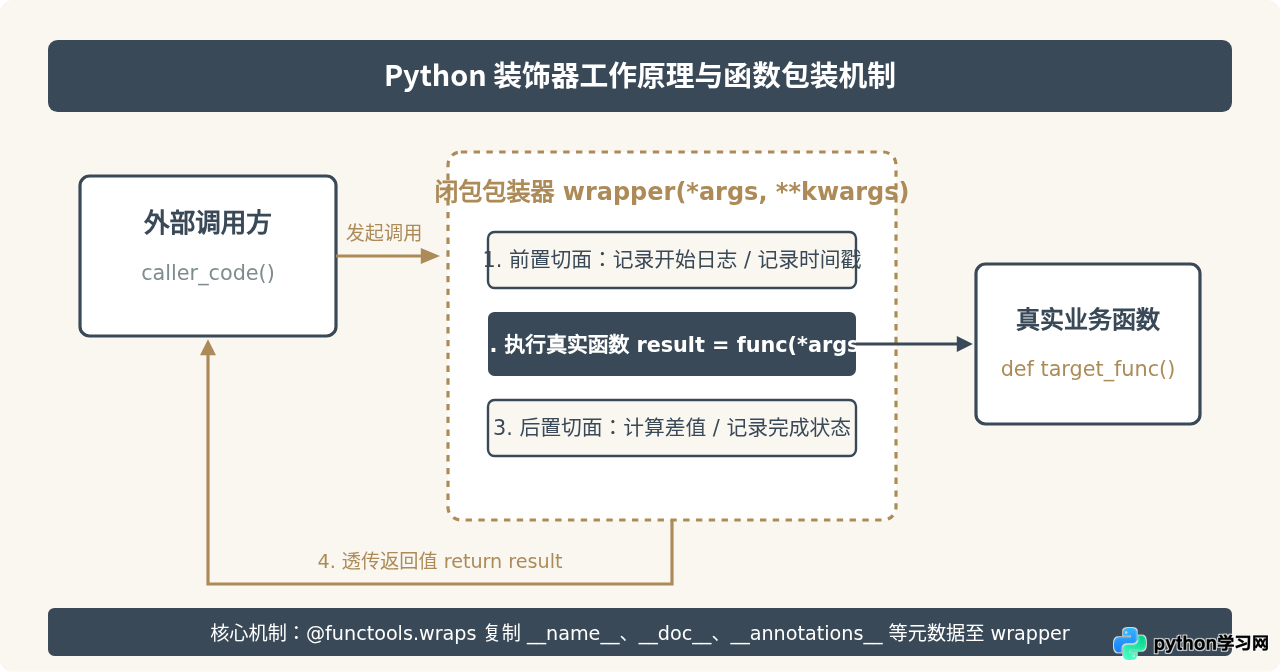
Python中的函数是第一类对象(First-Class Object),这意味着函数可以作为参数传递给其他函数,也可以作为其他函数的返回值。装饰器本质上就是一个高阶函数,它接收一个目标函数作为输入,并返回一个替换后的包装函数。
当我们在函数定义上方编写 @decorator_name 语法糖时,解释器实际执行的操作是 func = decorator_name(func)。此后所有针对该函数的调用,都会首先重定向到装饰器内部生成的包装函数上,从而让我们能够在目标函数执行前后注入自定义操作。
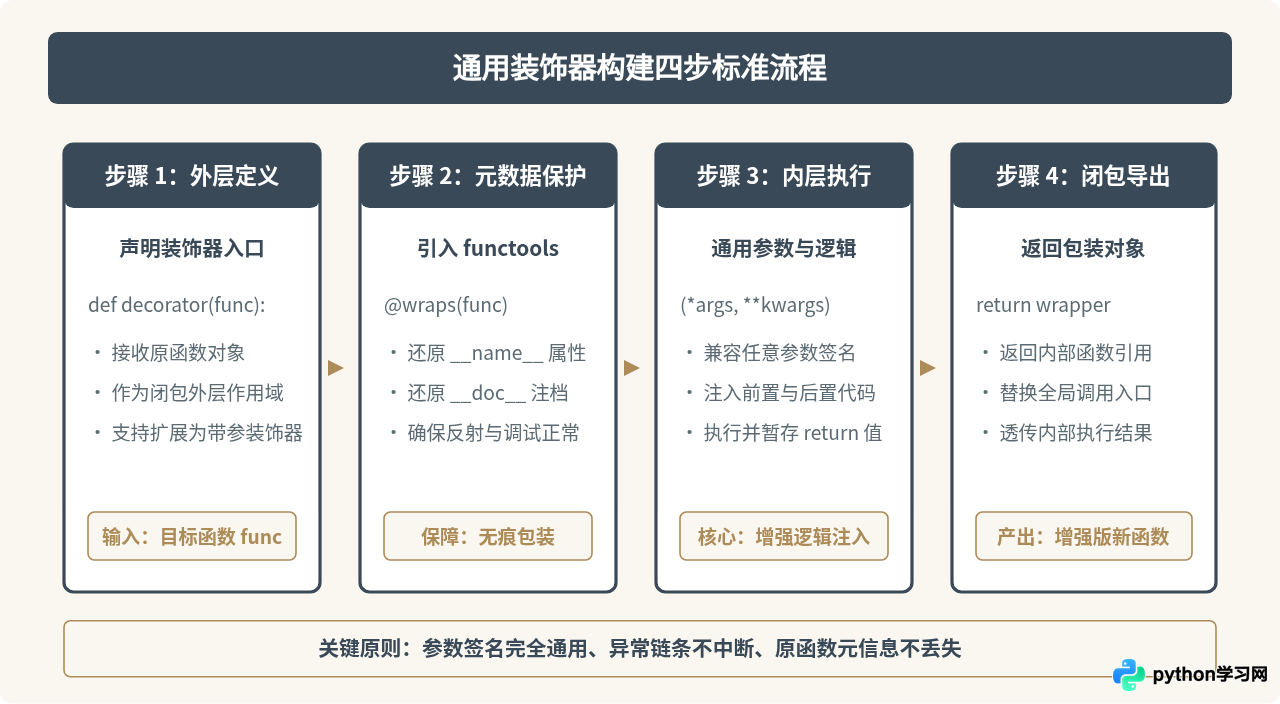
二、标准装饰器的四步构建法
编写一个工业级可用的通用装饰器,必须遵循清晰的标准流程。很多初学者编写的装饰器往往存在元数据丢失、无法接收变长参数或捕获异常时状态不一致的问题。标准的装饰器构建应严格遵循以下四个步骤:
三、实战一:实现高精度性能计时装饰器
性能分析时,我们需要精确统计函数的运行耗时。在测量系统时钟时,不应使用受系统时钟校准影响的 time.time(),而应优先选择单调时钟 time.perf_counter(),以避免系统时间调整带来的测量偏差。
1. 计时装饰器完整代码
以下是具备异常安全性的性能计时装饰器实现:
import time
from functools import wraps

def time_tracker(func):
    """
    高精度性能计时装饰器
    统计目标函数运行时间,并在函数执行完毕后打印耗时
    """
    @wraps(func)
    def wrapper(*args, **kwargs):
        start_time = time.perf_counter()
        try:
            # 执行目标函数并捕获返回值
            result = func(*args, **kwargs)
            return result
        finally:
            # 无论函数正常结束还是抛出异常,耗时统计均能完整执行
            elapsed_time = time.perf_counter() - start_time
            print(f"[性能统计] 函数 '{func.__name__}' 执行耗时: {elapsed_time:.6f} 秒")

    return wrapper
2. 代码要点剖析
time.perf_counter():专门用于计算时间差的单调递增时钟,分辨率极高且不受夏令时或网络对时影响。try...finally结构:将耗时计算放入finally块中至关重要。如果业务代码抛出未捕获的异常,finally仍会触发,确保能拿到故障前的耗时数据,而不会掩盖异常传播。- 返回值透明传递:内层
wrapper必须将func的返回值赋给result并在退出前显式返回,否则外部调用者将拿到默认的None。
四、实战二:实现结构化日志记录装饰器
在排查生产问题时,掌握函数的调用入参、调用结果以及异常堆栈是关键。日志装饰器不仅要输出入参摘要,还要在函数发生异常时详细告警。
1. 日志记录装饰器完整代码
import logging
from functools import wraps

# 配置基础日志格式(示例)
logging.basicConfig(
    level=logging.INFO,
    format="%(asctime)s [%(levelname)s] %(message)s"
)
logger = logging.getLogger("AppLogger")

def log_execution(func):
    """
    业务调用日志记录装饰器
    自动记录函数进入、参数详情、返回结果及异常状态
    """
    @wraps(func)
    def wrapper(*args, **kwargs):
        # 格式化入参信息(注意过滤或脱敏敏感字段)
        arg_str = ", ".join([repr(a) for a in args])
        kwarg_str = ", ".join([f"{k}={v!r}" for k, v in kwargs.items()])
        full_params = ", ".join(filter(None, [arg_str, kwarg_str]))

        logger.info(f">>> 调用函数 [{func.__name__}] | 参数: ({full_params})")

        try:
            result = func(*args, **kwargs)
            logger.info(f"<<< 完成函数 [{func.__name__}] | 返回值: {result!r}")
            return result
        except Exception as e:
            logger.error(f"!!! 异常抛出 [{func.__name__}] | 错误类型: {type(e).__name__} | 详情: {e}")
            raise  # 重新抛出原异常,保证上层调用方的错误处理逻辑不被破坏

    return wrapper
2. 运行示例与输出验证
@log_execution
def calculate_discount(price: float, discount_rate: float) -> float:
    if not 0 < discount_rate <= 1:
        raise ValueError("折扣率必须在 (0, 1] 范围内")
    return round(price * discount_rate, 2)

# 正常调用
calculate_discount(199.0, 0.85)

# 异常调用
try:
    calculate_discount(100.0, -0.2)
except ValueError:
    pass
运行上述测试代码后,控制台将输出如下格式的标准化日志输出:
2026-10-28 03:40:00 [INFO] >>> 调用函数 [calculate_discount] | 参数: (199.0, 0.85)
2026-10-28 03:40:00 [INFO] <<< 完成函数 [calculate_discount] | 返回值: 169.15
2026-10-28 03:40:00 [INFO] >>> 调用函数 [calculate_discount] | 参数: (100.0, -0.2)
2026-10-28 03:40:00 [ERROR] !!! 异常抛出 [calculate_discount] | 错误类型: ValueError | 详情: 折扣率必须在 (0, 1] 范围内
五、高级技巧:多层装饰器堆叠与执行时序
在真实业务中,我们经常需要同时为某一个函数启用日志记录和性能耗时统计。Python支持在同一函数上堆叠多个装饰器:
@log_execution
@time_tracker
def fetch_user_orders(user_id: int):
    time.sleep(0.1)  # 模拟数据库查询
return [{"order_id": 1001, "amount": 258.0}]多层装饰器的执行顺序遵循“自下而上装配,自外向内执行”的洋葱模型机制:
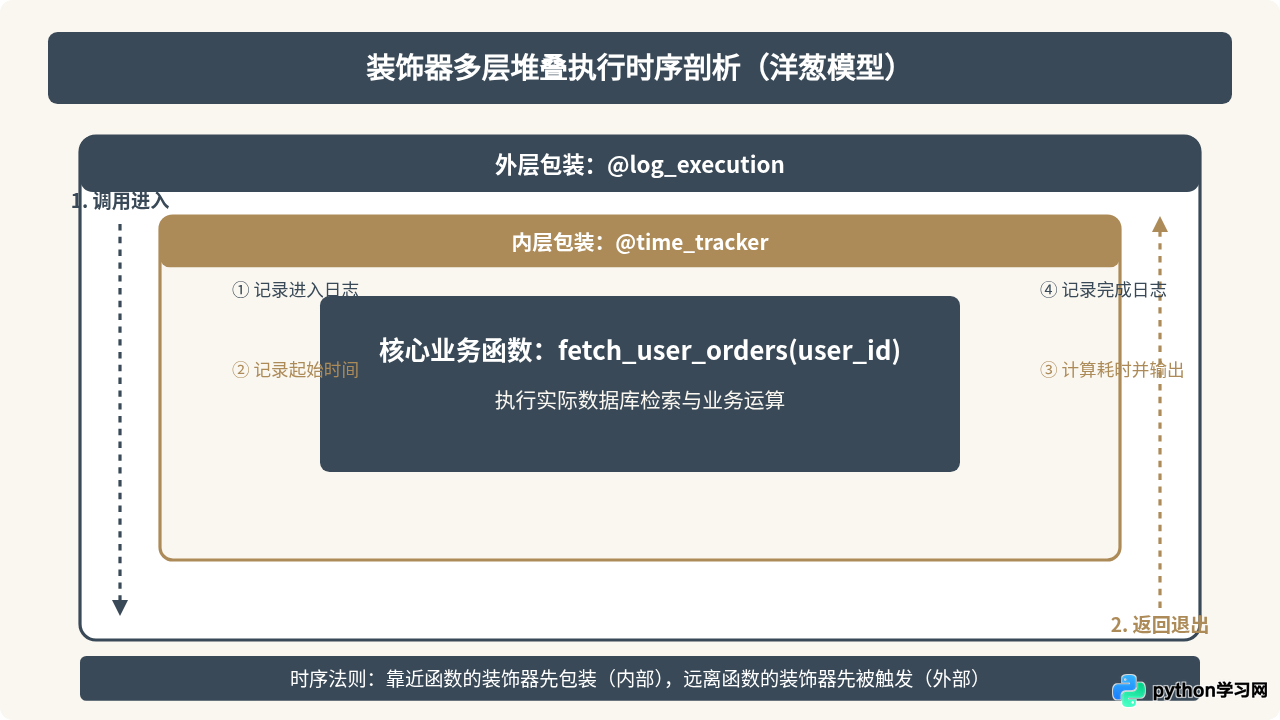
由时序图可见,当 @log_execution 位于最外层时,前置日志最先被记录;随后进入 @time_tracker 开始计时;业务函数执行完毕后,先由计时装饰器输出耗时,最后由外层日志装饰器输出完成状态。这种结构符合工程直觉,即外层日志能完整观测到包含子装饰器在内的全链路。
六、生产环境避坑指南与总结
在日常生产代码中使用装饰器,需特别留意以下四项易发缺陷与防护规范:
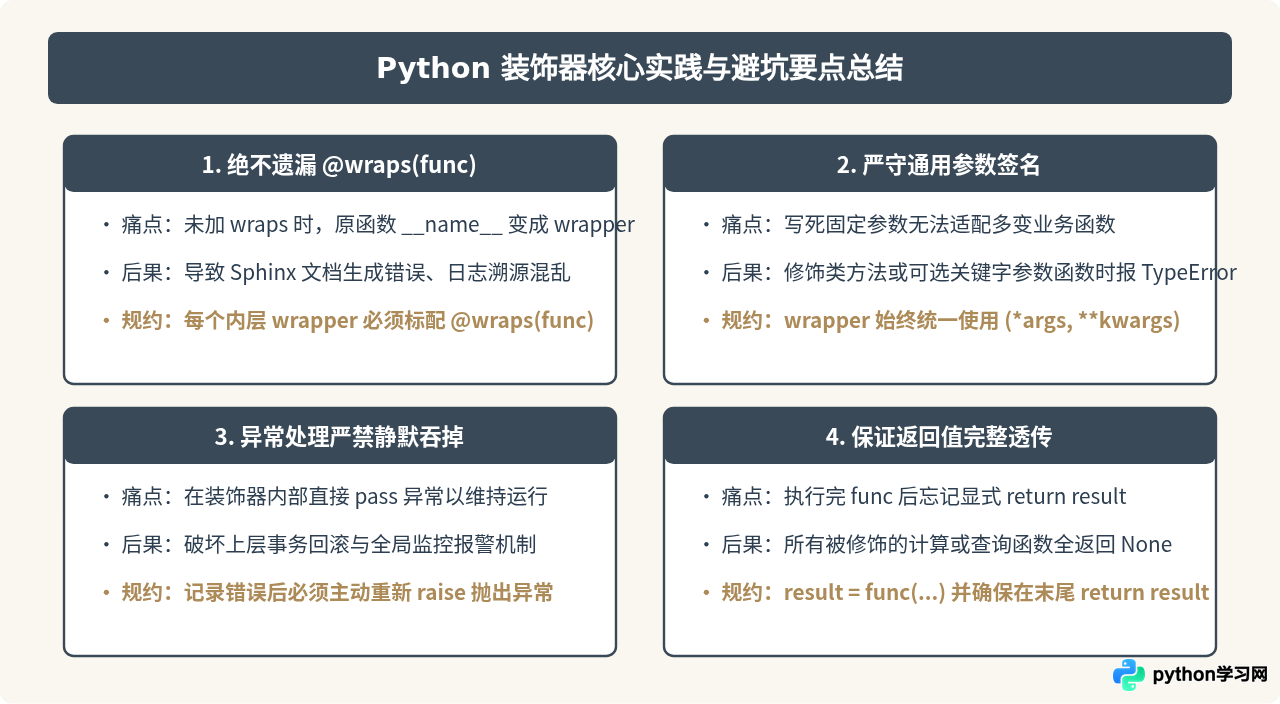
综上所述,Python装饰器是实现面向切面编程(AOP)的核心利器。通过将日志记录与性能计时逻辑抽离为独立装饰器,不仅提升了系统可观测性,也让核心业务代码保持高度聚焦与整洁。在编写装饰器时,时刻牢记使用 @functools.wraps 维持原函数元数据、统一采用 *args, **kwargs 签名兼容各类函数,并通过 try...finally 确保异常时生命周期的完整性,就能写出稳健、高效的高质量工业级代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















