


AI数字人是什么?2D真人克隆与3D虚拟偶像的区别
本文解析AI数字人的核心概念,区分2D真人克隆与3D虚拟角色的技术差异与应用场景。通过交付物形态、制作逻辑及交互能力的对比,帮助读者根据讲解视频或角色运营的实际需求,选择合适的技术路线,避免被营销术语误导。
刷到一个会说话的虚拟主播,很多人的第一反应是:这是真人录好了,还是电脑实时生成的?再看一个能跳舞、能换装的虚拟角色,又容易把它们当成同一种产品。
先看交付物,比先问“用了什么AI”更容易弄明白。屏幕里一段像真人的讲解视频,和能在三维场景里运动的角色资产,制作方式与后续用途有明显差别。AI数字人是一个宽泛称呼,不代表每个角色都能自主理解问题,也不代表它背后没有真人参与。
看着像真人,不等于把整个人复制进电脑
日常所说的2D真人克隆,通常指以真人照片或视频为外观依据,生成面向屏幕的说话影像。这里的“2D”主要描述交付和使用方式,并不能据此断言服务内部完全没有三维技术。它复制的是某些外观与表现特征,不是人的记忆、判断或完整人格。
这类方案常用于固定构图的讲解、培训和通知。以Synthesia的个人形象功能为例,官方资料列有照片或视频建形象的路径,并要求相应的本人授权确认。具体要准备什么素材,应按实际创建流程核对,不能拿任意一张别人的照片就视为可用。
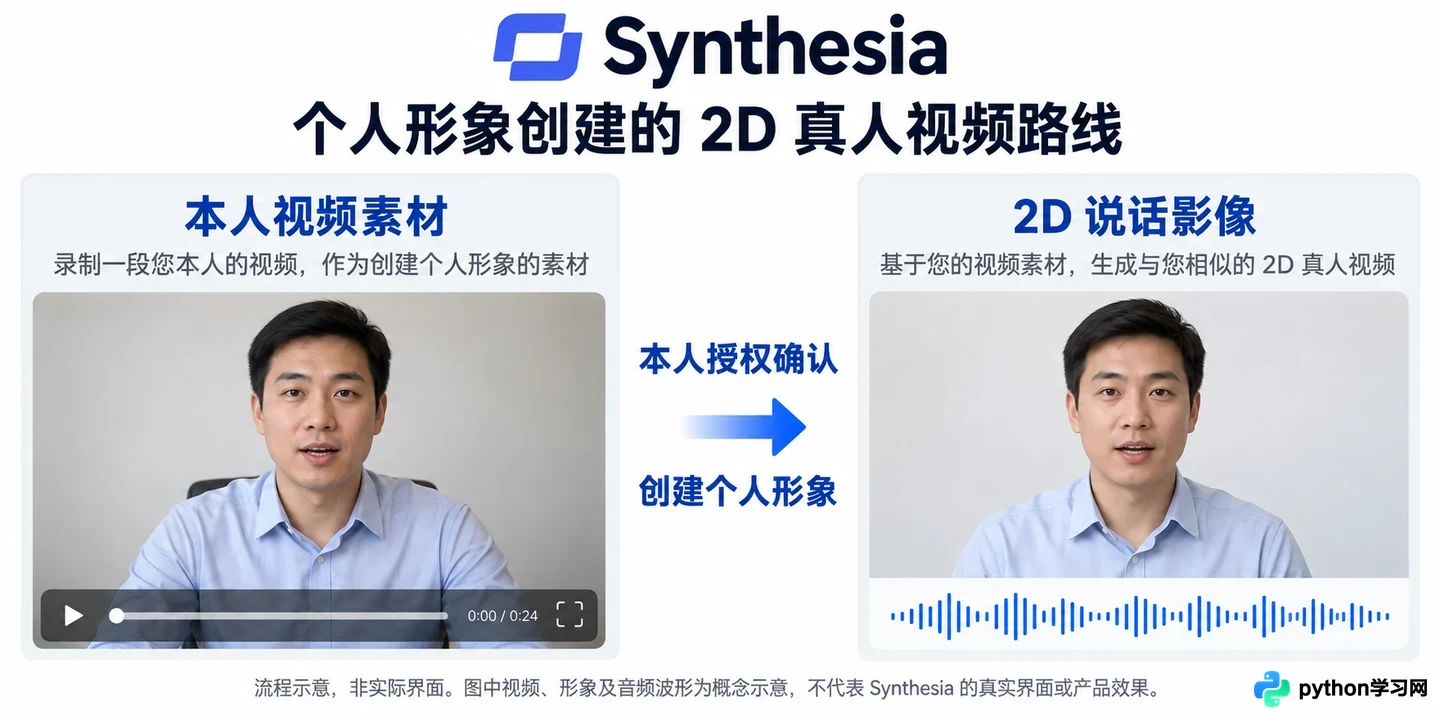
Synthesia个人形象创建界面,展示基于真人视频素材生成2D数字人的流程
判断是否合适,可以先看一段包含专有名词和自然停顿的短稿:声音是否清楚,口型与语音是否协调,表情是否符合内容。看起来像某个人,不代表每句话都像他本人会说的。更换姿态、衣服或拍摄角度的能力,也要逐项确认,不能从一个正面口播样片推导出来。
能转身和换机位,靠的是三维角色结构
3D数字人通常有三维模型、材质以及让角色运动的控制结构。可以把模型理解成外形,把绑定与控制结构理解成让它摆出动作的骨架和关节;实际制作还涉及灯光、动画和渲染。最终播放出来仍可能是一段普通视频,但背后保留的角色资产能服务更多视角与场景。
Epic的MetaHuman就是可创建和驱动三维数字人角色的框架。官方介绍包含绑定角色,以及由视频、音频或关键帧等方式驱动表现的能力。这说明三维路线可以承接多种动画来源,并不意味着每个项目都能一键完成。
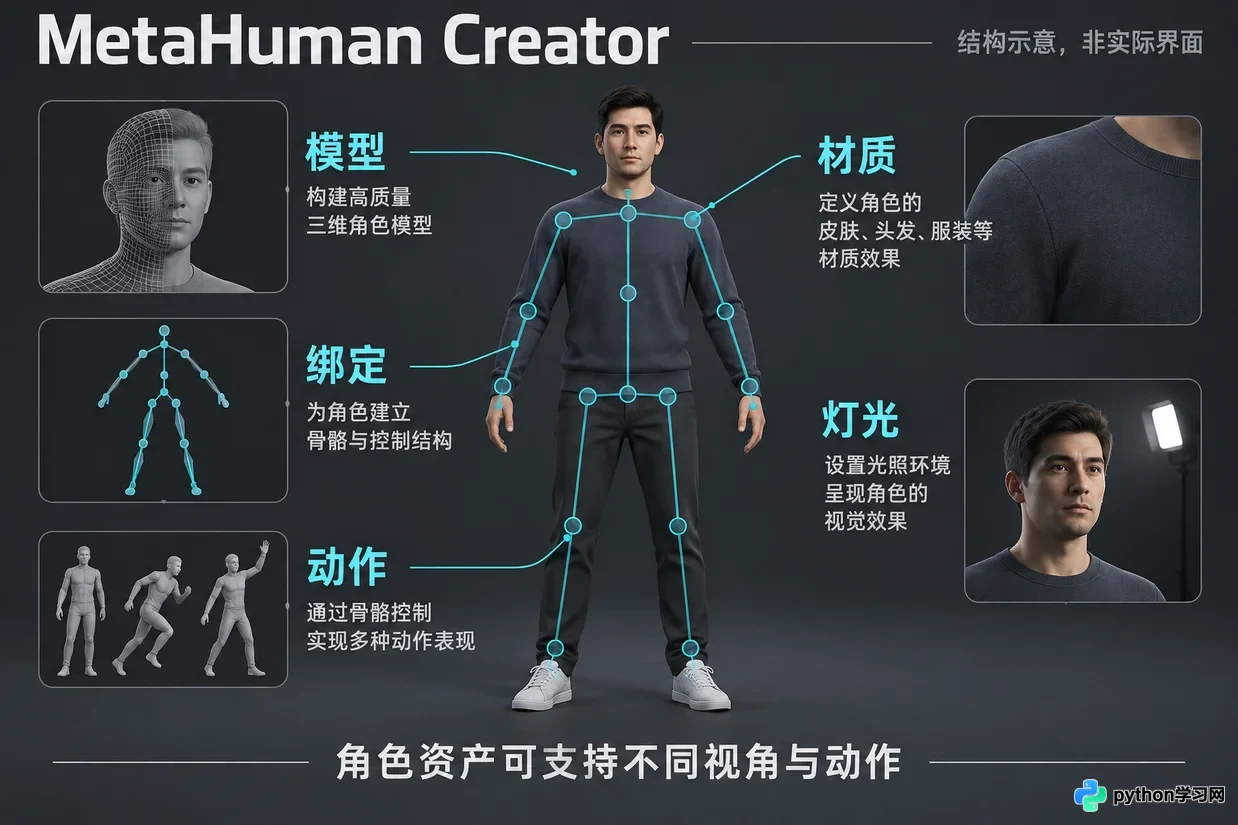
MetaHuman Creator界面,展示3D数字人的模型结构与骨骼绑定细节
虚拟偶像需要跳舞、走动、与场景发生关系时,这种可控制的空间结构很有用。但“3D”不等于卡通,“2D”也不等于写实:三维角色可以高度写实,屏幕形象也可以风格化。虚拟偶像是角色定位,三维是表现方式,两者不能画等号。
会说话、会回答、实时互动,是三件事
最容易误会的地方,是看到数字人在讲话,就认为它能像客服一样处理追问。按文稿生成视频,只解决表达;能够回答问题,还需要对话或知识系统;能够实时互动,还要看输入、生成与播放能否及时衔接。
真人克隆和三维角色都可能接入对话能力,也都可能只是播放提前做好的内容。采购或试用时,应把要求说清楚:是录制一段成片,还是用户插话后立即响应?是回答固定问题,还是查询业务信息?先验证这几个动作,避免只凭一段演示判断整套能力。
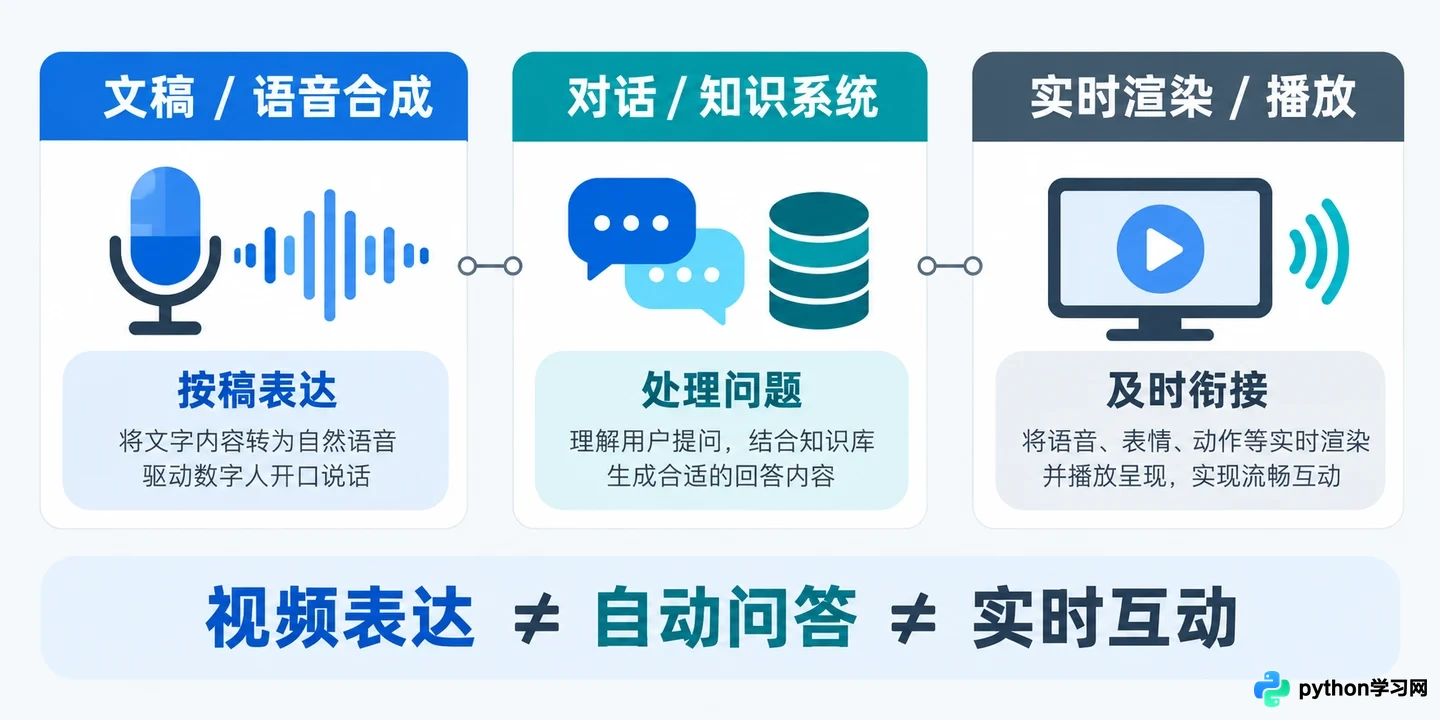
数字人交互能力分解图,展示语音生成、对话逻辑与实时响应的关系
做讲解还是经营角色,决定先选哪条路线
如果主要任务是把审好的稿件做成固定机位讲解,可以先评估真人影像路线的制作条件和成片质量。若要长期经营一个能换场景、换机位、做全身表演的角色,则应把三维资产、动作制作和维护能力一起纳入考虑,不能只比较第一次生成的费用。
两条路线也能在项目中组合使用,没有必要硬选一个技术标签。先写清楚需要交付视频还是角色资产,再核对表演范围、交互方式与素材授权,最后用同一段真实需求做样片。能否完成这段内容,比“克隆”“虚拟偶像”这些名称更有判断价值。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















