


推荐5款好用的在线Python代码运行工具
推荐5款好用的在线Python代码运行工具:Google Colab、Replit、PythonAnywhere、Programiz与JupyterLite。深入分析各自的运行机制、依赖支持、适用场景与具体操作注意事项,帮助开发者和学习者按需挑选最适合的在线编程环境。
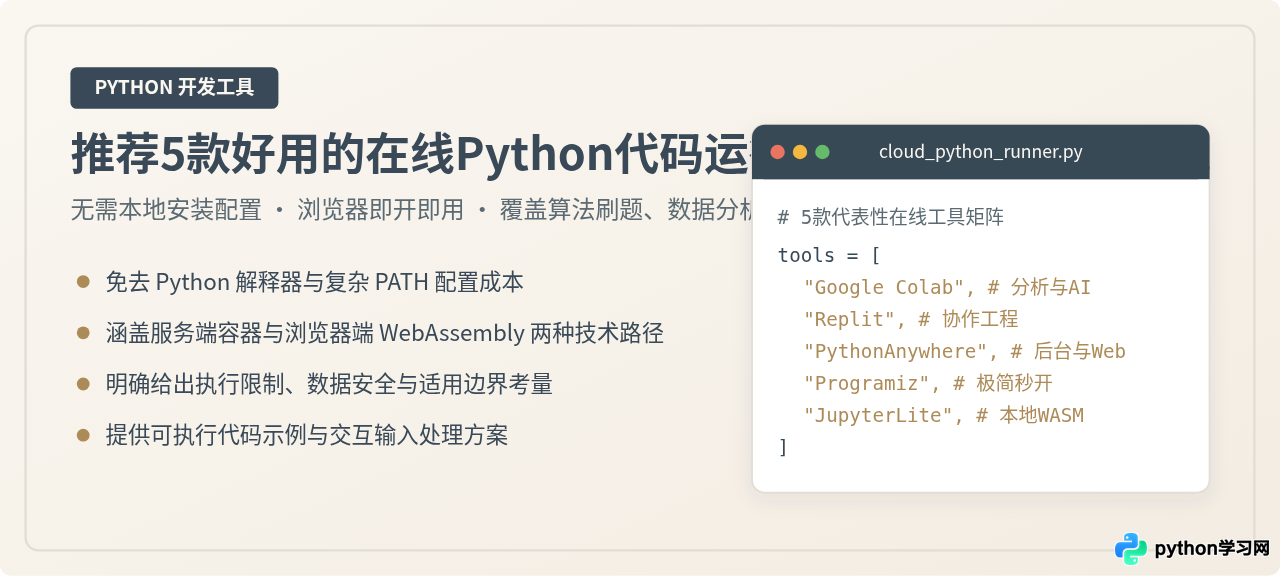
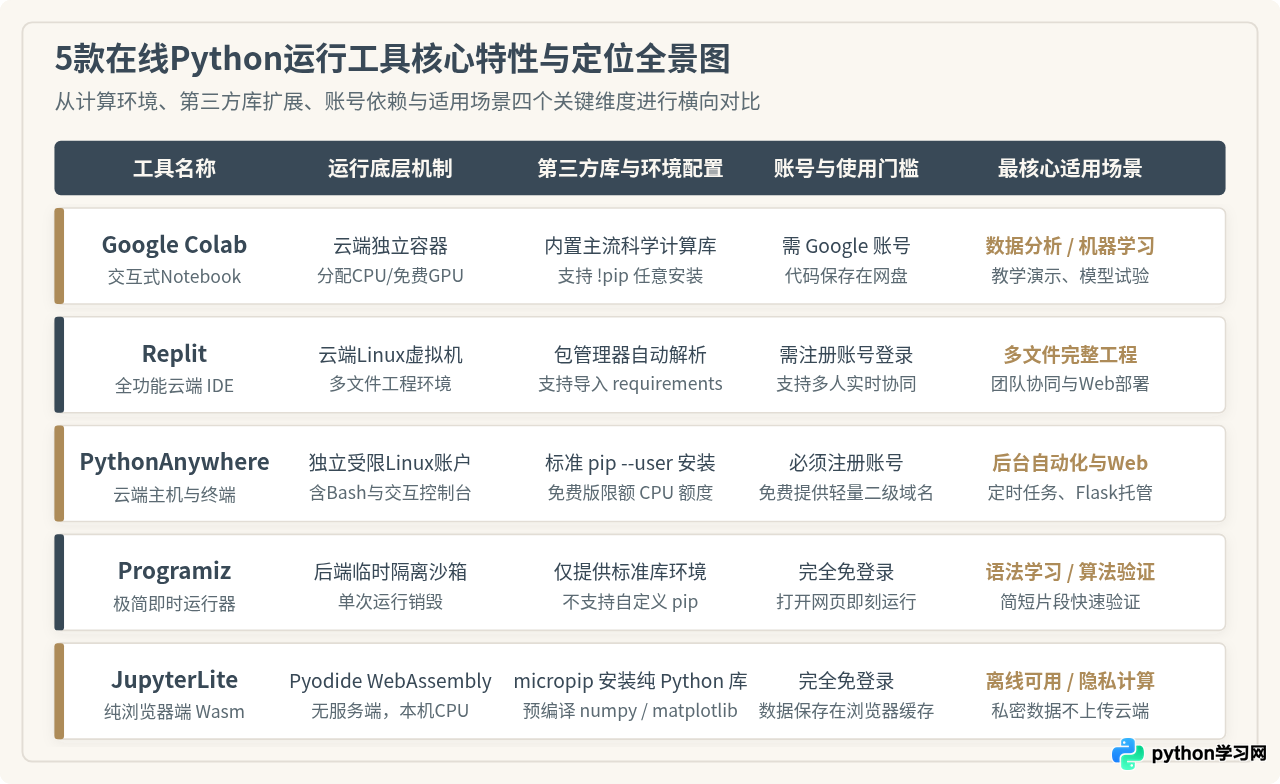
一、5款主流在线Python工具特性与适用场景
评估一款在线 Python 工具是否好用,核心在于考量四个指标:环境就绪速度、第三方库支持能力、文件与数据持久化机制,以及是否要求强制登录。以下 5 款工具代表了当前在线 Python 运行环境的五种典型方案。
1. Google Colab:数据科学与机器学习的交互式工作台
Google Colab 是基于 Jupyter Notebook 构建的云端交互式计算环境。它的核心价值在于开箱即用的数据科学全家桶(预装了 NumPy、Pandas、Matplotlib、Scikit-learn 以及 PyTorch/TensorFlow 等核心库),并且为每个免费账户提供了按需调用的云端 GPU 与 TPU 算力配额。
在 Colab 中,代码以单元格(Cell)为单位进行组织,支持代码与富文本排版混排,生成的数据图表会直接内联显示在输出流中。每个会话运行在一个专用的临时虚拟容器中,你可以通过 !pip install <package> 安装任意需要的第三方库,并且能够直接与 Google Drive 关联实现文件持久化存储。其主要限制在于非交互式守护进程:长时间无操作或单次运行超过上限后会触发运行时自动断开,内存中的临时变量将会重置。
2. Replit:支持多文件与团队协作的云端全功能 IDE
如果你需要构建的是一个包含多个 .py 模块、静态资源、配置文件以及外部依赖的完整程序,Replit 是最接近本地专业代码编辑器的在线工具。
Replit 为每个项目(Repl)提供一个基于 Linux 的沙箱环境,配备了完整的左侧文件树导航栏、基于 Monaco 的代码编辑器、内置终端(Bash)以及多语言包依赖解析器。当你在代码中 import requests 并点击运行时,Replit 会自动检测并从 PyPI 下载依赖。此外,Replit 支持多人实时协同编写与调试,非常适合结对编程、在线答疑以及教学演示。免费版本的主要约束是创建的 Repl 默认为公开可见,且容器在闲置后会转入休眠状态。
3. PythonAnywhere:面向后台脚本、定时任务与 Web 部署的云主机
与偏向临时交互的前端工具不同,PythonAnywhere 的定位是一个运行在云端的轻量级 Python 服务器。注册后,你将获得一个受限的 Linux 用户主目录、原生的 Bash 终端以及 Python 交互式 Shell。
它的突出优势在于支持“计划任务”(Scheduled Tasks)与 WSGI Web 应用托管。如果你写了一个需要每天固定时间抓取公开接口数据的爬虫脚本,或者想部署一个轻量级的 Flask/Django 演示后台,PythonAnywhere 允许脚本在关闭浏览器后继续在云端执行。免费计划提供每天固定的 CPU 运算秒数(CPU quota)以及一个二级域名二级站点,但免费账户对对外访问的公网白名单有严格限制,仅允许访问官方白名单内的合规域名。
4. Programiz Online Compiler:免登录、秒开的单文件即时调试器
当你的诉求仅仅是验证一个算法逻辑、测试一段推导公式或排查一个基础语法疑问时,打开大型云端 IDE 往往需要等待数秒至数十秒的容器初始化时间。Programiz Online Compiler 则专注于“极简与速度”。
它的界面极为纯粹:左侧为单文件编辑窗口,右侧为终端输出面板。无需注册或登录任何账号,打开网页即可直接敲入代码并运行。后端通过轻量级微隔离沙箱在毫秒级别返回运行结果。由于其单次运行即销毁的机制,它不支持使用 pip 额外安装复杂的 C 扩展包,也不提供长期文件存储,但对于刚接触 Python 的初学者以及日常刷算法题的开发者而言,它是启动成本最低的选择。
5. JupyterLite:纯浏览器端运行、零服务器依赖的 WebAssembly 环境
JupyterLite 是一项突破性的技术实现,它将完整的 JupyterLab 界面以及基于 WebAssembly(WASM)的 Pyodide Python 解释器直接移植到了浏览器内部。
这意味着当你在 JupyterLite 中运行 Python 代码时,没有任何网络请求发送给云端服务器,所有的计算逻辑、内存分配和数据处理全部在本地浏览器的 JavaScript 引擎中完成。这带来了两个决定性的好处:其一是极致的数据安全性,你可以放心地在其中清洗包含商业机密或个人隐私的本地 CSV/Excel 文件,数据绝不会离开本地设备;其二是支持离线运行,一旦页面资源完成初次缓存,即使处于断网或机舱环境下也能正常编写和执行代码。
二、两种核心底层架构:云端隔离容器 vs 浏览器端 WebAssembly
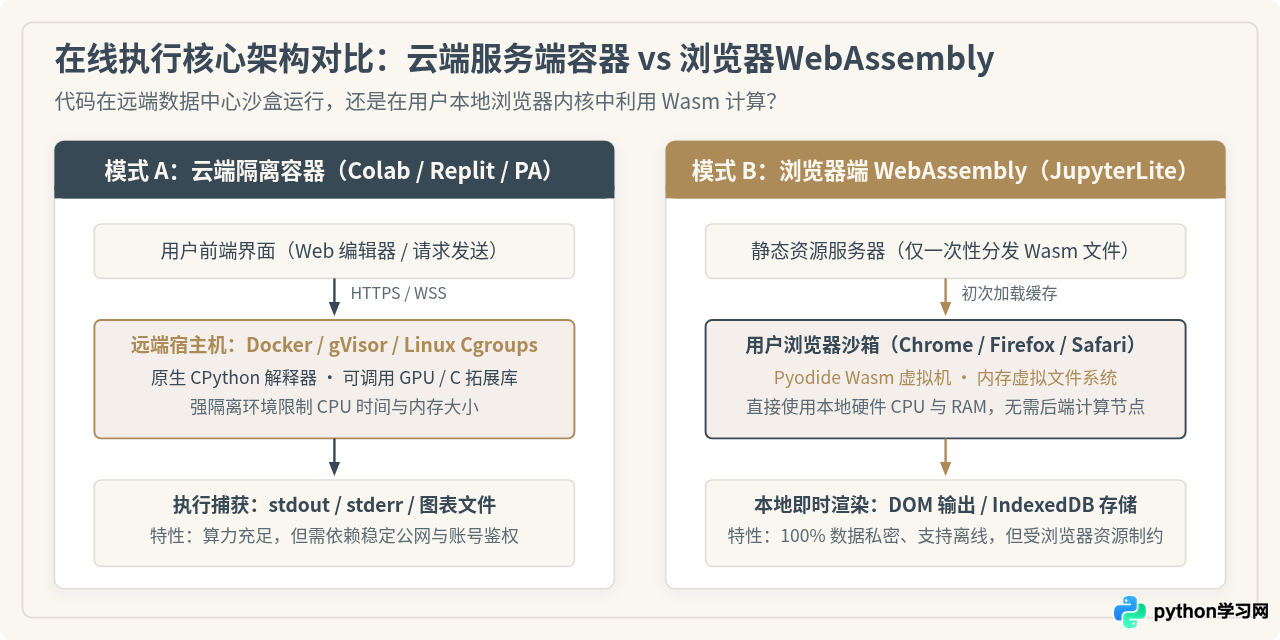
在选择在线运行工具时,理解其底层的执行机制有助于避免在实际开发中踩坑。当前市场上的在线 Python 环境在架构上清晰地划分为两大阵营:服务端容器执行架构与客户端 WebAssembly 架构。
服务端容器执行(Server-Side Sandbox):Colab、Replit、PythonAnywhere 和 Programiz 都属于此阵营。用户的浏览器本质上只承担图形交互界面和代码传输的角色。当点击“运行”时,前端通过 WebSocket 或 HTTP POST 请求将代码打包发送给云端集群调度器。调度器在后端拉起一个经过 Linux Cgroups、Namespace 或 gVisor 严格沙箱隔离的容器,启动原生 CPython 进程执行脚本,最后将标准输出(stdout)、标准错误(stderr)及生成的图表以流式数据回传给浏览器。这种架构的优势是拥有原生的 Linux 系统环境,支持多线程、原生网络套接字以及强大的 GPU 算力;缺陷在于依赖网络连通性,且平台方必须设立严格的超时保护机制以防止算力滥用。
客户端 WebAssembly 架构(Client-Side Pyodide):以 JupyterLite 为代表。该方案将 C 语言编写的 CPython 源码通过 Emscripten 编译成了 WebAssembly 字节码。当用户访问网站时,浏览器下载 Pyodide 运行时并在本地 V8/SpiderMonkey 引擎中启动 Python 解释器。文件系统由浏览器的虚拟文件系统(基于 IndexedDB)模拟。这种方案不产生任何后端服务器维护开销,保障了完全的数据隐私,但其局限在于无法直接调用宿主机的特定硬件加速指令,且仅能加载纯 Python 轮子包或经官方预编译为 WASM 的科学计算包。
三、在线运行 Python 代码的标准操作流程与关键要点
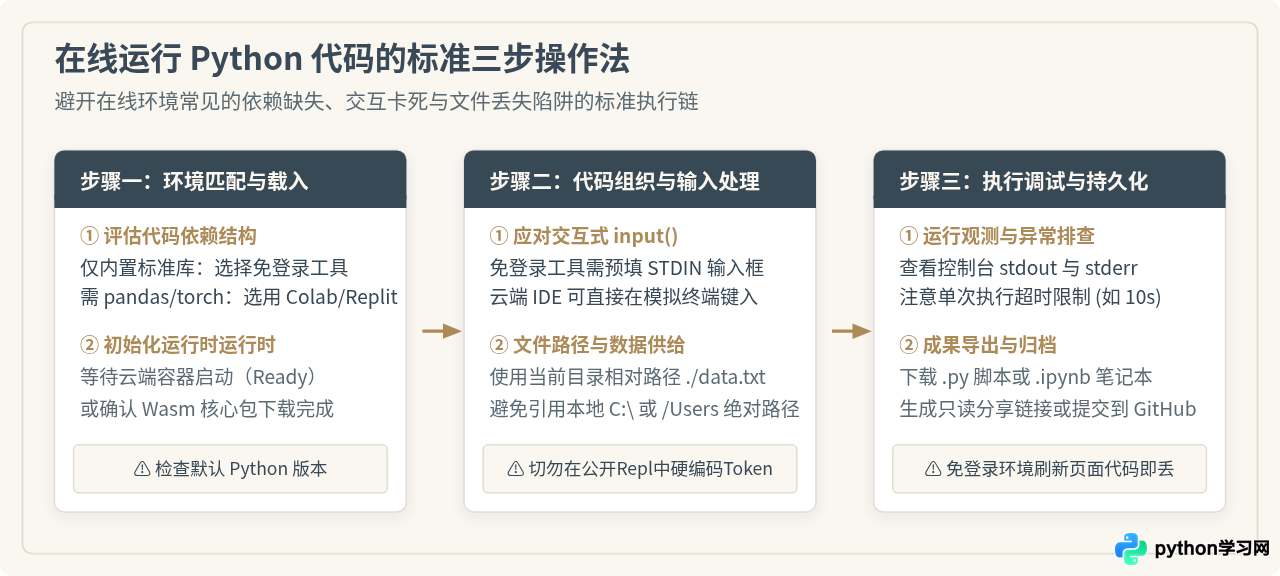
在实际使用在线工具编写代码时,开发者最常遇到的问题往往集中在:交互式输入无响应、外部依赖安装失败,以及会话断开后文件丢失。遵循规范的三个执行步骤能够有效规避这些问题。
步骤一:明确依赖范围并选择匹配工具
在动手前先梳理代码的依赖清单。如果仅仅使用了 Python 内置的 math、collections、itertools 等标准库,直接使用 Programiz 这类免登录工具可以在数秒内完成验证。如果代码需要引入 pandas、scikit-learn 等重量级科学计算库,应优先载入 Colab 或 JupyterLite,避免在不支持此类库的轻量工具中频繁遭遇 ModuleNotFoundError。
步骤二:正确处理代码输入(stdin)与文件读取
许多初学者在轻量在线编译器中使用 input() 函数时会遇到程序挂起超时的问题。这是因为部分轻量在线平台采用非阻塞的批量执行机制,无法在执行中动态弹窗等待用户输入。在此类工具中,必须提前在界面下方的“STDIN / Input”文本框中逐行填入预设的输入数据。
此外,当需要读取外部文件时,严禁使用本地开发习惯中的绝对路径(如 C:\Users\name\data.csv),而应通过在线界面提供的“Upload”功能将文件上传至当前工程目录,并在代码中使用标准相对路径读取:
当前无标准输入,使用默认测试参数
--- 步骤 2:环境相对文件写入与读取 ---
文件读取成功,内容为:[此文件保存在当前在线沙箱的临时虚拟目录中。]
步骤三:执行、排查与成果导出
运行代码后,控制台会输出执行耗时与返回码。若程序抛出异常,应重点观察 Traceback 信息的末行:
- TimeoutError / Execution Timed Out:代码陷入了无限循环(如未正确递增循环变量的
while),或等待输入超时。在线环境单次运行时间通常限制在 5 到 30 秒之间。 - MemoryError:在内存受限的容器(如免登录环境通常限制为 128MB~256MB 内存)中创建了过大的列表或数组。
- PermissionError:尝试在沙箱非用户目录(如根目录
/或系统目录/etc)下执行写操作。
四、不同使用场景下的精准选型决策指南
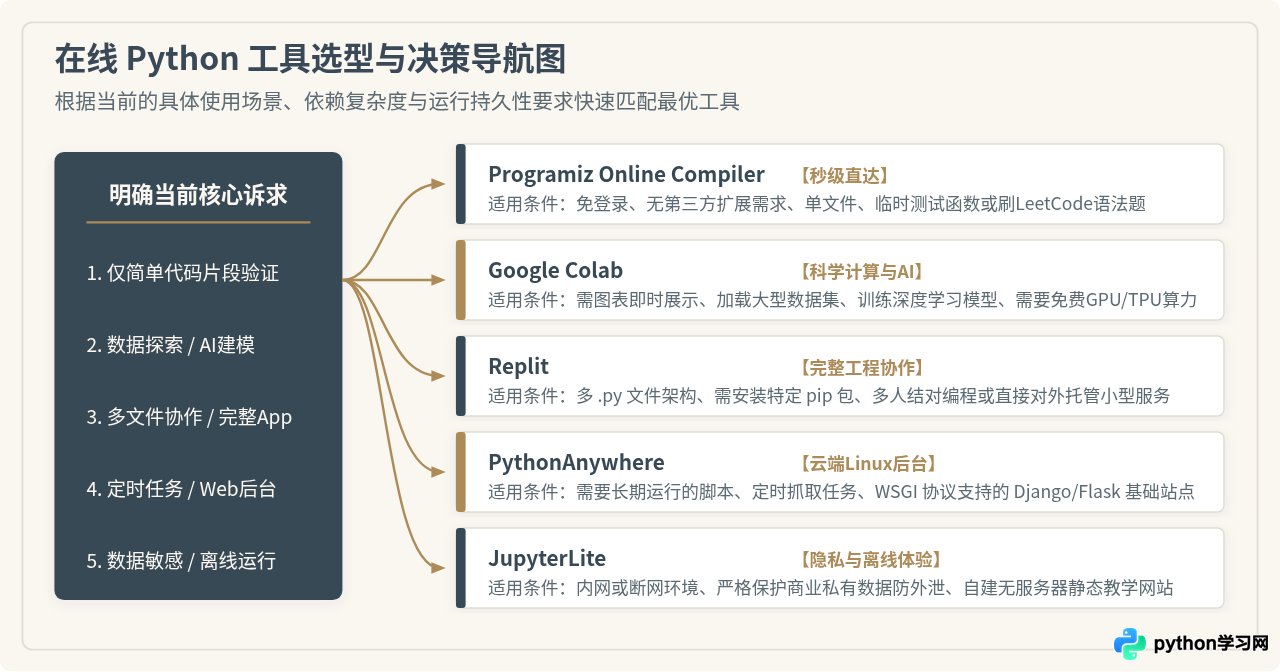
面对具体的开发任务时,可以根据代码规模、计算需求与协作模式,参考以下决策路径迅速选出最匹配的在线工具:
| 任务类型 | 推荐工具 | 选择理由与核心优势 | 必须注意的边界限制 |
|---|---|---|---|
| 语法自学 / 算法刷题 | Programiz | 打开网页即可运行,零加载等待,无需注册账号即可开始测试。 | 不支持多文件管理,无法使用自定义第三方库。 |
| 数据清洗 / 机器学习 | Google Colab | 提供免费 GPU/TPU 算力,预装主流科学计算库,内联展示交互图表。 | 非永久在线,空闲过久会自动回收运行时实例。 |
| 中小型项目 / 结对编程 | Replit | 完整的云端多文件 IDE,支持自动安装 PyPI 依赖,多人实时协同。 | 免费版工程默认全网公开,不宜存放私密代码。 |
| 定时任务 / 轻量接口 | PythonAnywhere | 提供受限 Linux 环境,原生支持后台定时任务与简易 Web 服务部署。 | 免费版限制单日 CPU 时间,对外网络请求受域名白名单限制。 |
| 企业私密数据 / 离线环境 | JupyterLite | 基于浏览器 WebAssembly 本地执行,数据绝不出网,支持离线缓存运行。 | 计算性能依赖本地浏览器,不支持编译型 C 扩展库。 |
五、在线 Python 工具的安全与生产限制说明
在线运行工具为临时开发与学习提供了极大的便利,但在工程实践中必须明确其安全红线与生产限制:
-
严禁硬编码敏感凭据:无论使用哪款工具,都切勿将数据库密码、第三方 API Token、私有 SSH 密钥等敏感信息直接写在代码中。尤其在 Replit 等免费版默认公开所有项目的平台上,公开的代码片段会被搜索引擎爬取,极易造成凭证泄露。建议在本地调试敏感逻辑,或在支持私有环境变量管理的专业环境中使用
os.environ.get()进行动态注入。 - 算力与超时并非无限:为了防止恶意挖矿或死循环耗尽资源,所有免费在线平台均严格限制了 CPU 核心数、可用物理内存及网络带宽。如果你的任务涉及千万级数据运算或大文件处理,在线工具必然会触发 OOM(内存溢出)或超时截断,此时应回归本地专业开发环境或企业私有计算集群。
-
网络出站受控:许多在线沙箱对发起的网络请求(例如使用
requests.get()爬取网页或调用外部 Webhook)设置了严格的防火墙规则,某些平台仅放行特定白名单域名的连接。在进行网络编程测试前,需先确认该平台的出网策略。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















