


Python顺序结构与分支、循环结构的区别及适用场景
深入解析Python三种基本控制结构(顺序结构、分支结构、循环结构)的核心运行机制、控制流特征与本质区别,结合具体的工程示例与选型决策步骤,帮助读者在实际编程中做出清晰合理的控制结构设计。
控制结构决定了计算机程序中语句的执行次序。Python程序的所有逻辑推演,归根结底都建立在顺序、分支与循环三种基础控制结构之上。掌握它们的核心机制与本质区别,不仅有助于写出语法正确的代码,更是合理组织程序逻辑、避免嵌套泥潭和消除潜在逻辑漏洞的关键。本文将通过执行流向分析、语法特性对比和典型场景实践,梳理三大结构的适用边界。
一、三大基本控制结构的运行机制与本质区别
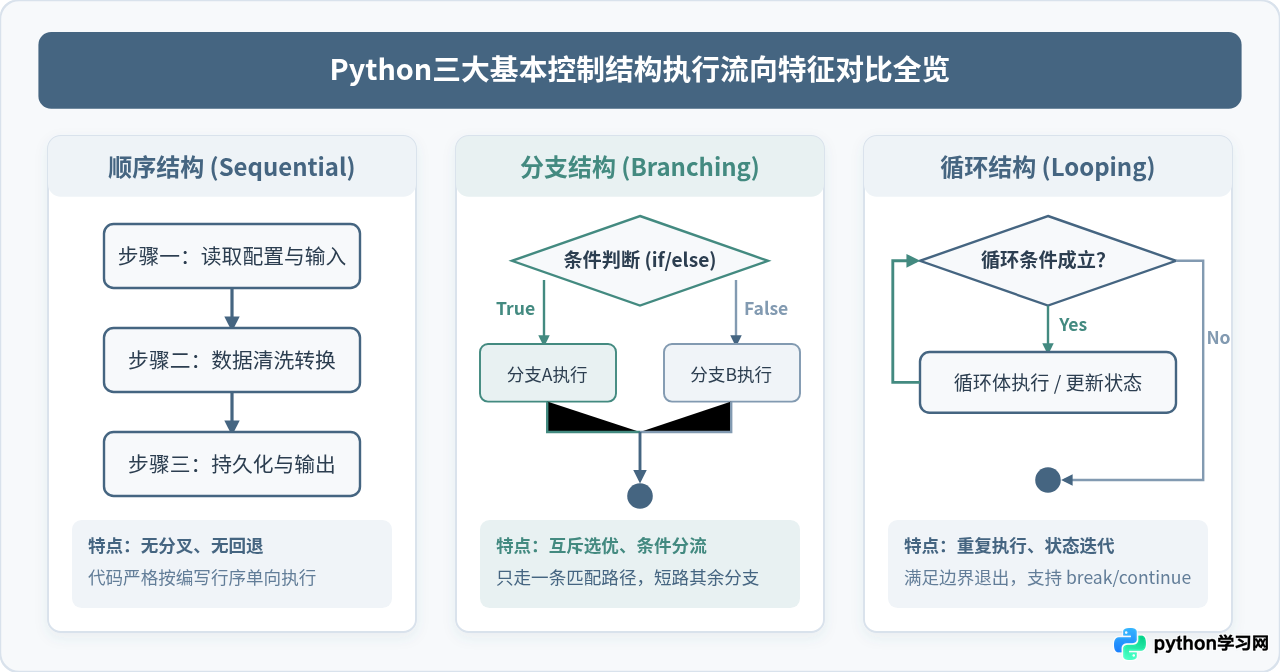
结构化程序设计理论证明,任何复杂算法都可以由顺序结构、选择(分支)结构和循环结构这三种基本形态组合而成。它们的核心差异体现在指令执行轨迹、状态依赖方式以及退出边界这三个关键维度:
- 顺序结构(Sequential Structure):是程序最自然的默认执行流。CPU和Python解释器从脚本的第一行开始,逐句向下编译执行。语句之间没有跳转、分流或回退,前一条语句的执行结果直接构成了下一条语句的执行上下文。
- 分支结构(Branching Structure):引入了条件判断机制。程序在运行到分支节点时,会对指定的布尔表达式进行求值,根据真假结果从两条或多条预设路径中挑选出唯一一条执行,而将其余未命中的分支全部跳过。
- 循环结构(Looping Structure):打破了代码单次向下推进的限制,引入了状态回环。只要循环条件保持为真,或者可迭代对象中依然存在未消费的元素,解释器就会反复执行特定代码块,直到终止条件触发或手动中断。
二、顺序结构:确定性线性处理与流水线脚本
顺序结构是编写程序的基础骨架。在顺序结构中,代码的物理排版顺序完全等同于实际执行顺序。这种结构适用于每一步操作都有确定输入与输出、不存在环境依赖分流且无需对集合数据重复处理的场景。
典型的适用场景包括系统启动配置加载、环境参数初始化、单一格式的文本或数学计算流水线。在这些任务中,逻辑是纯粹单向的,不需要做出非此即彼的选择。
# 示例:标准顺序结构的数据计算流水线
# 步骤 1:准备输入数据
raw_radius_str = "12.5"

# 步骤 2:类型转换与参数验证
radius = float(raw_radius_str)
pi = 3.1415926535

# 步骤 3:依据确定公式计算面积与周长
area = pi * (radius ** 2)
perimeter = 2 * pi * radius

# 步骤 4:标准化输出结果
print(f"半径为 {radius} 的圆面积为: {area:.2f},周长为: {perimeter:.2f}")
顺序结构的局限性:顺序结构无法应对现实业务中的“不确定性”。一旦输入的字符串无法转为浮点数(例如输入非法字符),或者需要根据用户权限展示不同数据,顺序结构就会崩溃或无法表达业务意图。这时必须引入分支结构建立防御与调度。
三、分支结构:基于状态决策的路径分流
分支结构的核心价值在于赋予程序“做决定”的能力。在Python中,分支结构主要通过 if、elif、else 语句实现,而在 Python 3.10 及以上版本中,还可以使用 match-case 结构进行模式匹配。
1. 短路求值与互斥机制
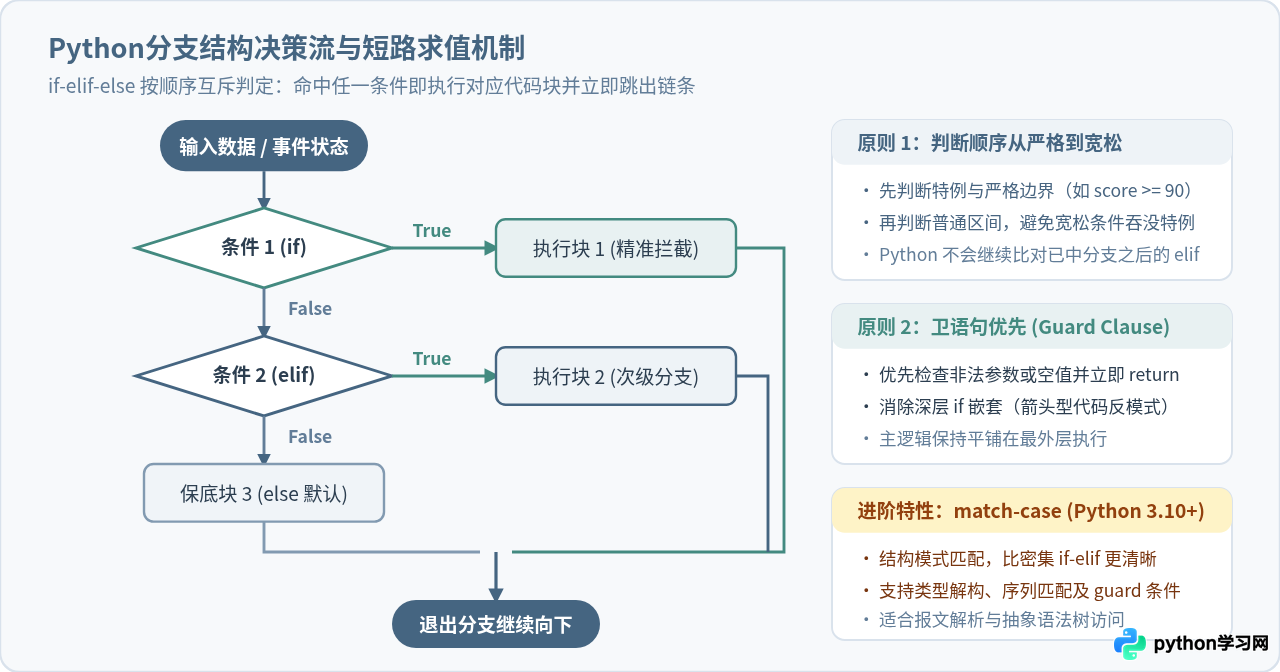
Python中的 if-elif-else 链条具备严格的互斥性与短路求值特性。解释器按照自上而下的顺序评估条件,一旦某个条件求值为 True,就会立即执行其代码块,执行完毕后直接跳过整个分支链剩余的所有 elif 与 else,进入后续主流程。
正因如此,编写多条件分支时必须遵循从严格到宽松、从特例到通用的判定顺序。如果将宽泛的条件写在上方,更为严苛的子条件将永远无法被触发。
# 示例:业务状态码分级响应处理
def process_http_response(status_code: int, payload: dict) -> str:
    # 卫语句:优先拦截非法输入或严重错误(Guard Clause)
    if status_code < 100 or status_code > 599:
        return f"无效的状态码: {status_code}"

    # 按照业务严格度递减分流
    if status_code == 200:
        data_count = len(payload.get("items", []))
        return f"请求成功,获取到 {data_count} 条数据"
    elif status_code == 401:
        return "身份鉴权失效,请重新登录"
    elif status_code == 403:
        return "无权访问此受保护资源"
    elif 400 <= status_code < 500:
        return f"客户端请求错误(HTTP {status_code})"
    elif 500 <= status_code < 600:
        return f"服务端响应异常(HTTP {status_code})"
    else:
        return f"其他协议状态(HTTP {status_code})"
if,导致代码横向膨胀、可读性极差。推荐在函数开头检查所有不满足前置条件的异常情况并立即 return 或抛出异常。将正常业务逻辑平铺在最外层,使主流程清晰易读。
四、循环结构:处理重复性与集合遍历
当任务需要对一批同类数据重复进行相同处理,或者需要持续等待某个状态变更时,循环结构是唯一合理的选择。Python提供了两种核心循环:for 循环与 while 循环。
1. for 循环 vs while 循环的选型依据
-
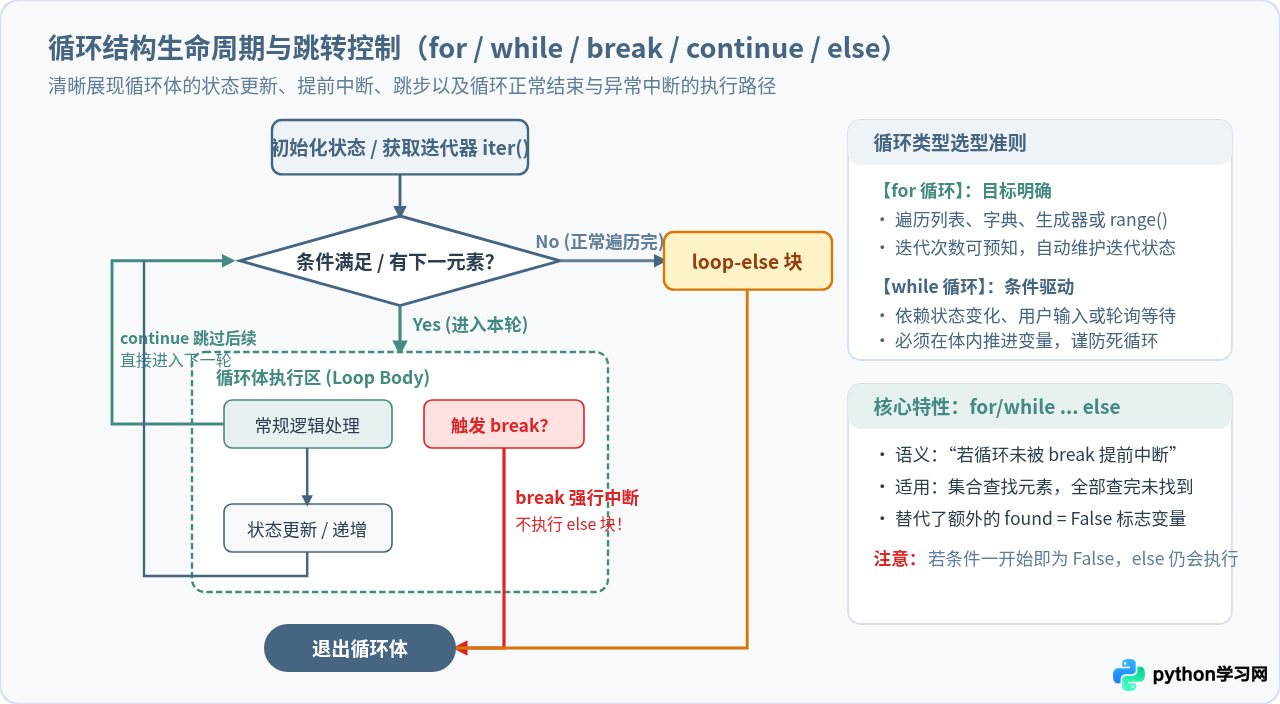
for 循环(迭代器驱动):适用于已知遍历目标或可预知次数的场景。在Python中,
for循环本质是基于迭代协议(iter()和next())工作的,能够天然、安全地遍历列表、元组、字典、集合以及生成器,不会引发越界错误。 - while 循环(条件驱动):适用于循环次数未知,执行与否取决于动态状态变化的场景。例如服务监听、网络超时重试、用户交互提示或数值收敛计算。
2. 流程跳转与 Python 特有的 loop-else
循环体内部可以通过以下关键字精细化控制流向:
continue:立即终止当前这一轮迭代,跳过循环体中剩余的代码,直接进入下一轮迭代。break:彻底跳出循环,不再执行任何后续轮次。-
loop-else(例如for ... else):这是Python独有的语法设计。当且仅当循环正常耗尽元素执行完毕、未触发 break 时,才会执行else块。如果在遍历过程中命中了break,else块将被跳过。该语法非常适合用于在集合中查找特定元素的逻辑。
# 示例:结合 while 重试机制与 for-else 查找的混合处理
import time

def find_target_record(database_records: list[dict], target_id: str) -> dict | None:
    # 使用 for-else 结构进行线性检索
    for record in database_records:
        if record.get("id") == target_id:
            print(f"成功定位目标记录: {target_id}")
            return record
    else:
        # 仅在循环完整走完且未找到匹配项时执行
        print(f"遍历所有 {len(database_records)} 条记录,未发现 ID 为 {target_id} 的数据")
        return None

def fetch_with_retry(max_attempts: int = 3) -> bool:
    attempt = 0
    while attempt < max_attempts:
        attempt += 1
        print(f"正在进行第 {attempt} 次连接尝试...")
        # 模拟条件判断与提前退出
        connection_success = (attempt == 2) # 假设第2次连接成功
        if connection_success:
            print("连接建立成功,跳出重试循环")
            return True
        time.sleep(0.1) # 简单等待
    print("达到最大重试上限,宣告失败")
    return False
for item in my_list: 中直接执行 my_list.remove(item) 会改变列表底层的索引偏移,导致部分元素被意外跳过漏查。如果需要过滤,应使用列表推导式 [x for x in my_list if condition] 或在原列表切片副本 my_list[:] 上遍历。
五、综合选型与推导步骤:从业务需求到代码结构
在实际工程开发中,单一结构往往无法独立完成复杂的业务目标。优秀的程序设计在于能够根据业务特征,将三种结构有机编排在一起。
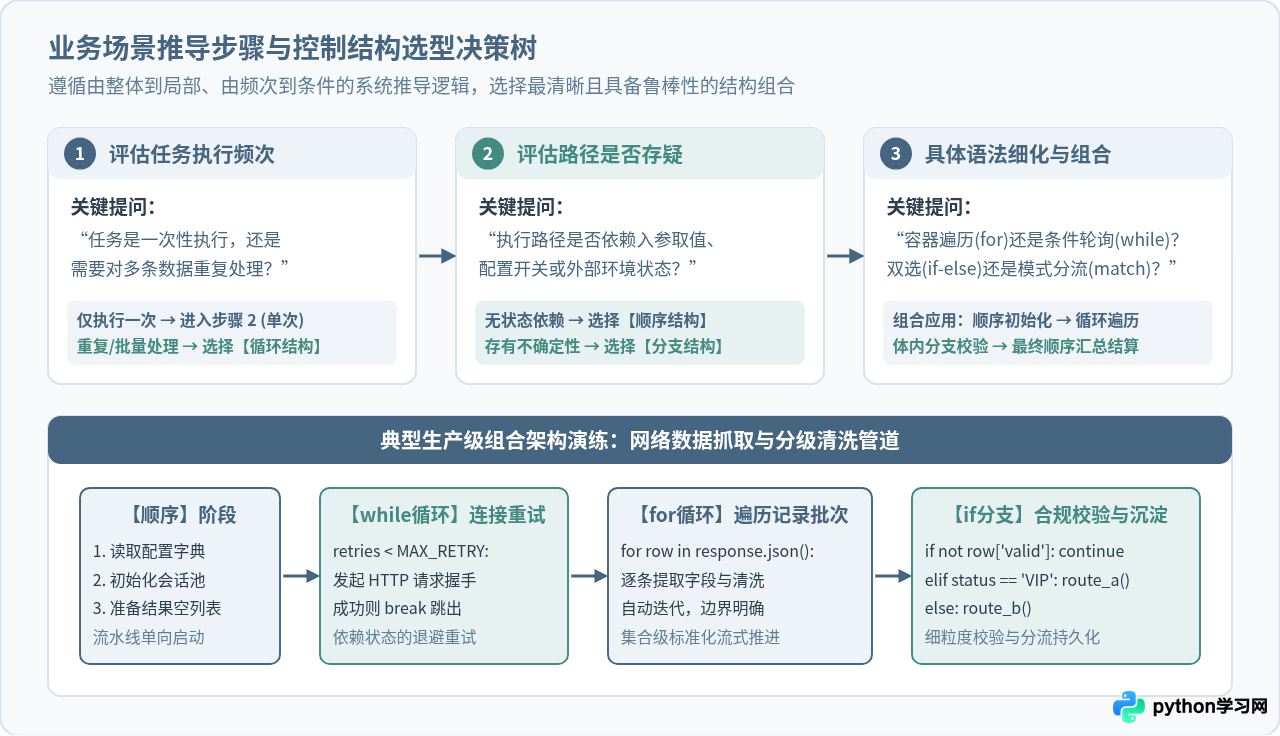
工程设计三步推导法
- 第一步(审视频次与批量):先分析要处理的核心数据是“单条单次输入”还是“批量集合序列”。如果是批量数据,外层框架必须确立为循环结构;如果是一次性单任务,则按单向流水线设计。
- 第二步(审视分支与不确定性):识别每一步操作是否存在可能失败的边界、业务特例或不同角色权限。只要存在分支可能,立即在对应节点嵌入分支防御语句。
-
第三步(细化语法与嵌套控制):根据已知条件类型选用最轻量的表达方式。能用单行三元表达式的不写冗长
if-else;已知序列遍历严禁使用基于下标的while i < len(arr),统一使用优雅的for in。
六、总结与核心选型速查
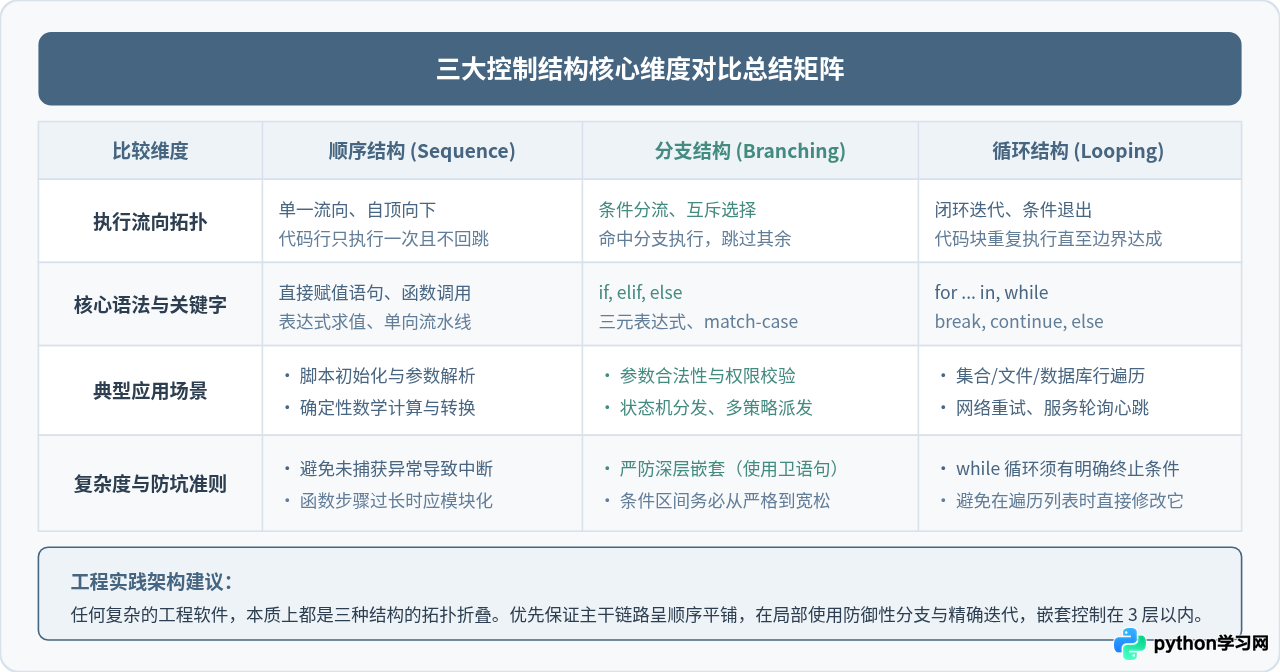
为了方便在日常编写代码时快速评估与决策,下表汇总了顺序、分支与循环结构的关键特征与选型指南:
| 结构类型 | 流向与拓扑特征 | 典型语法与关键字 | 适用场景 | 核心防范点 |
|---|---|---|---|---|
| 顺序结构 | 单向单次执行,自上而下,无分支与跳转 | 直接表达式、函数调用、流水线管道 | 参数初始化、单次数学计算、无分歧文件导出 | 步骤过长时应拆分子函数,避免单函数超过50行 |
| 分支结构 | 依据布尔状态互斥分流,命中即短路跳出 | if, elif, else, match-case |
参数校验、错误拦截、权限控制、多状态业务派发 | 防止条件顺序颠倒;使用卫语句将嵌套控制在2层以内 |
| 循环结构 | 状态回环迭代,满足条件重复执行,直到边界触发 | for ... in, while, break, continue |
批量数据清洗、日志行解析、接口轮询重试、算法逼近 | while务必更新迭代状态防止死循环;避免遍历中删改列表 |
总而言之,顺序结构确保了程序的基本执行链路,分支结构提供了应对业务多变性的决策能力,循环结构则赋予了计算机高效处理海量数据的核心生产力。在日常编写Python代码时,保持主干逻辑呈清晰的顺序流动,用扁平的分支结构处理边缘条件,用精确的循环结构消费数据,是写出优雅、健壮代码的不二法门。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















