


为什么Python replace替换后原字符串没变?
深入解析Python中调用replace方法后原字符串内容保持不变的核心原因。通过内存模型、可变与不可变对象机制、标准解决步骤及典型场景对比,彻底掌握Python字符串处理的正确方法。
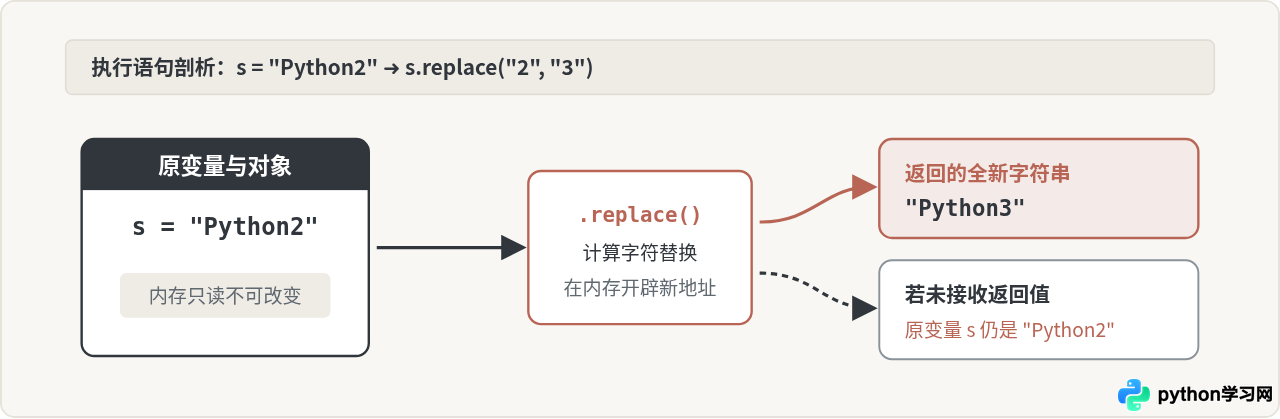
str)是不可变对象(Immutable)。调用 str.replace() 并不会直接在原字符串所在内存中修改字符,而是计算并返回一个包含了替换结果的全新字符串。如果没有用变量重新接收这个返回值,原字符串变量引用的仍旧是旧对象,表现出来就是“原字符串完全没变”。
一、现象重现:一次典型的“无效替换”
很多初学 Python 的开发者在处理文本时,常常写出类似下面的代码:
# 定义一个初始文本
text = "Hello World"

# 期望把 "World" 替换成 "Python"
text.replace("World", "Python")

# 打印结果
print(text)
在终端中运行这段代码,控制台打印出的结果依然是:
Hello World代码既没有抛出异常,也没有给出任何警告,但 text 的内容原封未动。这往往会让人产生困惑:难道是传入的参数不对?还是匹配项没有找到?事实上,replace 确实执行了替换,但结果并没有自动“写回”原变量。
二、深层原因:字符串的不可变性与内存模型
在 Python 语言中,数据类型被严格划分为可变对象(Mutable)和不可变对象(Immutable):
- 不可变对象:数值(
int,float)、字符串(str)、元组(tuple)、冻结集合(frozenset)等。 - 可变对象:列表(
list)、字典(dict)、集合(set)等。
对于字符串对象而言,一旦在内存堆区完成创建,其内部的字节序列就处于完全锁定与只读状态。Python 不提供任何能够在底层直接修改原字符串内部字符的接口。
当我们调用 text.replace("World", "Python") 时,Python 解释器在底层执行了以下三步:
- 在内存中开辟一块全新的内存地址;
- 将原字符串中符合条件的片段进行替换,并将新字符序列写入该新地址;
- 将这个新创建的字符串对象作为方法的返回值交付给调用者。
如果调用者没有提供变量来承接这个返回值,这个新对象在表达式执行完毕后就会因为引用计数归零而被垃圾回收机制清理,原变量 text 所指向的内存地址没有任何改动。
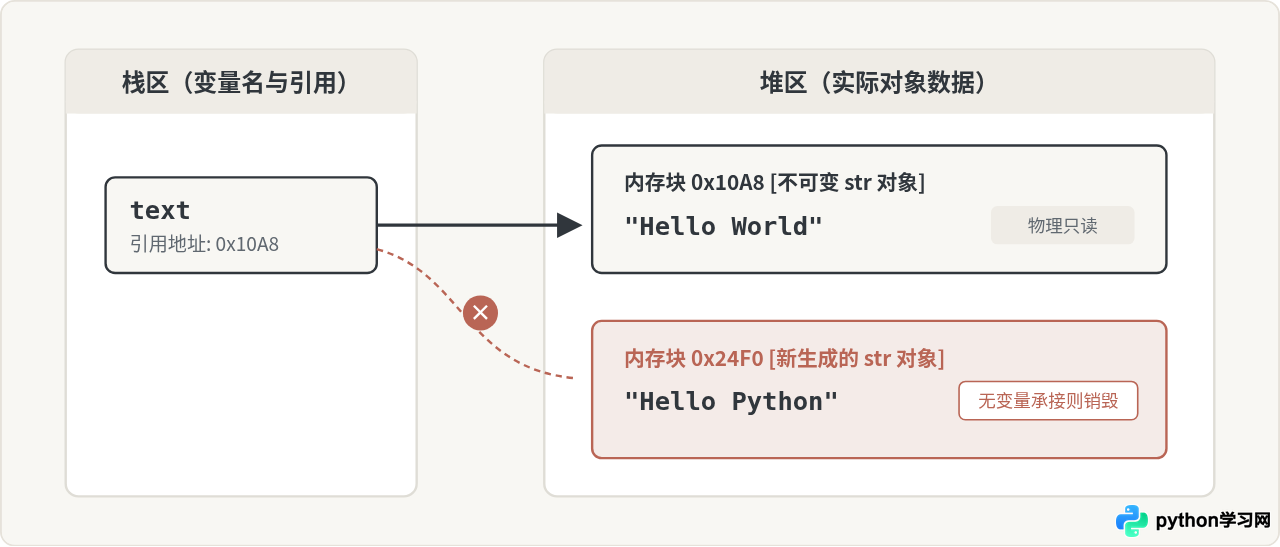
我们可以用内置的 id() 函数验证这一机制。id() 会返回对象在内存中的唯一标识符:
text = "Hello World"
print("替换前原对象 id:", id(text))

new_text = text.replace("World", "Python")
print("替换后新对象 id:", id(new_text))
print("原变量目前 id:", id(text))
示例输出:
替换前原对象 id: 4358249840
替换后新对象 id: 4358250032
原变量目前 id: 4358249840输出清晰地证明:new_text 存储在一个完全不同的内存位置上,而 text 依然牢牢绑定在原来的地址上。
三、标准修复步骤与常见写法
要让替换结果生效,核心在于显式接收方法返回的全新字符串。根据实际业务需求,通常有两种处理路径:
路径 A:直接覆盖原变量(最常用)
如果后续代码不再需要使用替换前的旧字符串,直接将返回值重新赋值给原变量即可:
text = "Hello World"
# 将新字符串对象重新绑定到 text 变量
text = text.replace("World", "Python")
print(text)  # 示例输出:Hello Python
路径 B:使用新变量保存(保留原始版本)
在数据清洗、日志记录或需要保留原始内容做比对的场景下,推荐赋予其一个语义明确的新变量名:
raw_input = "2026/10/31"
clean_date = raw_input.replace("/", "-")
print(raw_input)   # 示例输出:2026/10/31(原样保留)
print(clean_date)  # 示例输出:2026-10-31(新格式)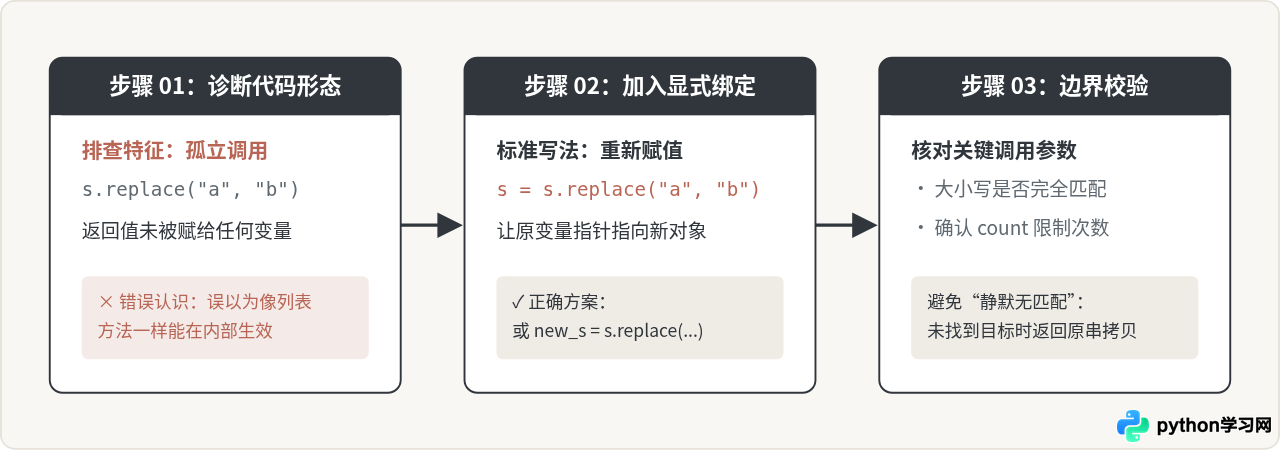
四、对比分析:为什么初学者容易落入这个陷阱?
对 replace 行为的误解,往往来自于对 Python 其他常见内置类型(如列表 list)使用习惯的惯性迁移。
在 Python 中,列表支持原地修改(In-place mutation)。例如列表的 append()、sort()、reverse() 等方法,直接在现有内存地址上修改内部元素,它们的返回值为 None:
nums = [3, 1, 2]
nums.sort()     # 原地修改,无需赋值
print(nums)     # 示例输出:[1, 2, 3]
因为习惯了 nums.sort() 这种“直接在原对象上操作”的语法,很多人直觉上认为 text.replace(...) 也是相同机制。不仅是 replace(),Python 字符串的所有处理方法——包括 strip()、lower()、upper()、split()、title() 等,全部遵循“返回新对象,不碰原对象”的铁律。
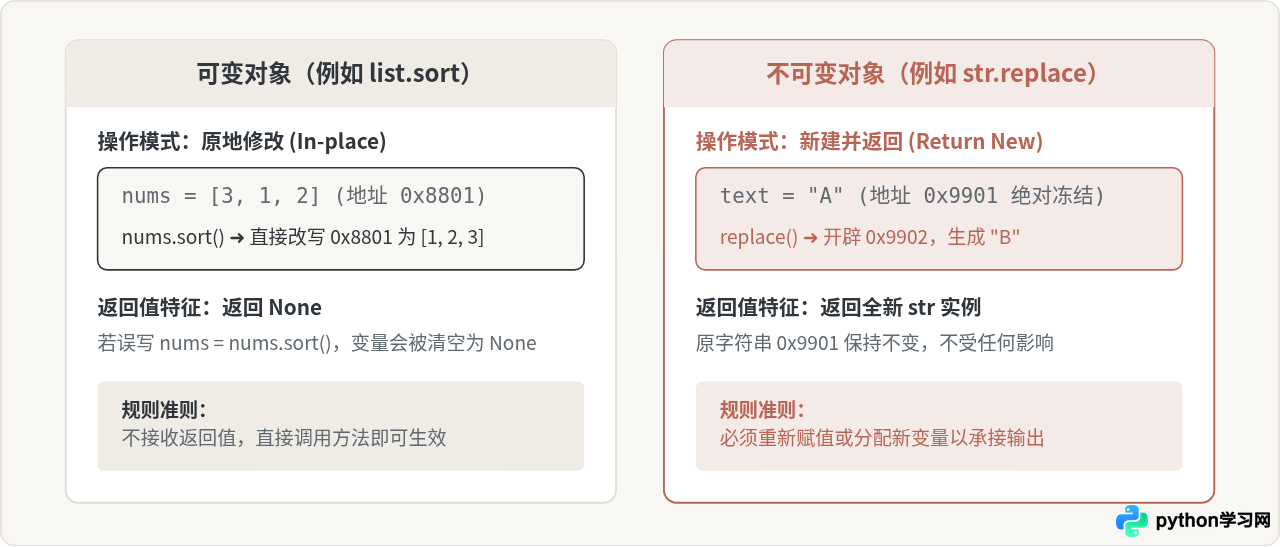
| 对比维度 | 字符串方法(如 str.replace) | 列表方法(如 list.sort) |
|---|---|---|
| 对象类型 | 不可变对象(Immutable) | 可变对象(Mutable) |
| 原对象状态 | 严格保持原样,无法被任何方法篡改 | 在原内存位置被直接改写 |
| 方法返回值 | 替换后的全新字符串对象 | None |
| 正确使用姿势 | s = s.replace(old, new) |
lst.sort()(切忌 lst = lst.sort()) |
五、进阶细节与避坑指南
在确认了必须使用重新赋值之后,在日常开发中使用 replace() 还有以下几处需要注意的边界条件与场景扩展:
1. 替换次数控制:count 参数
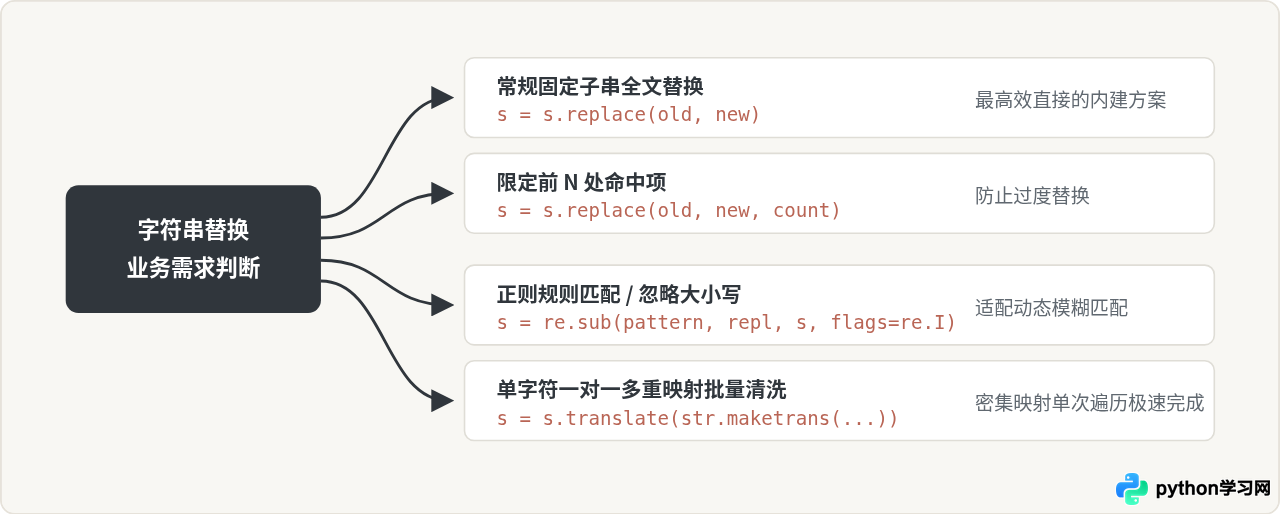
replace() 接受第三个可选参数 count,用于指定最大替换次数。默认情况下,它会替换所有匹配到的子串:
order_id = "2026-AB-2026-CD"

# 仅替换第 1 处匹配项
result = order_id.replace("2026", "2027", 1)
print(result)  # 示例输出:2027-AB-2026-CD
2. 链式连续替换
由于每次调用 replace() 都会返回一个新的字符串,因此可以无缝进行链式调用:
raw_text = " ( Hello Python! ) "
cleaned = raw_text.strip().replace("(", "[").replace(")", "]")
print(cleaned)  # 示例输出:[ Hello Python! ]
3. 大小写敏感性与“静默失败”
str.replace() 严格区分大小写。如果在原字符串中未找到匹配项,方法不会报错,而是静默返回一个原字符串的副本:
filename = "REPORT_FINAL.TXT"
# 小写的 .txt 无法匹配大写的 .TXT
filename = filename.replace(".txt", ".csv")
print(filename)  # 示例输出仍为:REPORT_FINAL.TXT
如果需要忽略大小写替换,应使用标准库中的 re.sub(),并传入 flags=re.IGNORECASE。
六、总结
回到文章标题的问题:“为什么 Python replace 替换后原字符串没变?”
一句话总结:这是 Python 针对不可变类型设计的安全保证。replace() 的职责不是破坏原有内存中的字符,而是生产包含修改的新对象。记住标准规则:无论何时对字符串进行修改,永远要用赋值语句(s = s.replace(...))将新结果捕获回来。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















