


Python Lark库教程:快速生成词法分析器与语法树
全面讲解如何使用 Python Lark 库快速构建词法分析器与语法分析树(Parse Tree),包含 EBNF 文法设计、大小写终结符规则、四则运算实战以及 Transformer 语义求值。
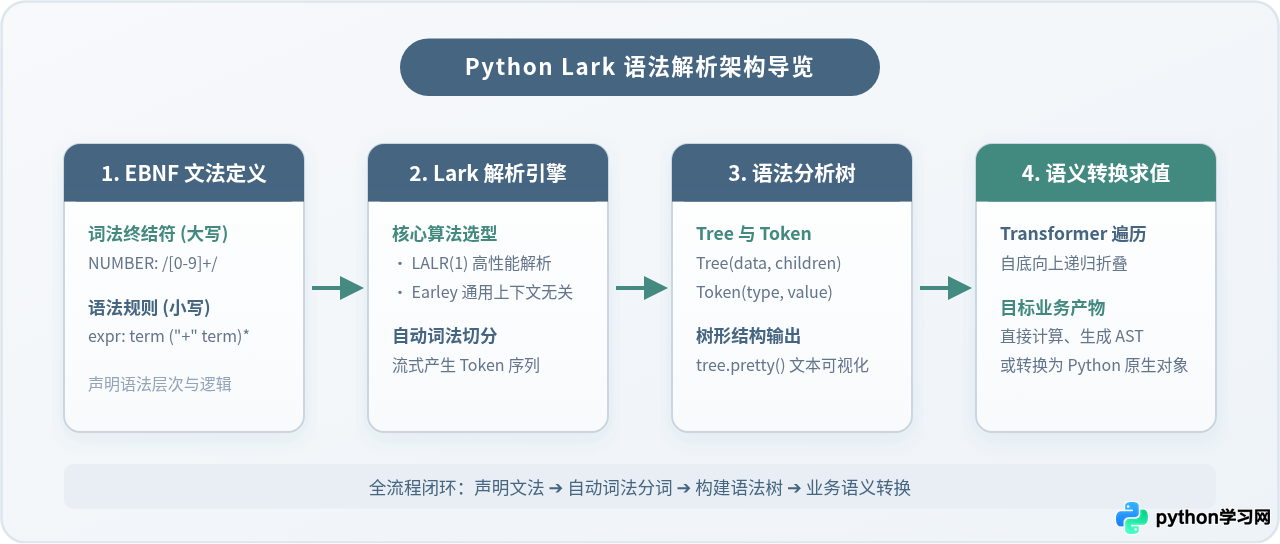
一、环境准备与 Lark 核心解析流程
Lark 作为一个纯 Python 库,不依赖外部 C 编译器或复杂的原生工具链,安装过程非常直接。在终端中执行以下命令即可完成安装:
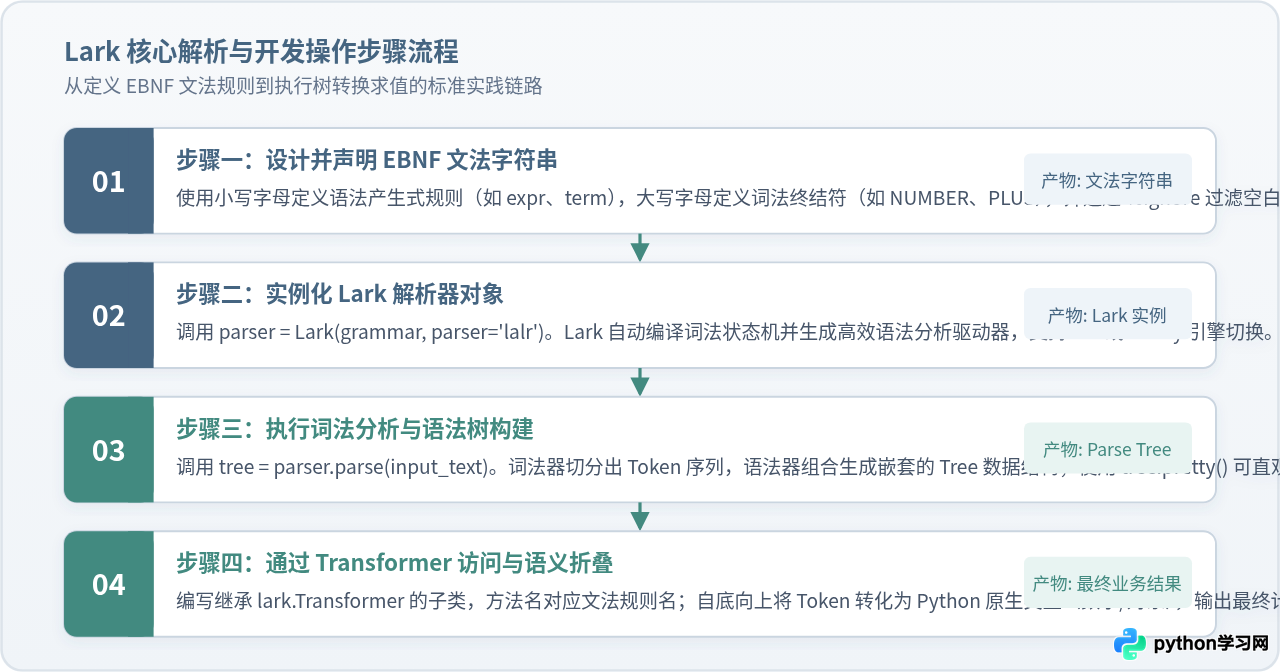
pip install lark在实际编写代码前,理解 Lark 内部的数据流动机制有助于快速定位文法设计中的问题。Lark 的解析过程由四个关键步骤组成:
- 文法声明:使用标准的 EBNF 语法规则编写文法字符串,明确指出文本由哪些语法结构和词法单元组成。
- 引擎实例化:创建
Lark核心对象,Lark 会自动编译文法,构建对应的状态机与词法提取器。 - 语法分析:调用
parser.parse(text)处理目标文本,词法分析器先将字符流切分为一系列Token,语法分析器再将 Token 组装为嵌套的Tree对象。 - 语义转换:通过继承
Transformer编写访问逻辑,自底向上遍历语法树并折叠节点,输出最终的数值结果或抽象语法树(AST)。
二、EBNF 文法设计:区分词法规则与语法规则
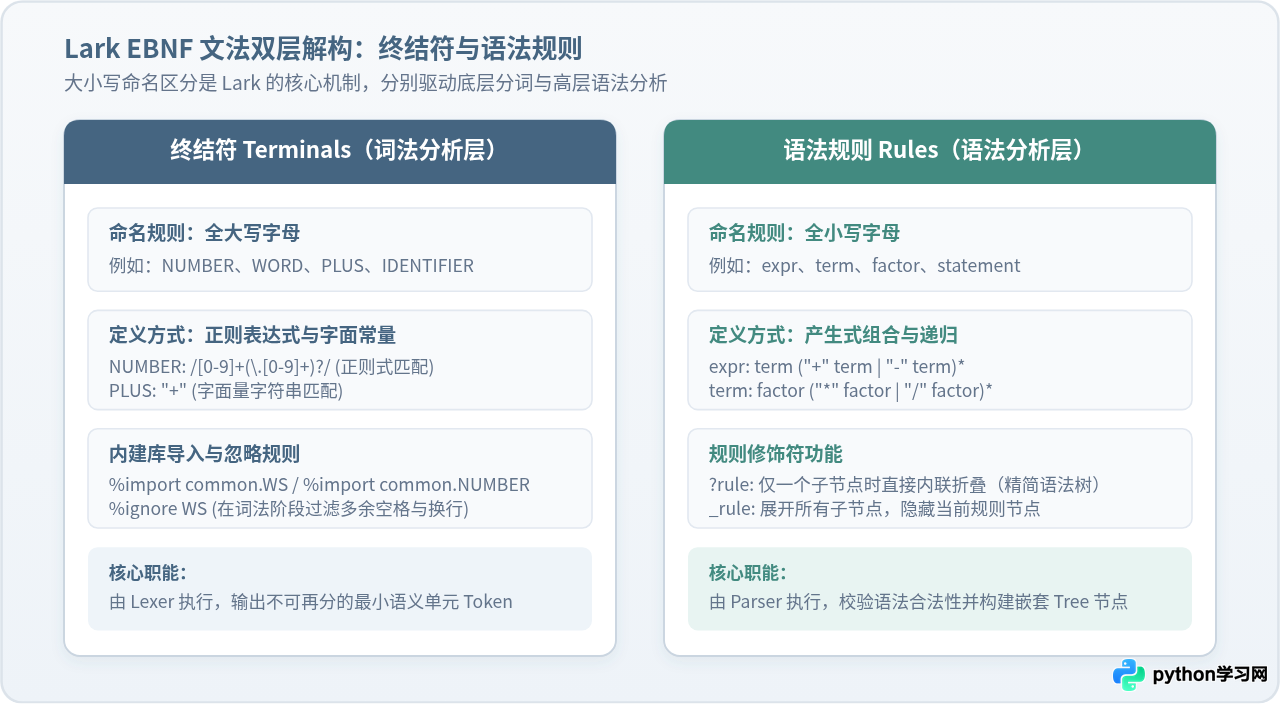
Lark 采用声明式文法规范。理解 Lark 文法设计的核心,在于掌握大小写命名区分这一黄金法则。在文法字符串中,大小写代表完全不同的解析层次与处理角色:
1. 终结符(Terminals):词法分析层
终结符的名称必须全部使用大写字母(例如 NUMBER、WORD、PLUS)。终结符由词法分析器(Lexer)执行,用于匹配输入文本中的不可再分的最小单元(Token)。
- 正则表达式定义:可以使用斜杠包裹正则表达式,例如
NUMBER: /[0-9]+(\.[0-9]+)?/。 - 字符串字面量定义:可以直接指定精确匹配的符号,例如
PLUS: "+"、EQ: "=="。 - 内置标准终结符:Lark 提供了常用的内建库,通过
%import common.NUMBER、%import common.CNAME可以直接复用标准词法规则。 - 忽略规则:在绝大多数文本和编程语言中,空格和换行不需要进入语法分析,使用
%ignore WS可在词法分析阶段自动丢弃空白符。
2. 语法规则(Rules):语法分析层
语法规则的名称必须全部使用小写字母(例如 expr、term、statement)。语法规则由语法分析器(Parser)执行,定义了如何将终结符和子规则拼接组合成复杂的嵌套结构。
- 序列与分支:使用空格表示顺序出现,使用竖线
|表示逻辑“或”,例如expr: term ("+" term | "-" term)*。 - 重复匹配修饰符:支持正则表达式风格的符号,
*表示匹配 0 次或多次,+表示匹配 1 次或多次,?表示可选(0 次或 1 次)。 - 规则内联修饰符(? 与 _):若在规则名前加问号(如
?expr: ...),当该规则匹配到的子节点只有一个时,Lark 会自动将该规则节点折叠剔除,避免在语法树中产生冗余的单子节点嵌套;前缀下划线(如_expr)则会完全隐藏当前规则节点并展开其所有子节点。
三、实战案例:从零构建四则运算解析树
为了具体展示从词法到语法树的生成过程,我们以支持加减乘除、括号运算以及浮点数的算术表达式解析器为例。在算术表达式中,乘除的优先级高于加减,括号的优先级最高。在 EBNF 中,通过分层递归结构能够天然表达运算优先级。
1. 完整解析代码示例
新建 Python 脚本 calc_parser.py,编写如下完整可执行代码:
from lark import Lark

# 定义四则运算 EBNF 文法
calc_grammar = """
    // 语法规则(小写):分层体现运算优先级
    expr: term (PLUS term | MINUS term)*
    term: factor (STAR factor | SLASH factor)*
    factor: NUMBER
          | LPAREN expr RPAREN

    // 终结符(大写):词法单元匹配
    PLUS: "+"
    MINUS: "-"
    STAR: "*"
    SLASH: "/"
    LPAREN: "("
    RPAREN: ")"

    // 导入内置数字与空白符规则,并配置忽略空白
    %import common.NUMBER
    %import common.WS
    %ignore WS
"""

# 实例化 Lark 解析器,指定入口规则为 expr,引擎为 lalr
parser = Lark(calc_grammar, start="expr", parser="lalr")

# 待解析的目标表达式
expression = "3 + 5 * 2"

# 执行词法分析与语法树构建
tree = parser.parse(expression)

# 输出语法分析树的文本结构
print(tree.pretty())
2. 语法树结构与运行输出
运行上述脚本后,在控制台可以观察到 tree.pretty() 输出的树状层次结构:
expr
  term
    factor
      3
  +
  term
    factor
      5
    *
    factor
      2
仔细分析这一输出结构可以发现:
- 整个结构的根节点是
expr。 - 左侧子项是经过
term包装的factor(数字 3)。 - 操作符
+是同级的一个 Token。 - 右侧子项是一个完整的
term节点,它内部包含了factor(5)、*和factor(2)。这意味着乘法计算被完整封装在右侧子树中,确保了其优先结合的正确语义。
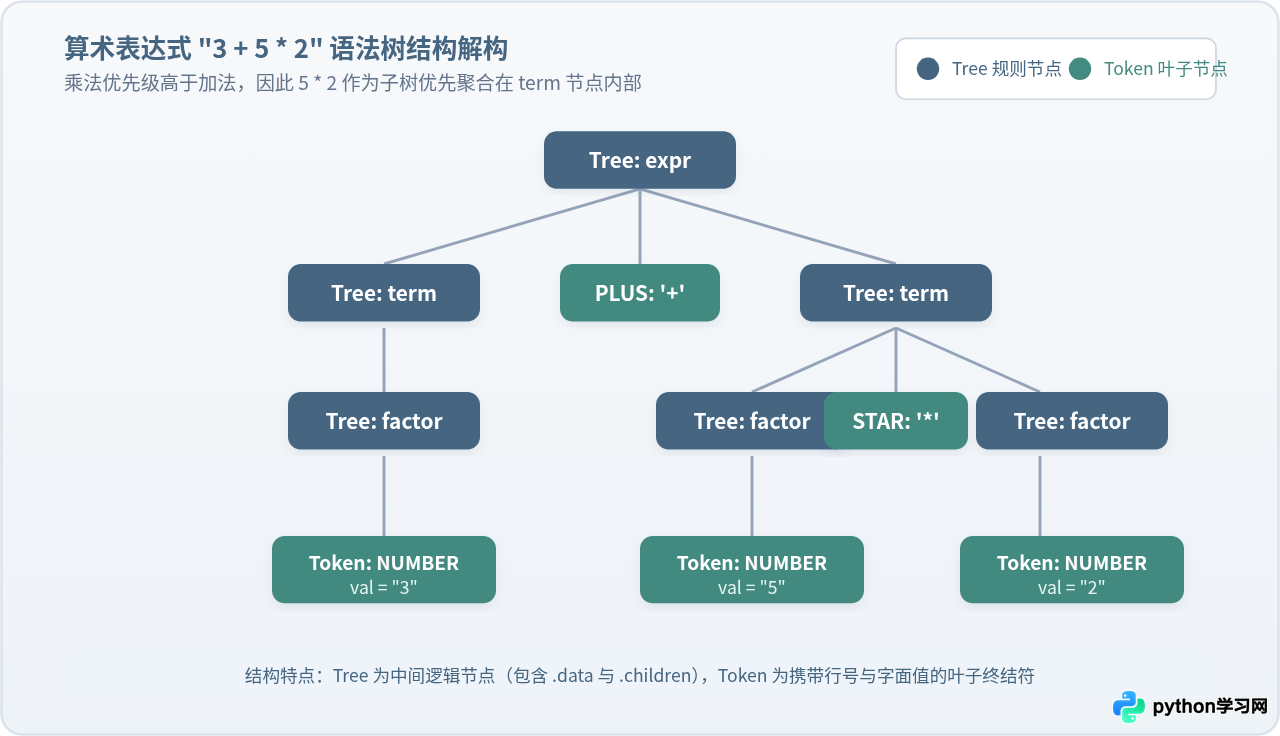
在 Lark 中,语法树由两种基本元素组成:Tree 是非终结节点(有 data 属性表示规则名称,有 children 列表保存子项);Token 是叶子终结符(继承自 Python 的 str,拥有 type 属性表示 Token 名称,以及字符在源文本中的行号 line、列号 column 等元数据)。
四、语法树的遍历与求值:使用 Transformer
生成语法树仅完成了结构验证。在实际应用中,我们通常需要计算出最终结果,或者将其转换为领域模型对象。如果直接通过递归函数遍历包含多层嵌套的 Tree,代码会充斥大量的类型检查。Lark 提供了 Transformer 机制,能够以自底向上(Bottom-Up)的方式自动收敛求值。
1. 规则别名与 Transformer 映射
为了让 Transformer 的方法更加直观,我们可以在文法规则的分支后添加 -> 别名。并且,通过在规则名前添加 ? 前缀,可以让单个子节点自动提升,简化树的层次。
创建 calc_eval.py,完整代码如下:
from lark import Lark, Transformer, v_args

# 采用带别名与折叠修饰符 ? 的文法
optimized_grammar = """
    ?start: expr

    ?expr: expr "+" term   -> add
         | expr "-" term   -> sub
         | term

    ?term: term "*" factor -> mul
         | term "/" factor -> div
         | factor

    ?factor: NUMBER        -> num
           | "(" expr ")"

    %import common.NUMBER
    %import common.WS
    %ignore WS
"""

# 定义 Transformer 求值器
@v_args(inline=True)  # inline=True 将 children 列表解构为函数的独立位置参数
class CalculateTree(Transformer):
    def num(self, token):
        return float(token)

    def add(self, a, b):
        return a + b

    def sub(self, a, b):
        return a - b

    def mul(self, a, b):
        return a * b

    def div(self, a, b):
        if b == 0:
            raise ZeroDivisionError("除数不能为零")
        return a / b

# 构造解析器
calc_parser = Lark(optimized_grammar, parser="lalr")

# 执行测试
test_cases = [
    "3 + 5 * 2",
    "(3 + 5) * 2",
    "100 / (2 + 3) * 4"
]

evaluator = CalculateTree()
for expr in test_cases:
    tree = calc_parser.parse(expr)
    result = evaluator.transform(tree)
    print(f"{expr} = {result}")
3 + 5 * 2 = 13.0
(3 + 5) * 2 = 16.0
100 / (2 + 3) * 4 = 80.0
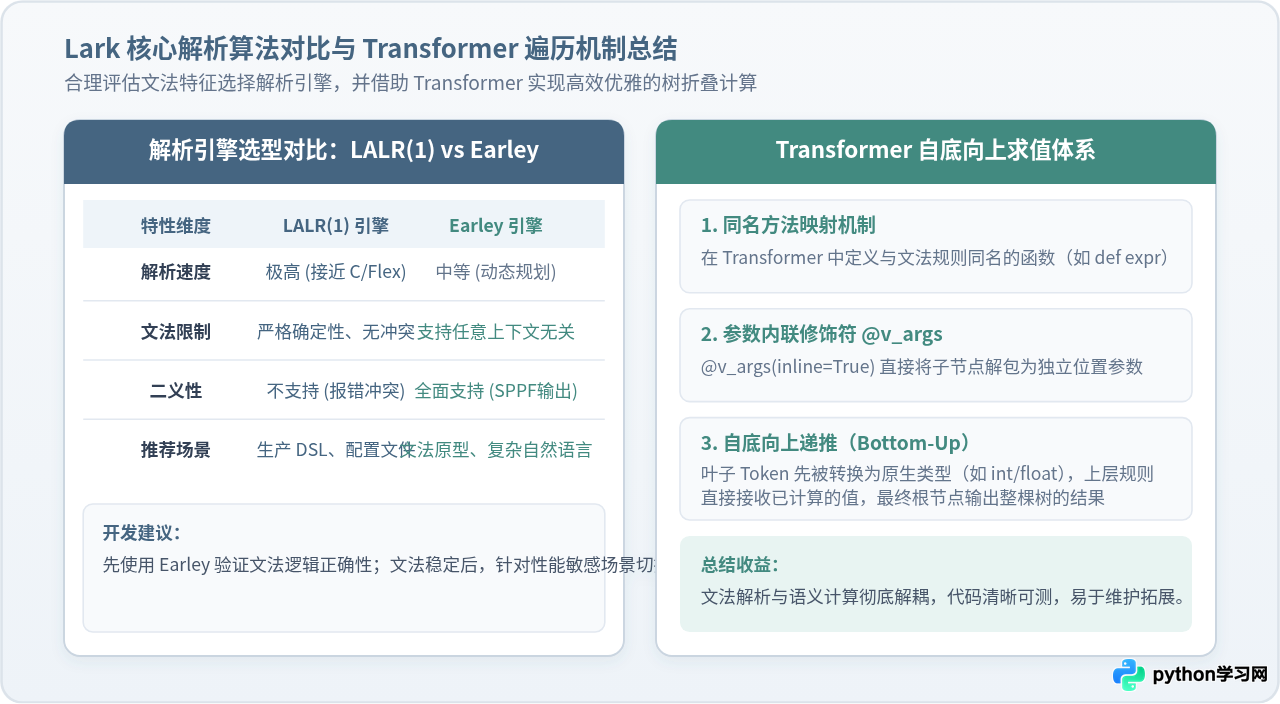
在求值器中,@v_args(inline=True) 扮演了关键角色。如果不加该装饰器,每个处理方法接收到的参数为一个列表 children;加上该装饰器后,子节点会自动解包为位置参数 a, b,使代码如同编写普通的代数运算函数一样清晰。
五、解析算法选择与常见避坑指南
Lark 提供了多种解析算法后端,最常用的是 lalr 和 earley。针对具体场景进行合理选型,是保证解析效率与文法正确性的前提。
| 特性维度 | LALR(1) 引擎 | Earley 引擎 |
|---|---|---|
| 解析性能 | 极快,线性时间复杂度 $O(n)$,内存占用低 | 中等,通用图表动态规划算法,复杂度 $O(n)$ 至 $O(n^3)$ |
| 文法兼容性 | 要求严格确定性文法,不能存在移进-归约或归约-归约冲突 | 能够解析任意上下文无关文法(CFG),支持左递归与二义性 |
| 词法分析策略 | 标准独立词法分析器(Standard Lexer)或上下文感知分析器 | 支持动态词法分析(Dynamic Lexer),分词可受当前语法状态引导 |
| 典型应用场景 | 生产级 DSL、配置解析器、数学公式求值等对吞吐要求高的系统 | 文法初期原型验证、自然语言处理、复杂或模糊语法的解析实验 |
常见错误排查与处理
-
UnexpectedCharacters异常:输入文本中出现了词法分析器未能匹配的字符。通常是因为缺少忽略规则(例如未设置%ignore WS)导致回车空格报错,或者终结符正则表达式未覆盖特殊符号。 -
UnexpectedToken异常:词法分析成功切分了 Token,但 Token 出现的顺序不符合语法规则。请检查语法规则分支中操作符与表达式的顺序。 -
LALR 移进-归约冲突(Shift/Reduce Conflict):当使用
parser='lalr'时,若文法规则存在二义性(例如同时允许expr: expr "+" expr而没有指定左结合优先级),LALR 会无法判定如何归约。解决办法是分层定义语法(如同本文中的expr -> term -> factor),或者临时切换为parser='earley'观察生成的完整树结构。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















