


怎么将扁平列表转换为Python一键多值字典
详细讲解如何将Python扁平列表转换为一键多值字典,涵盖defaultdict与setdefault的核心用法、成对交替列表与属性分组等常见场景及避坑指南。
collections.defaultdict(list),若在无法引入外部模块的轻量场景下,则可使用原生字典的 dict.setdefault() 方法。依据扁平列表的具体排列格式(如奇偶成对交替或基于特定特征归类),配合步长切片或特征函数提取键名,即可快速完成数据结构的重新规整。
一、认识数据转换的核心目标与场景
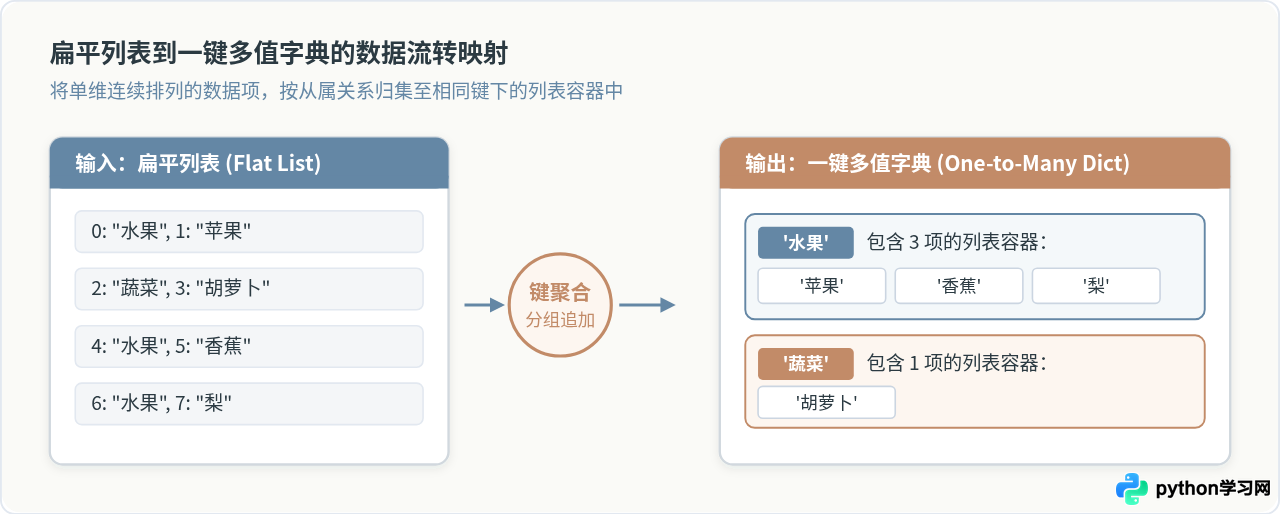
在日常开发与数据处理任务中,我们经常会接收到“扁平结构”的列表数据。所谓扁平列表,是指元素直接在一维列表中平铺展开,没有内嵌的分组层级。根据业务来源不同,主要表现为以下两种常见形态:
- 奇偶成对交替列表:列表元素按“键、值、键、值”依次连续排布,例如
['水果', '苹果', '蔬菜', '胡萝卜', '水果', '香蕉', '水果', '梨']。同一键名会在不同位置重复出现。 - 单值列表按属性归类:列表中仅包含基础数据项(如单词、数字或对象),需要根据某种属性规则(例如单词长度、首字母、取模结果)将它们归集为具有共同分类的字典。
而“一键多值字典(Multidict)”,是指字典中的每个键不再对应单一标量值,而是对应一个可扩展的容器对象(最常见为列表 list 或集合 set),如 {'水果': ['苹果', '香蕉', '梨'], '蔬菜': ['胡萝卜']}。转换的关键是在遇到重复键时将新值追加进已有容器,而不是覆盖旧值。
二、核心操作步骤与标准执行流程
无论扁平列表的来源是什么,将其转换为一键多值字典的操作均遵循一套严谨的逻辑流程:提取键值对、检查键容器状态、追加元素并完成迭代。
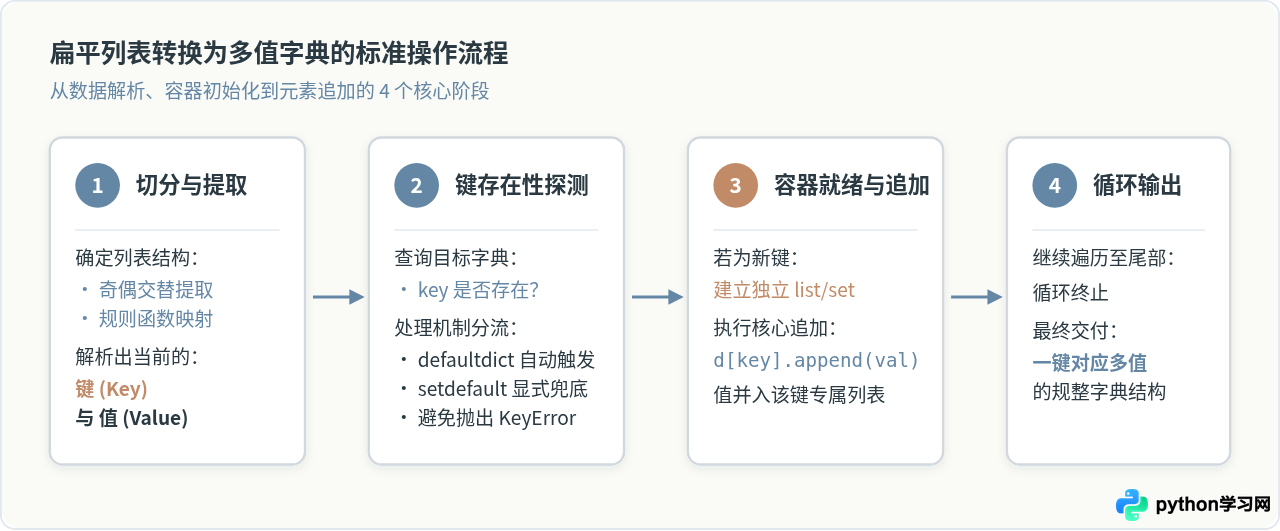
整个处理过程分为四个阶段:
- 切分与提取:通过索引步长或者迭代器,将连续的扁平元素解构为当前的键(Key)和对应的值(Value)。
- 键存在性探测:判断目标字典中是否已有该键。如果直接使用普通字典取值追加,未初始化的键会引发
KeyError异常。 - 容器初始化与追加:新键分配专属的空列表容器,已有键则直接定位已有容器,通过
append()将当前值追加进容器末尾。 - 循环输出:完成整个列表的遍历后,返回完整的聚合字典。
三、推荐方案:使用 collections.defaultdict
在 Python 中构建一键多值字典,最推荐的方式是利用标准库 collections 中的 defaultdict。它在内部继承自原生字典,当访问不存在的键时,会自动调用预设的工厂函数(此处为 list)来为该键初始化一个空列表,免去了手动判断的繁琐分支。
代码示例:处理交替出现的成对扁平列表
from collections import defaultdict

# 示例输入:奇数索引为键,偶数紧邻项为值的扁平列表
flat_list = ['水果', '苹果', '蔬菜', '胡萝卜', '水果', '香蕉', '水果', '梨', '蔬菜', '西红柿']

# 初始化 defaultdict,指定列表工厂 list
multi_dict = defaultdict(list)

# 步长为 2 遍历列表,同时提取键与值
for i in range(0, len(flat_list), 2):
    key = flat_list[i]
    val = flat_list[i + 1]
    multi_dict[key].append(val)

# 输出结果
print(dict(multi_dict))
示例输出:
{'水果': ['苹果', '香蕉', '梨'], '蔬菜': ['胡萝卜', '西红柿']}这种写法不仅代码语义非常清晰,而且由于键不存在时的默认创建是在底层 C 扩展中完成的,运行效率明显优于在 Python 层面反复执行条件判断。
四、原生方案:使用 dict.setdefault()
如果当前开发环境受限,不允许引入额外的模块,或者代码属于极简脚本,可以直接使用 Python 原生字典自带的 setdefault() 方法。
dict.setdefault(key, default) 的工作机制是:检查字典中是否存在指定的 key;如果存在,直接返回其当前对应的值;如果不存在,则将 key: default 插入字典,并返回该 default 对象的引用。由于返回的是容器对象的内存引用,紧接着在其后链式调用 .append(val) 即可完成归类。
代码示例:使用 setdefault 实现相同转换
flat_list = ['A', 1, 'B', 2, 'A', 3, 'B', 4, 'C', 5]
result_dict = {}

for i in range(0, len(flat_list), 2):
    k = flat_list[i]
    v = flat_list[i + 1]
    # 如果 k 不存在则建立空列表并返回引用,随后追加值
    result_dict.setdefault(k, []).append(v)

print(result_dict)
示例输出:
{'A': [1, 3], 'B': [2, 4], 'C': [5]}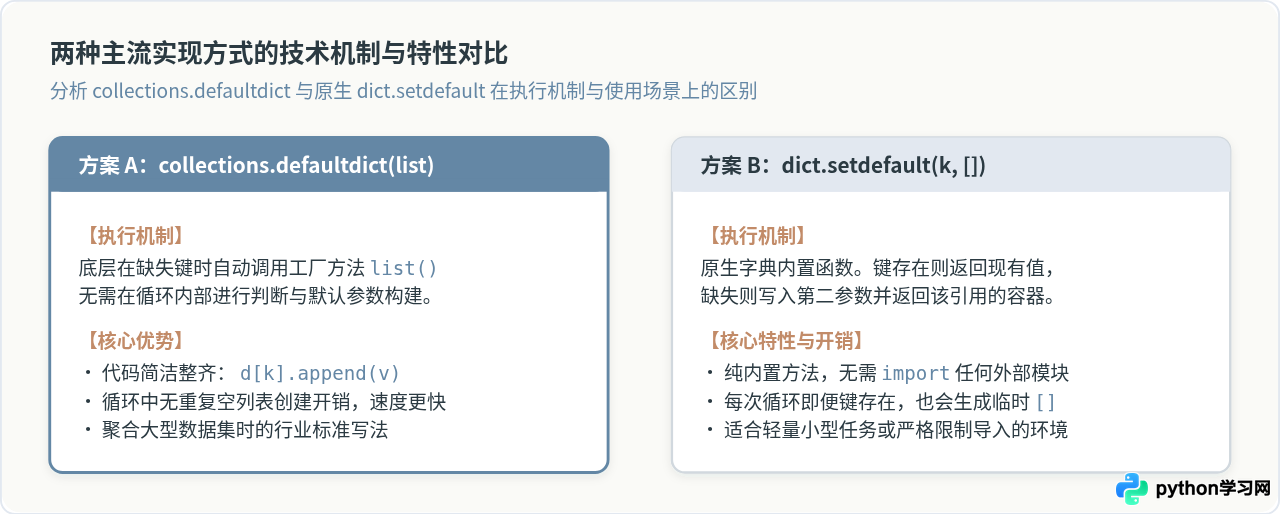
注意:在调用 dict.setdefault(k, []) 时,Python 解释器在求值参数阶段,每次循环都会在内存中创建一个新的空列表对象 []。即便目标键 k 已经存在,这个刚刚生成的空列表也会立即被当作无用参数丢弃,并等待垃圾回收。因此在处理数十万级别的大规模扁平列表时,collections.defaultdict 的性能优势会更加突出。
五、不同列表组织形态的高效处理技巧
在实际编码中,扁平列表的数据结构不尽相同,需要搭配适当的解构策略:
1. 使用 zip 与迭代器解构交替列表
除了使用步长索引 range(0, len(lst), 2),还可以借助迭代器实现更具 Pythonic 风格的成对切分:
from collections import defaultdict

raw_data = ['语文', 92, '数学', 98, '英语', 88, '数学', 95, '语文', 89]

d = defaultdict(list)
# 将列表转为迭代器,并使用 zip 将其按 2 个一组解包
it = iter(raw_data)
for k, v in zip(it, it):
    d[k].append(v)

print(dict(d))
# 示例输出: {'语文': [92, 89], '数学': [98, 95], '英语': [88]}
2. 单值扁平列表按特征属性归类
若扁平列表中仅存储单一实体,需要按照元素的某个衍生属性(例如字符串首字母或长度)进行聚合:
from collections import defaultdict

words = ['apple', 'banana', 'apricot', 'blueberry', 'cherry', 'avocado']

# 按首字母归类成多值字典
grouped = defaultdict(list)
for w in words:
    initial = w[0].upper()
    grouped[initial].append(w)

print(dict(grouped))
# 示例输出: {'A': ['apple', 'apricot', 'avocado'], 'B': ['banana', 'blueberry'], 'C': ['cherry']}
3. 需要自动去重的场景:使用 set 容器
若同一键下的值存在重复且业务上只需要保留唯一项,只需将容器类型由 list 改为 set,追加方法相应地由 append() 改为 add():
from collections import defaultdict

data = ['A', 1, 'A', 2, 'A', 1, 'B', 3]
unique_dict = defaultdict(set)

it = iter(data)
for k, v in zip(it, it):
    unique_dict[k].add(v)

print(dict(unique_dict))
# 示例输出: {'A': {1, 2}, 'B': {3}}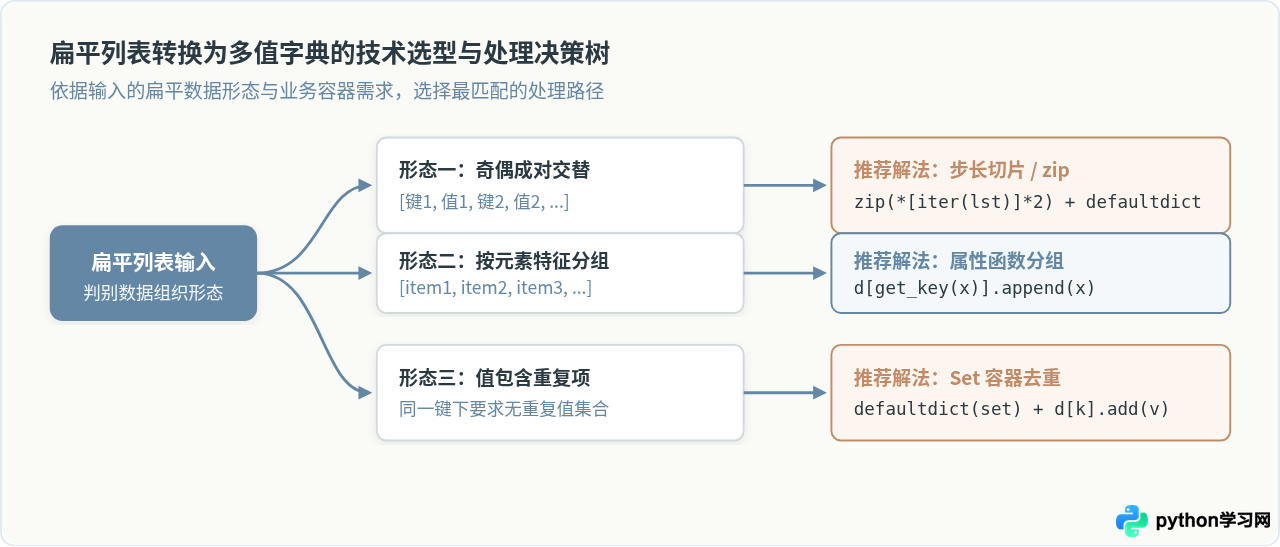
六、常见错误与注意事项
陷阱一:误用 dict.fromkeys() 导致多键共享列表引用
初学者容易尝试先提取所有去重键,然后用 dict.fromkeys(keys, []) 初始化字典。这是 Python 中极为经典的引用陷阱:所有键所绑定的其实是同一个列表对象在内存中的地址,修改其中任意一个键对应的列表,其他所有键的值都会同步变化。
# 错误示范:切勿使用!
keys = ['A', 'B']
bad_dict = dict.fromkeys(keys, [])
bad_dict['A'].append(100)
print(bad_dict)
# 错误输出: {'A': [100], 'B': [100]} -> 'B' 也被意外修改
务必保证每个键在初始化时,都独立调用一次构造函数生成全新的列表实例。
陷阱二:奇数长度扁平列表的边界越界
当交替成对列表由于缺失字段导致总长度为奇数时,使用 range(0, len(lst), 2) 访问 lst[i + 1] 会抛出 IndexError: list index out of range。处理不可靠外部输入时,建议在切分前校验列表长度,或采用 zip(it, it),后者会自动丢弃末尾不成对的残缺元素,保证程序稳定运行。
七、总结与选型建议
将扁平列表转换为 Python 一键多值字典的核心是分离提取逻辑与分组容器维护:
- 日常开发首选
collections.defaultdict(list),语法干净、意图明确且执行效率最优。 - 轻量脚本或受限环境选用原生
dict.setdefault(k, []).append(v),免导包且通用性强。 - 成对交替的扁平结构,推荐搭配
it = iter(lst); zip(it, it)进行优雅解包。 - 若需要自动过滤重复值,将多值容器由
list调整为set即可。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















