


Python 3代码中直接输入和打印中文的方法
详细讲解Python 3代码中直接输入和打印中文的方法,深入剖析UTF-8与Unicode底层机制,对比Python 2的差异,并提供终端环境配置与乱码排查全流程指南。
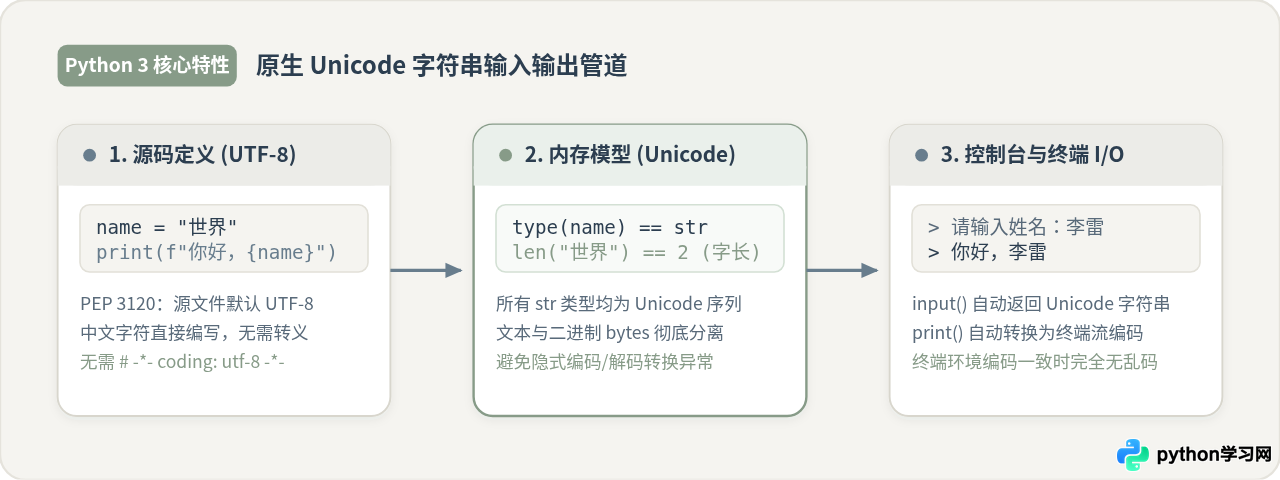
在 Python 3 中,直接输入与打印中文字符不需要像历史版本那样配置编码声明或进行复杂的转码。由于 Python 3 源码文件默认采用 UTF-8 编码,并且语言内置的 str 字符串类型原生即为 Unicode 序列,开发者可以在代码中直接使用 print() 输出汉字,或通过 input() 接收控制台的中文输入。本文将完整介绍直接处理中文的具体代码写法、核心操作流程、Python 3 与早期版本的关键机制差异,以及出现终端乱码时的定位与解决方法。
一、直接打印与输入的标准代码实现
在 Python 3 中,中文字符串与其他任何文本字符的地位完全相同。无需引入任何第三方模块,直接调用内建的 print() 与 input() 函数即可完成操作。
1. 直接打印中文字符串
可以直接在 print() 函数中传入中文常量,也可以将中文字符串赋值给变量后输出,或使用 f-string(格式化字符串字面量)进行拼接:
# 示例代码:直接打印中文
greeting = "世界"
year = 2026

# 1. 直接输出中文常量
print("你好,Python 3!")

# 2. 结合变量与格式化字符串输出
print(f"欢迎来到中文编程环境,{greeting}!当前年份:{year}")

# 3. 打印包含中文的多行文本
multiline_text = '''这是第一行中文内容。
这是第二行中文内容,格式保持原样。'''
print(multiline_text)欢迎来到中文编程环境,世界!当前年份:2026
这是第一行中文内容。
这是第二行中文内容,格式保持原样。
2. 直接接收控制台的中文输入
使用 input() 函数时,提示信息可以直接包含中文,用户在终端输入的汉字也会直接被解析为标准的 Unicode str 对象,无需任何反序列化或 decode() 操作:
# 示例代码:交互式中文输入与输出
user_name = input("请输入您的姓名:")
user_city = input("请输入您所在的城市:")

print(f"你好,{user_name}!很高兴认识来自{user_city}的朋友。")

# 验证输入内容的字符长度与数据类型
print(f"姓名长度(字数):{len(user_name)},数据类型:{type(user_name)}")请输入您所在的城市:北京
你好,李雷!很高兴认识来自北京的朋友。
姓名长度(字数):2,数据类型:<class 'str'>
从上述运行结果可以看出,len("李雷") 准确返回数值 2,表明 Python 3 准确按字符(人类直觉上的字数)而非底层存储的字节数来处理中文字符串。
二、操作步骤与标准开发流程
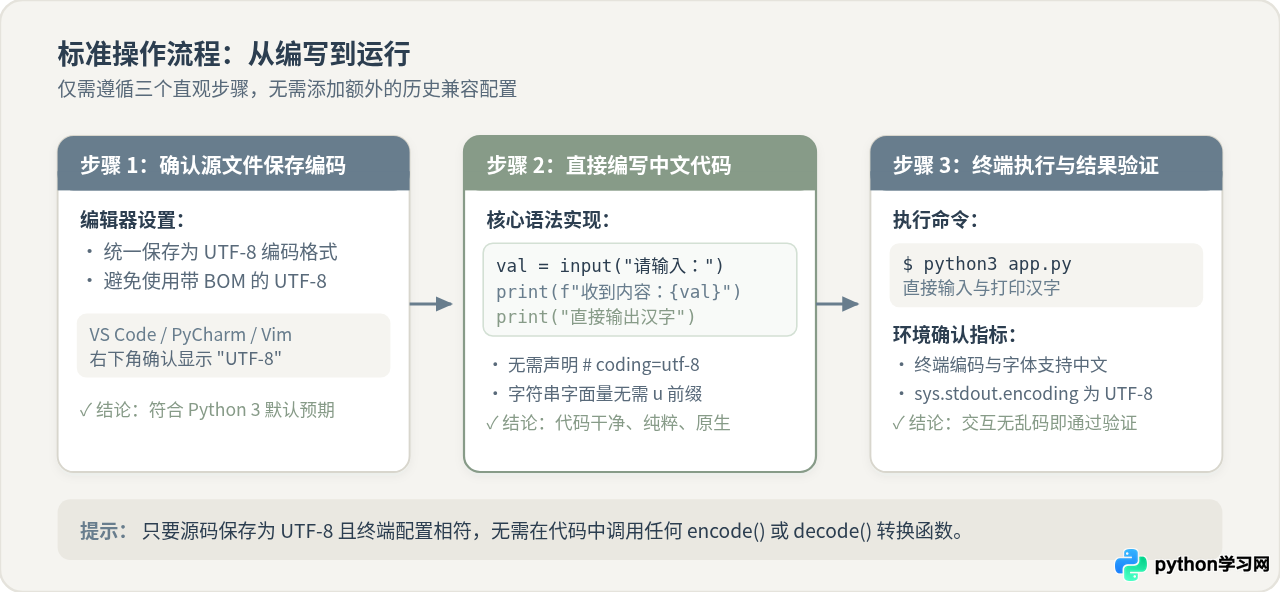
要在项目中顺利运行包含中文的代码,仅需遵循清晰的三个操作步骤。开发的核心要求是让“文件编码”与“Python 解释器预期”保持一致。
-
步骤 1:确认源文件保存编码为 UTF-8
在主流代码编辑器(如 Visual Studio Code、PyCharm、Sublime Text 或 Vim)中,新建的.py文件默认均保存为 UTF-8 编码。在编辑器底部状态栏可以确认编码状态。务必保存为标准 UTF-8(无 BOM),不要使用 Windows 记事本附带 BOM 的特殊 UTF-8 格式。 -
步骤 2:直接编写中文业务逻辑
如第一节所示,无需在代码顶部写任何编码提示行,直接书写中文变量内容、提示词或注释即可。 -
步骤 3:在终端执行并验证输出
在系统终端或 IDE 内置控制台中执行命令python3 your_script.py。终端将直接输出预期的汉字。
三、核心机制:Python 3 与 Python 2 的本质差异
理解为什么 Python 3 可以“直接”处理中文,关键在于对比 Python 2 与 Python 3 在字符串模型上的架构重构。许多关于中文编码的旧习惯(如在文件头部写编码声明)正是从 Python 2 遗留下来的。
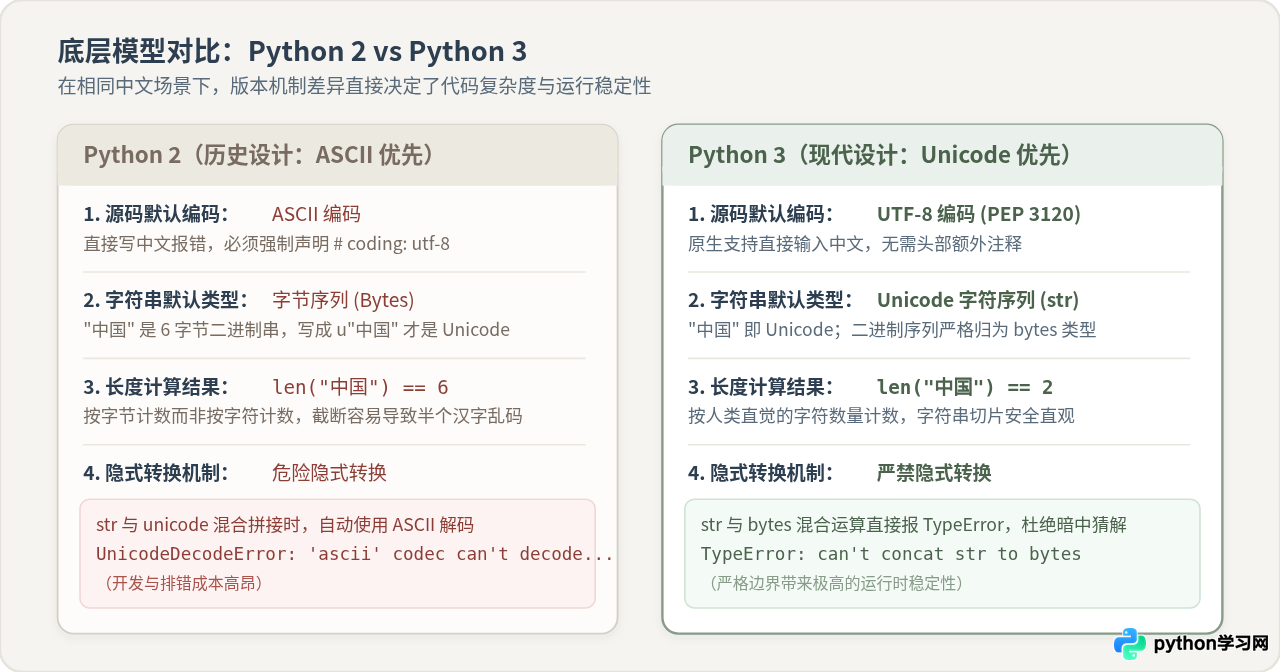
在一致的中文处理场景下,两个版本存在以下四项关键差异,这些差异决定了为什么 Python 3 能够摆脱乱码困扰:
| 对比维度 | Python 2(已淘汰历史方案) | Python 3(现代标准方案) | 机制差异对开发的影响 |
|---|---|---|---|
| 源文件默认编码 | ASCII 编码 | UTF-8 编码 (PEP 3120) | Python 2 遇到中文直接报语法错误,必须写头部注释;Python 3 原生默认识别,头部无需任何额外代码。 |
| str 数据类型 | 底层字节流 (Bytes) | Unicode 抽象字符序列 | Python 2 中 "中国" 实为 6 字节二进制串,必须显式写 u"中国";Python 3 所有字面量天然就是 Unicode。 |
| 字符长度计算 | len("中国") == 6(按字节) |
len("中国") == 2(按字数) |
Python 3 切片与长度运算符合人类直觉,不会发生中文字符被截断为“半个汉字”而损坏文本的情况。 |
| 类型混合运算 | 隐式 ASCII 自动解码 | 严禁隐式转换,抛出 TypeError | Python 2 会在隐式转换失败时随机抛出 UnicodeDecodeError;Python 3 划分清晰边界,杜绝不可控的隐式转换。 |
# -*- coding: utf-8 -*-?根据 Python 官方规范 PEP 3120,Python 3 的默认源码编码被永久指定为 UTF-8。除非你特意使用非 UTF-8 格式(例如 GBK 或 Big5)保存
.py 文件,否则这行声明在 Python 3 中完全是多余的。直接省略它,代码依然百分之百正常运行。
四、常见问题排查:终端中文乱码与解决方案
当代码按照标准规范编写后,如果运行仍然出现乱码或抛出 UnicodeEncodeError,问题几乎全部出在外部环境配置上,而非 Python 代码本身。
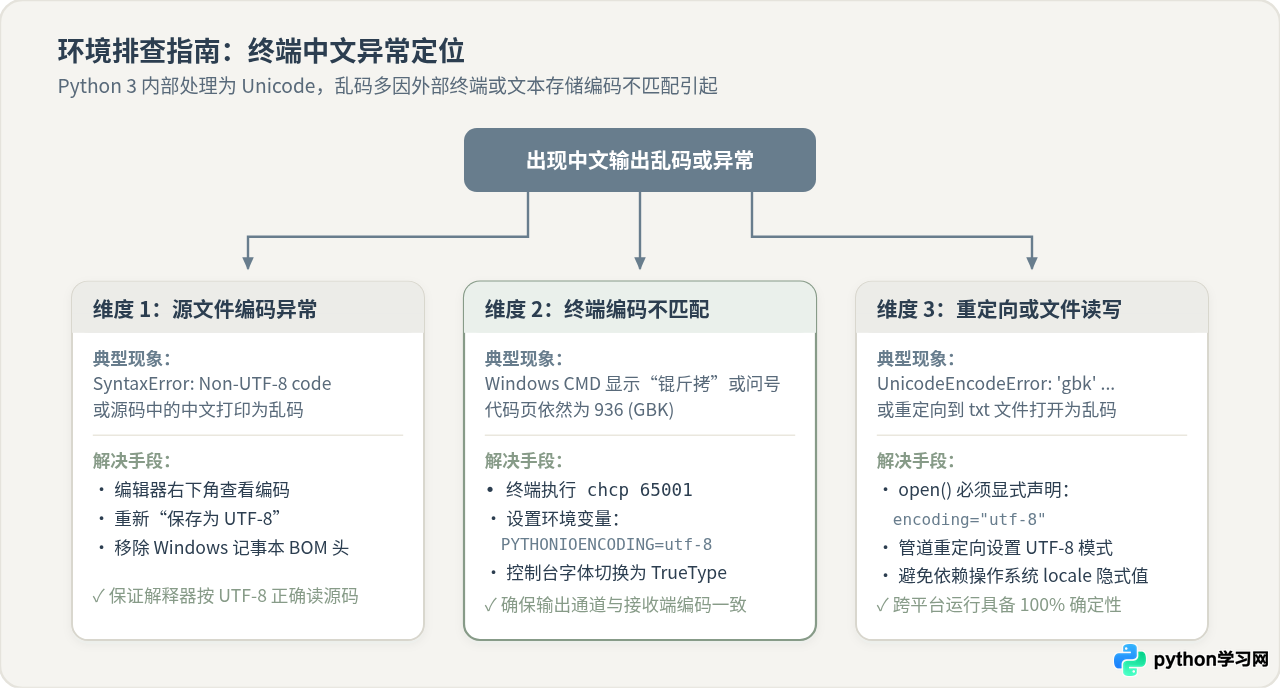
1. Windows 命令提示符(CMD)出现乱码或“锟斤拷”
原因:传统 Windows CMD 的默认代码页通常是 936(GBK 编码),当 Python 输出 UTF-8 编码的 Unicode 文本而控制台未正确协商代码页时,会导致字符映射混乱。
解决步骤:
- 在 CMD 窗口中运行命令:
chcp 65001,将当前终端代码页切换为 UTF-8。 - 推荐使用现代的 Windows Terminal,其默认全面支持 UTF-8 与完整中文字体渲染。
- 若程序需要以脚本自动化运行,可在系统环境变量中添加
PYTHONIOENCODING=utf-8,强制 Python 将标准输入输出流的编码指定为 UTF-8。
2. Linux / macOS 终端异常或提示编码不支持
原因:在极简 Docker 镜像或未初始化的服务器环境中,系统的 LANG 环境变量可能被默认配置为 POSIX 或 C,导致系统终端没有 UTF-8 区域设置。
解决步骤:在终端中执行 locale 命令检查当前语言环境。若发现非 UTF-8,可在 ~/.bashrc 或 ~/.zshrc 中加入:
export LANG=en_US.UTF-8
export LC_ALL=en_US.UTF-8
3. 重定向到文件时报 UnicodeEncodeError: 'gbk' codec can't encode...
原因:在某些 Windows 环境下,直接在终端打印正常,但执行 python app.py > output.txt 重定向时报错。这是因为重定向脱离了控制台接口,Python 会退回到操作系统默认的 ANSI 编码(中文 Windows 下为 GBK)。
解决步骤:在执行命令前设置环境变量 set PYTHONIOENCODING=utf-8,或在 Python 3.7+ 中使用 UTF-8 模式标志运行:
# 启用 Python 原生 UTF-8 模式运行脚本
python -X utf8 your_script.py > output.txt
五、扩展实用技巧:中文文件与数据的协同处理
在掌握直接输入和打印中文的基础上,实际开发中通常还会伴随文件保存与 JSON 序列化需求。为了让整套系统完全不出现乱码,需注意以下两个高频场景。
1. 中文文本文件保存:显式声明 encoding="utf-8"
在代码中读取或写入包含中文的文本文件时,务必在 open() 函数中显式传入 encoding="utf-8" 参数:
# 正确规范:显式指定 UTF-8 编码
content = "这是需要持久化保存的中文文本内容。"

# 写入文件
with open("data.txt", "w", encoding="utf-8") as f:
    f.write(content)

# 读取文件并直接打印
with open("data.txt", "r", encoding="utf-8") as f:
    read_text = f.read()
    print(f"成功读取文件内容:{read_text}")
如果省略 encoding="utf-8",Python 会调用系统平台默认编码(Windows 下为 GBK),导致同一份代码在 macOS/Linux 上正常而在 Windows 上读写乱码。显式传参能够彻底消除平台差异。
2. JSON 格式化输出中文字符
默认情况下,json.dumps() 会将所有非 ASCII 字符转义为形如 \u4e2d\u6587 的 Unicode 转义序列。如果希望在终端打印或保存时直接呈现可读汉字,必须将 ensure_ascii 设置为 False:
import json

user_info = {"姓名": "张三", "职业": "工程师", "城市": "杭州"}

# 默认会转义为 \u 编码
print("默认 dumps 输出:", json.dumps(user_info))

# 正确做法:设置 ensure_ascii=False
print("直接中文输出:", json.dumps(user_info, ensure_ascii=False, indent=2))直接中文输出:{
"姓名": "张三",
"职业": "工程师",
"城市": "杭州"
}
六、全流程规范清单
归纳总结 Python 3 在中文输入、处理与打印方面的核心规范,开发者在日常编码中只需对照以下四项清单:
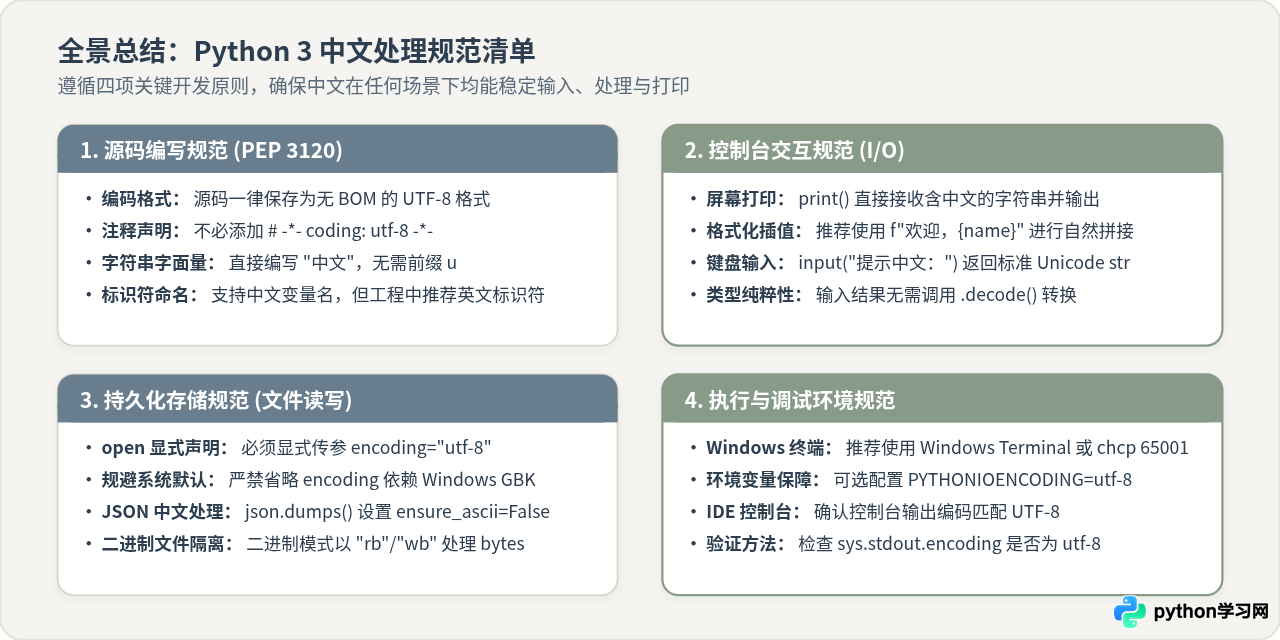
总结而言,Python 3 对中文的支持是原生且透明的。只要保证源文件存储为 UTF-8、涉及文件读写时显式指定 encoding='utf-8',并在终端层面保持 UTF-8 支持,就可以像处理纯英文字符一样,直接、自然地在 Python 3 中进行一切中文输入与输出。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















