


Python 3中UTF-8与GBK编码转换的bytes和str区别

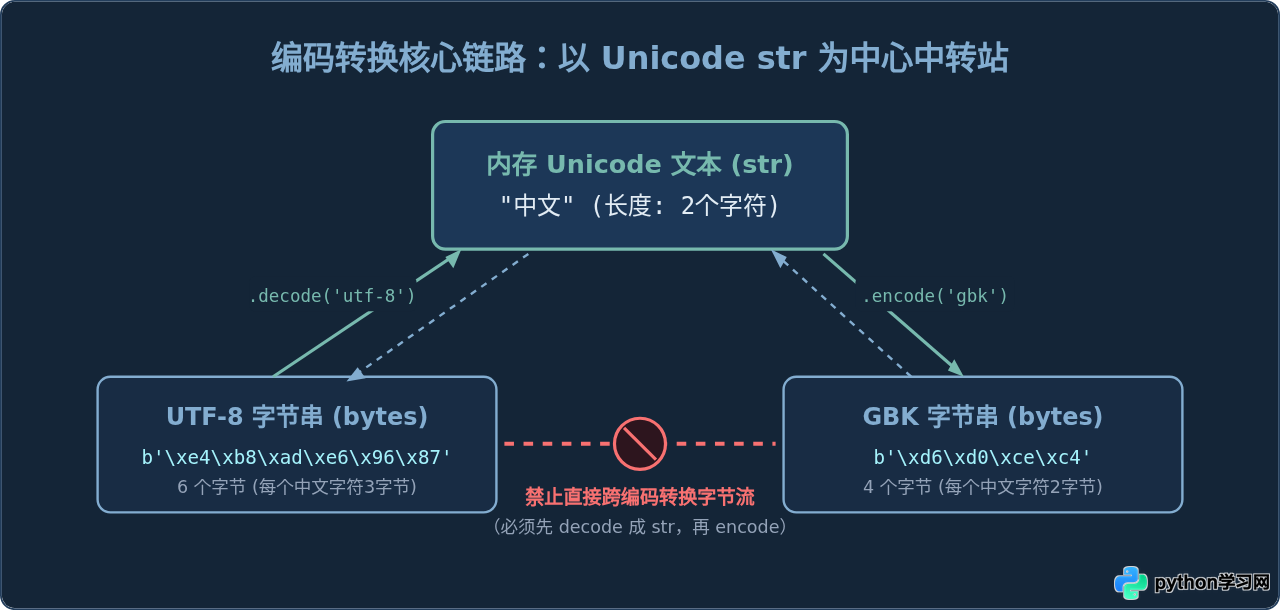
在处理旧系统导出文件、Windows 控制台交互或第三方接口对接时,经常会遇到中文显示为“锟斤拷”或抛出 UnicodeDecodeError 的情况。这类问题的根源,往往在于混淆了 Python 3 中 str 与 bytes 的职责,以及试图直接在不同编码的二进制字节流之间进行转换。Python 3 从语言核心层面将“抽象文本”与“物理存储的字节”彻底拆分开来:任何两种编码(如 UTF-8 与 GBK)之间的转换,都无法跳过 str 直接完成,必须遵循 字节流 (UTF-8) → 解码为 str → 重新编码为字节流 (GBK) 的完整闭环。
一、str 与 bytes 的本质区别:抽象文本与底层字节
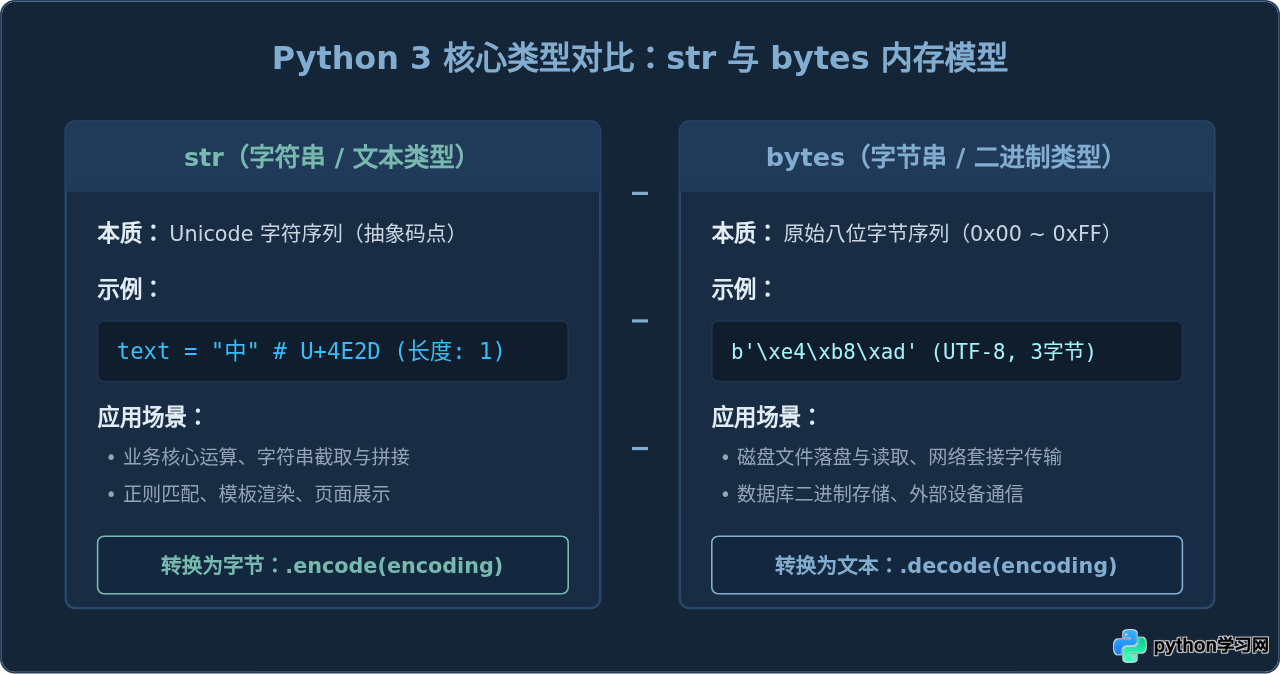
在 Python 2 时代,str 实际上是字节串,文本与字节混用导致了大量隐晦的编码异常。Python 3 对此进行了彻底重构,确立了清晰的二元类型系统:
str(字符串):在 Python 3 中,str代表内存中的 Unicode 字符序列。它是纯粹的抽象符号,不绑定任何具体的存储格式或物理编码方式(例如它既不是 UTF-8 也不是 GBK)。当你写下s = '中文'时,Python 关心的是字符“中”和“文”这两个 Unicode 码点(Codepoints),用户无需关心它在内存底层用几个字节存储。bytes(字节串):代表原始的 8 位(octet)二进制序列,取值范围在0~255之间。无论是保存在磁盘文件中的内容、通过网络 Socket 发送的数据包,还是图片、音频等二进制资源,在 Python 中都以bytes形式存在。当写下b'\xe4\xb8\xad\xe6\x96\x87'时,它是一组不可读的底层十六进制字节。
简而言之:str 是人类阅读和逻辑处理的文本,而 bytes 是计算机存储和网络传输的介质。它们之间不存在隐式自动转换,不能直接进行拼接操作(例如 'a' + b'b' 会直接抛出 TypeError)。
二、UTF-8 与 GBK 的编码规则差异与中转机制
既然 str 是纯粹的抽象字符,那么同一个字符“中”是如何变成不同的 bytes 的?这就是字符编码方案(Encoding)的作用。
| 对比维度 | UTF-8 编码方案 | GBK 编码方案 |
|---|---|---|
| 字符集范围 | 全球统一 Unicode 字符集(收录几乎所有语言与符号) | 针对简繁体汉字、日韩汉字及 ASCII 的国家标准扩展 |
| 编码长度 | 变长(1 到 4 个字节);英文字符 1 字节,常用汉字 3 字节 | 双字节变长;英文字符 1 字节,汉字固定 2 字节 |
| “中”对应字节 | b'\xe4\xb8\xad'(3 个字节) |
b'\xd6\xd0'(2 个字节) |
| 直接互转可行性 | 无法直接互转!规则完全不同,字节无法一一映射 | |
很多初学者常犯的一个错误是试图通过简单替换或强制类型转换,将一个 UTF-8 的 bytes 直接“转”为 GBK 的 bytes。由于这两种编码的码表结构、字节长度和位标记完全不同,任何跨编码转换都必须以内存中的 Unicode str 作为唯一的桥梁。
三、编码转换的具体操作步骤与代码实现
在实际工程中,将 UTF-8 编码的字节数据转换为 GBK 编码(或反之),需要严格按照“解码(decode) → 编码(encode)”两步完成。
1. 场景一:纯内存变量的转换操作
假设从外部接口或旧数据源中读取到了一段 UTF-8 编码的 bytes 数据,目标是输出给仅支持 GBK 编码的硬件设备:
# 1. 假设这是接收到的 UTF-8 字节流(6 字节)
utf8_bytes = b'\xe4\xb8\xad\xe6\x96\x87'

# 2. 第一步:使用正确的源编码将 bytes 解码为内存 Unicode str
text_str = utf8_bytes.decode('utf-8')
print(f"解码后的文本: {text_str}, 类型: {type(text_str)}")
# 示例输出: 解码后的文本: 中文, 类型: <class 'str'>

# 3. 第二步:将 Unicode str 重新编码为目标编码 GBK 的 bytes
gbk_bytes = text_str.encode('gbk')
print(f"转换后的 GBK 字节流: {gbk_bytes}, 类型: {type(gbk_bytes)}")
# 示例输出: 转换后的 GBK 字节流: b'\xd6\xd0\xce\xc4', 类型: <class 'bytes'>
2. 场景二:文件层面的编码转换(GBK 转换至 UTF-8)
在 Windows 环境下,许多历史遗留的 CSV 文件或日志文件是 GBK(或 ANSI)编码。若要在现代服务中统一以 UTF-8 归档,推荐通过 Python 的上下文管理器进行流式转换:
# 将 gbk_input.txt 读取并保存为 utf8_output.txt
src_path = "legacy_gbk.txt"
dst_path = "converted_utf8.txt"

# 读取端显式声明 encoding='gbk',Python 自动在边界将 bytes 转为 str
with open(src_path, 'r', encoding='gbk') as f_in:
    content = f_in.read()  # 此时 content 是纯粹的 Unicode str

# 写入端显式声明 encoding='utf-8',Python 自动在边界将 str 编码为 UTF-8 bytes
with open(dst_path, 'w', encoding='utf-8') as f_out:
    f_out.write(content)

print("文件编码转换完成")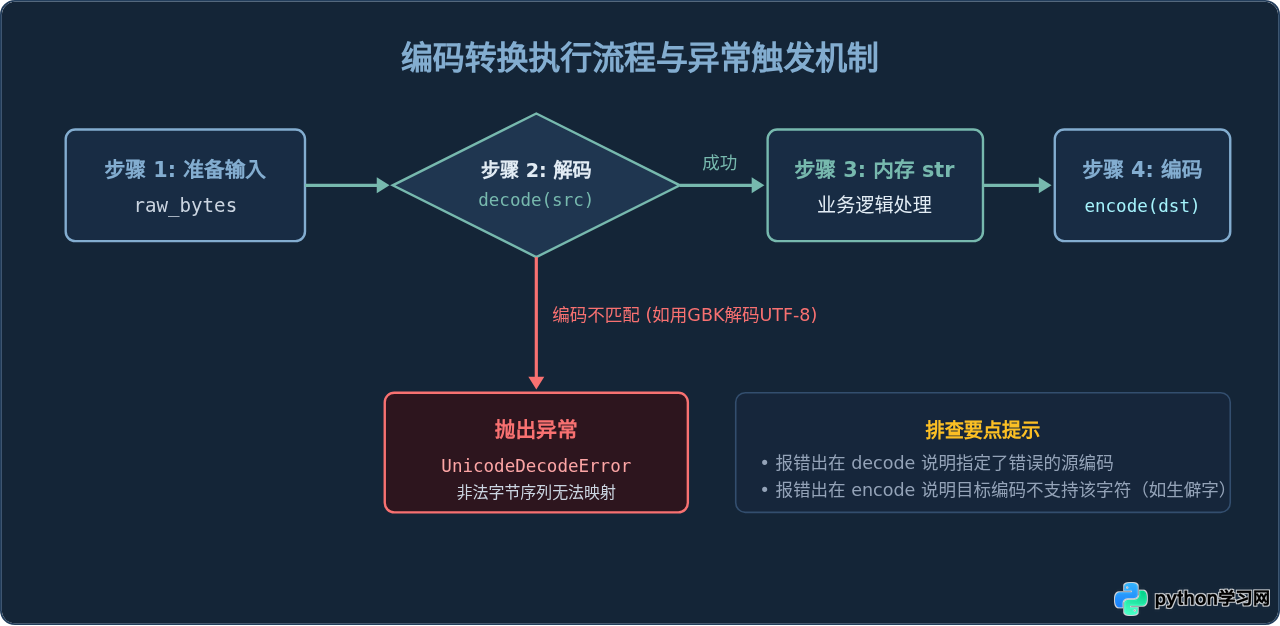
四、常见陷阱与异常处理策略
1. 混淆解码与编码方向
最容易引起混淆的是两个方法名的含义:
decode(解码):只属于bytes对象。意思是“按照某种规则,把物理字节解密成人类能懂的文本字符”。encode(编码):只属于str对象。意思是“按照某种规则,把内存中的文本符号打包编译成计算机能存储的物理字节”。
在 Python 3 中,对 str 调用 .decode() 或对 bytes 调用 .encode() 都会直接报 AttributeError。
2. 字符集不兼容与 UnicodeEncodeError
UTF-8 包含全球几乎所有语言字符和 Emoji 表情,而 GBK 仅包含中日韩汉字及常用字符。如果将包含特殊字符(例如 '⚡ Python')的 UTF-8 文本转为 GBK,就会触发 UnicodeEncodeError: 'gbk' codec can't encode character...。
3. 安全容错参数:errors 的选择
在调用 .decode() 或 .encode() 时,可以通过 errors 参数控制遇到无法映射字符时的策略:
raw_text = "数据指标:98.5% 🚀"  # 包含火箭 Emoji

# 默认 strict 模式:遇到非法字符直接抛出异常
# raw_text.encode('gbk', errors='strict')  # 抛出 UnicodeEncodeError

# ignore 模式:静默丢弃无法编码的字符(适合日志或清洗)
clean_bytes = raw_text.encode('gbk', errors='ignore')
print(clean_bytes.decode('gbk'))  # 输出: 数据指标:98.5%

# replace 模式:用问号 '?' 代替无法编码的字符
safe_bytes = raw_text.encode('gbk', errors='replace')
print(safe_bytes.decode('gbk')) # 输出: 数据指标:98.5% ?注意:在涉及财务、订单、密码等核心数据的场景中,严禁盲目使用 ignore,否则会导致关键数据丢失且难以追查。开发排查阶段优先使用默认的 strict 模式,暴露出真正的数据源编码不一致问题。
五、Unicode 三明治架构与排查决策
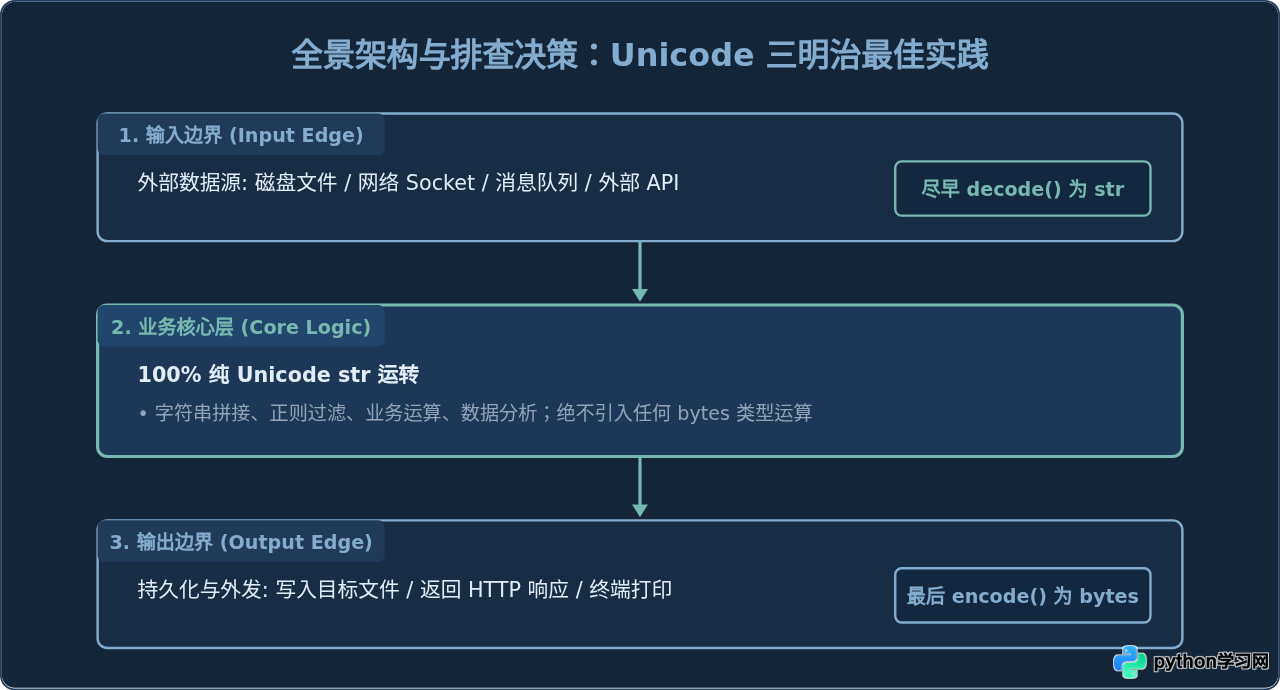
为了从根本上避免编码混乱,业界普遍遵循 Ned Batchelder 提出的 “Unicode 三明治模型”(Unicode Sandwich)。其核心准则为:
- 输入边界尽早解码:在最靠近数据源的地方(如读取文件、接收 HTTP 请求、从 Redis 读取 bytes 后),立刻使用其原始编码将其
decode成str。 - 核心业务层纯净处理:应用内部的所有函数传递、业务逻辑、正则替换、文本操作,100% 只处理
str,绝不穿插bytes。 - 输出边界最终编码:仅在向外界输出数据时(写回文件、向网络 Socket 写入、保存数据库 BLOB),才根据接收端的要求将其
encode为对应的目标bytes。
六、总结与速查清单
- 定位角色:
str表达人类文本,bytes表达物理存储。在 Python 3 中两者互不隐式转换。 - 转换路线:不存在从
utf-8 bytes直接到gbk bytes的捷径;必须遵循raw_bytes.decode('utf-8').encode('gbk')。 - 报错排查:
UnicodeDecodeError:说明用错了源解码格式,尝试读取的原始字节不符合该编码规则。UnicodeEncodeError:说明目标编码(如 GBK)的码表容纳不下当前 Unicode 字符(如特殊符号或 Emoji)。
- 架构规范:在系统输入输出边界完成编解码,让核心业务逻辑始终与纯文本
str交互,即可杜绝绝大多数乱码与类型异常。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















