


Python中print与sys.stdout.write有什么区别?
深入对比Python中print函数与sys.stdout.write方法的底层原理、类型要求、参数控制、缓冲机制与实际应用场景,帮助开发者准确选择最适合的标准输出方式。
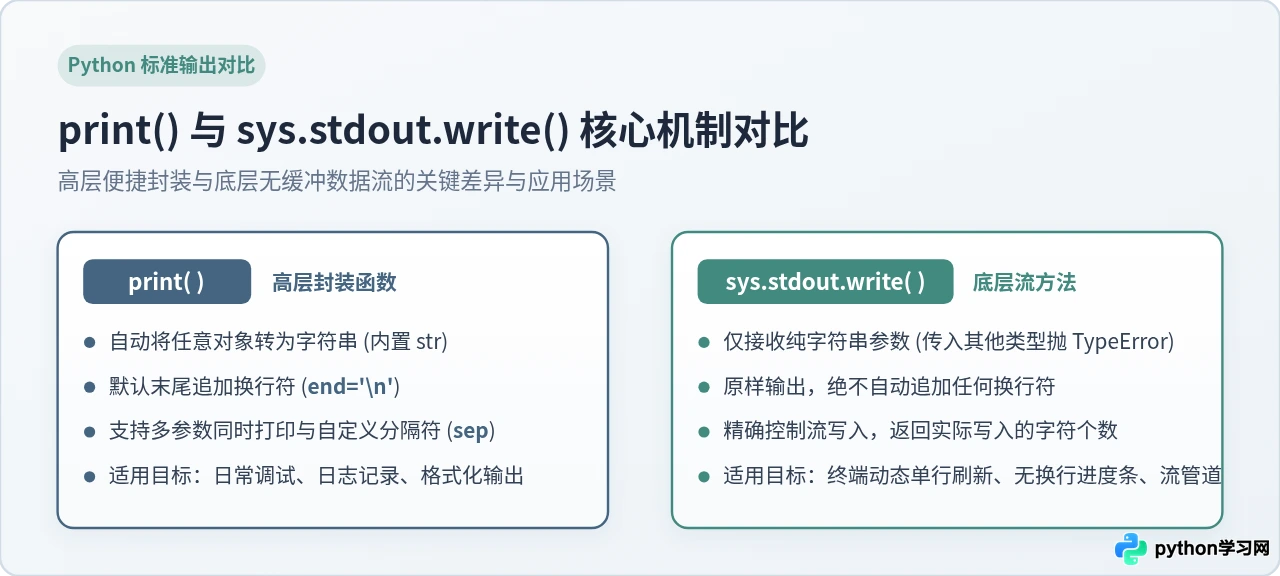
print() 与 sys.stdout.write() 的根本区别在于层级抽象与控制粒度。print() 是 Python 提供的内置高层函数,会自动对入参调用 str()、支持多参数以指定分隔符连接、默认在末尾追加换行符
并可选择自动刷新;而 sys.stdout.write() 是底层标准输出文本流的原生写入方法,只严格接收单个纯字符串、不追加任何换行符,且返回实际写入的字符数。在架构上,print() 的底层正是在调用 sys.stdout.write()。
一、架构层次:高层封装与底层流方法
在 Python 的 I/O 体系中,sys.stdout 是一个定义在 sys 模块中的文件型对象(通常是 io.TextIOWrapper 类的实例),代表进程的标准输出流。理解两者的首要切入点,是认清它们的层级隶属关系。
sys.stdout.write() 属于底层流写入通道,它直接将文本写入该文件对象的缓冲区中;而 print() 则是一个开箱即用的高层封装工具,它负责接收不同类型的对象,将其格式化成最终的文本字符串后,再委托 sys.stdout.write() 写入终端。可以用下面的一行等价代码来概括两者最基础的关系:
import sys
sys.stdout.write(str("Hello") + " ")
为了直观展现两者在 Python 运行时环境中的层级调用链路,请参阅图 1 所示的系统架构关系:
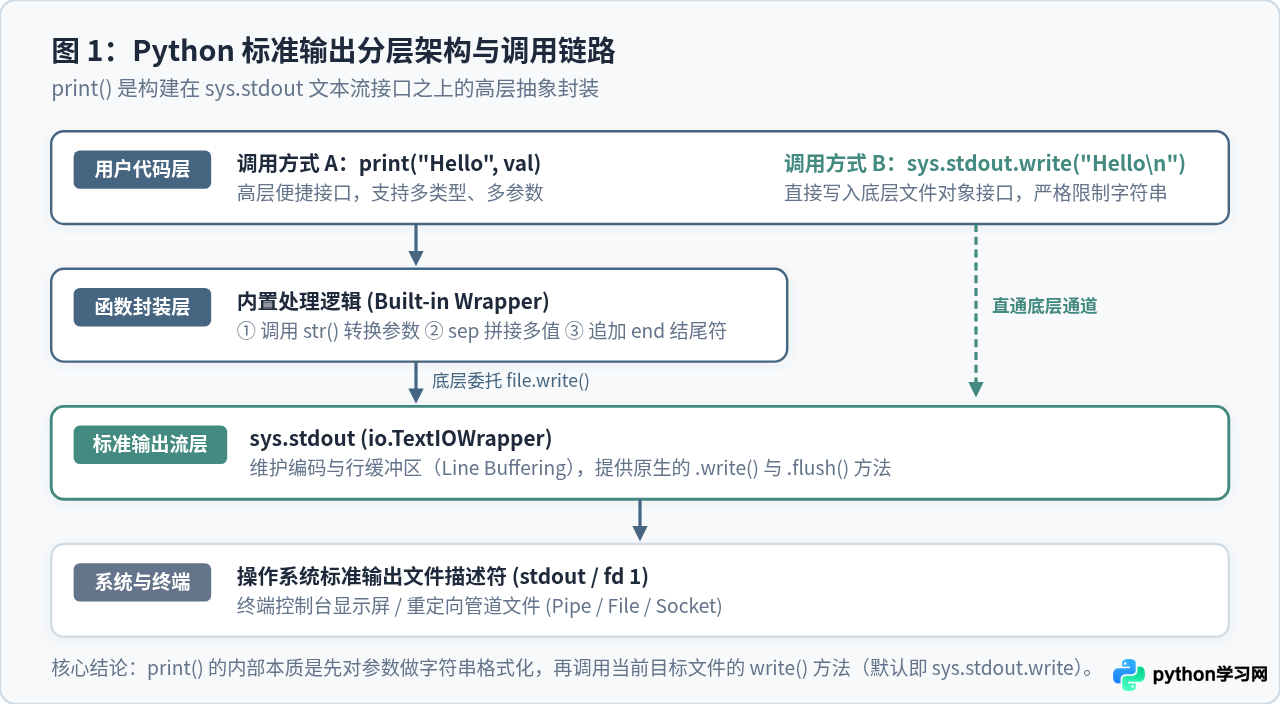
print() 的完整函数签名其实包含 file 参数:print(*objects, sep=' ', end='
', file=None, flush=False)。当 file=None 时,它默认就是向 sys.stdout 写入。因此,sys.stdout.write() 是承载 print() 输出任务的基石。
二、核心区别的五个技术维度
在实际编码中,虽然两者都能向屏幕输出内容,但在参数类型、换行处理、多参数机制、返回值以及缓冲区刷新五个维度上存在明确差异。
1. 入参类型检查:自动转换 vs 严格限制字符串
print() 能够接收任意类型的 Python 对象(数字、字典、列表、布尔值或自定义类的实例),因为它在内部会对传入的每一个对象主动调用 str() 进行类型转换:
print("数值为:", 1024, ["A", "B"])
数值为: 1024 ['A', 'B']
与之相反,sys.stdout.write() 具有极其严格的参数校验。它只允许传入一个纯字符串(str),传入任何非字符串对象都会立即抛出 TypeError:
sys.stdout.write(1024) # 错误调用
TypeError: write() argument must be str, not int
sys.stdout.write() 时,必须由开发者显式完成类型转换,例如写成 sys.stdout.write(str(1024)) 或使用 f-string sys.stdout.write(f"{1024}")。
2. 行尾追加行为:自动追加换行 vs 原样输出
默认情况下,print() 的 end 参数值为 '
',这意味着每次调用 print() 结束后,都会在末尾自动追加一个换行符,将光标移动至下一行起始位置:
print("第二行")
第一行
第二行
而 sys.stdout.write() 不会对输入内容做任何额外修饰,你传入什么字符,它就输出什么字符。如果没有在字符串末尾显式写上
,连续调用两次将紧挨在一起输出在同一行:
sys.stdout.write("第一部分")
sys.stdout.write("第二部分")
第一部分第二部分
3. 多参数与分隔符支持
print() 声明了可变位置参数 *objects,允许一次性传入多个参数,并由 sep 参数控制它们之间的连接字符(默认是一个空格 ' '):
2026-10-31
sys.stdout.write() 只接受单一参数。若需要输出多个变量,必须由开发者在传参前自行完成拼接或格式化。
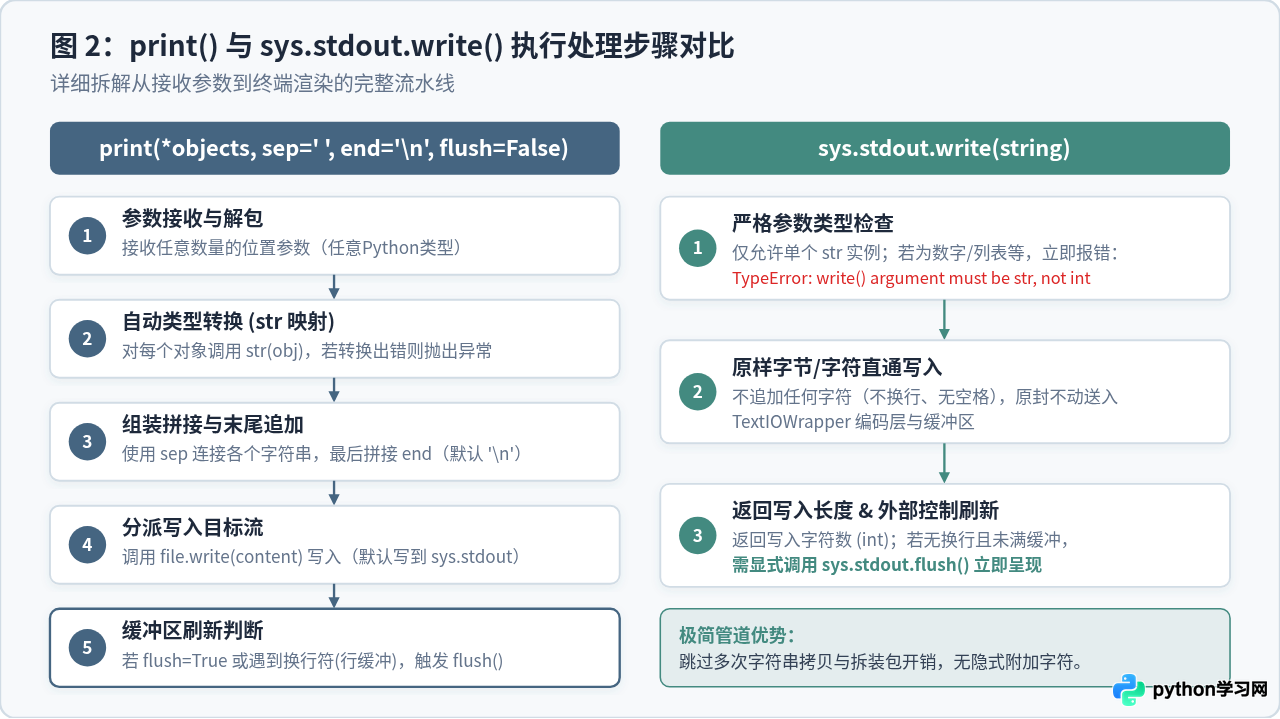
4. 执行流程与步骤拆解
下面的图 2 清晰展示了当调用两个接口时,底层分别走过的内部执行步骤:
5. 返回值差异
print() 的执行目的纯粹是为了产生副作用(即在目标设备上呈现文本),其返回值始终为 None。
而 sys.stdout.write() 遵循标准 I/O 协议规范,会返回成功写入底层流的字符数(Python 3 中以字符数为单位)。这在交互式解释器(REPL)中表现尤为明显:
>>> sys.stdout.write("Python ")
Python
7 # 返回值:6个英文字符 + 1个换行符 = 7
三、特性多维技术矩阵
为了让不同维度的差异一目了然,图 3 将核心技术指标整理成了全景对比表:
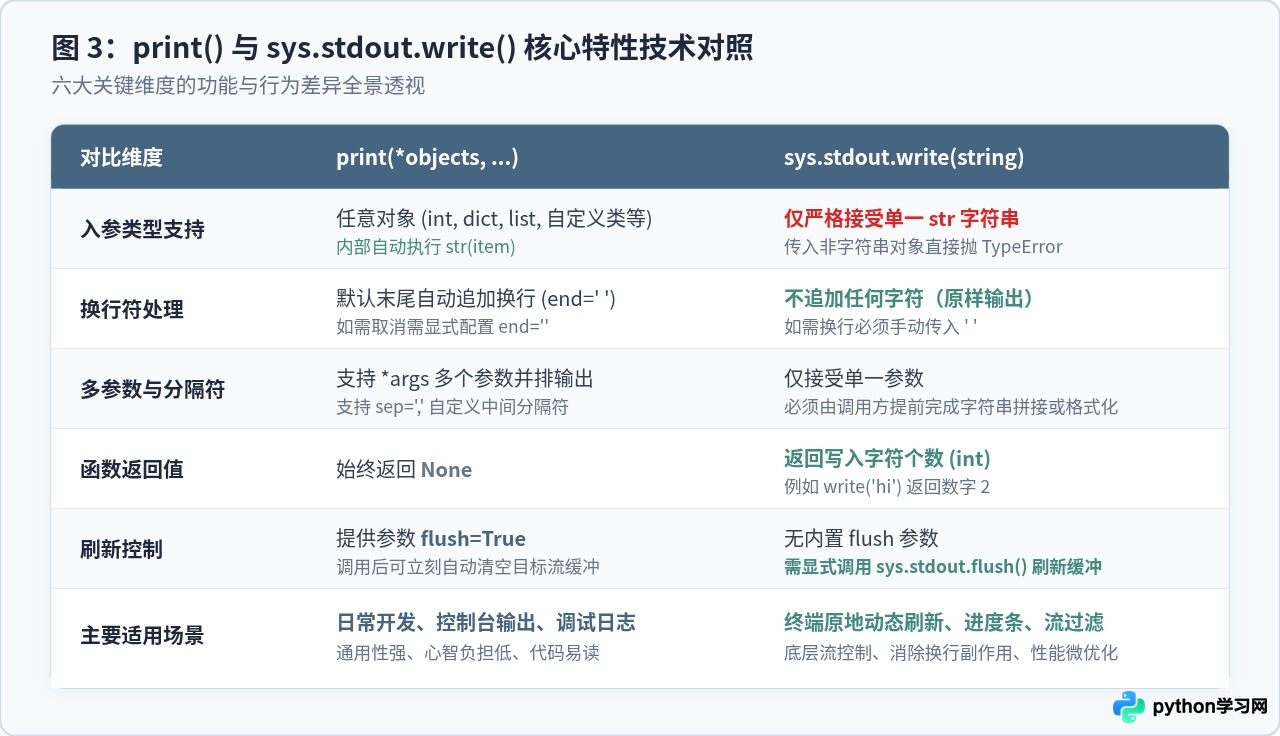
四、缓冲机制与实时刷新:为什么有时候内容出不来?
很多初学者在使用 sys.stdout.write() 时,会遇到“明明调用了写入,但终端屏幕上却迟迟没有显示”的困惑。其根本原因在于标准 I/O 的行缓冲(Line Buffering)机制。
由于 print() 默认末尾包含
,终端遇到换行符时通常会自动刷新行缓冲区,内容立即呈现在屏幕上。如果设置了 end='' 取消换行,也可以通过传入 flush=True 强制立即刷新。
若输出字符串中没有
,数据会暂存在操作系统或 Python 的缓冲区内,直到缓冲区填满、程序结束或显式触发刷新时才会一次性吐出。因此无换行输出时必须搭配 sys.stdout.flush()。
实战场景:命令行原地刷新进度条
利用 sys.stdout.write() 不自动换行且可精准控制的特性,配合回车符
(让光标回到当前行的行首)与 sys.stdout.flush(),可以编写出干净平滑的单行动态进度条:
import time
def render_progress(total_steps=100):
for i in range(total_steps + 1):
percent = i * 100 // total_steps
bar = "#" * (percent // 2) + "-" * (50 - percent // 2)
# \r 将光标重置到当前行最左侧
sys.stdout.write(f"\r正在处理: [{bar}] {percent}%")
# 立即将缓冲区数据推送到终端显示屏
sys.stdout.flush()
time.sleep(0.02)
# 完成后输出一个换行符,避免下一行提示被覆盖
sys.stdout.write("\n任务已完成!\n")
render_progress()
正在处理: [##################################################] 100%
任务已完成!
虽然通过 print(f"
正在处理...", end='', flush=True) 也能达到类似效果,但使用 sys.stdout.write() 表达更直接、语法意图更纯粹,避免了 print() 内部反复处理 *objects 和默认参数的计算开销。
五、选型决策指南与高频避坑
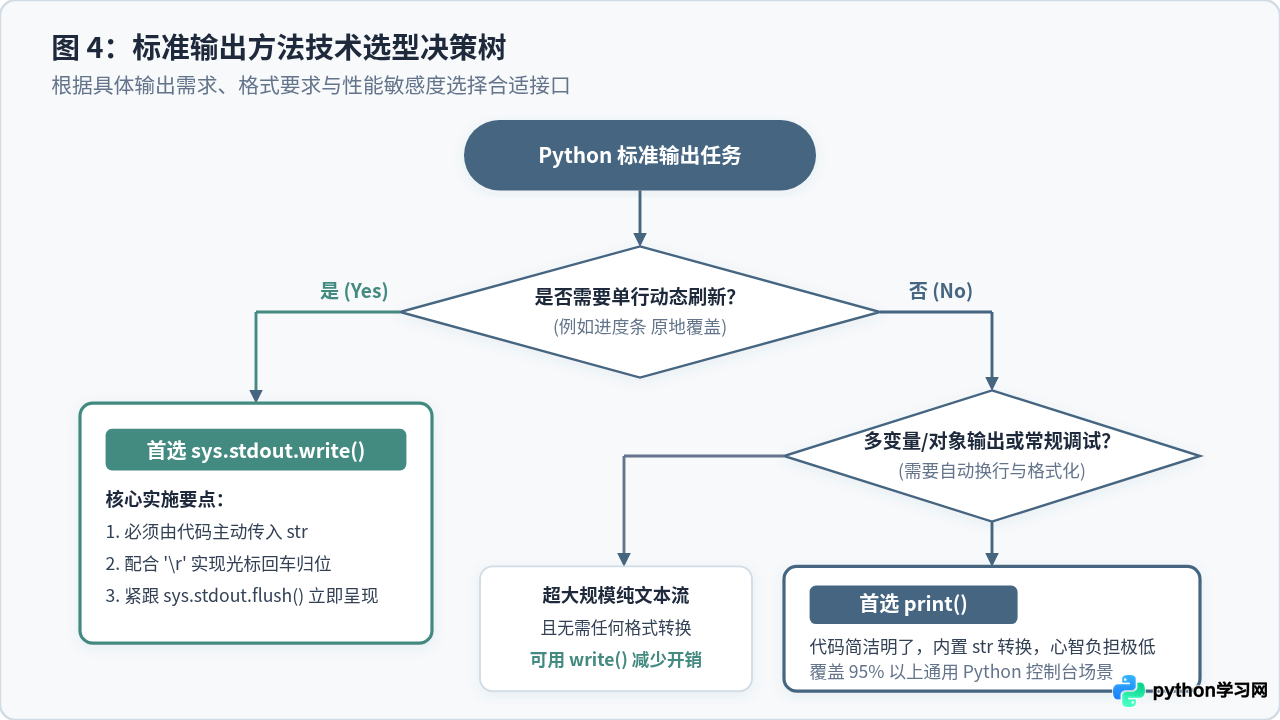
在工程项目中,何时使用 print(),何时选用 sys.stdout.write()?图 4 提供了清晰的判断路径:
总结与避坑速查
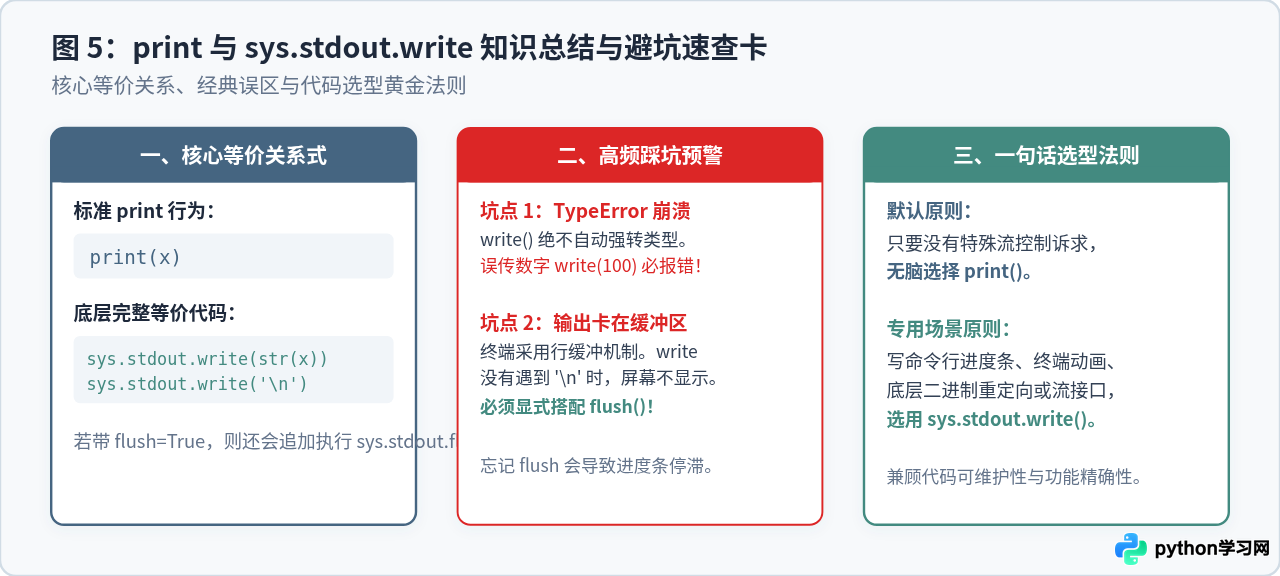
为了帮助大家在日常开发中规避常见错误,图 5 总结了核心公式、常见陷阱与选择口诀:
- 绝大多数日常场景:直接使用
print()。它语法简短、自动处理多类型与格式化、可维护性高。 - 终端交互特效与微秒级流水线:使用
sys.stdout.write()。在需要无换行动态覆盖( - 切记类型与缓冲:使用
write()时务必保证传参已是str;若无换行符,务必及时调用flush()。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















