


Python可变与不可变数据结构有什么区别
深入解析Python中可变与不可变数据结构的核心区别,从内存分配、id机制、哈希原理到经典代码陷阱与工程选型,帮助开发者全面透彻理解底层机制。
一、核心分类与判别方式
Python 将所有数据都抽象为对象。每个对象在底层都拥有三个核心属性:身份标识(Identity,由 id() 获取)、类型(Type,由 type() 获取)以及值(Value)。对象的类型在创建时决定了其是否具有可变性。
- 常见的不可变对象(Immutable):
int、float、bool、complex、str、tuple、bytes、frozenset。 - 见的可变对象(Mutable):
list、dict、set、bytearray以及绝大多数用户自定义的类实例。
最直观的检验方法是观察执行修改操作前后,对象通过内置函数 id() 返回的内存地址是否一致。
# 1. 验证可变对象(列表):内容增加,内存地址保持不变
numbers = [1, 2]
print("初始地址:", id(numbers))  # 示例: 4352849216
numbers.append(3)
print("修改后地址:", id(numbers))  # 示例: 4352849216 (完全相同)

# 2. 验证不可变对象(字符串):看似修改,实则开辟新对象
text = "hello"
print("初始地址:", id(text))     # 示例: 4353001840
text += " world"
print("修改后地址:", id(text))     # 示例: 4353124528 (地址已改变)
二、内存模型与底层工作原理
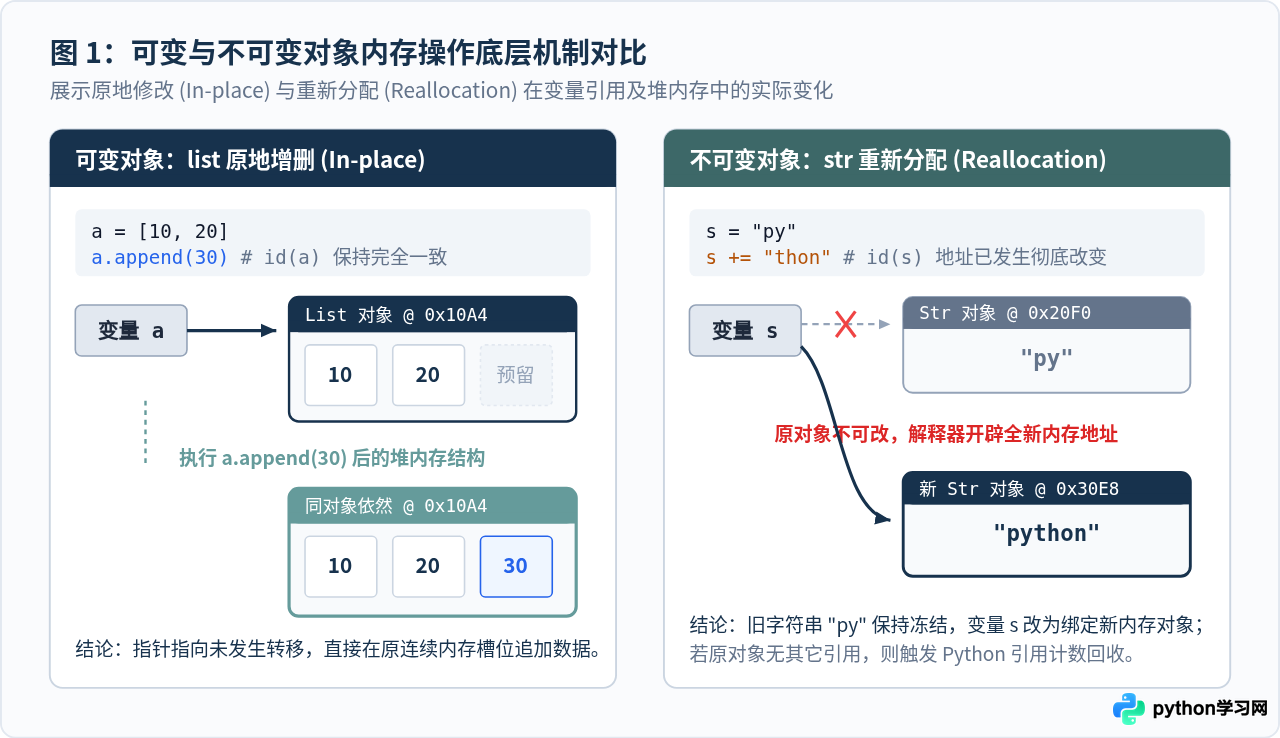
在很多静态语言(如 C/C++)中,变量名通常对应一块固定的栈内存格子,赋值操作直接改写格子里的内容。但在 Python 中,变量名本质上只是指向堆内存对象的标签(Reference/Pointer)。
对于可变对象(例如 list),Python 的对象结构体内部包含一个指向可扩容缓冲区的指针数组。当调用 append() 或进行切片赋值时,解释器直接改写底层连续内存数组中的槽位指针,对象本身的头部结构与内存起始地址完全不变。
而对于不可变对象(例如 str 或 tuple),其内部数据长度与字节序列在实例化阶段已被固定。当开发者执行 s += "xyz" 时,Python 无法也不允许直接往原内存块尾部追加字符,而是必须计算新长度,向操作系统申请一块全新的内存区域存放拼接后的字符串,并将变量 s 重新绑定到该新地址。原对象如果失去了所有引用计数,会被 Python 垃圾回收器(Garbage Collector)回收。
三、关键特性的四大核心差异
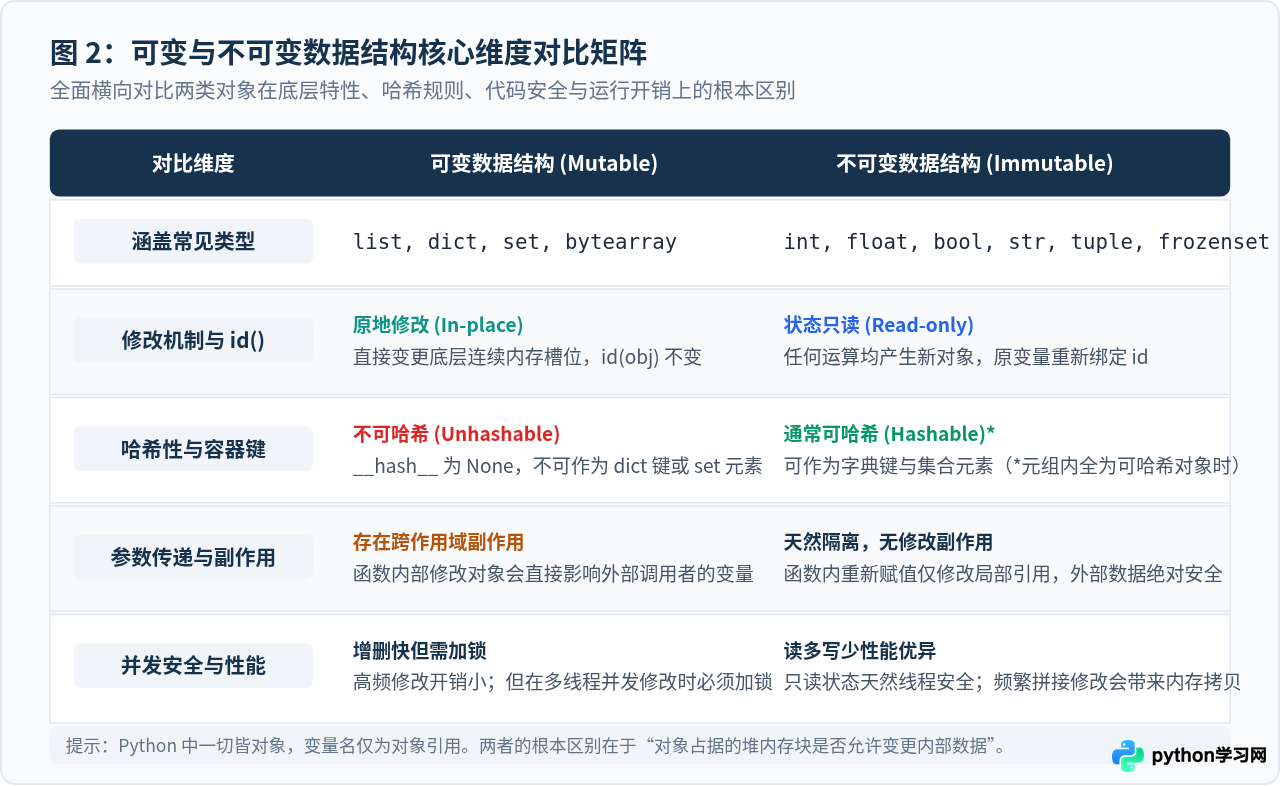
内存行为的差异进一步投射到程序运行的方方面面,集中体现在哈希性、参数传递副作用、运算性能以及并发安全性四个维度。
1. 哈希性与字典键(Hashability)
Python 字典(dict)和集合(set)底层均依赖哈希表实现 \(O(1)\) 复杂度的极速检索。哈希表要求一个键的哈希值在整个生命周期内必须恒定不变。如果一个对象在加入字典后内部数据发生改变,其哈希值也将改变,导致哈希表无法定位到原先存放的槽位。
因此,Python 规定可变对象是不可哈希的(Unhashable),其内部的 __hash__ 属性被显式置为 None。如果尝试用列表作为字典的键,解释器将立即抛出 TypeError: unhashable type: 'list'。
2. 函数传参与跨作用域副作用
Python 的传参机制是“传对象引用”(Pass-by-assignment)。形参获得的是实参指向的对象引用。
- 如果传递的是不可变对象,函数内部对其进行的任何加法、乘法等修改操作,都只会使局部形参指向新对象,调用者外部的实参数据不受丝毫影响。
- 如果传递的是可变对象,且在函数体内使用了原地修改方法(如
list.extend()、dict.update()),外部实参的内容会同步改变。这种跨作用域的修改副作用若非有意为之,极易导致隐蔽的业务逻辑 Bug。
def modify_data(my_num, my_list):
    my_num += 10          # 整数是不可变的,局部变量 my_num 绑定新对象
    my_list.append(999)   # 列表是可变的,原地修改同一个堆内存对象

x = 1
items = [10, 20]
modify_data(x, items)

print("外部 x:", x)          # 输出: 1 (未受影响)
print("外部 items:", items)  # 输出: [10, 20, 999] (已被篡改)
四、实践中最易踩入的三个陷阱与推导排查
陷阱一:可变对象作为函数默认参数(Default Argument Trap)
这是 Python 开发者最常遇到的初学者陷阱之一。许多人误以为函数的默认参数会在每次调用该函数时重新初始化求值。
实际运行机制:函数的默认参数表达式是在模块加载、函数被定义(def 语句执行)时且仅在此刻求值一次。如果默认参数是可变对象(如 def func(data=[])),该列表对象被永久保存在函数对象的 __defaults__ 属性中。所有不传参的后续调用,共享的都是这同一个列表。
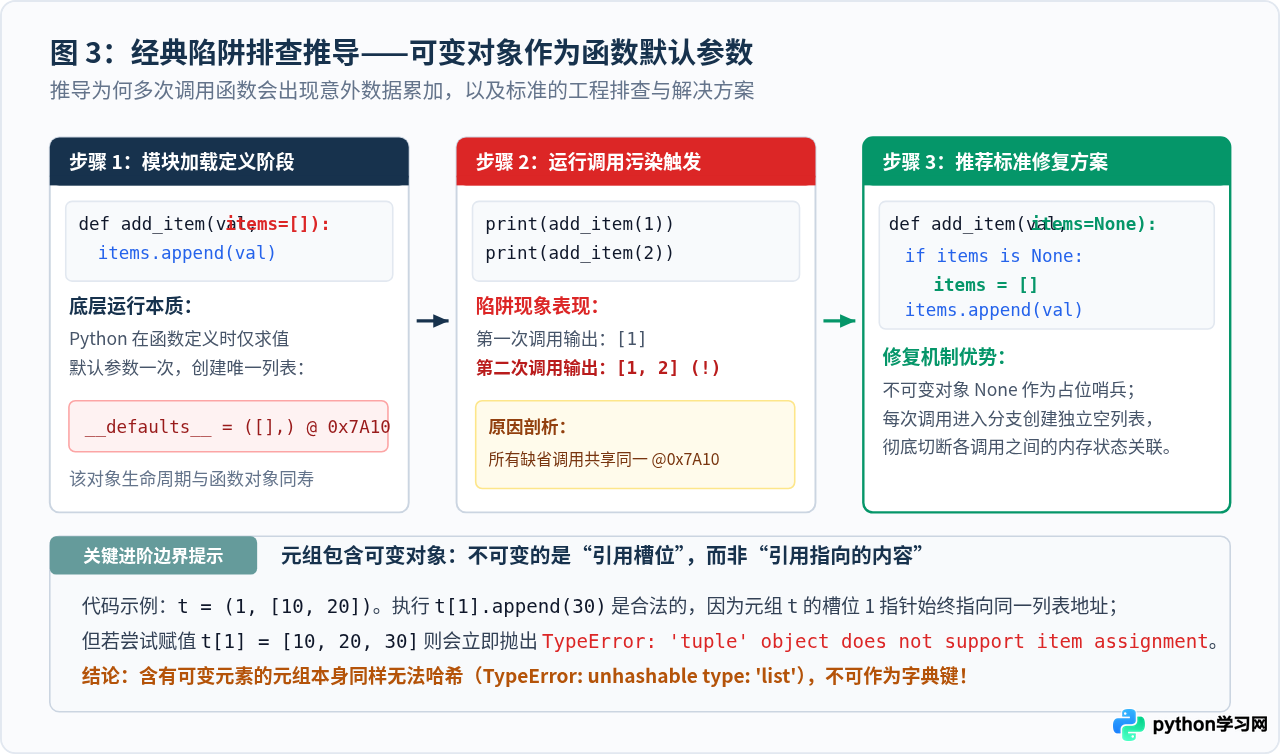
永远不要将 [] 或 {} 等可变对象直接写在函数的默认形参位置。标准工程做法是使用不可变对象 None 作为占位哨兵,并在函数体内通过条件判断动态初始化。
陷阱二:元组包含可变对象带来的“伪不可变性”
元组(tuple)本身是不可变结构,但若元组的成员中包含了可变对象(例如 t = (1, [2, 3])),情况就会变得复杂:
- 元组固化的是每个索引槽位中所保存的内存引用指针。你无法替换
t[1]指向另一个列表; - 但是,
t[1]所指向的那个列表本身依然是可变的。你可以执行t[1].append(4),且操作能够顺利成功; - 此时元组的内容看起来改变了,正因如此,包含可变对象的元组不能被哈希,无法作为字典的键。
陷阱三:浅拷贝(Shallow Copy)与深拷贝(Deep Copy)的混淆
使用切片 nums[:] 或 copy.copy() 对可变容器进行拷贝时,默认执行的是浅拷贝:外层创建了新容器,但内层嵌套的可变子对象依然只复制了引用地址。如果修改了内层嵌套数据,原对象同样会被波及。在处理多维列表或嵌套字典时,必须根据场景引入 copy.deepcopy()。
五、工程技术选型与决策建议
在实际软件架构与编码中,如何选择适合的数据结构?我们可以根据场景的核心约束,遵循明确的决策路径。
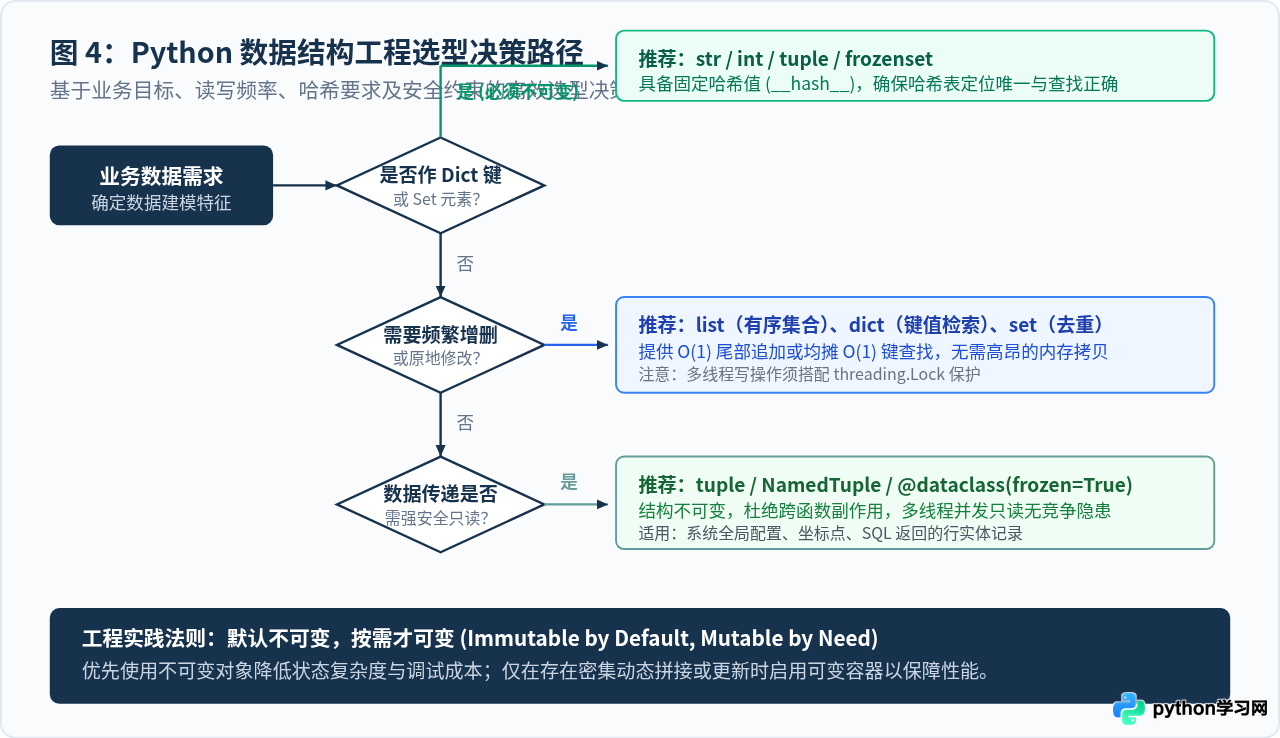
在设计系统模型时,推荐遵循以下工程原则:
- 默认偏向不可变(Immutable by Default):传递配置项、坐标、API 响应字段或常量元组时,优先使用
tuple、NamedTuple或@dataclass(frozen=True)。不可变结构天然消除并发竞态条件,代码更具确定性。 - 高频动态修改启用可变容器:对于需要频繁按索引更新、在尾部增删元素的业务流水线,选用
list;对于需要键值检索与增量维护的映射,选用dict。 - 注意字符串高频拼接的性能反模式:在循环体内多次使用
s += chunk会反复申请内存并拷贝旧数据,形成 \(O(N^2)\) 的性能瓶颈;应先将片段放入可变列表chunks.append(chunk),最后通过"".join(chunks)一次性完成高效分配。
六、全文核心总结清单
| 对比维度 | 可变数据结构 (Mutable) | 不可变数据结构 (Immutable) |
|---|---|---|
| 代表类型 | list, dict, set, bytearray |
int, float, str, tuple, frozenset |
| 就地修改 | 支持,调用方法直接在原内存区域写入 | 不支持,所有更新均在底层生成新对象 |
| 地址变化 | 内容改变时 id() 严格保持一致 |
发生变化后 id() 必定变为新地址 |
| 哈希与字典键 | 未实现哈希,不可作 dict 的键和 set 元素 |
只要成员均不可变,即可哈希,可作为键与集合元素 |
| 传参副作用 | 函数内就地修改会改变外部调用方的实际数据 | 外部数据绝对安全,函数内赋值只变更局部绑定 |
| 多线程并发 | 并发写操作存在竞态隐患,须加互斥锁 | 只读状态天然具备线程安全性 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















