


Python变量命名规则:合法字符、关键字与基础禁忌
深入解析Python变量命名的硬性语法规则与工程禁忌:从合法字符集、大小写敏感、35个保留关键字,到内置名称遮蔽陷阱与PEP 8标准规范,提供完整代码示例与验证决策流程。
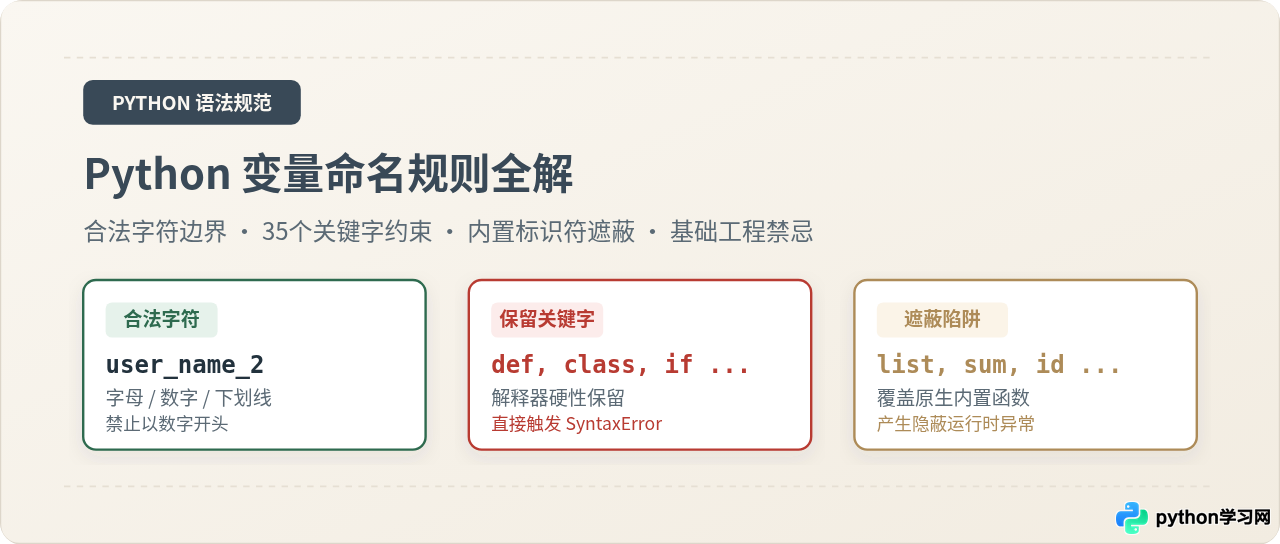
在 Python 中,给变量命名不仅是书写代码的第一步,更直接决定了解释器能否正常解析程序、以及团队协作时代码是否具备长久的可维护性。Python 的变量命名规则由三层约束共同构成:一是词法分析器设定的合法字符与位置硬约束,二是语言保留的35个系统关键字边界,三是工程层面的内置名称遮蔽陷阱与命名禁忌。本文将通过具体语法规则、破坏机制演示与标准化流程,系统梳理变量命名的全套准则。
一、合法字符构成与语法强制边界
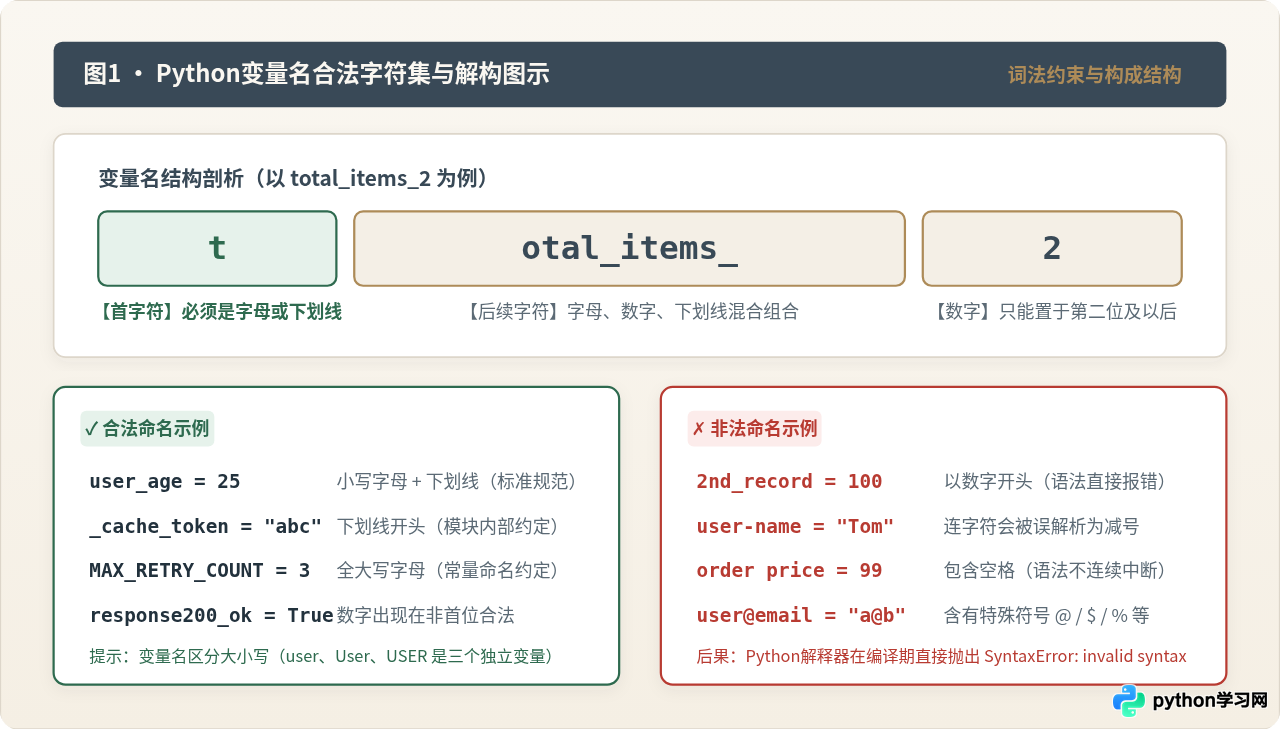
Python 标识符(Identifier,包括变量名、函数名、类名等)在底层词法解析时遵循明确的字符集与位置规则。只要违反了这些底层约束,Python 解释器在编译生成字节码之前就会直接抛出 SyntaxError: invalid syntax,代码完全无法启动执行。
1. 允许使用的字符集
合法的 Python 变量名只能由以下三类字符组成,不可包含其他任何符号:
- 英文字母:包含小写字母
a-z与大写字母A-Z。 - 阿拉伯数字:
0-9的十个数字字符。 - 下划线:唯一的合法标点符号
_(ASCII 码 95)。
2. 首字符的核心限制
变量名的第一个字符必须是字母或下划线,严禁以数字开头。这是所有基于 C 语法家族解析器的通用设计,目的是避免词法分析器在扫描源码词元(Token)时,把数字开头的变量名与十进制、十六进制数值常量发生歧义混淆。
3. 大小写严格敏感
Python 是一门完全大小写敏感(Case-Sensitive)的语言。同一个单词若大小写组合不同,在 Python 内存符号表中会被分配为完全独立的变量。例如:
user_count = 10
User_Count = 20
USER_COUNT = 30

# 这是三个互不相干的独立变量
print(user_count, User_Count, USER_COUNT)
# 示例输出: 10 20 30
虽然语法上允许同时定义,但在同一个作用域内混用大小写极其容易引发读写错乱,属于典型的代码异味。
4. 严禁包含空格与特殊标点符号
初学者极易误用的符号包括连字符(减号 -)、空格、点号 . 以及符号 @、$、%、!。在 Python 语法中,这些符号均具有特定的运算或语法语义:
user-name会被解释器解析为变量user减去变量name的减法表达式。user.name会被解析为访问对象user的属性name。user name中间的空格会导致词法分析器判定为两个独立的连续标识符,从而中断语法树构建。
Python 3 的标识符在底层支持 PEP 3131 标准,允许使用 Unicode 字符(例如使用中文
总金额 = 100)。尽管解释器能够正常运行中文变量,但在现代软件工程、开源生态与企业协作中,强烈建议坚持使用纯 ASCII 英文字符。非 ASCII 变量名不仅在跨平台环境(如某些精简 Docker 镜像或 CI/CD 流水线)中可能出现字符集编码乱码,还会对代码自动补全、静态类型检查及团队国际化协作造成严重阻碍。
二、保留关键字的硬性拦截与排查机制
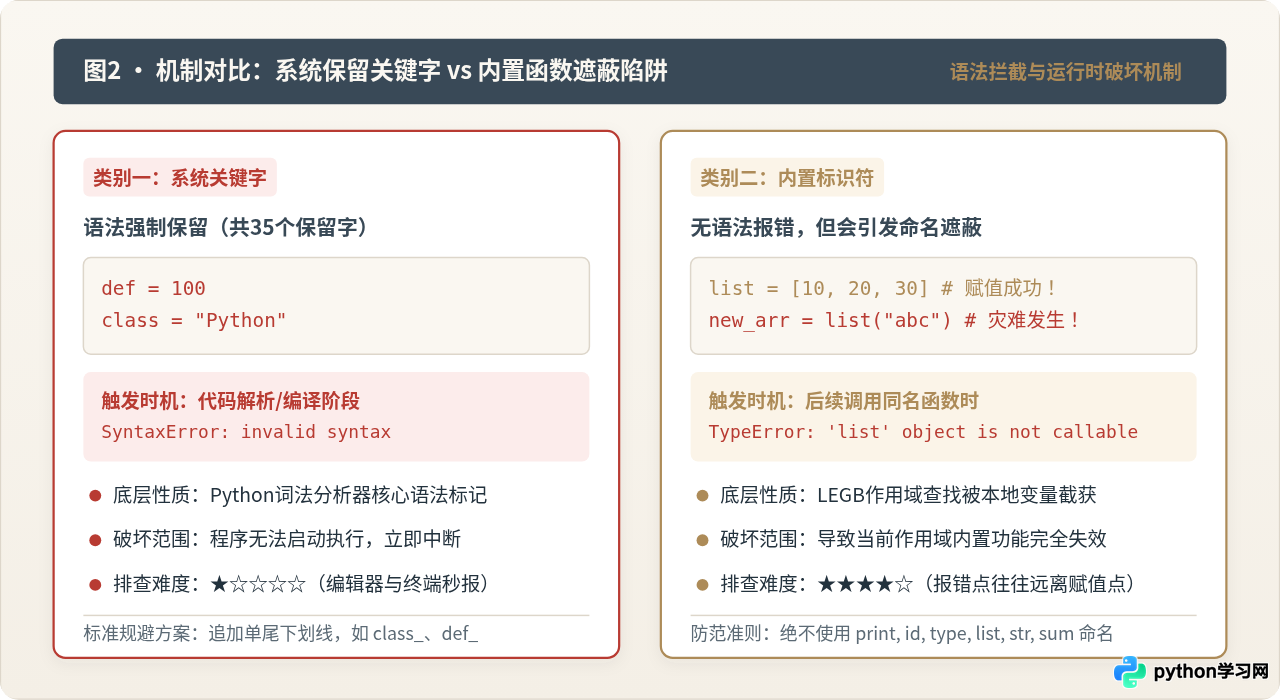
即使完全由合法字母组成,只要命中了 Python 语言本身的保留关键字(Keywords),解释器同样会直接报错。关键字是 Python 语法结构的支柱,用于控制条件分支、循环、函数定义、异常处理等核心语义。
1. Python 3 核心关键字清单
在主流的 Python 3 环境中,系统保留了 35 个核心关键字。你可以通过标准库的 keyword 模块随时打印当前运行时的完整列表:
import keyword

print(f"关键字总数: {len(keyword.kwlist)}")
print(keyword.kwlist)

# 示例输出:
# 关键字总数: 35
# ['False', 'None', 'True', 'and', 'as', 'assert', 'async', 'await',
#  'break', 'class', 'continue', 'def', 'del', 'elif', 'else', 'except',
#  'finally', 'for', 'from', 'global', 'if', 'import', 'in', 'is',
#  'lambda', 'nonlocal', 'not', 'or', 'pass', 'raise', 'return', 'try',
#  'while', 'with', 'yield']
2. 关键字赋值的报错表现
尝试对任何关键字执行赋值操作,都会直接打断程序编译。例如:
# 错误示例:试图将关键字作为变量名
pass = "secret_123"
# 报错: SyntaxError: invalid syntax

class = "Computer Science"
# 报错: SyntaxError: invalid syntax
值得注意的是,在 35 个关键字中,除了 True、False 和 None 首字母大写外,其余 32 个关键字均为全小写。因此理论上 Pass = "123" 或 Class = "CS" 不会触发关键字报错,但这破坏了代码规范,强烈不建议利用大小写差异来规避关键字。
3. 工程解法:单尾随下划线惯用法
在实际业务开发中,我们常常会遇到变量在概念上恰好对应某个关键字的情况。例如在 Web 框架中解析 HTML 元素的 class 属性,或者在数据库查询中指定 from 表名。
PEP 8 官方给出了唯一的标准化推荐做法:在变量末尾追加单个下划线(Single Trailing Underscore)。例如:
# 正确做法:使用单尾下划线避让关键字冲突
class_ = "btn-primary"
from_ = "user_orders"
type_ = "vip_member"
三、内置标识符的隐蔽“遮蔽(Shadowing)”陷阱
与关键字触发明确的 SyntaxError 不同,Python 还存在一类更为危险、更难排查的命名错误——遮蔽内置函数或类型(Shadowing Built-in Names)。
1. 什么是内置标识符
Python 在启动时会自动加载内置模块 builtins,其中包含了全局可用的常用类型与内置函数,例如:
- 内置容器与类型:
list,dict,set,tuple,int,float,str,bool等。 - 常用基础函数:
print,input,len,sum,max,min,type,id,open,range等。
2. 遮蔽现象的发生机理
Python 的作用域查找遵循 LEGB 原则(Local → Enclosing → Global → Built-in)。当你在模块或函数内部定义了一个名为 list 的变量时,Python 解释器不会抛出任何语法错误,而是将 list 这一名称绑定到了你自定义的数据对象上。
一旦当前作用域内的 list 被本地变量占用,后续任何想要通过 list() 构造列表的代码,在查找符号时都会命中本地变量,进而导致灾难性的运行时错误:
# 错误示范:将列表数据命名为 list
list = [10, 20, 30]

# 后续程序需要将字符串转为字符列表
chars = list("hello")

# 抛出异常:
# TypeError: 'list' object is not callable因为变量赋值的代码行本身并不会报错。当程序运行了数百行甚至跨模块调用时,报错信息只会指向调用处(
TypeError: 'list' object is not callable 或 TypeError: 'int' object is not callable),这会让不熟悉该机制的开发者百思不得其解。
四、基础禁忌与高风险不良习惯
除了语法硬性报错和内置名称遮蔽外,还有一系列变量命名的“软禁忌”。这些习惯虽然解释器可以通过,但严重违反了工程协作规范,往往会在代码评审(Code Review)中被直接打回。
1. 视觉易混淆的单字母变量(PEP 8 明令禁止)
PEP 8 规范明确规定:绝不要使用单个字符 l(小写字母 L)、O(大写字母 O)或 I(大写字母 I)作为任何变量名。
原因在于,在大量等宽字体、无衬线字体以及不同终端显示环境中,小写字母 l 与数字 1 几乎完全无法肉眼分辨,大写字母 O 与数字 0 也高度相似。如果写出 l = 1 或 val = O + 0,会给调试带来极大的视觉误导。
2. 下划线的前缀与后缀语义滥用
下划线在 Python 中具有极强的语法约定。如果不了解其背后的约定而随意命名,会导致外部调用方产生误判:
| 下划线形式 | 命名示例 | 约定语义与适用场景 | 错误用法警示 |
|---|---|---|---|
| 单前导下划线 | _internal_cache |
提示该变量为内部使用(受保护),使用 from module import * 时不会被导入。 |
不要将对外部暴露的常规公共变量加上单前导下划线。 |
| 单尾随下划线 | class_, id_ |
用于规避与 Python 关键字或内置标识符的命名冲突。 | 不要滥用无冲突的变量名后加下划线(如 user_)。 |
| 双前导下划线 | __private_token |
类内部触发属性名称修饰(Name Mangling),防止子类意外覆盖。 | 不要在普通模块全局变量或函数局部变量中使用。 |
| 双前后下划线 | __init__, __str__ |
Python 内部预留的魔法方法/专有属性(Dunder)。 | 严禁开发者自行发明 类似 __myvar__ 的双下划线变量。 |
| 单独立下划线 | _ |
约定作为抛弃型临时变量(如 for _ in range(5)),或交互环境最后结果。 |
不要用它承载具有明确业务意义的长期数据。 |
3. 无意义命名与拼音杂交
在较长作用域中,禁止使用泛泛无指代的单字母或简写(如 a, b, data, temp, res, obj)。变量名必须体现业务意图,例如使用 order_timeout_seconds 代替 t。
同时,杜绝汉语拼音或拼音与英文混杂的命名(如 yonghu_name, dingdan_list, shuju1)。拼音不仅降低代码的专业度,且同音字极多,极易造成理解歧义。
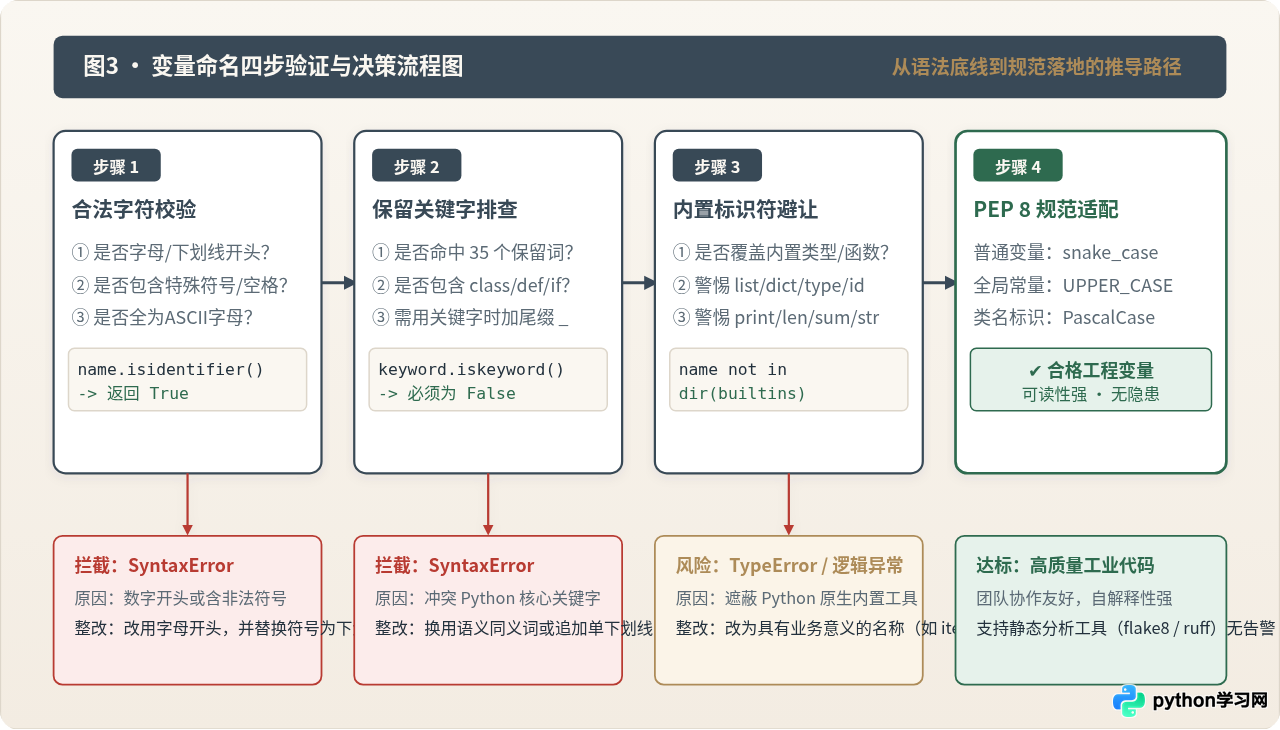
五、规范落地:PEP 8 推荐标准与四步自检流程
为了在日常编写代码时彻底杜绝命名问题,推荐遵循 PEP 8 的格式约定,并采用标准化的四步自检流程。
1. PEP 8 命名核心风格
- 常规变量与函数名:采用小写下划线风格(snake_case),如
user_account_id,retry_interval。 - 全局常量:采用全大写下划线风格(UPPER_CASE_WITH_UNDERSCORES),如
MAX_BUFFER_SIZE = 1024,DEFAULT_TIMEOUT = 30。 - 类名:采用大驼峰风格(PascalCase / CapWords),如
OrderProcessor,NetworkClient。 - 布尔型变量:建议使用谓词前缀(
is_,has_,can_),如is_active,has_permission,直观表达状态真假。
2. 编写自检脚本验证标识符
在编写动态生成变量、反射解析或配置映射程序时,可以使用 Python 内置方法与标准库进行自动化合规验证:
import keyword
import builtins

def validate_variable_name(name: str) -> tuple[bool, str]:
    # 1. 验证基础字符集与首字符结构
    if not name.isidentifier():
        return False, f"非法标识符格式: '{name}' 包含非法字符或以数字开头"

    # 2. 验证是否命中系统保留关键字
    if keyword.iskeyword(name):
        return False, f"冲突关键字: '{name}' 是 Python 语言保留字"

    # 3. 验证是否遮蔽内置标识符
    if name in dir(builtins):
        return False, f"高危警告: '{name}' 会遮蔽 Python 内置函数/类型"

    # 4. 验证易混淆单字符禁忌
    if name in ('l', 'O', 'I'):
        return False, f"违反 PEP 8 禁忌: '{name}' 视觉上极易与数字混淆"

    return True, "合法且规范"

# 示例测试
test_cases = ["2nd_item", "user-name", "class", "list", "l", "user_id"]
for var_name in test_cases:
    is_valid, msg = validate_variable_name(var_name)
    tag = "✓ 通过" if is_valid else "✗ 拦截"
    print(f"{tag} [{var_name}]: {msg}")
示例输出:
✗ 拦截 [2nd_item]: 非法标识符格式: '2nd_item' 包含非法字符或以数字开头
✗ 拦截 [user-name]: 非法标识符格式: 'user-name' 包含非法字符或以数字开头
✗ 拦截 [class]: 冲突关键字: 'class' 是 Python 语言保留字
✗ 拦截 [list]: 高危警告: 'list' 会遮蔽 Python 内置函数/类型
✗ 拦截 [l]: 违反 PEP 8 禁忌: 'l' 视觉上极易与数字混淆
✓ 通过 [user_id]: 合法且规范
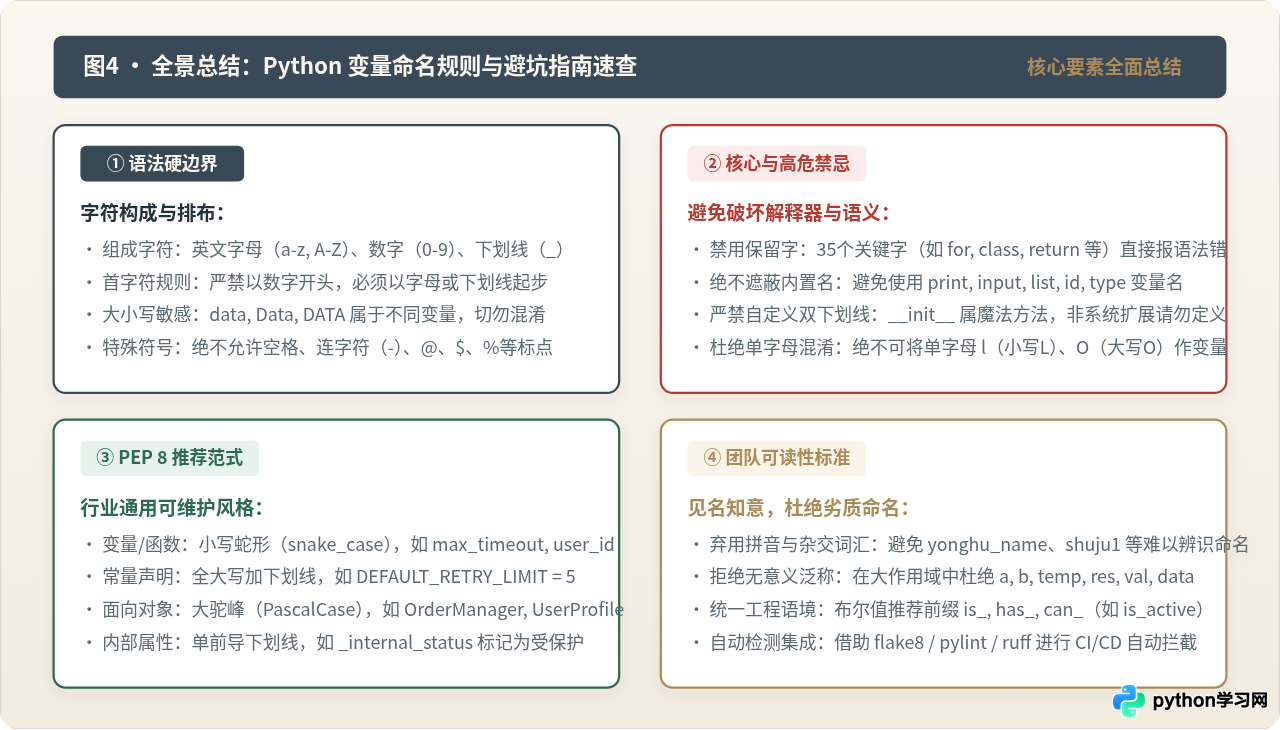
六、全景速查与总结
Python 变量命名的根本目标是兼顾解释器的词法正确性与团队工程协作的可维护性。在实际编码中,牢记“首字符避开数字、整体拒绝特殊符号、避开35个关键字、绝不覆盖内置函数、变量小写蛇形”,就能从源头规避绝大多数由变量命名引起的语法错误与静默隐患。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















