


Python代码中的xy通常代表什么?解析坐标与数据变量惯例
深入解析Python代码中xy变量的常见含义与行业惯例。涵盖平面几何与屏幕坐标系、易错的坐标与NumPy矩阵索引颠倒陷阱、机器学习大写X与小写y规范,以及陌生代码推导流程与命名最佳实践。
在 Python 编写或阅读源码时,x 和 y(或者成对出现的 (x, y))是最常见却也最容易引起维度混淆的单字符变量。根据不同代码领域的上下文,它们通常指向四种标准化语义:空间几何坐标、数学函数自变量与因变量、机器学习特征矩阵与标签向量,以及二维网格迭代点对。本文将逐层剖析这些惯例的起源、典型代码形态、高频踩坑点及规范化重构方案。
一、核心结论:代码上下文决定 xy 的真实身份
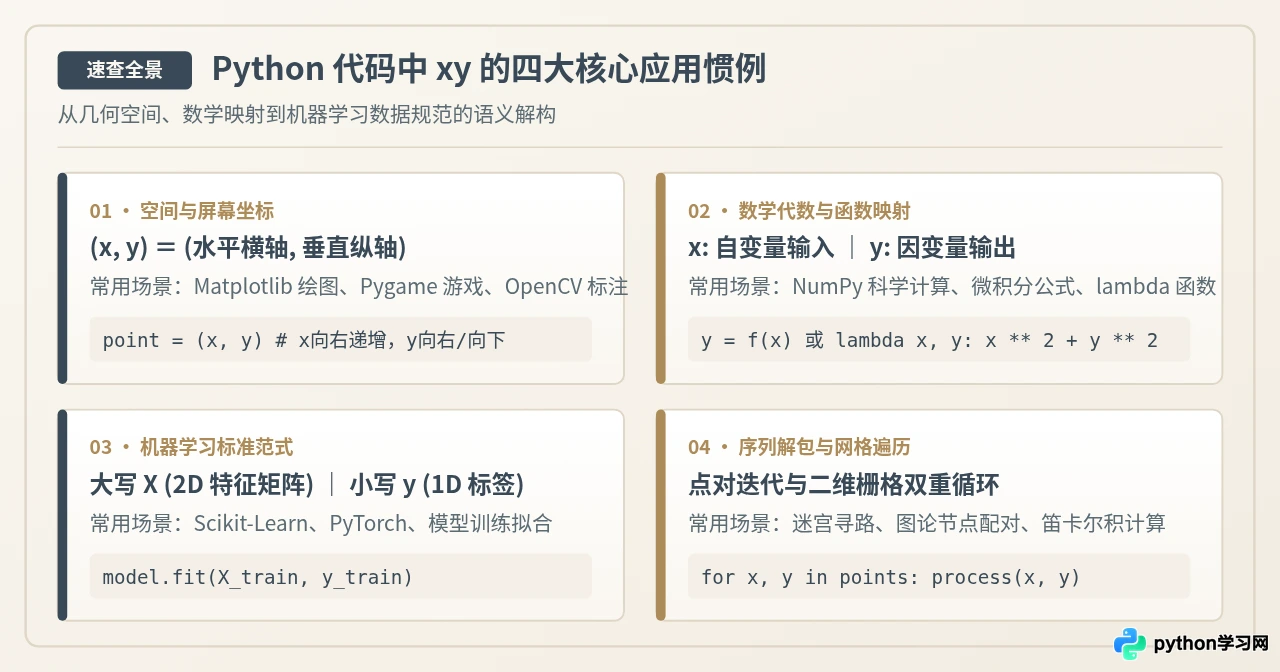
在 Python 中,解释器本身并不赋予变量名 x 或 y 任何特殊魔法,但数十年形成的科学计算、图形学与软件工程惯例,使得它们在特定语境下具备了高度统一的共识含义:
- 空间与屏幕坐标:表示二维平面上的一个点。
x代表水平横向坐标(由左向右增加),y代表垂直纵向坐标(在传统笛卡尔坐标系中向上增加,但在计算机屏幕/图像系统中向下增加)。 - 数学代数与函数映射:
x通常充当函数的自变量输入,y代表函数运算输出的因变量结果(即经典的 \(y = f(x)\))。 - 机器学习与数据科学:通常以大写
X表示样本特征矩阵(2D 数组),以小写y表示真实目标标签向量(1D 数组)。 - 序列解包与双重循环:在图论、游戏地图或栅格寻路算法中,
for x, y in points:或嵌套的for y in range(h): for x in range(w):用于遍历二维离散网格。
理解这些变量的关键,不在于死记单字符,而在于识别其所在代码段引入的第三方库及其绑定的数据结构形态。
二、几何与视觉图形:二维空间坐标体系
当代码中导入了图形渲染、游戏引擎或图像处理库(例如 Pillow、Pygame、OpenCV、Matplotlib 等)时,(x, y) 几乎无一例外代表几何平面中的定位点。
1. 屏幕坐标系与笛卡尔坐标系的方向差异
初学者容易忽略的一个物理细节是 Y 轴的正方向:
- 数学笛卡尔坐标系(如 Matplotlib 散点图/折线图):原点
(0, 0)位于左下角,向右为+X,向上为+Y。 - 计算机显示器与图像像素坐标系(如 Pygame、Pillow、OpenCV):原点
(0, 0)位于画布或屏幕的左上角,向右为+X,向下为+Y。
# 示例 1:在 Pillow (PIL) 中使用 (x, y) 坐标绘制图形
from PIL import Image, ImageDraw

# 创建一个 400x300 (宽x高) 的空白图像
img = Image.new("RGB", (400, 300), color="white")
draw = ImageDraw.Draw(img)

# 坐标点定义为 (x, y),表示距离左侧 x 像素,距离顶部 y 像素
center_x, center_y = 200, 150
radius = 30

# 绘制边界框:[左上角(x1, y1), 右下角(x2, y2)]
draw.ellipse(
    [center_x - radius, center_y - radius, center_x + radius, center_y + radius],
    fill="#AD8B58",
    outline="#394957"
)
在上述代码中,传递给绘图 API 的元组必须严格遵守 (x, y) 顺序,即横轴坐标在前、纵轴坐标在后。
三、易错重灾区:坐标 (x, y) 与矩阵内存索引 (row, col) 的颠倒陷阱
这是图像处理与科学计算领域最为臭名昭著的错误来源。当开发者在 NumPy 数组与图形视觉库(如 OpenCV)之间传递数据时,常常因为混淆了“几何坐标”与“数组索引”而导致程序崩溃或图像扭曲。
1. 为什么会发生颠倒?
核心矛盾来自于两种观察视角的不同:
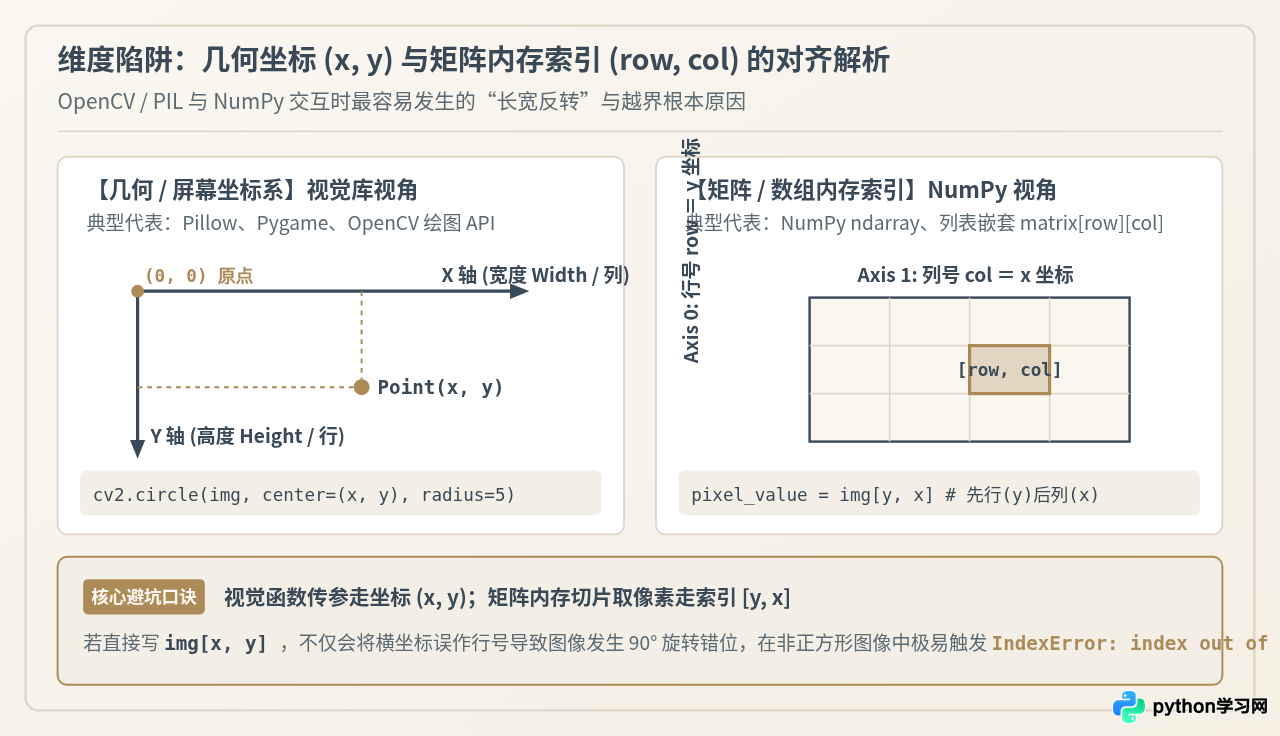
- 几何/绘图 API 的习惯:以观察者视角看平面,先说横向宽度(X 坐标),再说纵向高度(Y 坐标),因此函数接口接受
point = (x, y)。 - 数组/矩阵内存存储的习惯:以线性代数行优先(C-contiguous)存储,第一个维度是行号(Row,沿垂直方向向下计数),第二个维度是列号(Col,沿水平方向向右计数)。
因为垂直方向的行号(Row)对应的是 Y 坐标,而水平方向的列号(Col)对应的是 X 坐标,这就构成了铁律映射:
行号(Row) = y 坐标(高度方向 Height)
列号(Col) = x 坐标(宽度方向 Width)
因此:二维数组取像素点 (x, y) 的正确语法是:array[y, x] 或 array[row, col],切勿写成 array[x, y]!
2. 代码对比演示:正确与错误写法
import cv2
import numpy as np

# 创建一张高度 300、宽度 500 的 3 通道图像 (H, W, C)
# 注意:NumPy 创建数组时形状为 (行数/高度, 列数/宽度, 通道数)
h, w = 300, 500
canvas = np.zeros((h, w, 3), dtype=np.uint8)

# 假设我们在坐标 (x=450, y=100) 处操作
x, y = 450, 100

# 场景 A:使用 OpenCV 绘图函数(以几何坐标传参)
# OpenCV 接受的参数形式是 (x, y)
cv2.circle(canvas, center=(x, y), radius=10, color=(0, 255, 0), thickness=-1)

# 场景 B:直接修改 NumPy 像素矩阵(必须是 [y, x]!)
canvas[y, x] = [255, 255, 255]  # 正确写法:先行(y)后列(x)

# 场景 C:常见致命错误(颠倒为 [x, y])
# canvas[x, y] = [0, 0, 255]
# 执行会抛出错误:IndexError: index 450 is out of bounds for axis 0 with size 300
# 因为 axis 0 最大下标只有 299,把 x=450 传给第 0 轴必然越界!
四、数据科学与机器学习:大写 X 与小写 y 的行业规范
在以 scikit-learn、PyTorch、TensorFlow 为代表的数据挖掘与机器学习项目中,经常能看到形如 X_train, y_train 的变量命名。这里的 X 为大写,而 y 为小写,是有严格规范背景的。
1. 为什么 X 大写而 y 小写?
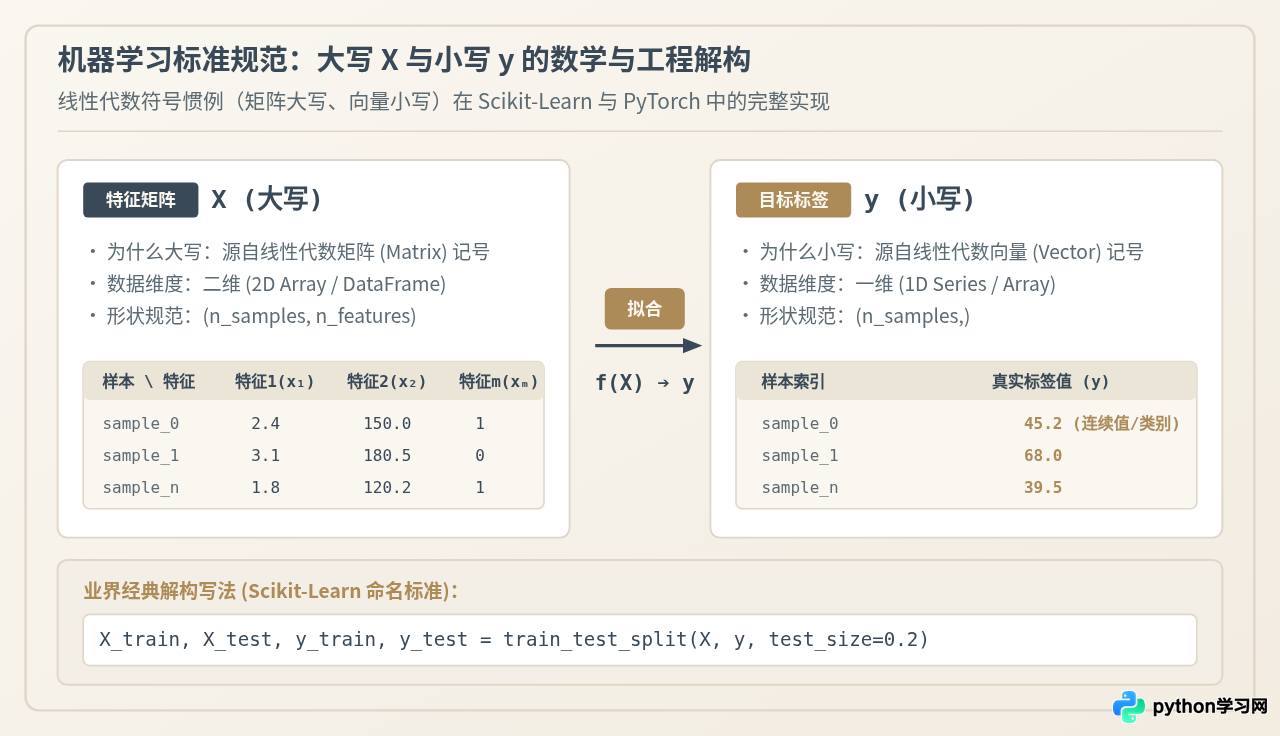
这一惯例直接承袭自线性代数(Linear Algebra)的数学符号规范:
- 矩阵(Matrix)用大写英文字母表示:在监督学习中,输入特征集合通常是一个二维数据表格(包含 \(n\) 个样本,每个样本具有 \(m\) 个特征),因此它在数学本质上是一个矩阵,记作 \(\mathbf{X} \in \mathbb{R}^{n imes m}\)。
- 向量(Vector)用小写英文字母表示:对于标准的单目标预测任务(如分类或回归),目标输出是每个样本对应的一个标签,整体构成一个长度为 \(n\) 的一维向量,记作 \(\mathbf{y} \in \mathbb{R}^{n}\)。
2. 工程实践中的标准写法
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
import numpy as np

# 构造模拟数据:1000 个样本,每个样本 8 个特征
# X 是二维数组 [1000, 8],y 是一维标签向量 [1000]
X = np.random.randn(1000, 8)
y = np.random.randint(0, 2, size=1000)

# 规范的数据集拆分解构
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 拟合与预测模型
clf = LogisticRegression()
clf.fit(X_train, y_train)          # 接受大写 X 和小写 y
predictions = clf.predict(X_test)  # 输入待预测特征矩阵 X_test
在团队协作中,切勿擅自将 X 改写为小写 x 或将 y 改为大写 Y。遵循这一规范能让任何具备机器学习背景的工程师在 1 秒内理解数据的维度与角色。
五、推导指南:在陌生代码中如何快速判断 xy 的真实含义
当阅读开源项目、老旧项目或未经充分注释的代码库时,遇到单独的 x, y 变量,可通过以下四步推导法准确还原其真实意图:
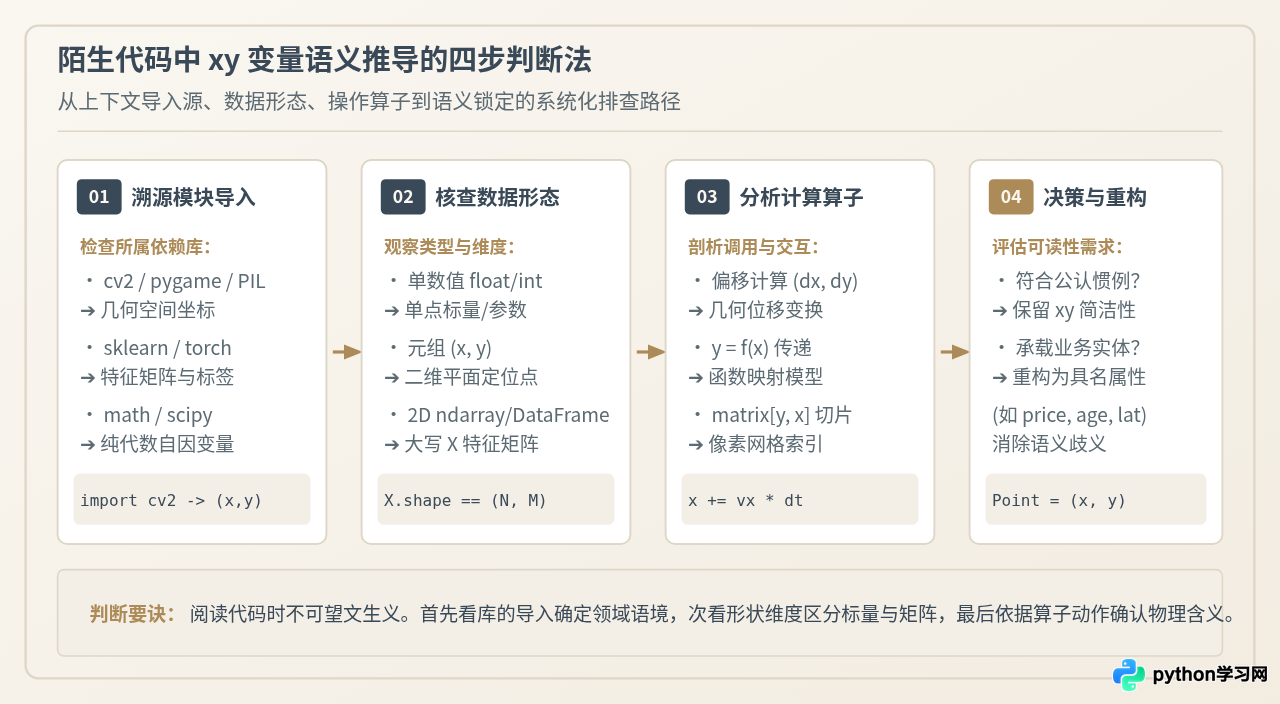
| 推导阶段 | 排查对象 | 典型特征举例 | 推断出的实际语义 |
|---|---|---|---|
| 第一步:溯源依赖 | 文件顶部的 import 声明 |
导入了 cv2, pygame, matplotlib导入了 sklearn, torch, scipy |
倾向于几何空间平面坐标 倾向于特征数据或数学函数 |
| 第二步:核查形态 | 变量的类型 type() 与形状 .shape |
(x, y) 为 2 元组或列表X 拥有 .shape == (N, M) 属性 |
平面点位坐标或栅格索引 机器学习样本特征矩阵 |
| 第三步:分析算子 | 变量参与的运算与方法调用 | 出现 x += speed_x, abs(x1 - x2)出现 matrix[y, x] 或 grid[y][x] |
物理位移或欧氏距离 二维内存网格与像素访问 |
| 第四步:确认决策 | 生命周期与作用域广度 | 仅在 3 行以内的局部列表推导或 lambda 中 贯穿数十行且传递给外部业务模块 |
符合惯例,允许保持简洁 反模式,建议重构成具名对象 |
六、工程规范与重构建议:何时沿用 xy,何时坚决杜绝?
在编写高质量 Python 代码(Clean Code)时,变量命名既不能盲目追求冗长,也不能过度依赖模糊缩写。
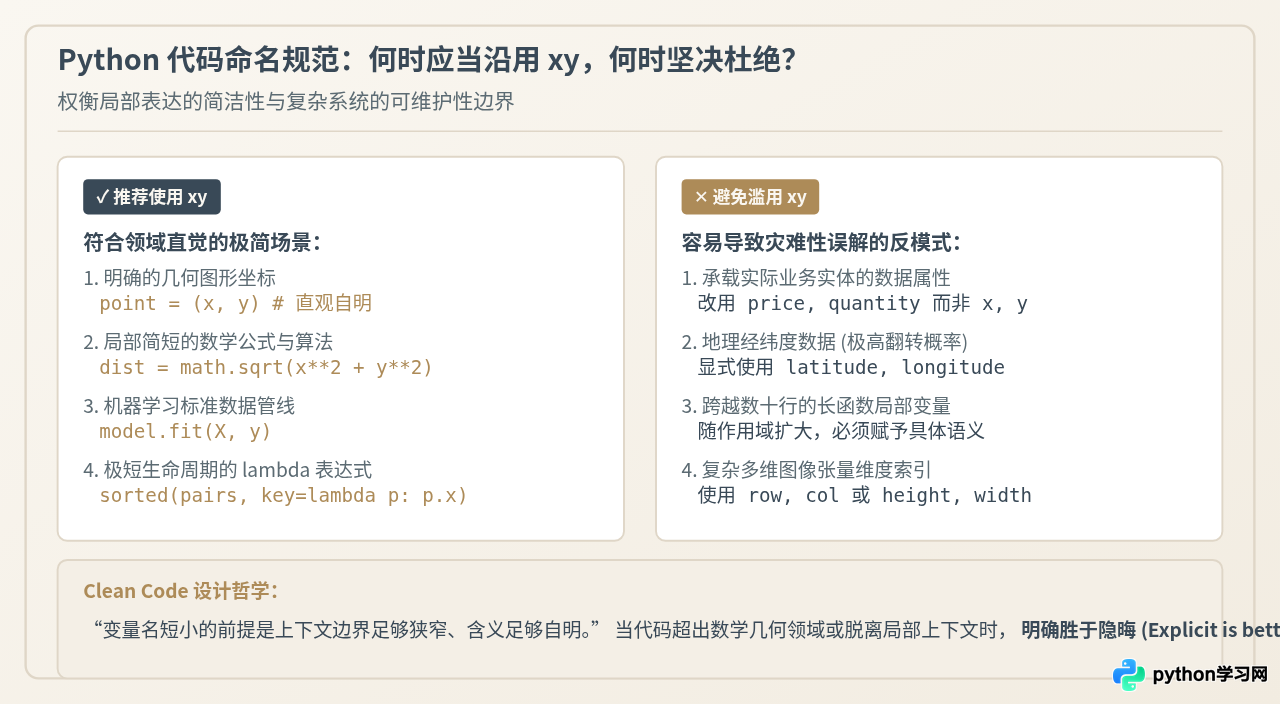
1. 推荐沿用 xy 的场景
- 严格限定在二维几何空间:例如坐标点抽象
Point(x, y)、平面距离计算math.hypot(x2 - x1, y2 - y1)。 - 简短数学函数与局部公式:如微积分导数实现、代数多项式计算、极值查找。
- 无歧义的极短 lambda 表达式:如
points.sort(key=lambda p: (p.x, p.y))。 - 标准机器学习接口适配:如实现自定义 Estimator 或数据加载器时的
fit(self, X, y)。
2. 坚决杜绝使用 xy 的典型反模式
- 具有实际业务含义的实体数据:切忌将“商品单价”与“购买数量”命名为
x, y,必须显式命名为unit_price和quantity。 - 地理信息系统(GIS)经纬度:地理坐标中经度(Longitude)对应水平 X 轴,纬度(Latitude)对应垂直 Y 轴。但业内常常有人习惯口头说“纬度/经度”,导致
(lat, lon)与(x, y)混杂引发系统性翻转。在 GIS 代码中,强烈要求强制使用latitude与longitude,切忌简写为 x, y。 - 高维张量索引:在深度学习图像处理中,维度通常为
(batch_size, channels, height, width),在做切片或转置时应明确使用h, w或height, width,避免使用x, y引起维度混淆。
3. 使用现代 Python 特性提升可读性
当坐标点需要跨越函数传递时,建议避免使用裸元组 (x, y),而改用 NamedTuple 或 dataclass,并配合类型提示(Type Hinting):
from typing import NamedTuple
from dataclasses import dataclass

# 方案 A:使用 NamedTuple(轻量、不可变、兼具元组解包特性)
class Point(NamedTuple):
    x: float
    y: float

# 方案 B:使用 dataclass(可变或需要附加丰富方法)
@dataclass(slots=True)
class Vector2D:
    x: float
    y: float

    def magnitude(self) -> float:
        return (self.x ** 2 + self.y ** 2) ** 0.5

# 使用具名结构,既支持 p.x 属性访问,也彻底杜绝顺序混淆
p = Point(x=120.5, y=85.0)
print(f"X坐标: {p.x}, Y坐标: {p.y}")
七、常见疑难问题排查清单 (FAQ)
Q1: 在 Matplotlib 绘图时,调用 plt.imshow(matrix) 与 plt.plot(x, y) 为什么会位置错位?
解答:这正是坐标与矩阵的原点差异造成的。plt.plot(x, y) 默认采用直角坐标系,Y 轴向下为负、向上为正,原点在左下角;而 plt.imshow() 显示图像矩阵时,默认原点在左上角,Y 轴向下递增。若需要统一,可以在调用 imshow 时显式配置 origin='lower',使其原点恢复至左下角与数学笛卡尔坐标系统保持一致。
Q2: 在遍历二维列表或网格时,双层循环的变量用 x, y 还是 row, col 更不易出错?
解答:推荐优先使用 for row in range(num_rows): for col in range(num_cols):。因为循环体内部访问数据几乎必然使用 grid[row][col],使用 row, col 能在心智模型中直接与下标对应,彻底消除 grid[x][y] 造成的行列颠倒隐患。
Q3: 三维空间中的坐标变量如何扩展?
解答:在空间几何中自然扩展为 (x, y, z),分别代表横轴、纵轴与垂直于平面的深度轴。但在三维张量(如体数据或视频序列)存储中,通常对应的是 [depth, height, width] 或 [z, y, x],同样需要格外注意内存轴向与几何轴向的映射对应关系。
© 本文遵循 Python 核心工程实践与 Clean Code 设计原则。规范命名、厘清坐标与维度差异,是编写健壮、可维护代码的基础素养。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















