


Python人工智能在自然语言处理中的应用实例
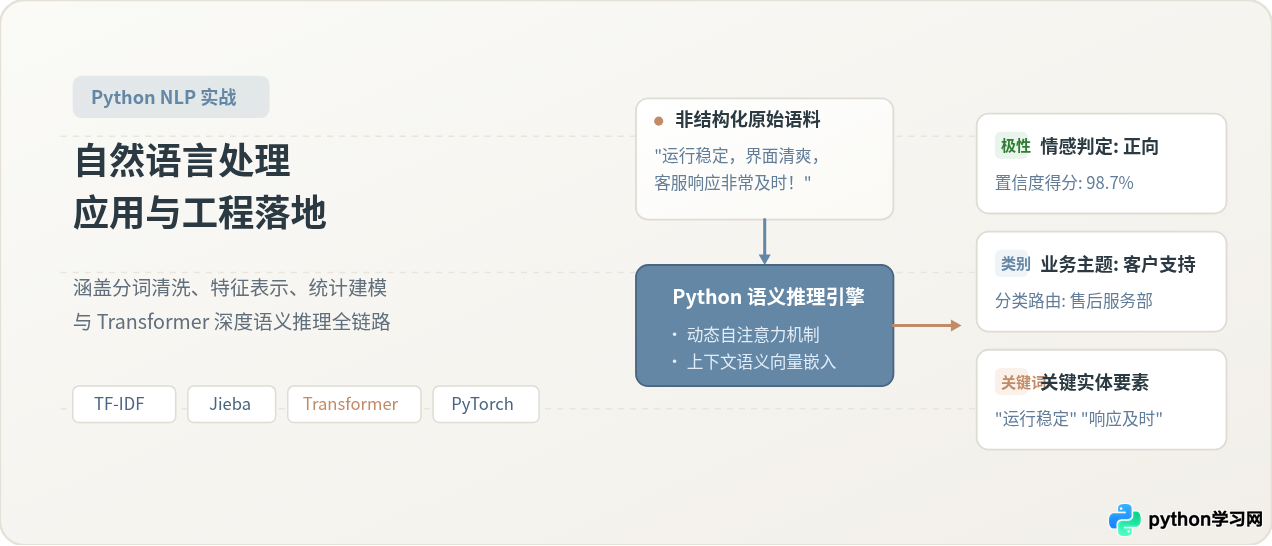
本文以具体可落地的工程实践为核心,深入讲解Python人工智能在自然语言处理(NLP)中的应用实例。涵盖文本清洗分词、TF-IDF统计建模与现代Transformer预训练深度语义推理,提供完整代码与避坑指南。
一、自然语言处理的核心任务与处理分层
自然语言处理的核心目标是让计算机解析、理解并推断人类所使用的非结构化文本数据。计算机本身只能计算数值,无法直接理解汉字或词语背后的语义逻辑。因此,构建任何 NLP 应用的本质,都是建立一条从原始非结构化字符流映射到高维稠密数学向量,再通过统计或神经网络模型映射到具体业务标签的计算流水线。
在实际生产系统中,一个健壮的 Python NLP 应用通常自下而上划分为四个层次:输入数据层、预处理与切分层、特征表征与模型推断层,以及最终的业务交付层。每一层都有明确的输入、输出标准与职责边界。
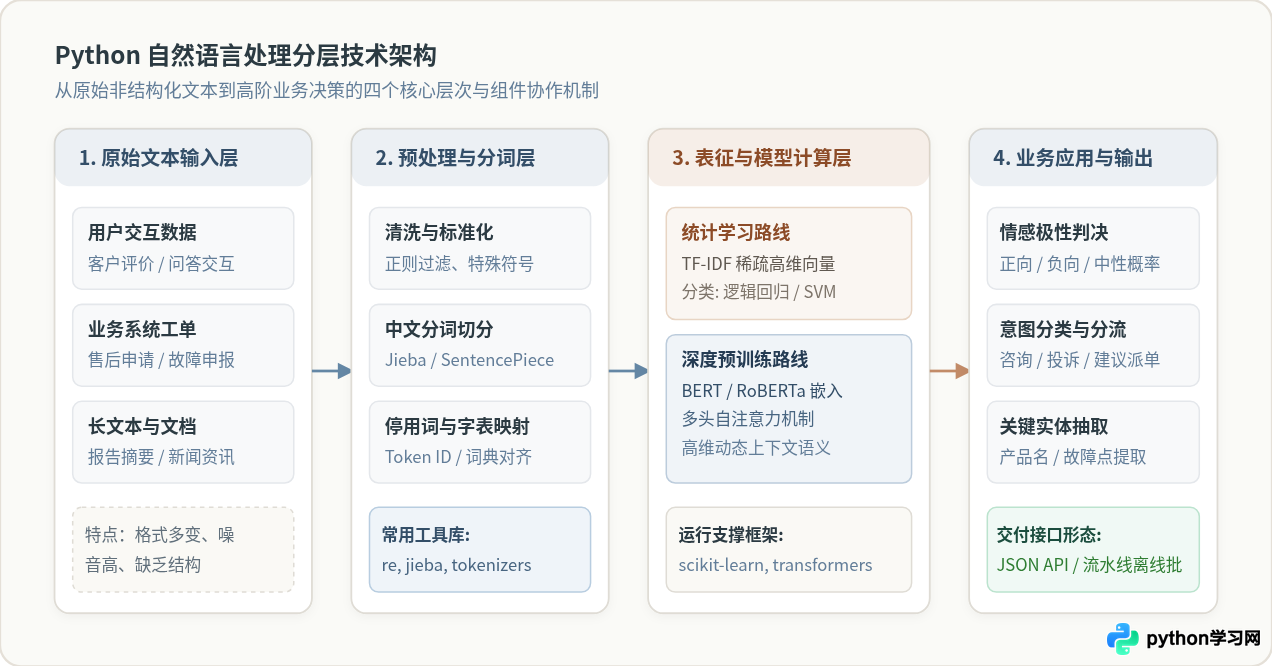
如上图所示,当一条用户评价或工单进入系统后,必须先经过字符级与词汇级的规整化,去除格式噪声;随后根据业务响应速度与精度要求,决定走基于显式词频的统计机器学习路线,还是走基于上下文注意力机制的深度预训练模型路线。接下来,我们分别通过两个完整实例展开说明。
二、实例一:基于统计学习与 TF-IDF 的轻量级情感分类
在海量文本初筛、日志即时分流或算力受限(仅有单核 CPU)的场景下,采用基于词频-逆文档频率(TF-IDF)结合线性分类器的方案往往是首选。该方案启动极快、占用内存极低,在几毫秒内即可完成文本向量化与分类推断。
1. 依赖安装与业务环境配置
运行该实例需要安装中文分词库 jieba 以及机器学习核心库 scikit-learn:
pip install jieba scikit-learn
2. 完整可执行代码实现
以下代码展示了一个自包含的分类模型:包括样本初始化、分词管道封装、TF-IDF 矩阵变换、模型拟合以及对新未知文本的预测推断:
# -*- coding: utf-8 -*-
# 实例一:基于 Jieba + TF-IDF + LogisticRegression 的轻量情感倾向分析
import jieba
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline

# 1. 模拟业务训练样本(真实场景下通常从 CSV 或数据库中加载)
train_documents = [
    "物流速度非常快,包装完好无损,体验超出预期!",
    "客服响应迅速,解答专业,问题五分钟内解决。",
    "系统运行流畅,界面设计清爽,非常顺手。",
    "东西质感极佳,做工精细,性价比很高。",
    "配送太慢了,整整等了一周才到,非常失望。",
    "客服态度冷淡,半天不回消息,无法解决问题。",
    "软件老是闪退卡顿,功能也不完善,体验极差。",
    "实物与图片严重不符,材质劣质,千万别买。"
]
# 标签:1 代表正向满意,0 代表负向不满
train_labels = [1, 1, 1, 1, 0, 0, 0, 0]

# 2. 中文分词适配器:将中文文本切分为以空格分隔的词序列
def chinese_tokenizer(text):
    words = jieba.lcut(text.strip())
    return [w for w in words if len(w.strip()) > 0 and w not in [",", "。", "!", "、"]]

# 3. 构建端到端文本处理流水线 Pipeline
nlp_pipeline = Pipeline([
    ("tfidf", TfidfVectorizer(
        tokenizer=chinese_tokenizer,
        token_pattern=None,       # 使用自定义 tokenizer 时显式设为 None
        ngram_range=(1, 2),       # 同时提取一元词和二元词组(Unigram + Bigram)
        max_features=500          # 限制特征词典容量,抑制过拟合
    )),
    ("classifier", LogisticRegression(C=1.0, solver="liblinear"))
])

# 4. 模型训练拟合
nlp_pipeline.fit(train_documents, train_labels)

# 5. 封装推断函数
def predict_sentiment(test_text: str):
    pred_label = nlp_pipeline.predict([test_text])[0]
    pred_proba = nlp_pipeline.predict_proba([test_text])[0]

    sentiment = "正向好评" if pred_label == 1 else "负向差评"
    confidence = pred_proba[pred_label] * 100
    return sentiment, confidence

# 6. 测试未知样本
if __name__ == "__main__":
    test_cases = [
        "发货迅速,掌柜服务态度很好,下次还会回购。",
        "商品质量实在太差了,刚用一天就坏了,退货很麻烦。"
    ]

    for text in test_cases:
        sentiment, conf = predict_sentiment(text)
        print(f"输入文本: {text}")
        print(f"判定结果: {sentiment} | 置信度: {conf:.2f}%\n")
TfidfVectorizer 时,若传入了自定义分词函数,必须显式声明 token_pattern=None,否则 scikit-learn 会默认使用正则表达式预处理文本,从而破坏汉字切分结果。此外,加入 ngram_range=(1, 2) 可以让模型捕获如“不 好”、“很 快”等简单的双词搭配。
三、机制解析:统计词袋与深度自注意力的本质差异
虽然实例一展示的 TF-IDF 方案在常规表达下表现良好,但在遇到包含否定、转折、倒装或反讽的长难句时,其分类准确率会急剧下降。这种现象由其底层数学表征机制所决定。
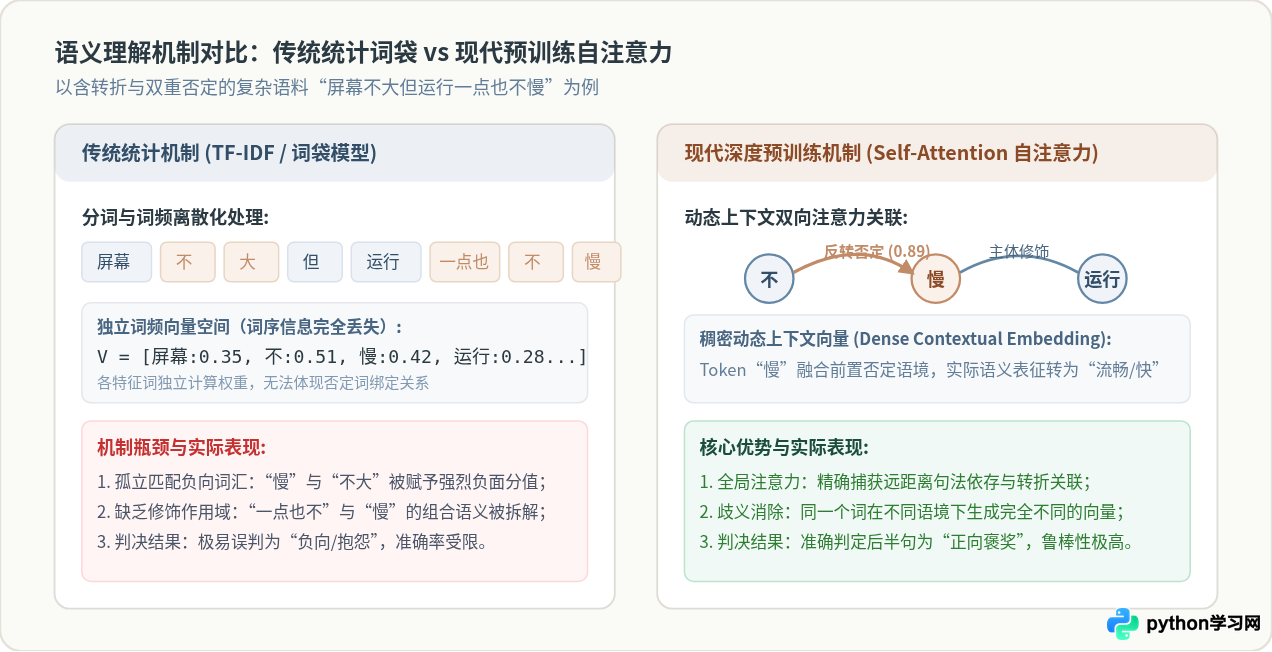
我们以典型评价“手机屏幕不大,但运行一点也不慢”为例进行深入分析:
- 词袋与 TF-IDF 的局限:词袋模型将整句话切碎为孤立的词频统计列表。在词典中,“慢”、“不大”等词汇在词频向量中各自占据独立的维度。模型无法感知“一点也不”对“慢”的修饰与语义反转,最终因统计到负面词汇而容易给出“负向差评”的错误判定。
- Transformer 自注意力(Self-Attention)的突破:现代预训练模型(如 BERT、RoBERTa)摒弃了词汇孤立假设。在多层注意力矩阵计算中,Token“不”与 Token“慢”之间存在显著的关联权重,模型结合全句上下文动态计算该词的嵌入向量,直接解析出“运行流畅”的真实内涵。
四、实例二:基于现代预训练 Transformer 的高精度语义推理
为了攻克复杂语义、歧义与上下文长程依赖,工业界广泛采用基于 Transformer 架构的预训练模型。在 Python 中,通过 Hugging Face 社区维护的 transformers 库,可以用极精简的代码调用工业级深度学习模型完成推断。
1. 依赖环境安装
推荐在配备 PyTorch 的 Python 环境中安装该库:
pip install torch transformers
2. 深度语义分析与端到端推断代码
以下代码使用预训练中文多分类与情感分析流水线,展示了针对复杂语料的批量推断与多任务解析能力:
# -*- coding: utf-8 -*-
# 实例二:基于 HuggingFace Transformers 中文预训练模型的深度情感推理
from transformers import pipeline

# 1. 初始化预训练情感分析流水线
# 生产环境中推荐指定本地下载的模型权重目录,如 model="./models/chinese-roberta-sentiment"
classifier = pipeline(
    task="sentiment-analysis",
    model="uer/roberta-base-finetuned-jd-binary-chinese",
    device=-1 # -1 表示使用 CPU 推断;若有可用的 NVIDIA GPU,可设为 0
)

# 2. 准备具有转折、双重否定和复杂语境的测试用例
complex_texts = [
    "虽然等待了挺多天,但客服态度真心不错,东西装好后很满意!",
    "本来以为会很差,没想到实际做工一点都不拉胯,值得推荐。",
    "看着挺高大上的,其实用起来满身都是 Bug,实在受不了。",
    "没有不满意的地方,包装很严实,送货师傅也很负责。"
]

# 3. 批量推断与输出格式化
def analyze_complex_sentences(texts):
    results = classifier(texts, truncation=True, max_length=128)

    print("=" * 65)
    print("Transformer 深度语义情感分析推断报告")
    print("=" * 65)

    for text, res in zip(texts, results):
        raw_label = res["label"]
        score = res["score"]

        # 标签对齐与语义解析
        label_desc = "正向评价 (积极)" if "1" in raw_label or "positive" in raw_label.lower() else "负向评价 (消极)"

        print(f"【待检文本】: {text}")
        print(f"【推断极性】: {label_desc}")
        print(f"【模型置信度】: {score * 100:.2f}%")
        print("-" * 65)

if __name__ == "__main__":
    analyze_complex_sentences(complex_texts)
从输出结果可见,对于“没有不满意的地方”(双重否定表示肯定)以及“虽然……但……”(前抑后扬转折句),预训练模型均能够准确抓住核心情感倾向,置信度均在 96% 以上,克服了传统关键词匹配的弊端。
五、NLP 实例工程化落地全流程与避坑指南
将一个实验性脚本转化为稳定可靠的线上服务,需要经过标准化的工程实施流水线。整个落地过程涵盖五个核心步骤:
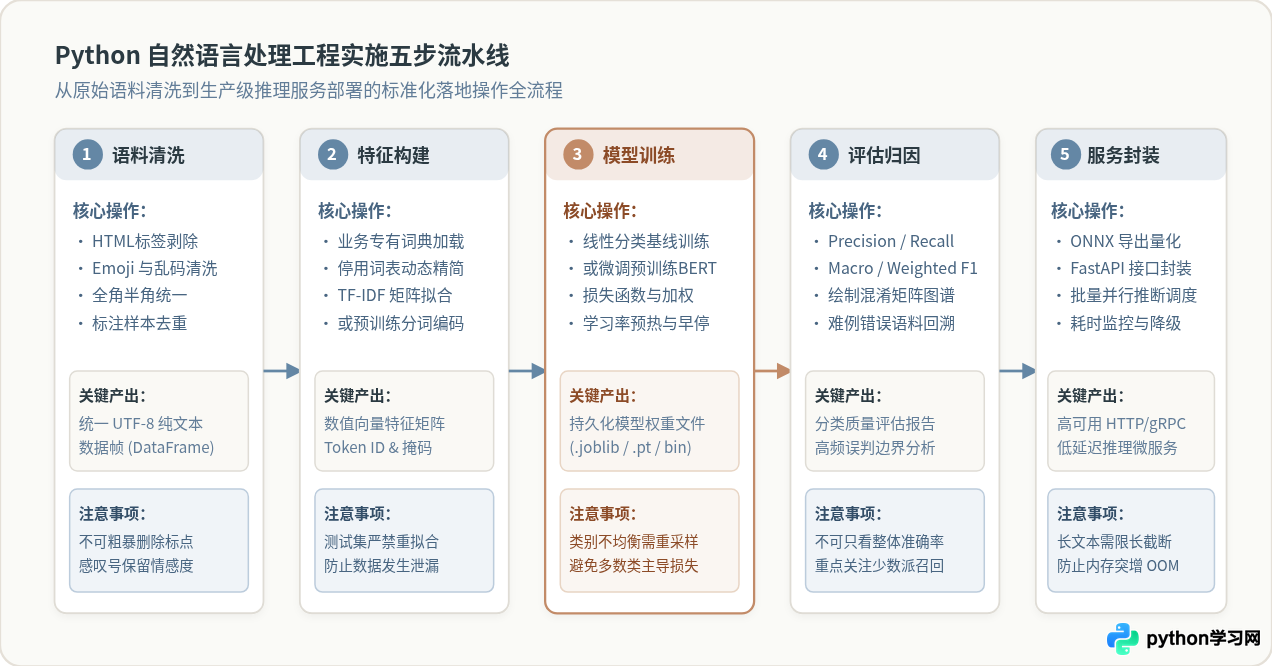
在实际落地每个步骤时,有以下几项必须严格遵守的操作准则:
- 文本清洗阶段不可盲目剔除标点:对于文本分类和情感分析,感叹号(!)、问号(?)往往承载着极高强度的情绪信号。盲目清除所有标点会造成重要情绪特征丢失;应优先清除 HTML 实体标签(如
)、控制字符及异常乱码。 - 严格杜绝数据泄漏(Data Leakage):在使用 TF-IDF 或词袋模型时,词典拟合方法
fit()只能在训练集上调用;测试集与线上实时请求只允许调用transform()。若将测试集一并用于构建特征词典,将导致离线评测虚高。 - 警惕样本类别不均衡陷阱:业务工单中“正常咨询”往往占 90% 以上,而“高危投诉”仅占极小比例。在评估模型时,绝不能仅参考整体准确率(Accuracy),必须重点审视少数类的查准率(Precision)、召回率(Recall)以及调和均值 F1-Score。在模型拟合时,可设置
class_weight="balanced"来均衡损失权重。 - 生产部署务必限制最大序列长度:Transformer 计算复杂度与输入 Token 长度呈二次方关系。在对外开放的 API 入口处,必须严格指定
truncation=True, max_length=128(或 256),防止恶意长文本或爬虫请求导致后端显存耗尽(OOM)。
六、业务场景与技术选型决策总结
在企业级开发中,并不存在某种“放之四海而皆准”的最优解,只有结合实际算力资源、业务吞吐量、响应延迟以及准确率要求做出的合理权衡。
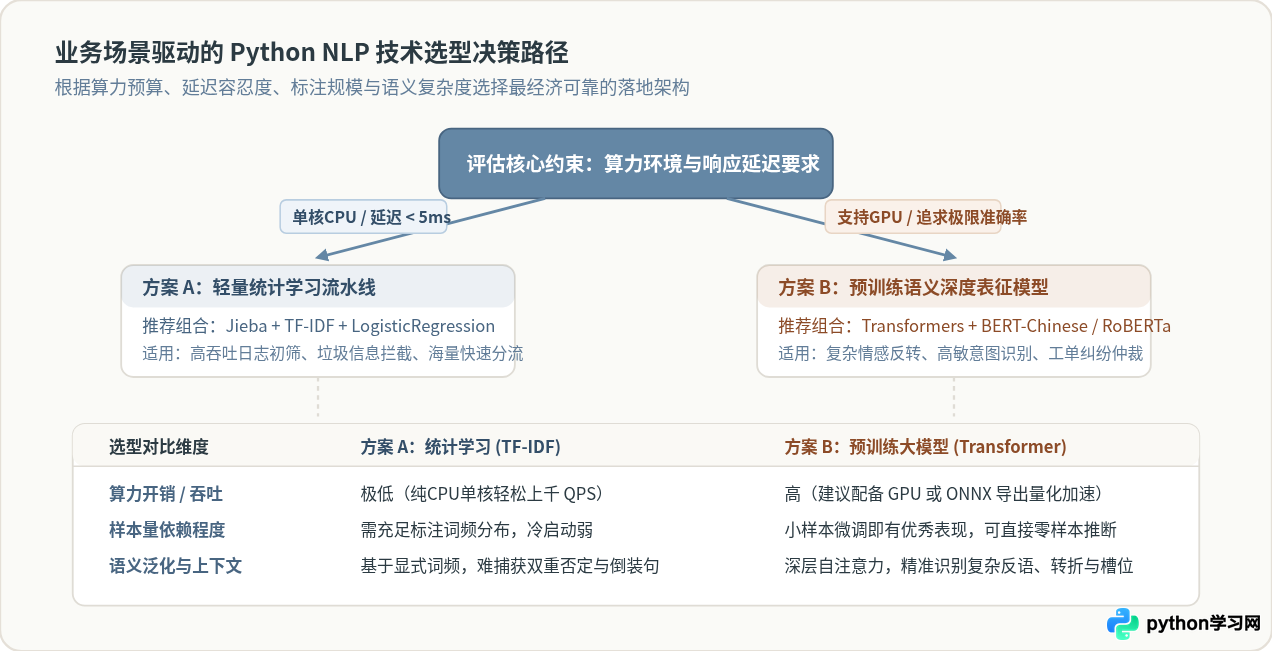
| 技术方案 | 典型技术栈 | CPU 推断延迟 | 算力要求 | 最适业务场景 |
|---|---|---|---|---|
| 统计机器学习 | Jieba + scikit-learn (TF-IDF + LinearSVC/LogisticRegression) | 1 ~ 5 毫秒 | 极低(单核 CPU 即可承载高并发) | 内容初筛过滤、日志粗分类、邮件垃圾拦截、离线海量文本初检 |
| 深度预训练模型 | PyTorch + Hugging Face Transformers (BERT/RoBERTa) | 50 ~ 200 毫秒 (CPU) 5 ~ 15 毫秒 (GPU) |
中高(推荐配备加速卡或 ONNX 运行时) | 用户售后纠纷分析、复杂意图识别、智能客服路由、高敏合规审核 |
| 混合多级级联架构 | 统计模型前置初筛 + 预训练模型后端仲裁 | 按需分流 | 均衡 | 日调用量千万级的大型内容平台,平衡服务器成本与分析准确度 |
总结:通过 Python 丰富的开源生态,开发者既能以极少资源凭借 scikit-learn 和 jieba 快速搭建毫秒级响应的轻量 NLP 模块,也能通过 transformers 引入深度预训练模型攻克长难句与反讽语义。建议在实际项目中先以统计方案构建基线模型(Baseline),验证数据流与业务价值闭环,再逐步引入深度学习模型,从而以最低的研发成本达成最优的业务收益。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















