


Python中is和==有什么区别?身份运算符与相等运算符解析
深入解析Python中身份运算符is与相等运算符==的核心区别,通过底层内存机制、CPython对象缓存细节以及实战代码示例,全面解析值比较与身份比较的应用边界与避坑指南。
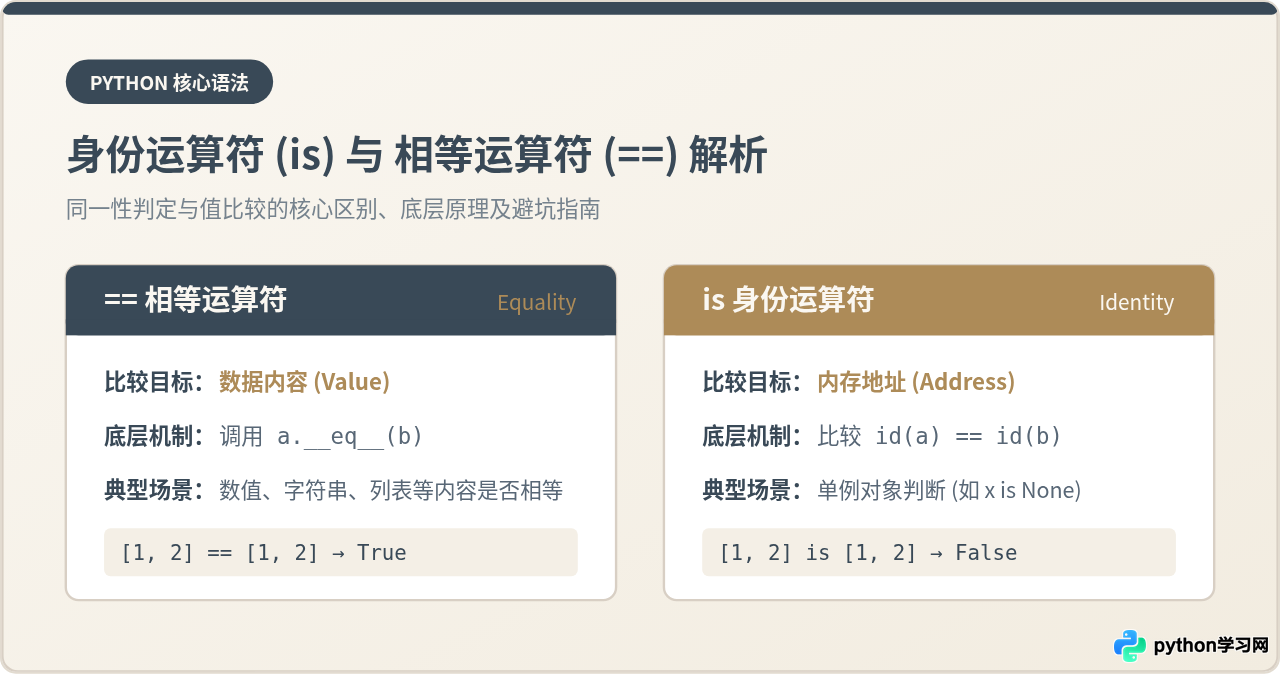
is 与 == 最根本的区别在于:== 是相等运算符,用于比较两个对象的内容(Value)是否相等;而 is 是身份运算符,用于比较两个变量是否指向内存中的同一个对象(Identity)。理解这两者的差异及其背后的内存机制,能够帮助开发者准确编写条件判断,避免在单例校验、常量优化及容器比较中产生难以察觉的Bug。
一、核心概念:值比较与身份比较
在编写条件判断时,初学者经常把 is 与 == 混用。虽然在某些特定情况下(例如小整数或短字符串比较)它们可能碰巧产生相同的布尔结果,但它们从底层原理到应用设计有着本质区别:
==比较的是“值”(Value):它关注两个变量所引用的数据内容在逻辑上是否一致。is比较的是“身份”(Identity):它关注两个变量是否完全指向同一个物理内存区域,即它们是否为同一个 Python 对象。
通过一个常见的可变对象(列表)示例,我们可以清晰地看到两者的行为差异:
# 运行环境:Python 3.8+ 交互式解释器或脚本
list_a = [1, 2, 3]
list_b = [1, 2, 3]
list_c = list_a

print("list_a == list_b:", list_a == list_b)
print("list_a is list_b:", list_a is list_b)
print("list_a is list_c:", list_a is list_c)list_a is list_b: False
list_a is list_c: True
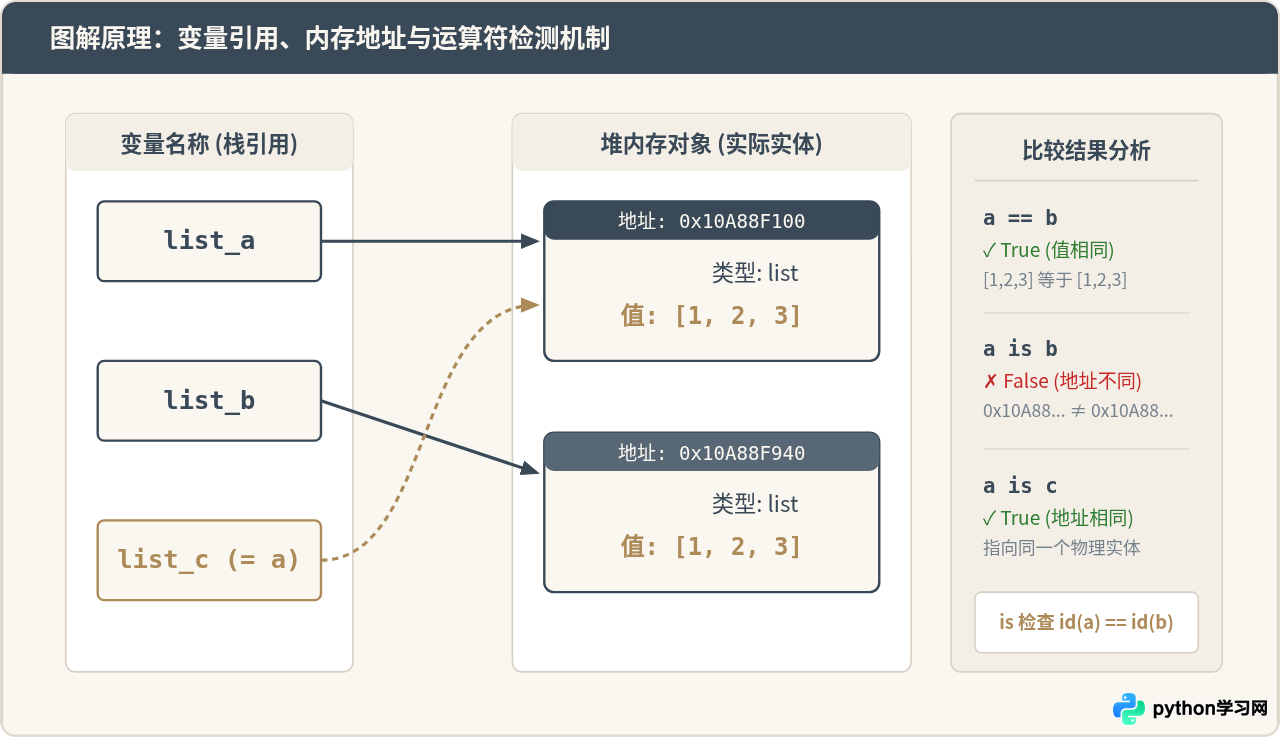
在上面的代码中,list_a 和 list_b 虽然内部元素完全相同,因此 list_a == list_b 为 True;但由于它们是分别创建的两个独立列表对象,在堆内存中拥有各自独立的内存块,因此 list_a is list_b 返回 False。而 list_c = list_a 只是创建了一个新的引用,它们共同指向同一块内存,因此 list_a is list_c 返回 True。
二、底层实现机制:id() 函数与魔术方法 __eq__()
要彻底搞懂两者的运作方式,需要深入到 Python 解释器的具体实现机制中。
1. 身份运算符 is 与 id() 函数
在 Python 中,每个对象都有唯一的标识符(Identity)。通过内置函数 id(obj) 可以获取该对象在生命周期内的整数标识。在 CPython 实现中,id(obj) 返回的就是该对象在 C 语言结构体层面的内存物理地址。
因此,表达式 a is b 在语义上完全等价于:
# is 的内部等价形式
id(a) == id(b)
is 运算是在 C 语言指针级别直接比对两个对象的内存地址指针,不会执行任何用户定义的 Python 代码,因此它的执行速度极快,时间复杂度恒定为 O(1)。
2. 相等运算符 == 与 __eq__() 方法
与 is 不同,== 是一个可重载的运算符。当执行 a == b 时,Python 解释器在底层实际上是在调用对象 a 的魔术方法 a.__eq__(b)。如果 a 没有实现该方法,或者该方法返回了 NotImplemented,解释器会尝试调用 b.__eq__(a)。
默认情况下,用户自定义的类如果不重写 __eq__() 方法,会直接继承 object.__eq__(),此时默认行为就是比较两个对象的身份(即退化为 is)。然而,标准库中的数值类型、字符串、元组、列表、字典以及数据类(dataclass)均重写了 __eq__(),使其逐项比对数据内容。
# 自定义类重写 __eq__ 示例
class User:
    def __init__(self, user_id, name):
        self.user_id = user_id
        self.name = name

    def __eq__(self, other):
        # 只要 user_id 相同,即视作逻辑相同的数据
        if isinstance(other, User):
            return self.user_id == other.user_id
        return False

u1 = User(1001, "Alice")
u2 = User(1001, "Alice")

print("u1 == u2:", u1 == u2)
print("u1 is u2:", u1 is u2)u1 is u2: False
三、什么时候用 is?什么时候用 ==?
在实际工程开发中,必须根据判定目标的性质严格选择运算符,切勿随意替代。
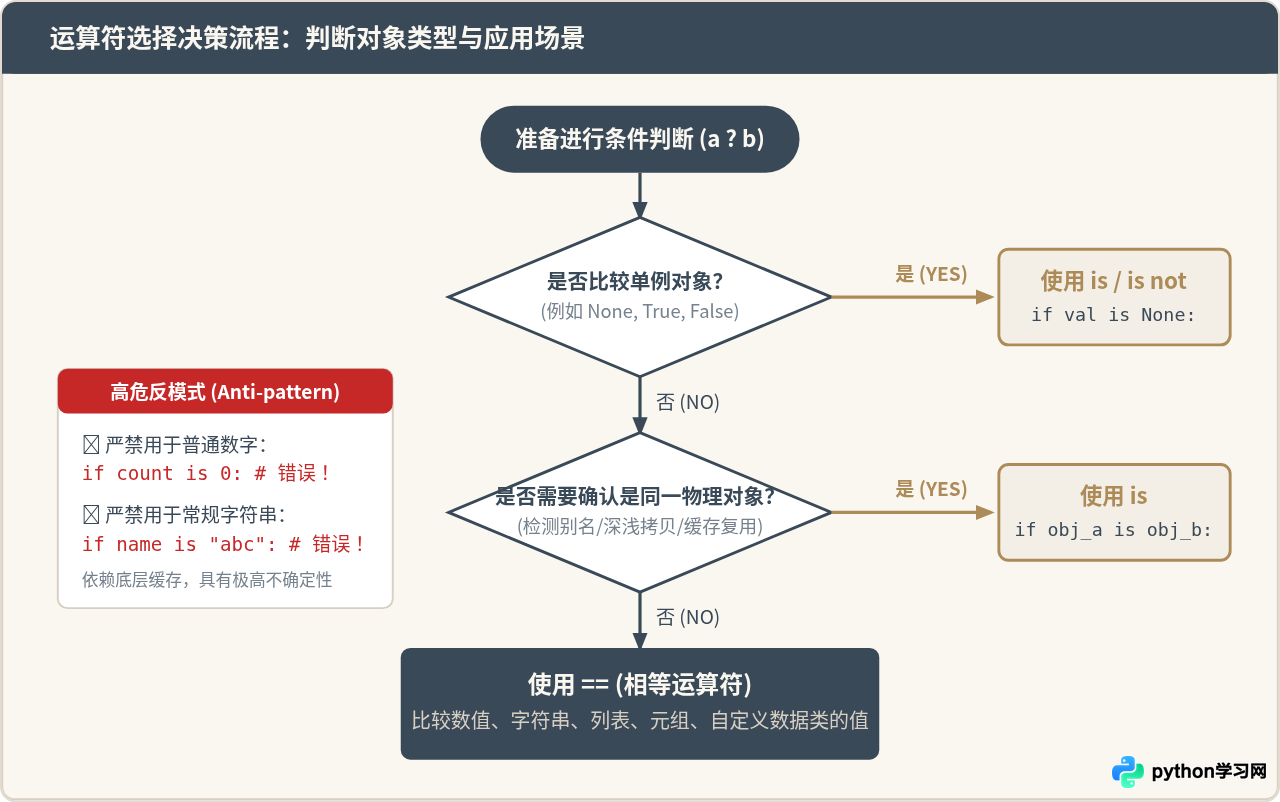
1. 必须使用 is 的场景:单例对象检查
在 Python 中,单例对象在全局范围内只存在一个唯一实例。最常见且最标准的用法是判断一个变量是否为 None:
# 规范推荐写法(符合 PEP 8 规范)
if result is None:
    pass

if result is not None:
    pass

# 不推荐写法(可能带来隐患)
if result == None:
pass因为
== 依赖对象的 __eq__() 实现。如果某个恶意或有缺陷的类重写了 __eq__ 并不管传参直接返回 True(例如某些第三方库为了实现特殊逻辑),那么 obj == None 将得到假阳性的 True。而 obj is None 则直接比对指针,绝不会被任何类的重载方法欺骗。此外,判断 True、False、Ellipsis(...)等单例时,同样优先使用 is。
2. 应该使用 == 的场景:数据与内容比较
在绝大多数常规业务逻辑中,我们需要比较的是数值的大小、字符串文本是否相同、列表或字典是否包含相同的键值对。此时必须使用 ==。
- 比较数字:
if count == 0: - 比较字符串:
if role == "admin": - 比较容器:
if user_ids == [101, 102]:
四、容易混淆的深坑:CPython 缓存机制与驻留陷阱
初学者最容易产生困惑的地方是:为什么有时候用 is 比较两个数字或字符串,居然也返回了 True?
1. CPython 的小整数对象池(Small Integer Cache)
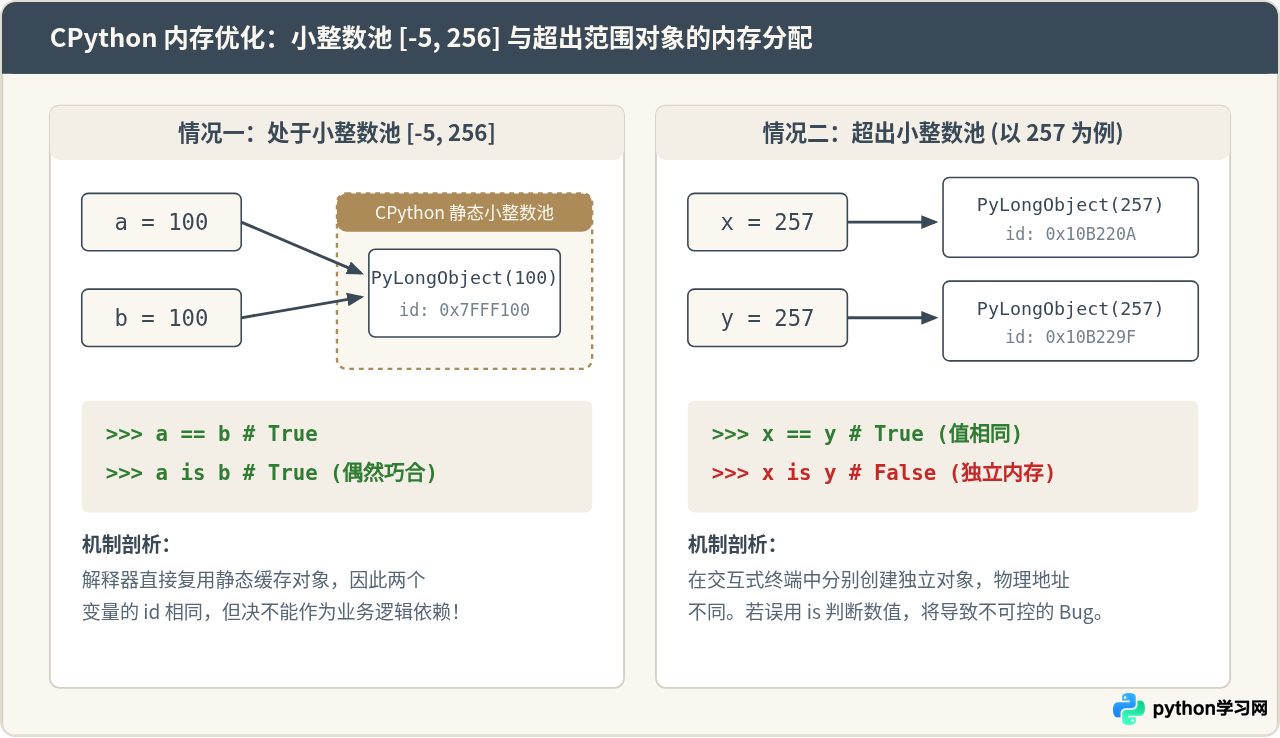
在官方 CPython 实现中,整数的使用频率极高。为了避免频繁创建和销毁常用整数对象带来的内存开销与碎片化,CPython 在启动时会预先在内存中分配一个连续的静态数组,缓存区间为 [-5, 256] 的所有整数对象。
只要代码中涉及这个区间的整数,CPython 都会直接返回已缓存的全局单例对象的引用。
# 在交互式 REPL 中逐行执行
>>> a = 256
>>> b = 256
>>> a is b
True

>>> x = 257
>>> y = 257
>>> x is y
False257 超出小整数池范围,解释器分别创建了两个独立的 PyLongObject 实例。
2. 代码块常量折叠(Code Block Optimization)
如果你把上述 x = 257; y = 257 写入同一个 .py 脚本文件执行,你会惊讶地发现 x is y 居然输出了 True!
这是因为 Python 编译器在编译整个代码块(如一个模块或一个函数体)时,会进行常量折叠与常量池去重。同一个代码块中相同的不可变字面量会被合并为一个常量,存储在该代码对象的 co_consts 元组中。但这属于 CPython 解释器的内部实现优化,不是 Python 语言规范所保证的特性。
3. 字符串驻留机制(String Interning)
类似地,CPython 会对长度较短且仅包含字母、数字和下划线的标识符风格字符串进行自动“驻留”(Interning),使得相同字符构成的字符串共享同一个内存对象。但是,对于包含空格、特殊符号或动态拼接生成的字符串,并不会自动驻留。
# 字符串驻留的不确定性
s1 = "hello"
s2 = "hello"
print("s1 is s2:", s1 is s2)  # 往往为 True(触发自动驻留)

s3 = "hello world!"
s4 = "hello world!"
# 在部分交互式终端中,s3 is s4 会返回 False!
print("s3 == s4:", s3 == s4)  # 始终为 True
print("s3 is s4:", s3 is s4) # 依赖环境与优化级别永远不要使用
is 来比较数值大小或字符串内容!即使你的代码在当前本地环境中因为常量优化运行“正常”,换到另一个环境、不同的 Python 版本(如 PyPy)、或改为动态输入(如从网络、文件或用户输入读取)时,is 会立即失效并返回 False,引发隐蔽生产事故。
五、关键特性速查与总结
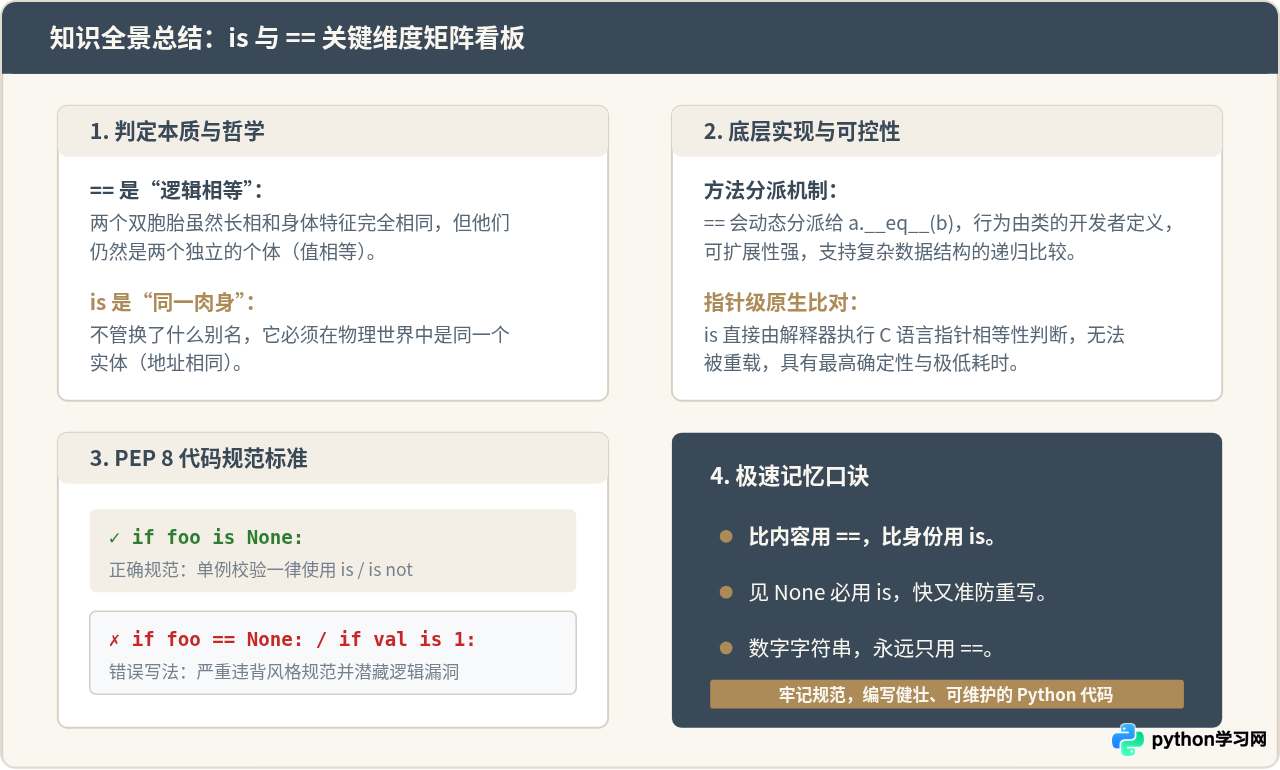
为了让读者能够在实际开发与面试中准确快速判断,我们将 is 与 == 的所有核心技术特征汇总为如下对比表:
| 对比维度 | is 运算符 | == 运算符 |
|---|---|---|
| 运算符类别 | 身份运算符(Identity Operator) | 相等运算符(Equality Operator) |
| 核心判定依据 | 内存地址(id(a) == id(b)) |
数据内容(逻辑值是否相等) |
| 底层实现机制 | C 语言底层直接比较对象内存指针 | 调用对象的魔术方法 __eq__() |
| 是否可被重写 | 不可被重载或篡改 | 可在类中通过重写 __eq__() 自定义 |
| 执行耗时与性能 | 极快,恒定时间复杂度 \(O(1)\) | 取决于对象的实现复杂度(如长列表比对需要 \(O(n)\)) |
| 最佳适用场景 | 校验单例(val is None)、变量是否指向同一实例 |
业务数值、文本内容、集合容器的数据相等性比对 |
| 典型误用风险 | 用来比较数字或字符串,受底层缓存与常量优化误导 | 比较单例时由于类重写 __eq__ 返回意外结果 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















