


Python怎么用open()函数打开和读取文件
详细解析Python中使用open()内置函数打开和读取文件的标准范式,涵盖with上下文管理、编码指定、四种常用读取方法对比、底层缓冲与游标机制,以及常见异常的排查与解决。
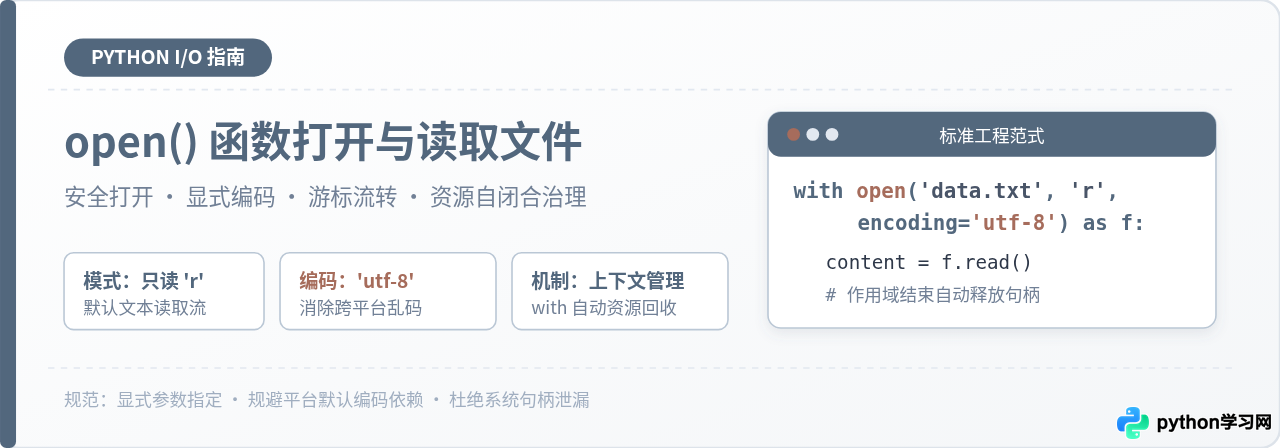
'r' 以及文本编码 encoding='utf-8',并在代码块内部根据文件体积选择 f.read()、f.readline()、f.readlines() 或直接对文件对象进行迭代。这样不仅能保证读取内容准确无乱码,还能在数据读取完毕或发生运行异常时,自动向操作系统归还文件句柄,避免资源泄漏。
一、标准打开语法与关键参数解析
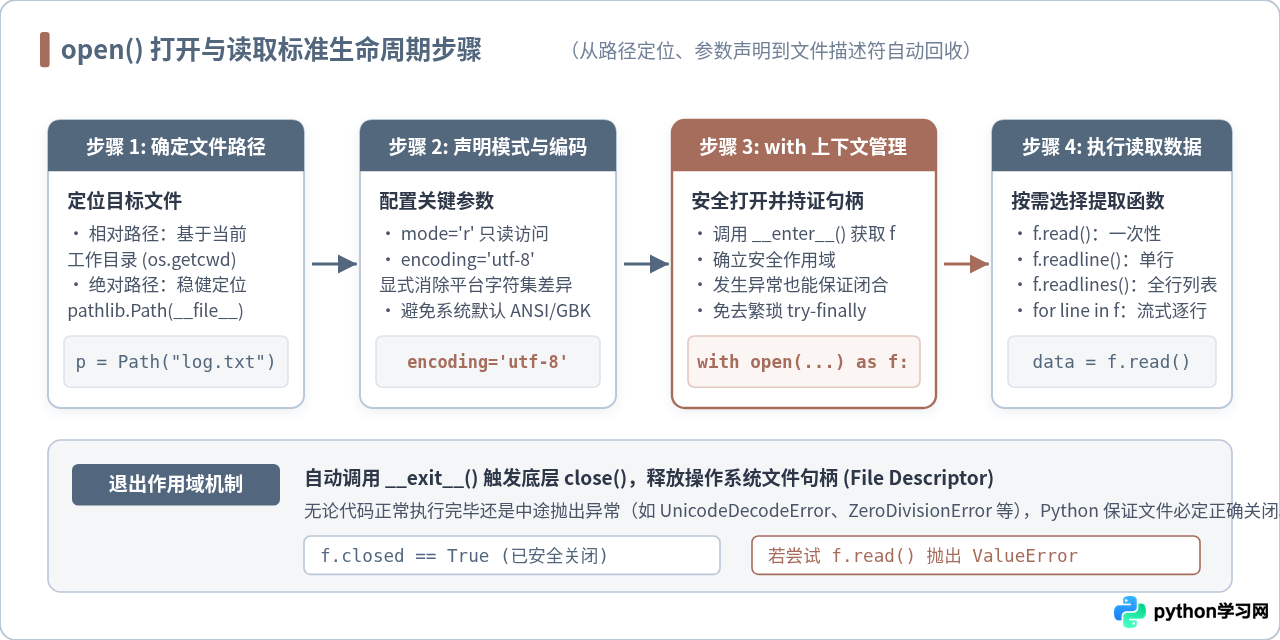
Python 内置的 open() 函数用于连接文件系统并返回一个文件对象(File Object)。初学者最容易书写两行直接赋值的代码,例如 f = open("data.txt"),随后调用 f.close()。这种方式虽然能跑通,但一旦在读取或处理数据的过程中发生异常(如格式解析失败、索引越界),后续的 close() 就无法被执行,导致该文件句柄在操作系统内核中长时间处于被占用状态。
在生产和日常开发中,必须统一采用 上下文管理器(Context Manager) 语法。其基础调用形式如下:
# 标准打开文件并读取的基础范式
with open("example.txt", mode="r", encoding="utf-8") as f:
    content = f.read()
    print(content)
# 离开 with 缩进块后,f 自动闭合,无需手动编写 close()
调用 open() 时,有三个最核心的参数必须清楚其含义与默认行为:
-
file(文件路径):目标文件的存放位置。可以使用相对路径或绝对路径。需要特别注意,相对路径是相对于当前终端的工作目录(Current Working Directory),而非 Python 脚本自身所在的目录。若脚本运行位置变动,极易产生
FileNotFoundError。 -
mode(打开模式):默认为
'r'(即只读文本模式)。虽然可以省略不写,但显式写出mode='r'能够大幅提高代码意图的可读性。只读模式要求目标文件必须事先存在,否则直接报错。 -
encoding(文本编码):强烈建议始终显式传入
encoding='utf-8'。如果省略该参数,Python 会回退使用操作系统平台默认的字符集:在 Linux 和 macOS 上通常是 UTF-8,而在简体中文 Windows 操作系统中则是 GBK。这种平台隐式差异是导致“代码在本地能跑,部署到服务器或他人电脑就报 UnicodeDecodeError”的罪魁祸首。
二、底层工作机制:流、缓冲区与文件游标
了解 open() 背后发生了什么,有助于在面对大文件或二进制数据时做出正确的决策。调用 open() 并不会立即把磁盘上的所有数据都搬进 Python 的变量中,而是完成了一套三层管道的装配:
- 操作系统内核层(OS Kernel):操作系统为当前进程分配一个整数形态的文件描述符(File Descriptor,如 fd=3),并在内核空间开辟与物理磁盘扇区映射的页缓存(Page Cache)。
-
Python 缓冲流(BufferedReader / TextIOWrapper):Python 的
io模块在用户态维护一个固定大小的内存缓冲区(通常为 8192 字节 / 8KB)。当执行读取时,底层一次性批量抓取 8KB 字节,随后由TextIOWrapper根据指定的编码算法将原始字节(Bytes)逐一解码为 Unicode 字符串。 -
游标指针(File Pointer):文件对象内部维护着一个以字节为单位的偏移量指针。每次读取操作都会让指针向后移动。当指针触达文件末尾(EOF,End of File)时,后续任何读取指令都将直接返回空字符串
''。
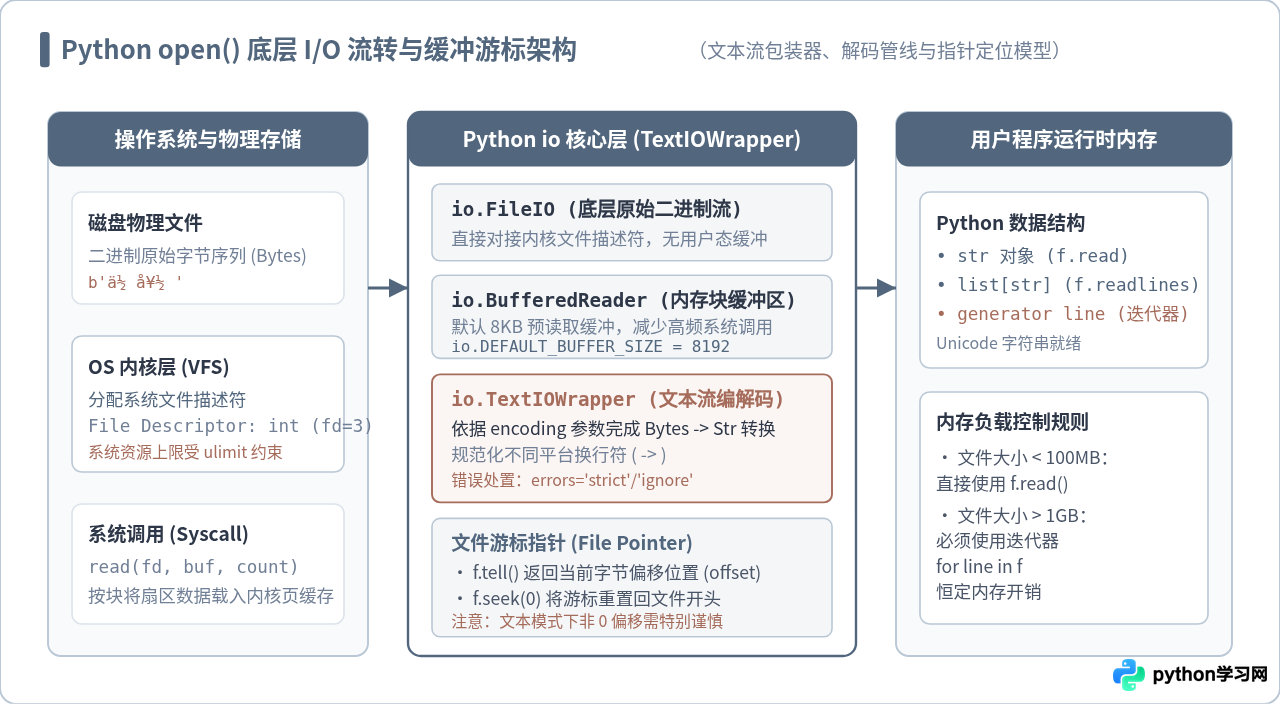
f.tell() 查询当前游标停留在第几个字节位置。若读取完毕后还想从头重新阅读,无需重新执行 open(),只需调用 f.seek(0) 即可将指针瞬间拉回文件起点。但在文本模式下,切勿使用非零数字随意 seek() 到多字节字符的中间,否则会破坏字符边界引发解码崩溃。
三、四种读取文件内容的方法与选型依据
拿到了文件对象 f 之后,Python 提供了多种从缓冲区中拉取字符串的方式。不同的方法在内存占用、返回值类型和适用场景上差异极大。
1. 全量读取:f.read([size])
不带参数时,f.read() 会从当前游标位置一直读到文件末尾,并将全部内容作为单一的字符串(str)返回。若传入正整数参数 size,则代表本次最多读取 size 个字符(在文本模式下按字符计算,在二进制模式下按字节计算)。
with open("config.json", "r", encoding="utf-8") as f:
    text_data = f.read()  # 一次性将全部字符放入内存
    print("文件总字符数:", len(text_data))
适用场景: 配置文件(JSON/YAML/INI)、小型文本模板或必须进行全篇正则匹配的场景。对于数百兆或数吉字节的大文件,绝不能直接使用无参 read(),否则瞬间引发 MemoryError。
2. 单行读取:f.readline()
f.readline() 每次仅从文件中截取一行文字,直到遇到换行符
为止。读取出的字符串会保留末尾的原生换行符。当文件已经读到末尾时,它会返回一个长度为 0 的空字符串 "",常用于 while 循环。
with open("server.log", "r", encoding="utf-8") as f:
    first_line = f.readline()  # 仅获取首行
    print("首行内容:", first_line.rstrip("
"))
适用场景: 探测 CSV 文件的首行表头、分段读取有特定边界标识的结构化文本。
3. 全行列表化:f.readlines()
f.readlines() 会遍历整篇文件,将每一行作为一个独立的字符串放入一个 Python 列表(list[str])中返回。每项末尾同样保留
。
with open("tasks.txt", "r", encoding="utf-8") as f:
    lines = f.readlines()
    print("总行数:", len(lines))
    # 可通过索引访问某一行,例如 lines[0], lines[-1]
注意事项: 虽然它提供了随机索引访问的便利,但由于同时构建了大量字符串对象和列表指针,其实际内存开销比 read() 还要高出约 30% 到 50%,只适合处理小文件。
4. 逐行惰性迭代:for line in f(工程推荐)
在 Python 中,文件对象本身就是一个可迭代对象(Iterable)。直接使用 for line in f 是处理文本文件最优雅、最高效的方式。底层由 C 语言实现的生成器机制驱动,每次迭代只在缓冲区就绪时 yield 出一行,处理完毕后即可被垃圾回收,内存占用始终维持在数 KB 的极低水平。
with open("access_huge.log", "r", encoding="utf-8") as f:
    for line_no, line in enumerate(f, start=1):
        clean_text = line.rstrip("
")
        if "ERROR" in clean_text:
            print(f"第 {line_no} 行告警: {clean_text}")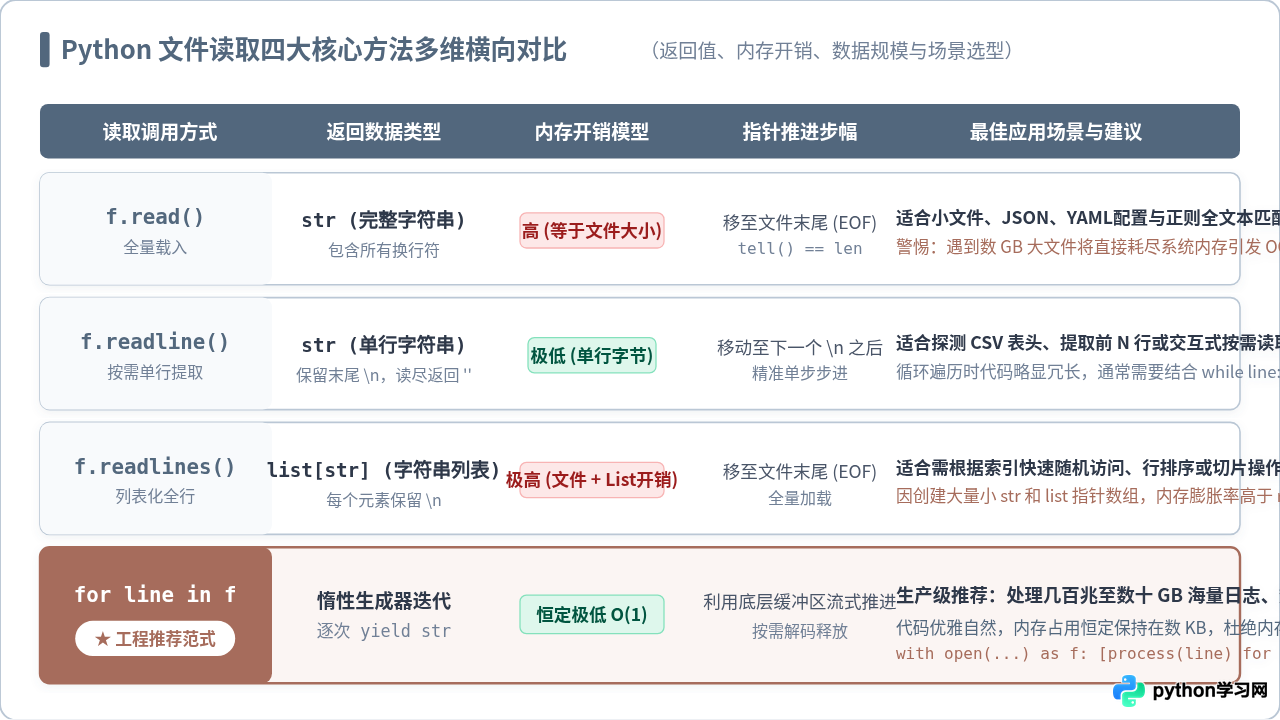
四、换行符细节与末尾空白处理
在文件读取中,新手经常发现打印出的每一行之间都有一个多余的空行。这是因为从文件读出的每行末尾都自带了操作系统原生换行符(Linux 为
,Windows 为
),而 Python 的 print() 函数默认又会附带一个
。
要去除这个冗余的换行符,不要直接使用粗暴的 strip(),因为它会连同文本行首和行尾原本具有语法意义的缩进空格或制表符一并抹除。正确的做法是使用精确匹配的右侧截断:
# 推荐写法:仅剔除末尾的换行符,保留开头的缩进空格
line_content = raw_line.rstrip("
")

# 或者让 print 不再额外追加换行符
print(raw_line, end="")
五、常见报错原因排查与健壮性编写
在真实运行环境中,文件 I/O 极容易受到外部文件系统状态的影响。以下是使用 open() 时最常碰到的四种错误及防御方案:
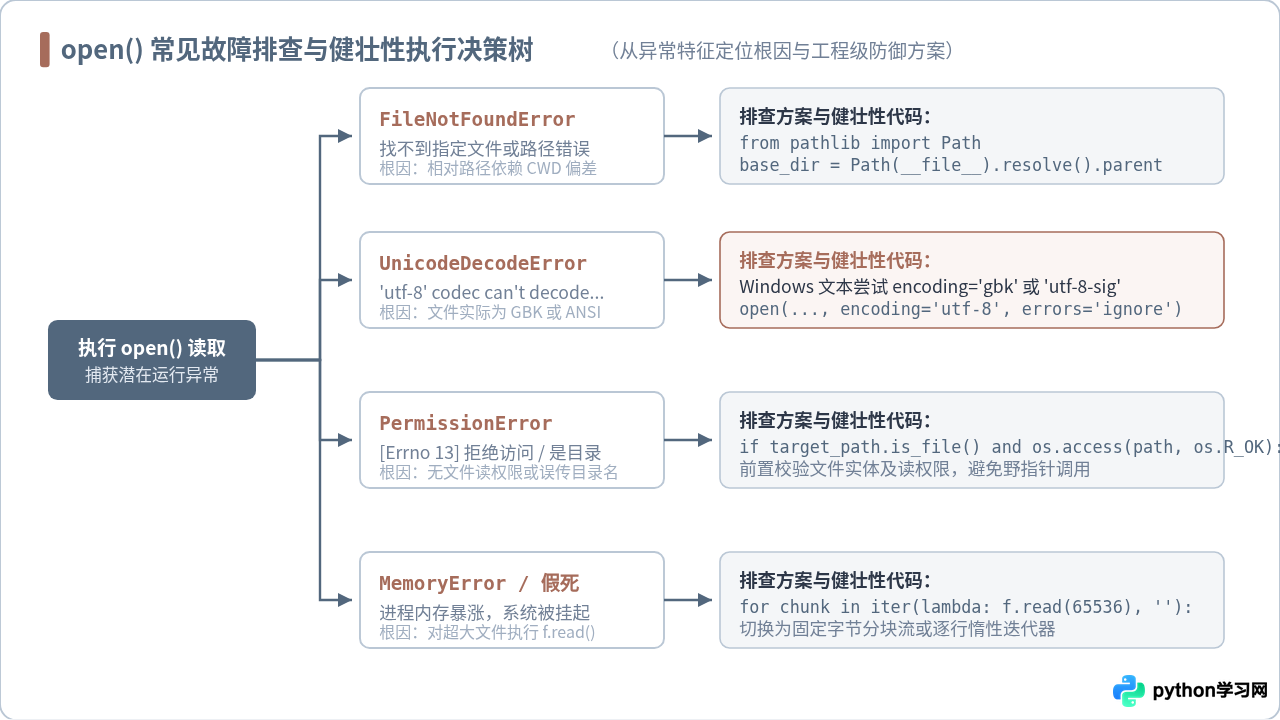
1. FileNotFoundError: [Errno 2] No such file or directory
发生原因: 使用了 open("data.txt") 相对路径,而在命令行中执行脚本时所在的当前工作目录与脚本文件所在的目录不一致。
最佳实践: 基于当前 .py 文件的物理位置构建绝对路径,使用标准库 pathlib.Path:
from pathlib import Path

# 锚定当前脚本所在目录,无论从哪里启动程序都不会迷路
CURRENT_DIR = Path(__file__).resolve().parent
TARGET_FILE = CURRENT_DIR / "data" / "records.txt"

if TARGET_FILE.exists():
    with open(TARGET_FILE, "r", encoding="utf-8") as f:
        data = f.read()
else:
    print(f"目标文件不存在: {TARGET_FILE}")
2. UnicodeDecodeError: 'utf-8' codec can't decode byte...
发生原因: 目标文件是由 Windows 记事本、旧版 Excel 或其他工具以 GBK/GB2312 编码保存的,但在 open() 中指定了解码器为 'utf-8'。
解决方案: 将编码调整为 encoding='gbk'。若文件中混杂有少量无法解析的脏数据且不影响核心分析,可搭配 errors='ignore' 或 errors='replace' 参数进行降级容错:
# 容错降级读取:跳过非法字符,确保程序不中断崩溃
with open("legacy_data.txt", "r", encoding="gbk", errors="ignore") as f:
    text = f.read()
3. PermissionError: [Errno 13] Permission denied
发生原因: 当前操作系统用户没有对该文件的读取权限,或者误将一个文件夹路径传给了 open()。检查目标路径是否确为文件实体(Path.is_file()),并核对文件的系统只读权限。
六、工程实践要点清单
核心准则汇总
| 考察维度 | 规范做法 | 反模式(应避免) |
|---|---|---|
| 句柄生命周期 | 一律采用 with open(...) as f: 自动上下文管理 |
单纯 f = open(...) 且不带 try-finally 保护 |
| 字符编码 | 显式书写 encoding="utf-8" |
依赖系统默认字符集(导致跨平台隐蔽故障) |
| 常规大文件遍历 | for line in f: 逐行迭代流式处理 |
无脑调用 f.read() 或 f.readlines() 造成内存爆满 |
| 路径定位 | 使用 pathlib.Path(__file__).parent 计算绝对定位 |
脆弱的纯相对路径(易受当前工作目录变更影响) |
| 末尾空白清理 | 使用 line.rstrip("
") 精确消除换行 |
误用 line.strip() 导致行首缩进与前导格式丢失 |
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















