


Python int()、str()、list()等类型转换内置函数的细节与异常处理
深入解析Python中int()、str()、list()、dict()等核心类型转换内置函数的内部工作机制、底层协议映射、常见边界陷阱与工业级异常防御实践。
Python 的类型转换并非简单的“语法糖”或单纯的数据重打包,而是依赖于底层特定的数据协议与魔法方法(如 __int__、__str__、__repr__ 与 __iter__)。在实际开发中,开发者频繁调用的 int()、str()、list()、dict() 等内置转换函数,在处理浮点字符串、字节流、单次迭代器以及容器嵌套时,隐藏着诸多边界规则和易抛异常的暗坑。本文系统梳理这些内置转换函数的运行细节、底层调用逻辑与常见报错场景,并提供工业级的防御式转换实践。
一、面向协议的类型转换:内置函数如何运作
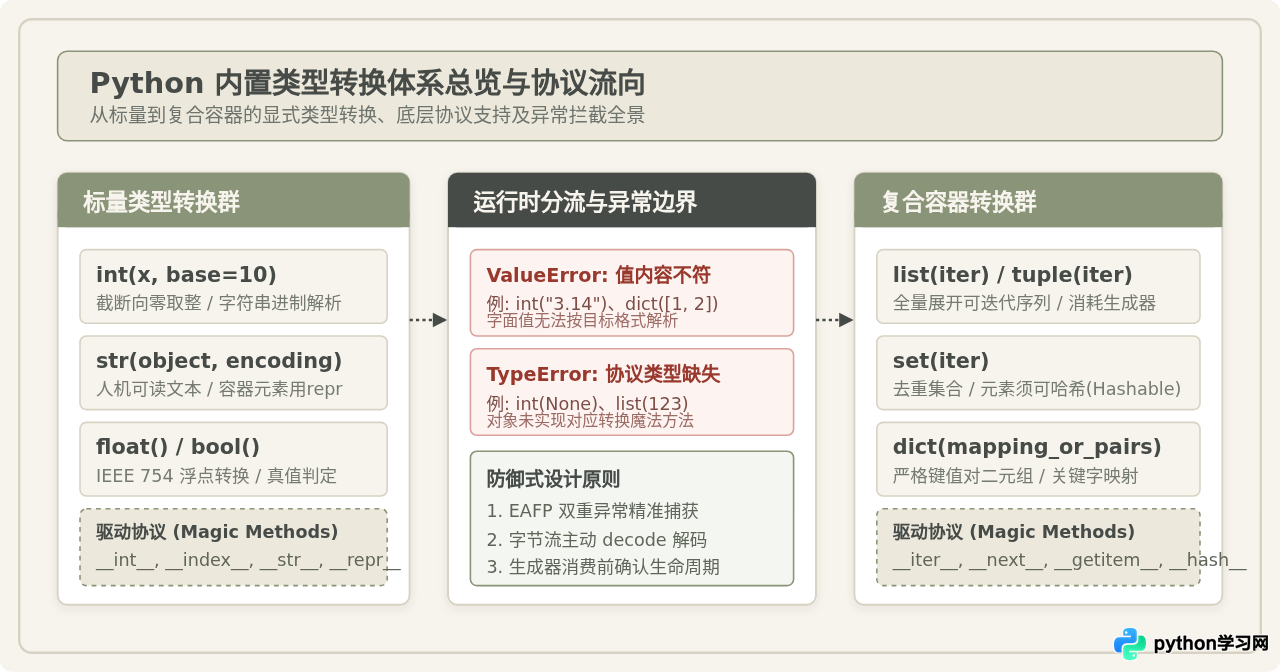
在强类型动态语言 Python 中,类型转换是显式声明的。当我们执行 target_type(source_obj) 时,解释器并非粗暴地将底层内存块重新解释,而是遵循统一的“面向协议(Protocol-driven)”设计:内置函数作为外层门面,在接收到输入后,会检查并调用对象内部约定的特殊魔法方法。
理解这套协议映射机制,是避开转换陷阱的前提。根据操作对象的形态,转换协议大致分为三类:
- 标量转换协议:如
int(obj)会优先查找并执行obj.__int__(),若未定义且涉及切片索引等上下文时回退至obj.__index__();float(obj)则调用obj.__float__()。 - 文本与呈现协议:如
str(obj)查找obj.__str__();若该方法缺失,则无缝回退至obj.__repr__();最终回退至基类object的内存地址显示。 - 容器与迭代协议:如
list(obj)、tuple(obj)、set(obj)要求对象必须实现__iter__()或遵循旧式序列协议的__getitem__()。若传入的对象不支持迭代协议,解释器将立即中断并抛出异常。
当目标类型的构造函数无法解析给定的数据形态,或者输入对象缺少必需的底层协议时,就会触发 ValueError 或 TypeError。下面我们逐个剖析核心内置转换函数的关键细节与高发暗坑。
二、int() 的进阶细节:截断规则、基数解析与浮点限制
int() 是日常使用频率最高的数值转换函数,其完整函数签名包含可选的进制基数参数:int(x=0, base=10)。但在简单的整数提取背后,有四个极其容易引起线上故障的细节。
1. 浮点数截断:向零取整而非四舍五入
当对浮点数调用 int() 时,Python 执行的是“向零截断(Truncation towards zero)”,即直接抹去小数部分,保留整数位。这与数学上的“向下取整(Floor)”在负数区间存在显著差异:
# 正数截断
print(int(3.9))   # 示例输出: 3

# 负数向零截断 vs 向下取整
print(int(-3.9))  # 示例输出: -3
import math
print(math.floor(-3.9))  # 示例输出: -4
如果业务场景需要标准的四舍五入(Round half to even),应使用 round() 函数;如果需要向下对齐网格,则必须使用 math.floor()。
2. 常见认知偏差:为什么 int("3.14") 无法一步到位?
许多初学者常有这样的直觉:“既然 int(3.14) 能得到 3,那么 int("3.14") 也理应得到 3”。然而在实际运行中,该操作会立即抛出异常:
# 尝试直接转换浮点字符串
int("3.14")
# 示例报错:
# ValueError: invalid literal for int() with base 10: '3.14'
这种设计看似死板,实则是 Python 为保证数据严谨性而设立的屏障。当输入为字符串时,int() 启动的是字符串整数字面量解析器。解析器要求字符串必须完全符合整型的词法规范,小数点被视为非法字符。
若业务确实允许带有小数的文本转整型,应先将其交由能识别小数点的浮点解析器,再执行整型截断:int(float("3.14"));或者根据业务语义按小数点进行字符串切分 int("3.14".split('.')[0])。
3. base 参数的进制解析与类型互斥
base 参数允许将不同进制的字符串表示转换为十进制整数,有效范围为 2 到 36,或者特殊的 0:
# 二进制、十六进制解析
print(int("1010", base=2))    # 示例输出: 10
print(int("0xff", base=16))   # 示例输出: 255

# base=0 自动推断进制前缀
print(int("0b1010", base=0))  # 示例输出: 10
print(int("0x1f", base=0))    # 示例输出: 31
但需要牢记一条铁律:base 参数只允许与字符串或 bytes 类型配合使用。如果将数值类型与显式 base 组合,会抛出 TypeError:
# 对数值类型传递 base
int(1010, base=2)
# 示例报错:
# TypeError: int() can't convert non-string with explicit base
4. 布尔值与 NoneType 的边界行为
在 Python 中,bool 是 int 的派生子类。因此 int(True) 返回 1,int(False) 返回 0。然而,代表空值的 None 并没有实现 __int__ 协议,传入时将抛出异常:
int(None)
# 示例报错:
# TypeError: int() argument must be a string, a bytes-like object or a real number, not 'NoneType'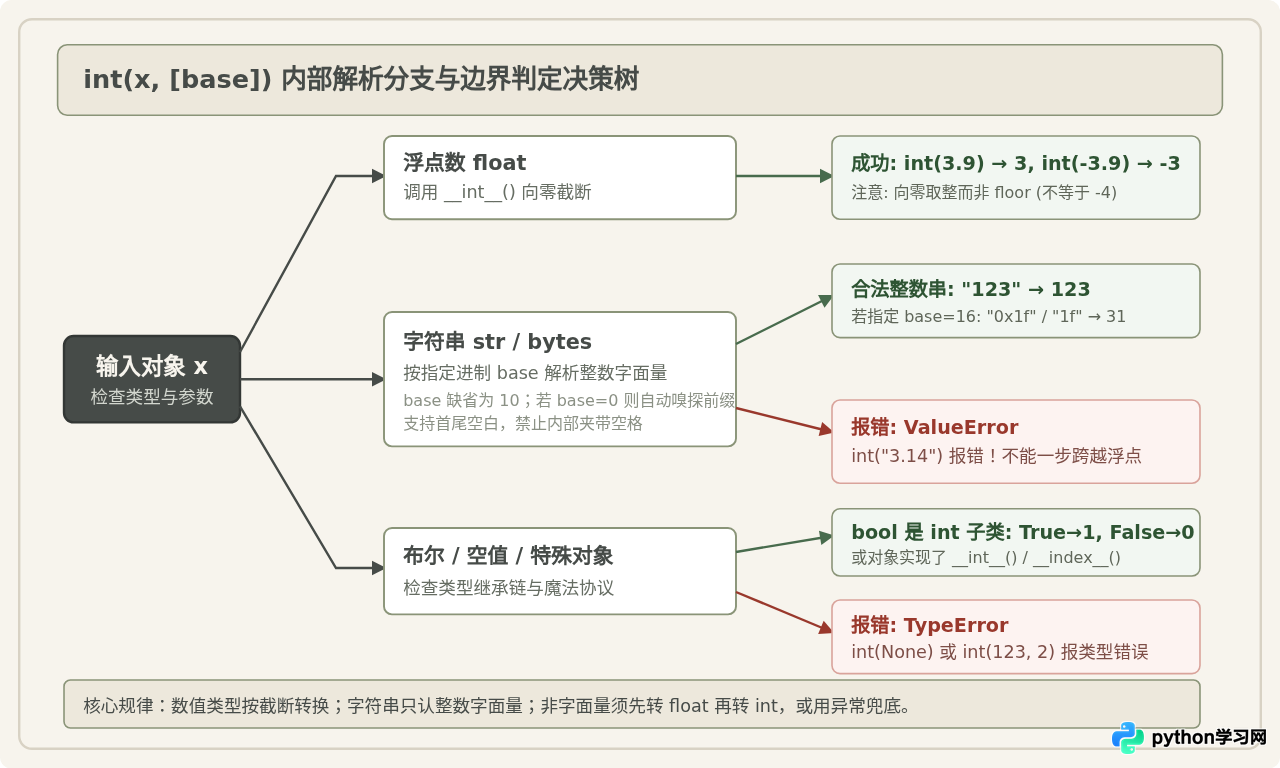
三、str() 序列化细节:人机表达、容器穿透与编码陷阱
str() 负责将各种对象转换为字符串形式。大多数开发者认为它非常简单,但在对象呈现、嵌套容器展示以及二进制通信中,潜藏着极易导致业务逻辑错误的设计细节。
1. str() 与 repr() 的双轨制分工
Python 将“对象的字符串表示”严格区分为两种诉求:
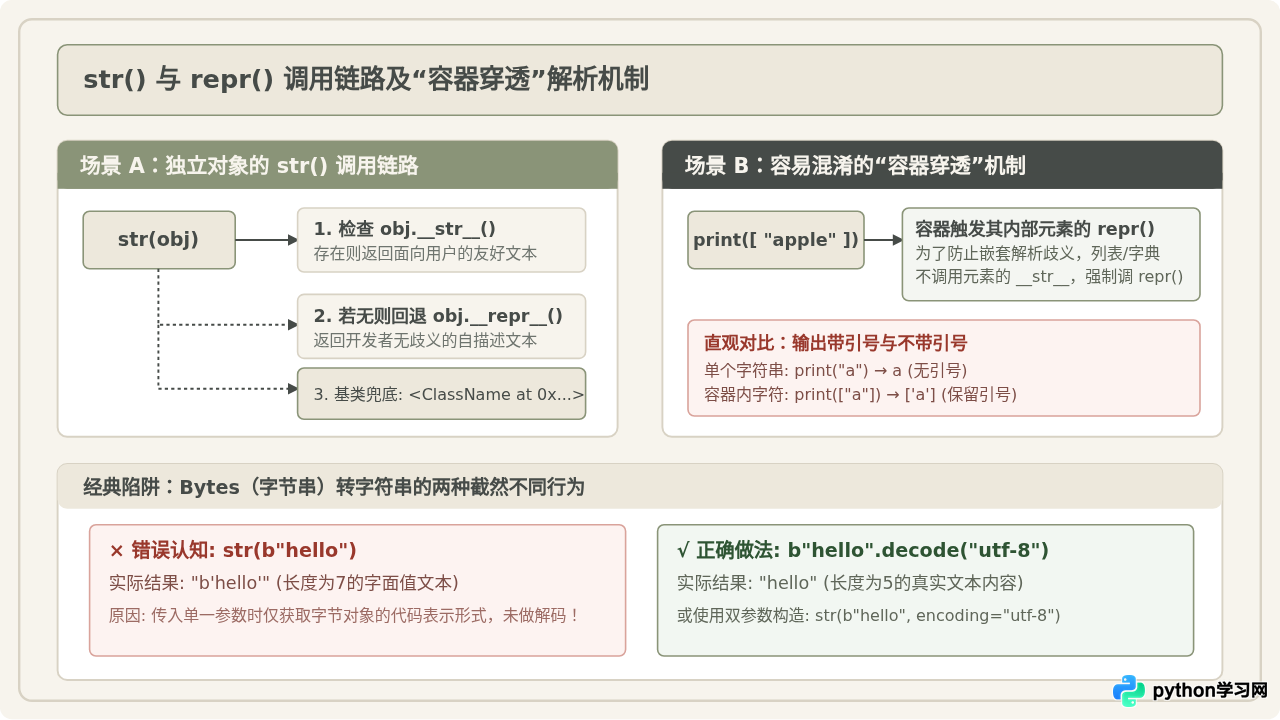
str():面向终端用户的非正式可读展示,强调可读性与整洁,对应底层__str__()。repr():面向开发者的严谨无歧义呈现,包含类型信息或代码还原形态,对应底层__repr__()。
若自定义类只实现了 __repr__(),当外部调用 str() 时,Python 会自动回退调用 __repr__();但反之如果只实现了 __str__(),调用 repr() 时绝不会回退到 __str__(),而是输出 <ClassName at 0x...>。
2. 隐蔽的“容器穿透”机制:列表中的元素为何总带引号?
在终端调试时,经常看到这样的现象:
name = "apple"
print(str(name))     # 示例输出: apple (无引号)
print(str([name]))   # 示例输出: ['apple'] (带引号)
明明外层调用了 str(),为什么里面的 name 打印出来却带着引号?
这是因为 Python 的容器类(list、tuple、dict、set)在实现自身的 __str__() 方法时,强制对内部包含的每一个元素调用 repr() 而非 str()。其设计哲学在于:如果容器内的字符串不加引号,["a, b", "c"] 打印出来就会变成 [a, b, c],导致肉眼和调试器完全无法分辨里面到底是有 2 个元素还是 3 个元素。
3. 字节序列(Bytes)转换的经典大坑
在进行网络请求、文件 IO 或加解密操作时,经常需要将 bytes 转为 str。最常见的致命误区是直接使用 str(b"..."):
raw_bytes = b"status_ok"

# 错误写法:直接调用单参数 str()
result_bad = str(raw_bytes)
print(result_bad)        # 示例输出: "b'status_ok'"
print(len(result_bad))   # 示例输出: 11 (包含了字母 b 和单引号!)

# 正确写法 1:使用 decode()
result_good = raw_bytes.decode("utf-8")
print(result_good)       # 示例输出: "status_ok"
print(len(result_good))  # 示例输出: 9

# 正确写法 2:指定 encoding 参数
result_alt = str(raw_bytes, encoding="utf-8")
print(result_alt)        # 示例输出: "status_ok"
若不显式指定 encoding,单参数的 str(raw_bytes) 仅仅是将 bytes 对象的 repr 文本转化成了普通字符串,导致前缀 b' 和尾随引号被当作真实数据写入数据库或发送至下游,引发难以察觉的数据污染。
四、复合容器转换:list()、set()、dict() 的装配陷阱
当把数据流装配进复合容器时,开发者使用的是 list()、tuple()、set() 以及 dict()。这些函数在消化数据时有着严格的先决条件。
1. 迭代器单次耗尽陷阱(Iterator Exhaustion)
list() 等容器构造函数可以接收任何实现了 __iter__() 协议的对象(如生成器、文件句柄、map()、filter() 等)。但是,迭代器是一次性的。一旦被读取,游标就会前进直至终点:
# 构造一个生成器表达式
squares_gen = (x * x for x in range(3))

# 第一次转换为列表
list_a = list(squares_gen)
print(list_a)  # 示例输出: [0, 1, 4]

# 第二次转换同一个生成器
list_b = list(squares_gen)
print(list_b)  # 示例输出: [] (已耗尽,静默返回空列表)
该特性不会抛出任何异常,但第二次调用会无声无息地得到空容器。如果后续代码依赖其中的数据,就会引发连锁逻辑异常。若数据需多次使用,应在初次生成时就固化为列表,或者在需要时重新生成迭代器。
2. 字符串转列表的切分粒度
字符串本身是一个字符序列。直接执行 list("2026") 会将其拆散为字符级别的单字列表:['2', '0', '2', '6']。如果初衷是将该字符串作为独立元素放入列表,应直接使用字面量包裹 ["2026"];若是需要按分隔符解析,应调用 "2026,2027".split(',')。
3. dict() 的二元结构约束
dict() 构造器要求输入必须是键值对映射关系。如果传入可迭代序列,其内部每个元素必须恰好为长度为 2 的子序列(如二元元组或双字符字符串):
# 合法结构转换
print(dict([('a', 1), ('b', 2)]))  # 示例输出: {'a': 1, 'b': 2}

# 错误结构转换:单元素列表
dict([1, 2])
# 示例报错:
# TypeError: cannot convert dictionary update sequence element #0 to a sequence

# 错误结构转换:子序列长度不等于 2
dict([('a', 1, 99)])
# 示例报错:
# ValueError: dictionary update sequence element #0 has length 3; 2 is required
此外,当输入序列中存在重复的键时,dict() 不会报错,而是执行后项覆盖前项策略:dict([('k', 1), ('k', 2)]) 最终结果为 {'k': 2}。
4. set() 的可哈希(Hashable)强约束
set() 内部基于哈希表实现,旨在提供 \(O(1)\) 的去重与查找效率。这要求放入集合的所有元素必须是不可变且可哈希的。如果尝试对包含可变对象(如列表、字典、其他集合)的序列调用 set(),将直接崩溃:
# 包含不可哈希子列表
raw_matrix = [[1, 2], [3, 4]]
set(raw_matrix)
# 示例报错:
# TypeError: unhashable type: 'list'

# 解决之道:先将子项转为不可变元组
safe_matrix = [tuple(row) for row in raw_matrix]
print(set(safe_matrix))  # 示例输出: {(1, 2), (3, 4)}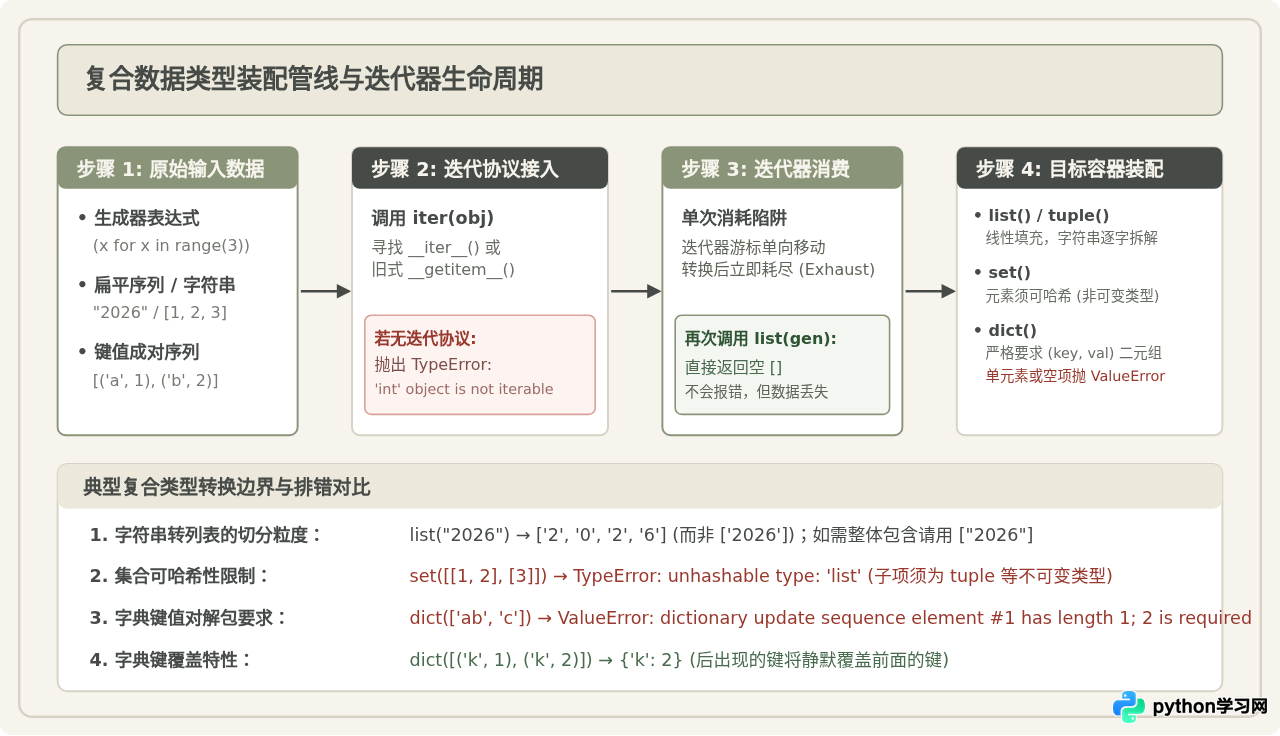
五、异常分类全景与工业级防御式转换实践
在大型工程中,类型转换往往处于接口网关、数据清洗、配置加载等关键卡口。如果直接暴露原生转换函数,极易因脏数据导致整个处理管道中断。
1. 核心异常排查速查
| 异常类型 | 根本原因 | 典型触发代码 | 标准排查与修复方案 |
|---|---|---|---|
ValueError |
数据类型受支持,但具体格式或内容无法解析 | int("3.14")、int("abc")、dict(['a']) |
检查字符串内容格式;对于浮点字符串采用 int(float(s));检查字典键值对长度 |
TypeError |
对象未实现目标函数所需的底层协议方法 | int(None)、list(100)、set([[1]]) |
增加 NoneType 预检;确保输入支持 __iter__;不可变包装消除不可哈希项 |
KeyError / IndexError |
容器转换派生的切片或解包越界 | dict(x.split(':')) 遇到无冒号数据 |
解包前校验元素数量,或改用带容错的字符串正则提取 |
2. 为什么 str.isdigit() 并不是好的预检方案?
在很多遗留代码中,经常能看到用 if s.isdigit(): return int(s) 的写法。这种 LBYL(Look Before You Leap)方式存在三大严重缺陷:
- 漏判负数:
"-123".isdigit()返回False,导致合法的负整数全部被拒绝。 - 误判 Unicode 特殊数字:在 Python 3 中,上标数字
"²"或带圈数字"①"的.isdigit()均返回True,但在调用int("①")时依然会抛出ValueError。 - 完全不支持浮点字符串:
"3.14".isdigit()返回False。
因此,Pythonic 的最佳实践是遵循 EAFP(Easier to Ask for Forgiveness than Permission) 原则:直接在转换处施加精确的异常拦截。
3. 工业级安全转换工具函数实现
下面给出一套在生产环境中经过验证的安全转换工具,具备类型短路、编码纠偏、精准双异常捕获与保底机制:
from typing import Any, Optional, List

def safe_int(val: Any, default: int = 0) -> int:
    """
    工业级整型安全转换函数:
    1. 快速处理 None 与已为 int 的对象;
    2. 支持浮点数及浮点字符串向零截断;
    3. 精准拦截 (ValueError, TypeError),绝不掩盖 KeyboardInterrupt 等系统异常。
    """
    if val is None:
        return default
    if isinstance(val, int) and not isinstance(val, bool):
        return val
    try:
        # 支持 float 及 "3.14" 字符串的双阶段转换
        return int(float(val))
    except (ValueError, TypeError):
        return default

def safe_str(val: Any, default: str = "", encoding: str = "utf-8") -> str:
    """
    规避 bytes 误转字面量 'b...' 陷阱的安全字符串转换器
    """
    if val is None:
        return default
    if isinstance(val, bytes):
        try:
            return val.decode(encoding)
        except UnicodeDecodeError:
            return val.decode(encoding, errors="replace")
    return str(val)

def safe_list(val: Any) -> List[Any]:
    """
    安全列表包装:
    - 若原本就是 list,直接返回;
    - 若为字符串,避免拆散为字符,包装为单元素列表;
    - 若为可迭代对象,展开为列表;
    - 若为不可迭代对象或 None,安全包裹。
    """
    if val is None:
        return []
    if isinstance(val, list):
        return val
    if isinstance(val, (str, bytes)):
        return [val]
    try:
        return list(val)
    except TypeError:
        return [val]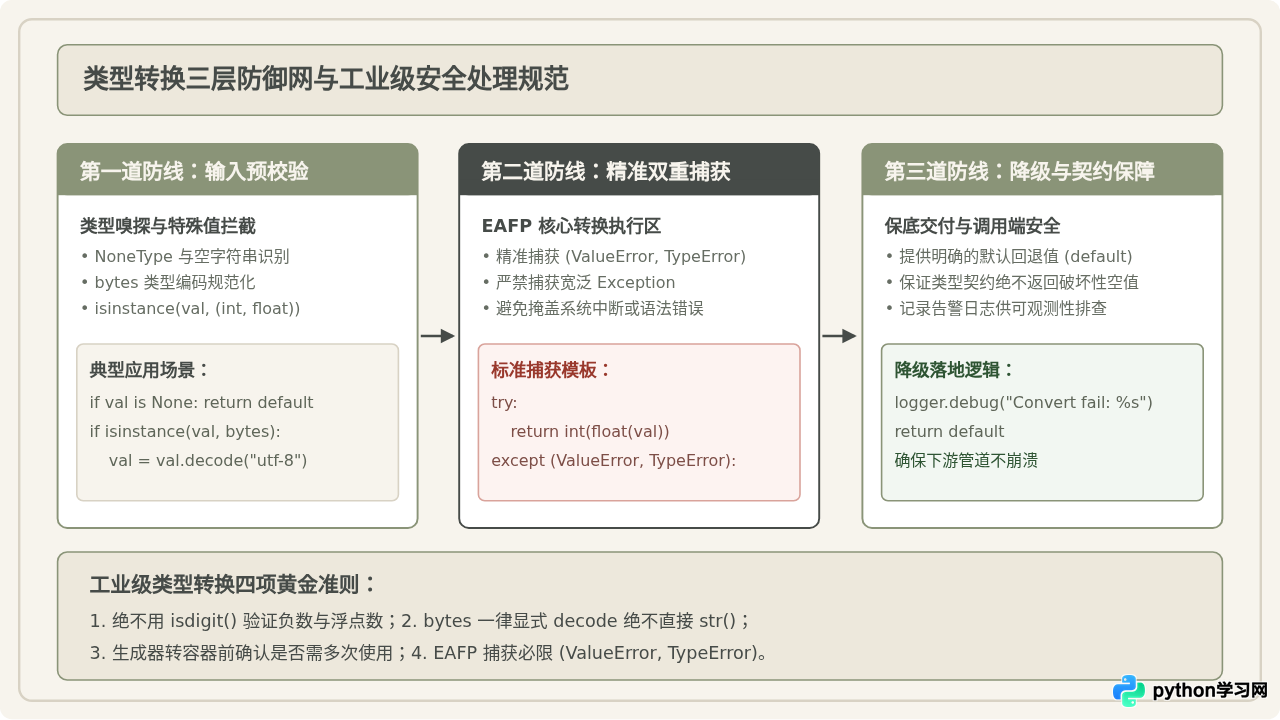
六、总结与工程落地守则
类型转换是程序各层模块之间交换数据的立足点。写出健壮代码的关键,在于把控底层细节与守住异常边界:
- 明确数值语义:谨记
int()是向零截断而非四舍五入;面对带有小数点的文本,必须走两阶段转换int(float(s))。 - 警惕二进制污染:处理
bytes数据时永远显式使用.decode("utf-8"),严禁裸调用str(b)。 - 认知迭代器生命周期:生成器是一次性消费品,不可重复执行
list()等全量展开操作。 - 统一使用双异常拦截:构建转换防线时,精准捕获
(ValueError, TypeError),摒弃不严谨的.isdigit()预检,为系统构筑高可用保底契约。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















