


Python多重赋值技巧:怎么同时给多个变量赋值
全面讲解Python中同时给多个变量赋值的核心语法与工程技巧,深入剖析元组解包机制、变量极速交换、带星号的扩展解包、链式赋值陷阱及常见报错应对方案。
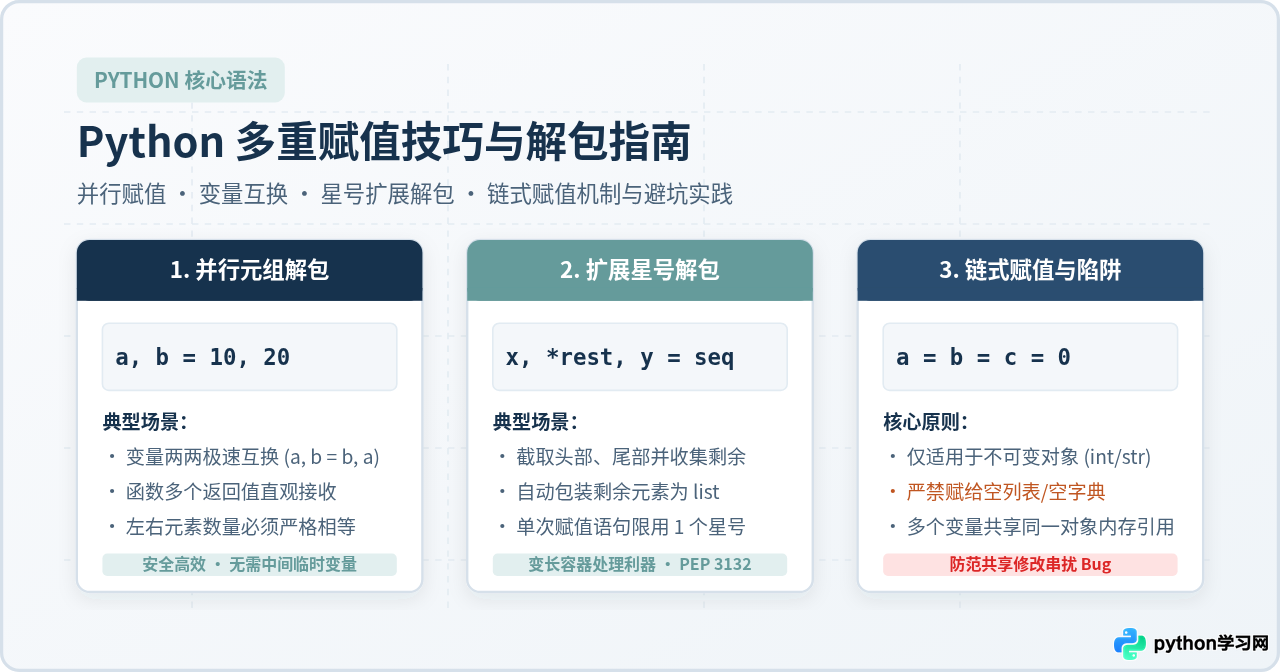
一、并行多变量赋值(元组解包机制)
最常见的同时给多个变量赋值的方式是用逗号分隔多个变量与对应数值:
# 在单行中直接为两个变量赋予不同的初始值
x, y = 10, 20
print(f"x = {x}, y = {y}")很多初学者会误以为这是两条赋值语句被合并在了一起,但其底层运行逻辑是先打包后解包:
- 右侧求值与打包:Python 解释器先计算等号右边的表达式
10, 20,将其在内存中打包为一个匿名元组(10, 20); - 左侧对应与解包:随后按照从左到右的位置次序,将元组中的元素依次赋值给左侧的变量名
x和y。
经典实践:优雅互换两个变量的值
在 C 或 Java 等语言中,交换两个变量的值通常需要引入一个第三方的中间临时变量:
# 传统语言中的交换方式(繁琐且需要额外变量)
temp = a
a = b
b = temp
而在 Python 中,只需要一行简短的并行解包语句:
a, b = 10, 20
# 一行完成两值互换
a, b = b, a
print(f"交换后:a = {a}, b = {b}")为什么这里 a 赋值后不会破坏原本 a 的值以至于导致 b 拿到错误结果?下面的步骤图展示了这一内存维度的执行细节:
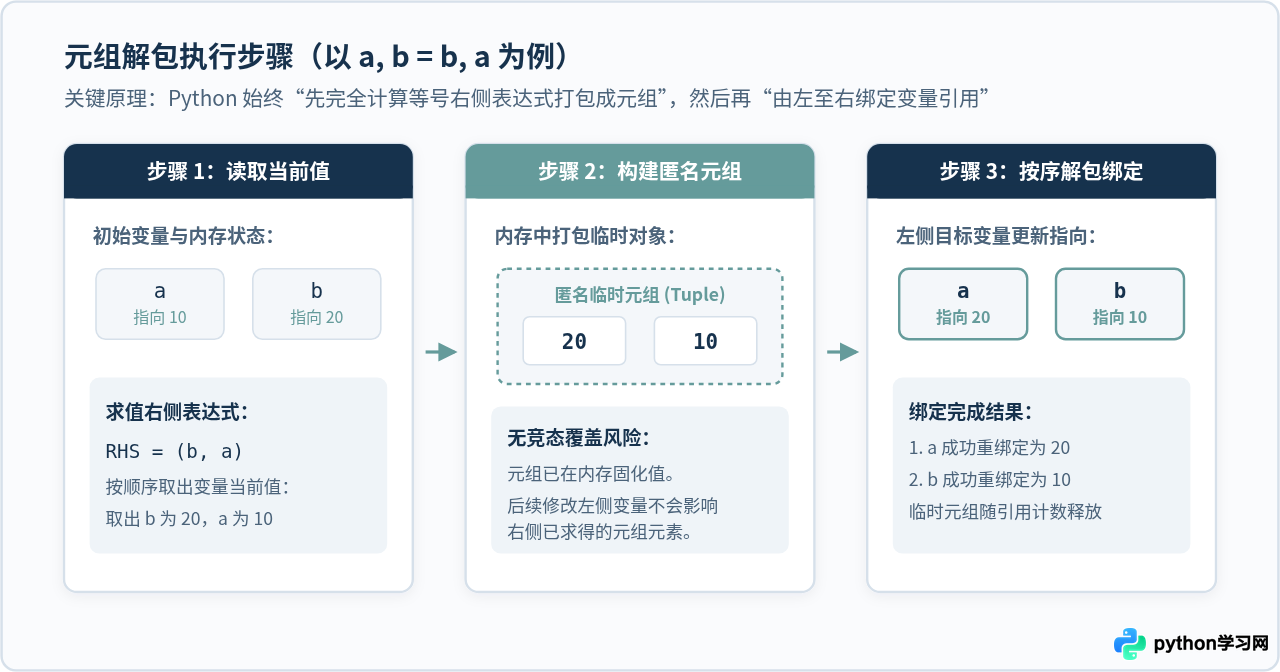
如图 1 所示,由于右侧的 (b, a) 在内存中优先完成取值并构建好了临时元组 (20, 10),左侧的绑定操作无论谁先谁后,读取的都已经是固化在元组中的历史引用,绝不存在相互覆盖竞态。
二、链式赋值:批量赋同一初始值与避坑指南
当需要为多个变量赋予完全相同的初始值时,可以使用连续等号的链式赋值(Chained Assignment):
# 批量将多个计数器初始化为 0
total = count = errors = 0
print(total, count, errors)链式赋值从右往左关联:Python 先计算右侧的值 0,然后依次让 errors、count、total 都指向这个对象。
对于整数、浮点数、字符串、元组或
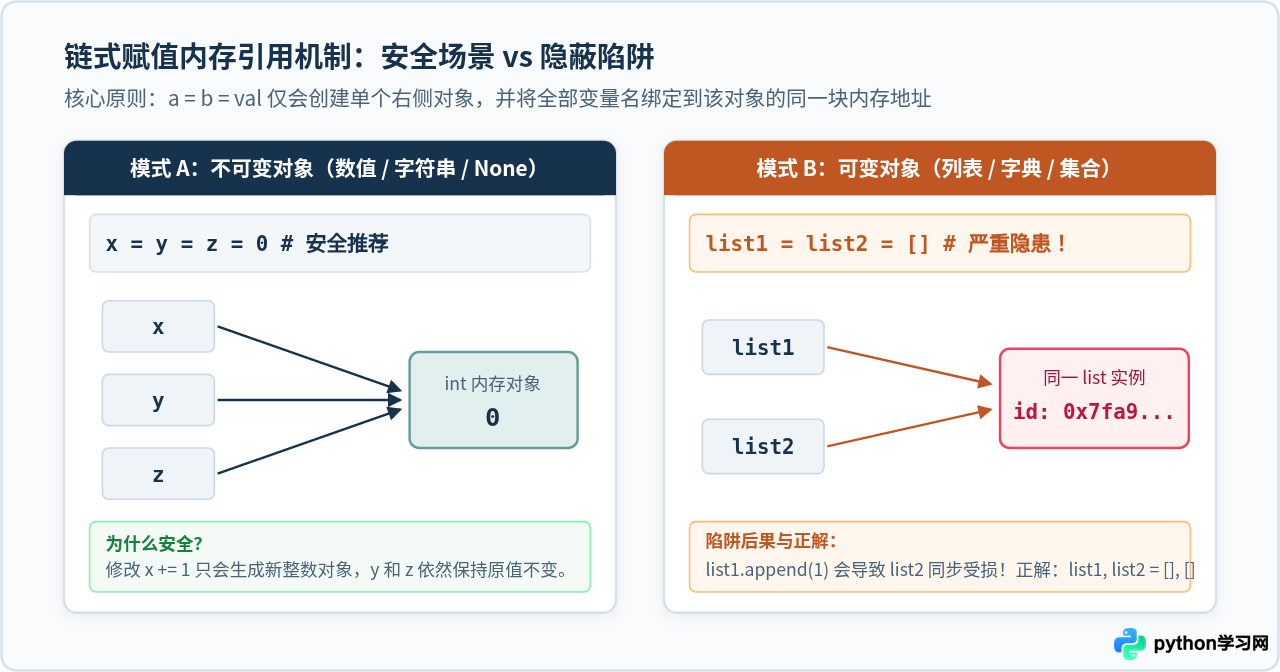
None 等不可变对象,链式赋值非常安全。但如果右侧是列表(list)、字典(dict)或集合(set)等可变对象,所有变量将全部指向内存中的同一个容器实例!
# 【错误示范】以为创建了两个独立的空列表
list_a = list_b = []

# 仅向 list_a 中追加元素
list_a.append("Python")

print(f"list_a: {list_a}")
print(f"list_b: {list_b}")  # list_b 竟然也被同步修改了!
print(f"是否为同一内存对象: {list_a is list_b}")这种隐蔽的问题在复杂业务代码中极难排查。图 2 直观对比了不可变类型与可变容器在链式赋值下的内部指针差异:
如果需要初始化多个独立的空容器,请始终使用逗号分隔的并行赋值或推导式:
list_a, list_b = [], []
三、带星号(*)的扩展解包技巧(变长序列截取)
普通的序列解包要求左侧变量数量与右侧容器元素个数必须完全一致,否则会直接抛出 ValueError。但在许多实际场景中,我们可能只关心容器的前几个元素、后几个元素,或者需要把剩余部分统一打包。
Python 3 引入了 PEP 3132(扩展迭代解包),允许在左侧某个变量名前加上星号 *,用于吸收任意长度的剩余元素:
scores = [98, 85, 76, 92, 60]

# 捕获第一个成绩、最后一个成绩,中间的所有成绩收集入 rest
first, *rest, last = scores

print(f"最高分: {first}")
print(f"中间成绩: {rest}")
print(f"最低分: {last}")图 3 细致展示了扩展解包的区间划分机制:
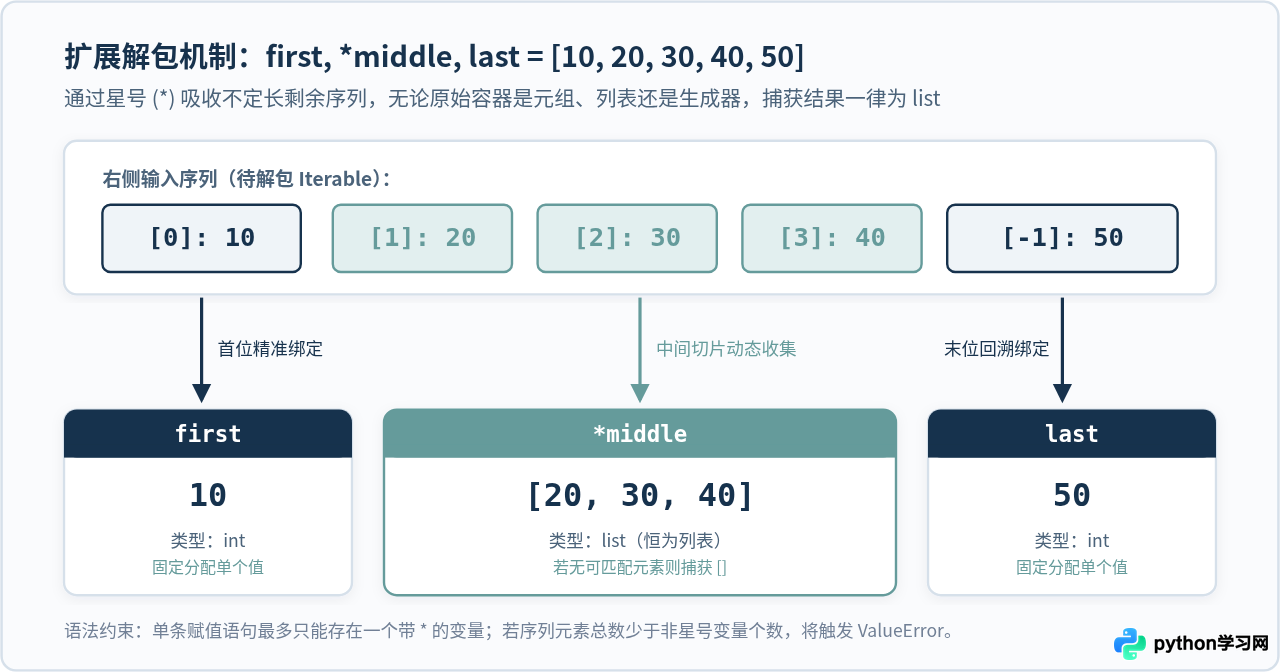
星号解包的三条黄金规则:
- 单次语句唯一性:一条赋值语句的左侧只能有一个带星号的变量名。若写出
*a, *b = [1, 2],解释器无法推断切分边界,会直接触发SyntaxError: two starred expressions in assignment。 - 结果恒为列表(list):无论右侧解包的是元组、字符串、集合还是生成器,星号捕获到的变量类型始终是
list。 - 容纳空序列能力:当序列元素个数恰好等于非星号变量个数时,星号变量会被赋予空列表
[],而不会报错。例如:head, *tail = [42]执行后,head为 42,tail为[]。
四、多重赋值的高频实战应用场景
场景 1:优雅接收函数的多个返回值
在 Python 中,当函数使用 return val1, val2 返回时,实质上返回的是一个元组。调用端可以直接利用多重赋值按需拆包:
def calculate_summary(numbers):
    return min(numbers), max(numbers), sum(numbers) / len(numbers)

# 直接解包三个返回值
min_val, max_val, avg_val = calculate_summary([12, 45, 68, 90, 23])
print(f"最小值: {min_val}, 最大值: {max_val}, 平均值: {avg_val:.2f}")场景 2:使用下划线 _ 忽略不需要的变量
在实际工程中,常常遇到返回多个字段但当前业务只关心其中某一个的情况。按照 Python 惯例,可以使用单个下划线 _ 或带星号下划线 *_ 占位:
user_record = ("Alice", 28, "Engineer", "Beijing")

# 仅提取姓名与城市,忽略中间的年龄与职业
name, _, _, city = user_record

# 结合星号批量丢弃尾部多余字段
name, *_, city = user_record
场景 3:循环结构中的就地解包
在 for 循环中,解包机制同样无缝生效,极大精简了多层字典与带索引遍历代码:
user_roles = {"admin": "管理员", "editor": "编辑", "viewer": "访客"}

# 遍历 items() 时直接解包键与值
for key, label in user_roles.items():
print(f"角色键名: {key} -> 权限中文: {label}")五、常见报错分析与防御式编程
在编写多重赋值语句时,最容易出现的错误是变量数与元素数量不匹配:
| 异常类型 | 典型触发代码 | 引发根因 | 最佳防御方案 |
|---|---|---|---|
ValueError |
a, b = [1, 2, 3] |
右侧元素过多:too many values to unpack (expected 2) | 改用星号解包 a, b, *rest 或提前校验容器长度 |
ValueError |
a, b, c = [1, 2] |
右侧元素不足:not enough values to unpack (expected 3, got 2) | 确认输入有效性或配置默认缺省值 |
SyntaxError |
*a, *b = [1, 2, 3] |
同一语句声明了两个及以上星号捕获项 | 单句保留一个 *,其余变量显式切片 |
六、技术选型与知识全景总结
为便于在实际编码时快速选择最合规、最高效的赋值语句,可参考图 4 总结的决策全景:
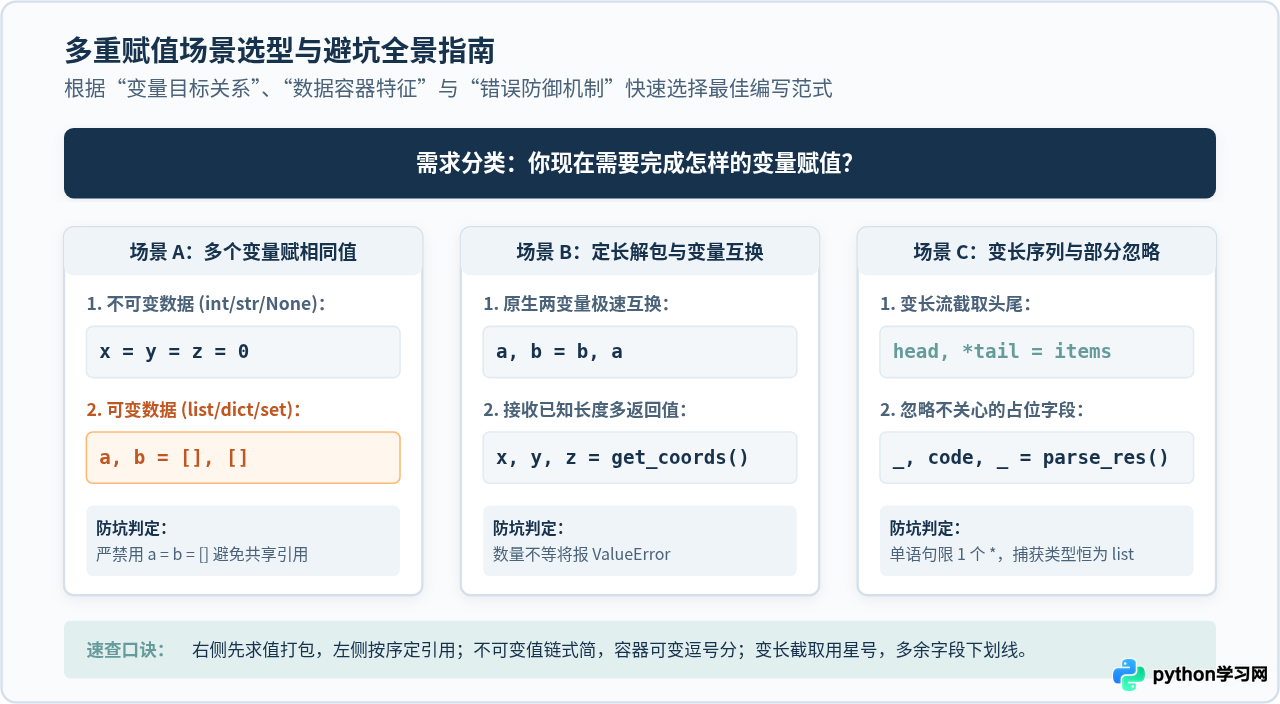
速查核心备忘:
- 极速互换首选:
a, b = b, a,底层依靠临时元组先求值再解包,无需第三方临时变量; - 批量初始化首选:对于数字和字符串用
a = b = 0;对于空列表/字典必须用a, b = [], []; - 变长序列首选:
first, *middle, last = seq,单语句限一个星号,收集结果必定是list; - 多余字段忽略首选:使用
_或*_明确表达占位意图,提升代码可读性与自解释性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















