


Python len()、range()、print()等高频内置函数用法示例
详细讲解Python高频内置函数len()、range()、print()的核心机制、常用参数、代码示例与易错点,并拓展enumerate()、zip()等高频搭配函数,帮助开发者写出地道高效的Python代码。
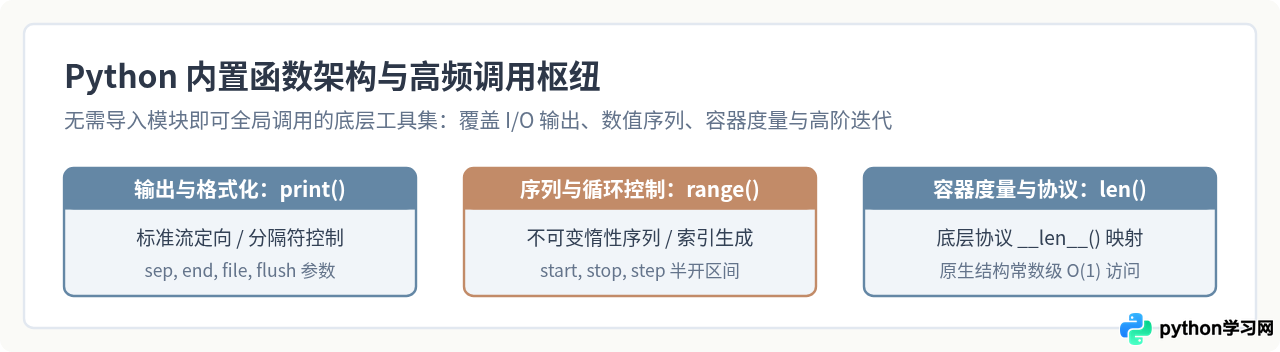
在 Python 开发中,len()、range() 和 print() 是使用频度最高的基础内置函数。掌握它们不仅关乎日常的输入输出与循环控制,更直接影响代码的内存占用与执行效率。本文针对这三个核心函数以及紧密协同的 enumerate()、zip() 等内置工具,逐一剖析其底层机制、语法参数与实战代码,明确参数边界与常见陷阱。
一、print():输出流控制与格式化管道
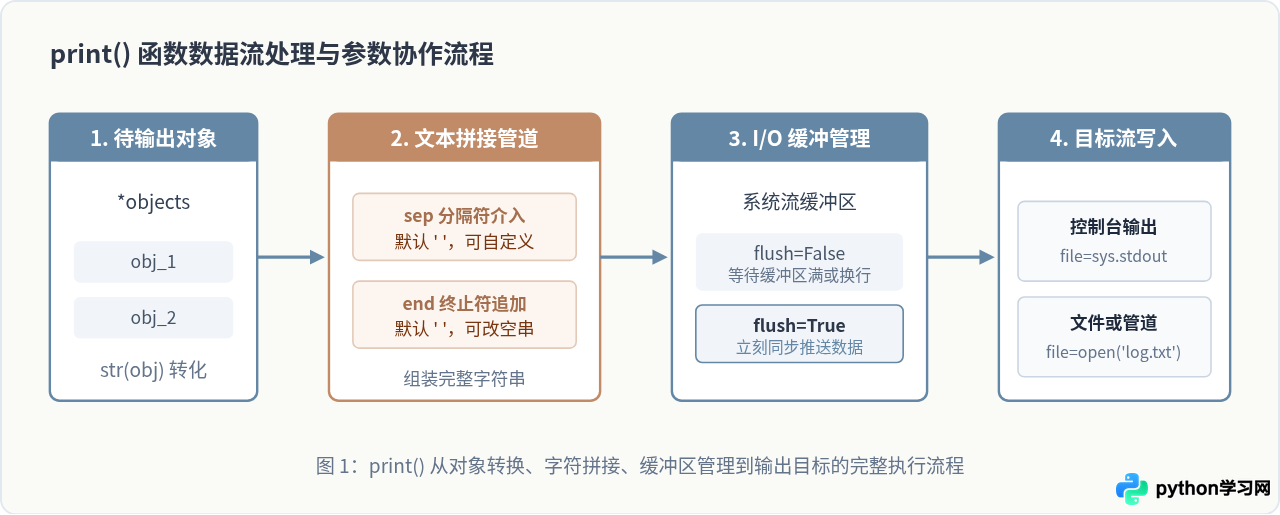
print() 函数负责将一个或多个对象转换成文本并写入指定的数据流。日常调用中多数人仅传入单个变量,实际上其完整签名为:
print(*objects, sep=' ', end='\n', file=None, flush=False)每个参数在输出管道中承担具体的分工:
- *objects:可变位置参数,支持同时传入任意数量的对象,输出前内部自动调用
str()转换为字符串。 - sep:对象之间的分隔符,默认为单个空格
' '。 - end:全部对象输出完毕后的结尾字符,默认为换行符
'\n'。 - file:写入的目标流对象,必须具备
write(string)方法,默认指向sys.stdout。 - flush:是否强制立即刷新缓冲区,布尔值,默认
False。
1.1 sep 与 end 参数的定制输出
在输出结构化数据(如 CSV 格式、路径或行内进度)时,合理使用 sep 与 end 能消除繁琐的手工字符串拼接:
# 示例 1:使用 sep 自定义元素分隔
date_parts = [2026, 10, 31]
print(*date_parts, sep="-")

# 示例 2:使用 end 实现同一行连续打印(不换行)
for num in range(5):
    print(num, end=" -> ")
print("完成")1.2 file 参数定向与 flush 实时刷新
默认情况下,print() 输出到标准输出终端。若将打开的文件句柄传入 file,即可将输出无缝重定向至本地文件。而在实现命令行进度条或高频日志记录时,操作系统默认的行缓冲机制可能延迟终端画面的渲染,此时将 flush=True 即可强制刷新当前缓冲区:
import sys
import time

# 示例 3:控制台原地动态刷新进度
print("任务处理中: ", end="", flush=True)
for i in range(3):
    time.sleep(0.2)
    print(".", end="", flush=True)
print(" [OK]")二、range():惰性序列与高效循环驱动
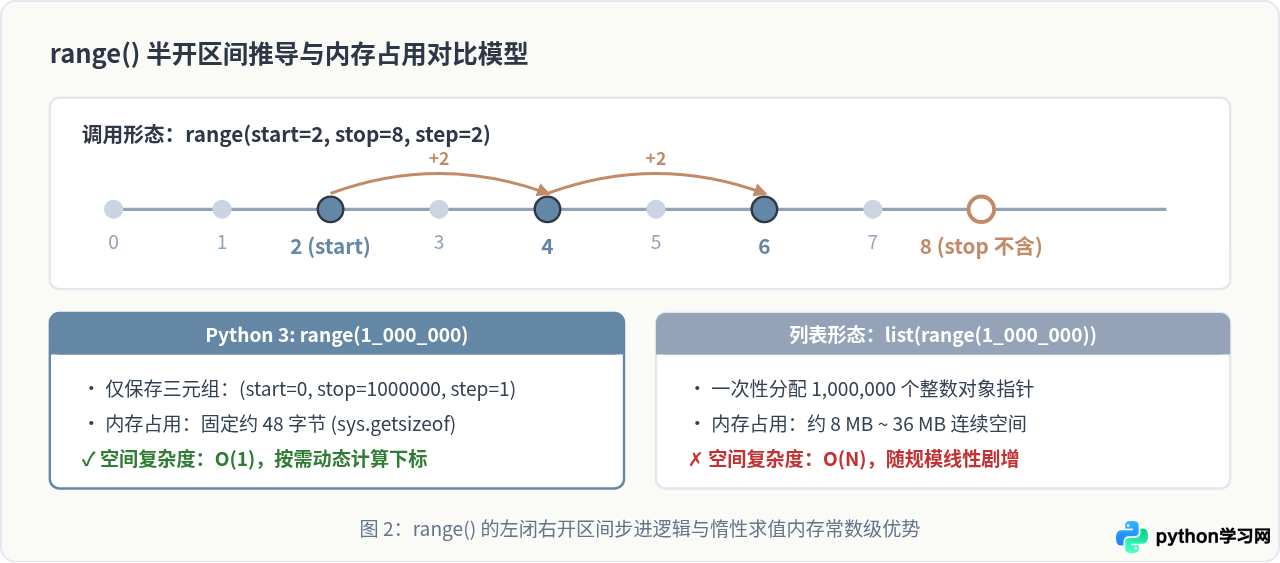
range() 在 Python 3 中是一个不可变的序列类型(而不是直接生成完整列表的普通函数)。它代表一个包含等差整数的有序集合,其核心特性在于惰性求值(Lazy Evaluation)。无论序列跨度多大,range 对象在内存中仅存储 start、stop 和 step 三个数值,空间复杂度恒定为 \(O(1)\)。
range() 支持两种调用形式:
range(stop):从0开始计数,递增步长为1,直至stop - 1。range(start, stop[, step]):从start开始,按指定step递增或递减,到达但不包含stop(即左闭右开区间[start, stop))。
2.1 正向递增与逆向倒序遍历
当指定负数作为 step 时,range() 会转为逆向递减,此时必须确保 start > stop,否则序列将为空:
# 示例 4:正向与反向步长
forward_seq = list(range(1, 10, 2))
reverse_seq = list(range(10, 0, -2))

print("正向步长(2):", forward_seq)
print("逆向倒序(-2):", reverse_seq)range() 仅接受整数参数(包括正整数、负整数和零)。如果传入浮点数(如 range(0.5, 5.5)),Python 解释器会直接抛出 TypeError: 'float' object cannot be interpreted as an integer。若需要浮点数等差数列,建议借助第三方库 numpy.arange() 或使用自定义生成器。
三、len():容器长度获取与底层 __len__() 协议
len() 返回对象的元素数量(即长度)。在表面上它是一个通用的独立函数,但在底层实现上,它遵循 Python 的数据模型(Data Model)协议,内部直接委派给目标对象的特殊方法 __len__():
# len(obj) 等价于底层调用
obj.__len__()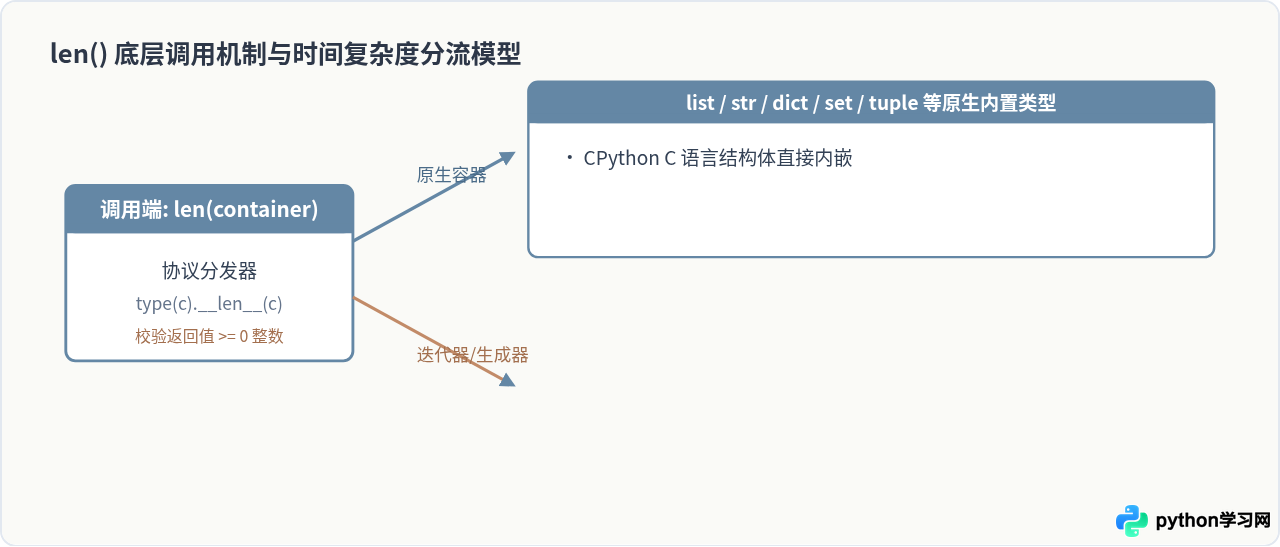
3.1 内置容器的多样化度量
len() 适用于所有序列与映射类型,其含义因容器特征有所侧重:
- 字符串(str):返回 Unicode 字符的数量(而非底层 UTF-8 字节数)。
- 字典(dict):返回唯一键(key)的数量。
- 集合(set):返回去重后的独立元素数量。
# 示例 5:多类型长度度量
text = "Python编程"
user_roles = {"admin": True, "editor": False}
unique_tags = {101, 102, 101, 103}

print("字符串字符数:", len(text))
print("字典键总数:", len(user_roles))
print("集合独立元素数:", len(unique_tags))3.2 自定义类实现 __len__() 协议
在面向对象编程中,若希望自定义数据结构支持 len(),只需声明 __len__() 方法,且返回值必须是非负整数:
class TaskQueue:
    def __init__(self):
        self._tasks = []

    def add(self, task_name):
        self._tasks.append(task_name)

    def __len__(self):
        return len(self._tasks)

queue = TaskQueue()
queue.add("数据清洗")
queue.add("特征工程")
print("当前队列任务数:", len(queue))四、高频伴随函数:组合使用的地道范式
在初学阶段,许多人习惯通过 for i in range(len(items)): 来遍历列表。虽然逻辑成立,但这种模式违背了 Python 的迭代哲学,既冗长又容易产生越界或混淆。通过结合 enumerate()、zip() 与聚合函数,代码会更加清晰直观。
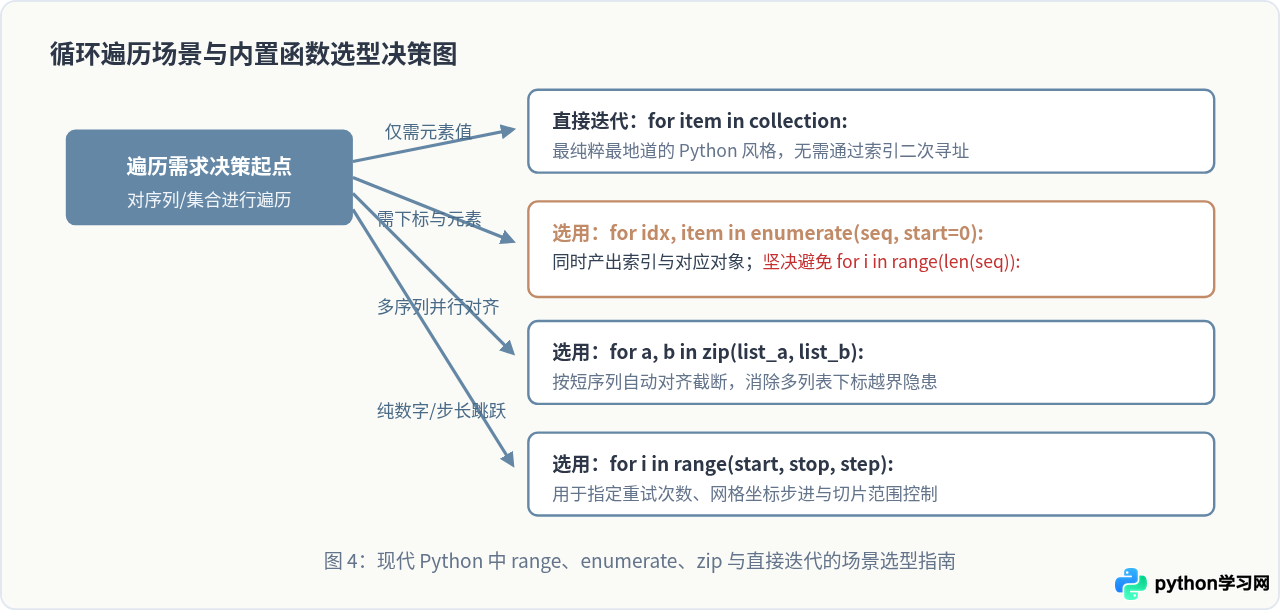
4.1 enumerate():告别 range(len()) 的抗错模式
当遍历既需要数据内容,又需要序列从某一起始数值开始递增的序号时,enumerate(iterable, start=0) 是首选工具:
# 示例 6:enumerate 优雅处理榜单序号
languages = ["Python", "Go", "Rust"]

for rank, name in enumerate(languages, start=1):
print(f"第 {rank} 名: {name}")4.2 zip():多集合矩阵对齐与元组打包
zip(*iterables) 将多个可迭代对象对应位置的元素配对打包成元组。如果输入列表长度不一致,默认以最短的序列为准:
# 示例 7:zip 并行处理关联数据
keys = ["主机", "端口", "状态"]
values = ["127.0.0.1", 8080, "UP"]

config = dict(zip(keys, values))
print("组合配置字典:", config)4.3 聚合计算高频三剑客:sum()、max()、min() 与 sorted()
结合 range() 与容器对象,Python 提供了一系列一步到位的聚合函数,无需编写显式循环累加器:
| 函数 | 基础语法示例 | 典型场景与返回值 |
|---|---|---|
sum() |
sum(range(1, 101)) |
对可迭代对象求和,支持 start 初始偏置值,返回总计数值。 |
max() / min() |
max(scores, key=lambda x: x['val']) |
返回极值元素,支持 key 排序规则回调函数。 |
sorted() |
sorted(items, reverse=True) |
返回全新排好序的列表,不修改原容器本身。 |
# 示例 8:聚合函数与 range 的紧密配合
# 快速求解 1 到 100 的累加和
total = sum(range(1, 101))

# 获取列表中的极值与新排序副本
data = [18, 92, 45, 67, 3]
maximum = max(data)
ascending = sorted(data)

print("1~100求和结果:", total)
print("最大值:", maximum)
print("排序后新列表:", ascending)五、高频内置函数使用注意事项与避坑清单
-
不要覆盖内置函数名称:变量名或函数名避免使用
len = 10、list = [1, 2]或print = "log"。此类赋值会遮蔽(Shadow)全局内置命名空间,导致后续合法的内置调用触发TypeError: 'int' object is not callable。若不慎覆盖,可在控制台中通过del len还原。 -
避免在遍历列表时直接修改其长度:在基于
range(len(lst))的循环中执行lst.pop()或lst.append(),会导致预设索引与实际列表结构失步,极易引发IndexError: list index out of range或跳过元素。正确的方案是在列表的浅拷贝lst[:]上遍历,或使用列表推导式构建新列表。 -
理解 range 的右开特性:
range(1, 5)只产生到4。若期望包含第N项,必须显式书写为range(1, N + 1)。 -
注意生成器的单次消耗与 len 限制:通过生成器推导式(如
(x * 2 for x in data))构建的对象无法使用len()提前探查大小。如果必须测量其长度,需转换为list(消耗内存)或遍历计数。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















