


Python用pandas读取Excel后怎么获取行数
在使用Python的pandas库读取Excel文件后,获取DataFrame行数最直接且推荐的方法是len(df)与df.shape[0]。本文详细拆解实现代码、底层原理、空值行与表头陷阱,以及多种业务场景下的最佳实践。
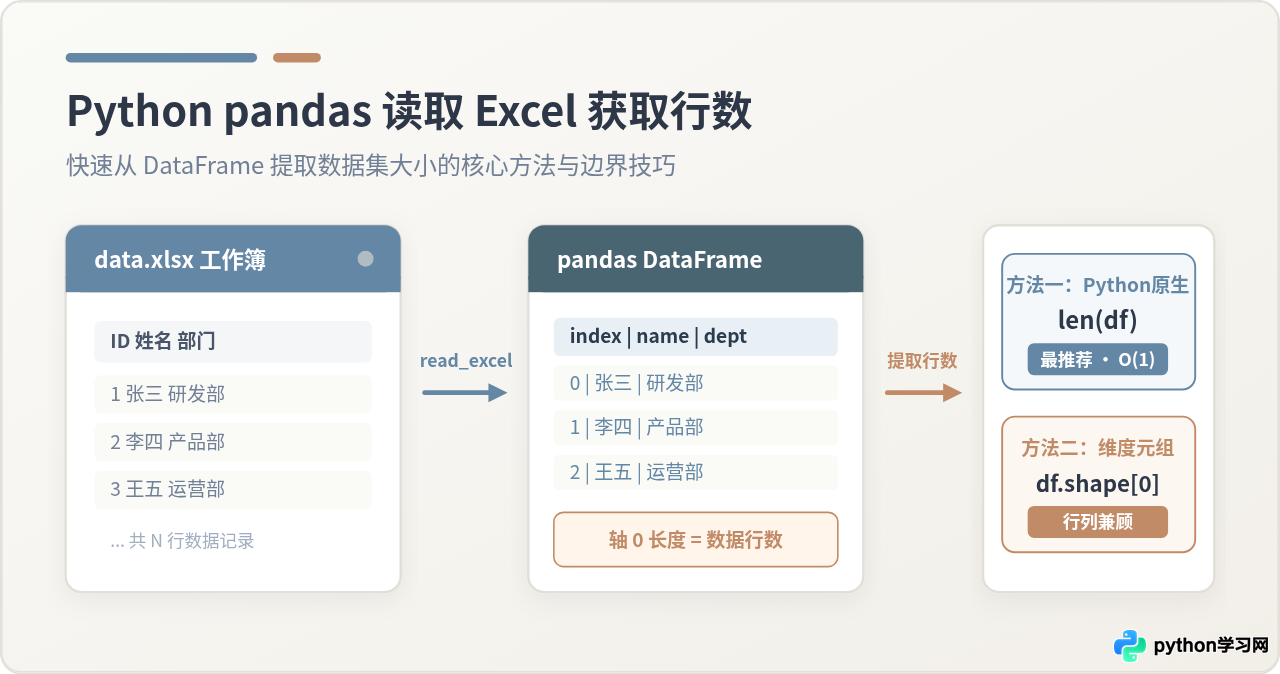
在 Python 中使用 pandas 库读取 Excel 文件后,获取数据行数最直接、最高效的做法是使用内置函数 len(df),或者访问属性元组 df.shape[0]。这两个方法都能在常数时间复杂度(O(1))内直接返回表格当前包含的数据行数,无需逐行遍历。
虽然这两行代码足够简单,但在实际的 Excel 数据处理场景中,经常会遇到“含表头少算了一行”、“空白格式残留导致多了很多空行”或“误用 count() 导致空值被漏算”等容易让人困惑的问题。本文将完整介绍具体操作代码、两者的底层运行机制,以及在处理真实 Excel 表格时的注意事项。
一、基础操作:完整代码示例与操作流程
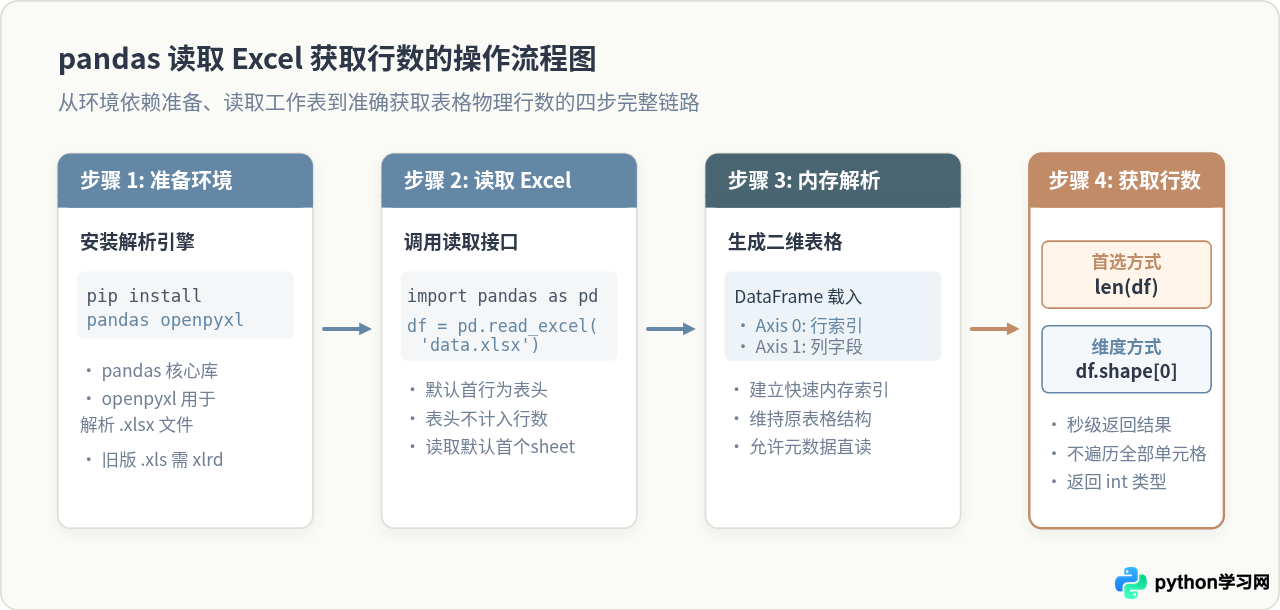
在处理 .xlsx 格式的 Excel 表格时,pandas 底层通常依赖 openpyxl 引擎进行文件流解析。如果你是首次使用,需要确保运行环境中已安装好这两个核心库:
pip install pandas openpyxl准备好包含数据的 Excel 文件(例如 data.xlsx)后,即可编写标准脚本完成读取并打印行数:
import pandas as pd

# 1. 读取 Excel 文件,默认读取第一张工作表并将第一行作为表头
df = pd.read_excel('data.xlsx')

# 2. 方式一:使用 Python 内置 len() 函数获取行数(最推荐)
rows_by_len = len(df)
print(f"数据总行数 (len): {rows_by_len}")

# 3. 方式二:使用 shape 属性获取行数
rows_by_shape = df.shape[0]
print(f"数据总行数 (shape[0]): {rows_by_shape}")

# 示例输出:
# 数据总行数 (len): 1280
# 数据总行数 (shape[0]): 1280
以上代码中,变量 df 是读取 Excel 后在内存中生成的 DataFrame 二维表格对象。无论调用 len(df) 还是 df.shape[0],返回的都是一个整型数值(int),代表该表格当前所包含的数据行总数。
二、常用行数获取方法的原理与对比
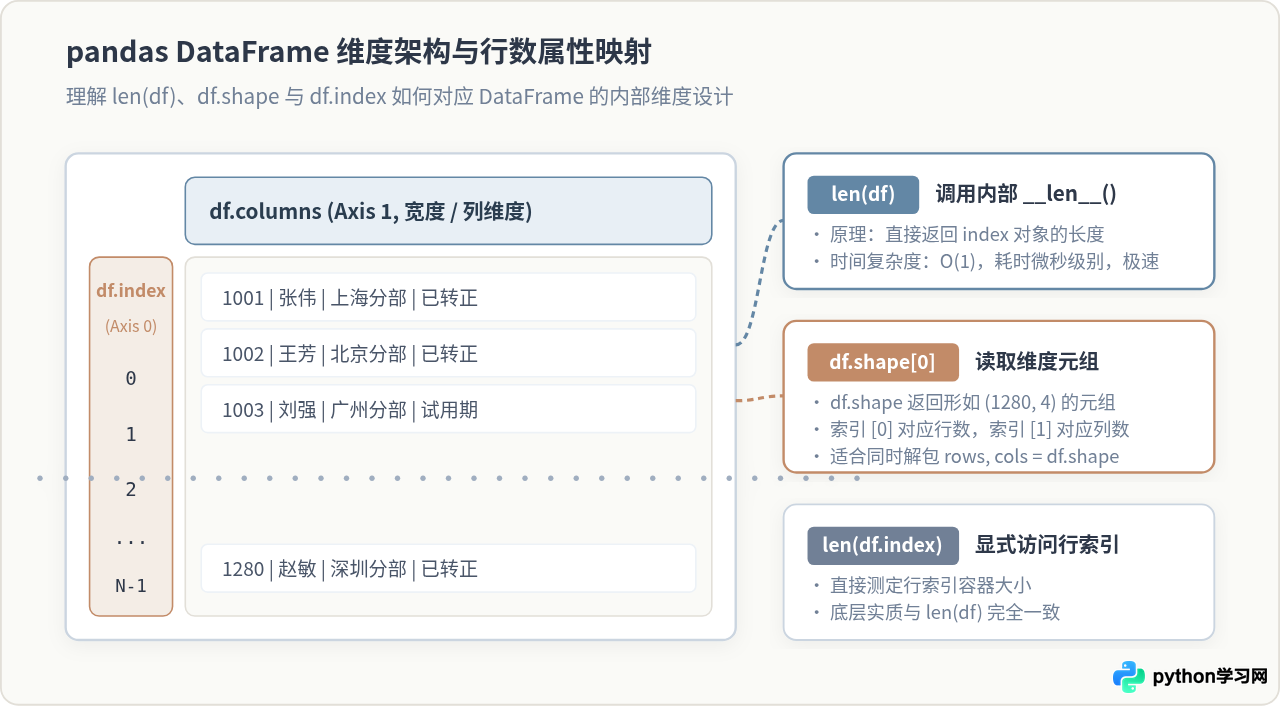
在日常开发和数据清洗工作中,获取行数的方法主要有三种:len(df)、df.shape[0] 以及 len(df.index)。虽然它们在绝大多数情况下返回相同的结果,但其底层设计和语义侧重有所不同。
1. len(df):最推荐的 Pythonic 方式
len(df) 是 Python 最自然也最符合规范的写法。当向内置函数 len() 传入一个 DataFrame 对象时,pandas 会触发其内部实现的魔术方法 __len__()。该方法直接返回当前行索引(Index)的元素总数,操作耗时仅为微秒级(时间复杂度为 O(1))。如果仅仅是想要获取行数,这种写法可读性最高,也最不容易写错。
2. df.shape[0]:适合同时获取行列维度
df.shape 继承自 NumPy 数组的维度属性,返回一个包含两个整数的元组:(行数, 列数)。其中索引 0 对应第 0 轴(垂直方向的行),索引 1 对应第 1 轴(水平方向的列)。当你不仅需要行数,还需要同时检查表格的列数时,可以通过元组解包一步完成:
# 同时解包行数与列数
total_rows, total_cols = df.shape
print(f"该表格共有 {total_rows} 行、{total_cols} 列")
3. len(df.index):直接检查行索引长度
每个 DataFrame 都有一个独立的 index 对象负责行定位。len(df.index) 直接丈量该索引容器的长度。实际上,len(df) 的底层正是通过查询 len(df.index) 实现的,因此两者性能一致,但在日常书写中无需特意写出 .index。
| 方法名称 | 返回值类型 | 时间复杂度 | 适用典型场景 |
|---|---|---|---|
| len(df) | int |
O(1) | 默认通用首选,日常代码简洁明确 |
| df.shape[0] | int |
O(1) | 需要同时获取行数和列数、日志排查打印 |
| len(df.index) | int |
O(1) | 行索引经过自定义变换后的长度二次校验 |
三、关键陷阱:总行数与有效非空行数 (len vs count)
初学者容易犯的一个典型错误是使用 df.count() 来获取行数。需要特别强调:len(df) 统计的是表格的物理行数,而 count() 统计的是非缺失值(Non-NaN)的数量。
如果 Excel 表格中的某一行虽然存在,但某些单元格处于空白状态(pandas 会自动填入 NaN),此时两者的统计结果会产生显著差异:
len(df):只要这行在表格结构中存在,无论单元格是有效数据还是NaN,都会被算作 1 行。df['某列'].count():只统计该列中非空的单元格个数。一旦该列存在空值,返回值必然小于总行数。df.count():不带列名调用时,会返回一个Series,分别列出每一列的非空计数值,而不是一个代表整表行数的单一数值。
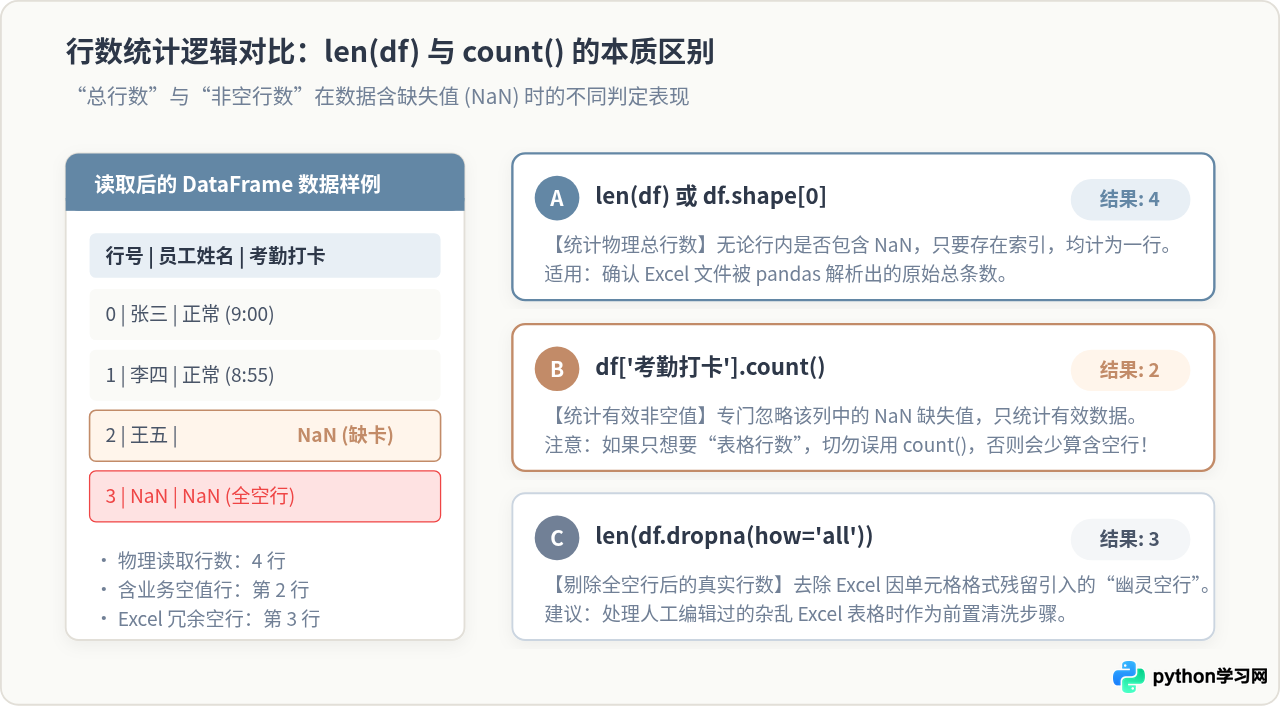
如果你的业务目标是“统计这批用户数据总共提交了多少条记录”,请务必使用 len(df);只有在“检查某一列有效填写率”时,才使用 df['列名'].count()。
四、读取 Excel 时影响行数的常见边界情况
在通过 pd.read_excel() 加载 Excel 文件时,Excel 本身的排版特点往往会直接影响最终读取出的 DataFrame 行数。以下三个情况最为普遍:
1. 表头行(Header)的扣除
在默认情况下,pd.read_excel('data.xlsx') 会将 Excel 文件的第一行当作字段名(即参数 header=0)。这意味着第一行不会计入 DataFrame 的数据行中。如果 Excel 文件在 Excel 软件左侧行号显示有 101 行(第 1 行为表头,第 2 至 101 行为数据),读取后 len(df) 返回的是 100。
如果你的 Excel 文件第一行本身就是实际数据、没有表头,必须显式传入 header=None,否则第 1 行数据会被误当成列名,导致行数少算 1 行:
# 当第一行就是纯数据无表头时
df = pd.read_excel('data.xlsx', header=None)
print("真实完整数据行数:", len(df))
2. Excel 格式残留引发的“幽灵空行”
使用 Excel 软件人工录入或复制粘贴数据时,用户经常会在数据末尾意外设置边框、空格或背景色。虽然这些行看起来没有文本内容,但 Excel 文件会将其识别为有效单元格区域。pandas 读取时,会将这些末尾区域全部填充为 NaN 并载入为实际行,从而导致 len(df) 测出的行数远大于实际数据行数。
针对这种情况,推荐在获取行数前先通过 dropna(how='all') 进行清洗,滤除整行全为空的无效记录:
# 过滤掉所有字段均为 NaN 的空白冗余行后再统计
clean_df = df.dropna(how='all')
print(f"清洗后的真实有效行数: {len(clean_df)}")
3. 多工作表(Multiple Sheets)读取
如果一个工作簿中包含多个 Sheet,并且在读取时指定了 sheet_name=None,pandas 会一次性读取所有工作表并返回一个字典(dict),其键为工作表名称,值为对应的 DataFrame。此时不能直接对返回对象调用 len(),否则得到的是工作表的数量,而非行数:
# 读取所有 sheet
sheets_dict = pd.read_excel('multi_data.xlsx', sheet_name=None)

# 逐一遍历每个 sheet 并输出各自的行数
for sheet_name, sheet_df in sheets_dict.items():
    print(f"工作表【{sheet_name}】的行数: {len(sheet_df)}")

# 统计所有工作表的总行数合计
total_rows_all_sheets = sum(len(sdf) for sdf in sheets_dict.values())
print(f"全簿合计总行数: {total_rows_all_sheets}")
五、选型总结与使用建议
获取 pandas 读取 Excel 后的行数是一项基础但至关重要的操作。为了在不同场景下写出稳健、高效的代码,可以参考以下决策速查指引:
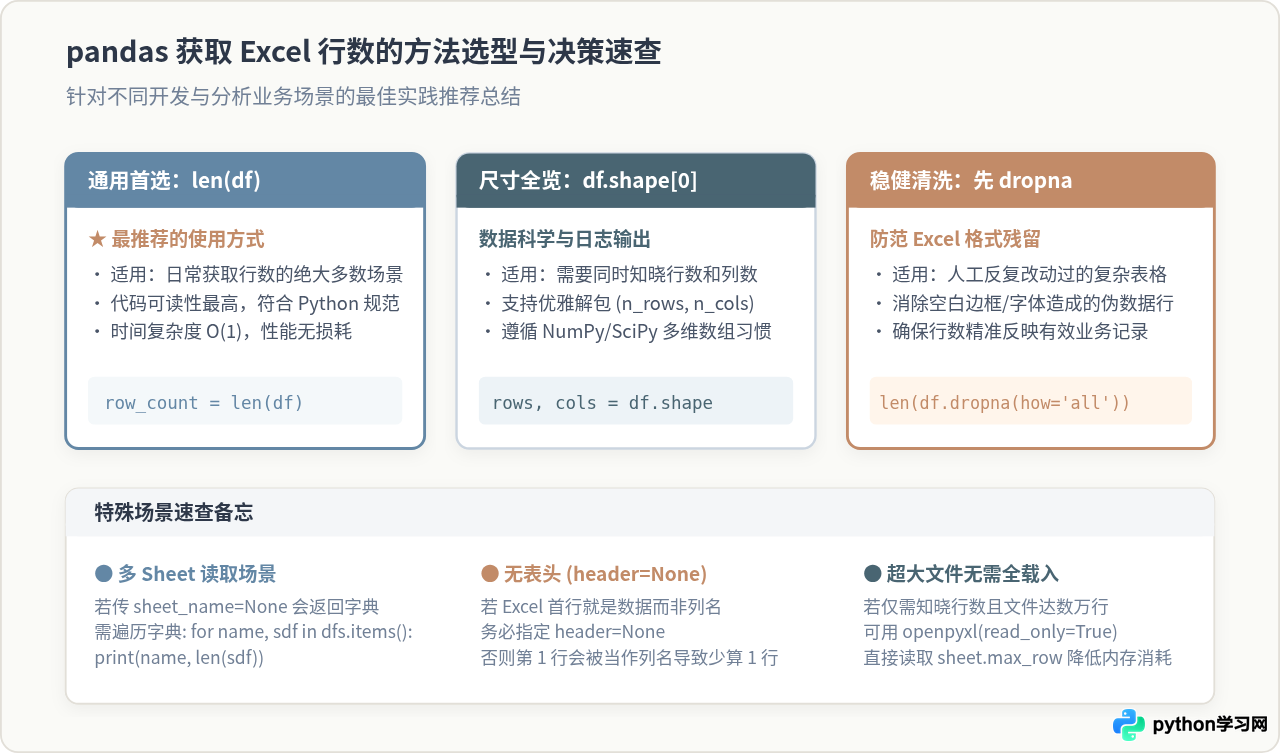
- 绝大多数常规场景:直接使用
len(df)。代码极短、执行时间达到 O(1) 毫秒级,且语义直截了当。 - 编写通用数据处理函数或日志监控:使用
rows, cols = df.shape。一行代码同时解构行列尺寸,便于格式化输出。 - 存在人工脏数据或 Excel 冗余空行:务必先调用
df.dropna(how='all')剔除幽灵空行,再通过len()测算真实行数。 - 区分业务需求:切勿混淆
len(df)(物理记录总行数)与df['col'].count()(特定列有效非空值数量)。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















