


Python property数据校验:在setter中添加类型与范围检查
深入解析如何在Python中利用@property和setter实现严密的数据校验。通过具体的类型检查与取值范围判断、规避布尔穿透陷阱、解决__init__初始化绕过问题,构建健壮的面向对象数据模型。
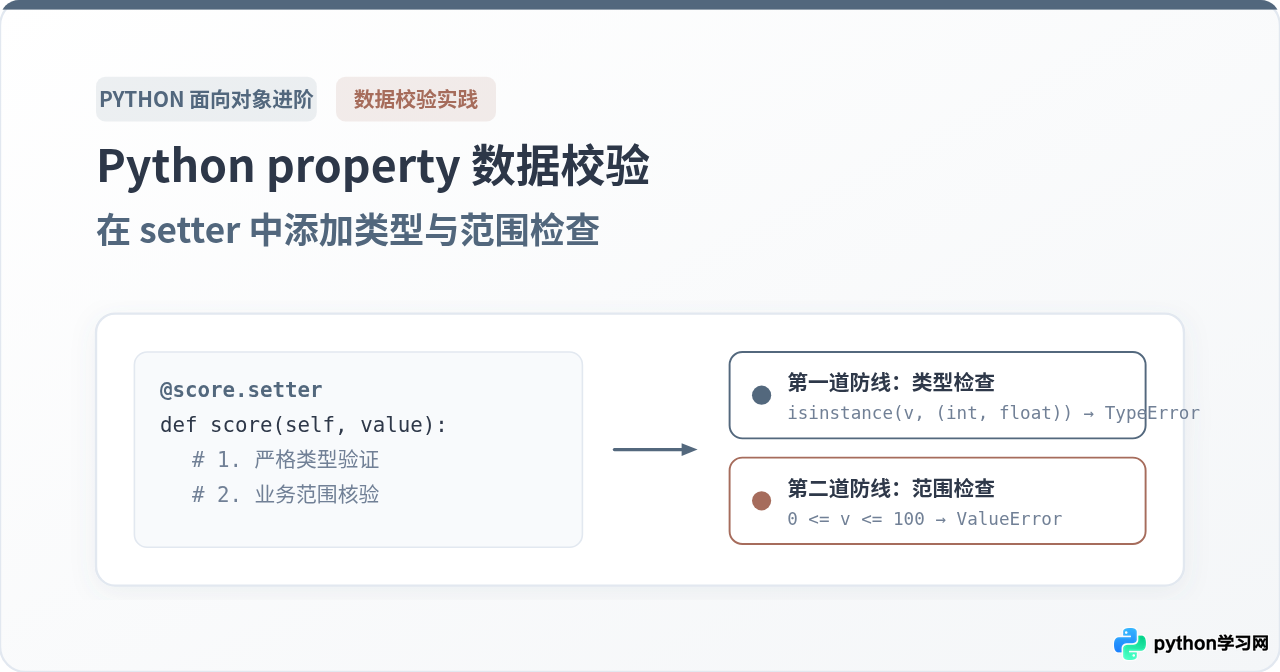
@property 装饰器及其配套的 @<attr>.setter。它能在保持外部“点号访问”(如 obj.val = 10)语法简洁性的同时,在赋值发生瞬间透明介入,执行严格的类型检查与业务取值范围检查,对非法输入抛出标准异常,从而从根本上杜绝对象内部产生脏数据。
一、为什么直接使用公共属性会留下隐患
Python 崇尚“大家都是成年人”的契约设计,默认情况下类中的属性都是公有的。当你定义一个简单的类并直接操作属性时,解释器不会做任何拦截。例如一个代表学生考试成绩的类:
class Student:
    def __init__(self, name, score):
        self.name = name
        self.score = score  # 公有属性,缺乏约束

s = Student("小明", 85)
s.score = -50           # 毫无预警地接受了负数!
s.score = "优秀"        # 甚至接受了字符串!
这种写法在小型脚本中非常快捷,但随着业务逻辑的推进,脏数据会在系统中静默扩散。直到下游函数执行 s.score + 10 时,程序才会突然崩溃并抛出异常。此时抛错的位置往往距离错误数据注入的时间点和代码行数已经非常遥远,排查成本极高。
如果照搬 Java 等静态语言的做法,为每个字段手写 get_score() 和 set_score() 方法,不仅会导致代码冗长、丧失 Pythonic 的自然属性访问感,还会破坏已经对外暴露的 API。
@property 机制正是为了平衡“天然语法体验”与“严格业务拦截”而设计的利器。
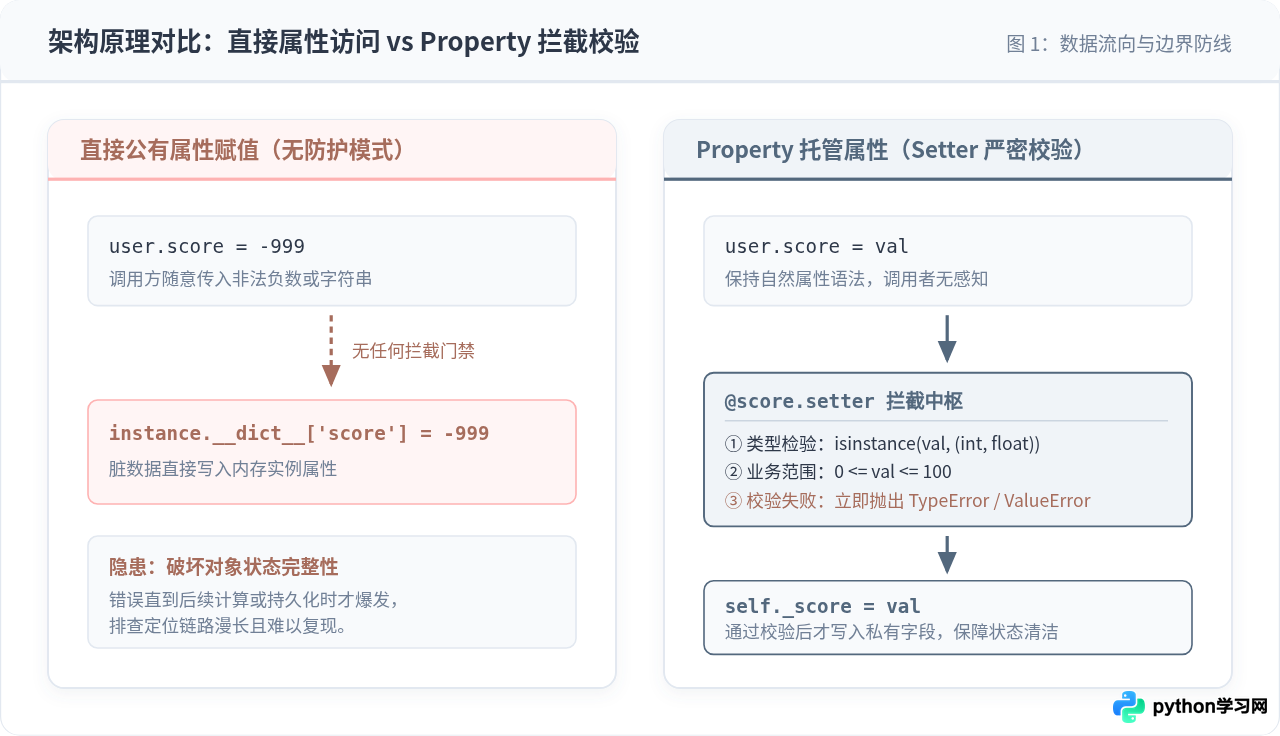
二、Property 的工作机制与底层私有变量隔离
要让属性具备校验能力,核心第一步是将真实的物理存储变量与对外的访问接口分离开来。
我们使用单下划线前缀的变量(如 _score)作为实例底层真实存储数据的私有变量(按照社区惯例表明受保护状态);然后定义一个与属性同名的函数(如 def score(self)),用 @property 装饰作为 Getter,用 @score.setter 装饰作为 Setter:
class Student:
    def __init__(self, name, score):
        self.name = name
        self._score = score  # 实际存储在 _score 中

    @property
    def score(self):
        """Getter:读取 score 属性时自动触发"""
        return self._score

    @score.setter
    def score(self, value):
        """Setter:对 score 赋值时自动触发,校验逻辑在此执行"""
        self._score = value
在 @score.setter 内部,必须写入带有下划线的内部变量 self._score = value。如果不小心写成了 self.score = value,该语句会再次触发当前 setter,从而造成无限递归,程序会立即崩溃并抛出 RecursionError: maximum recursion depth exceeded。
三、在 Setter 中实现阶梯式数据校验
有了拦截中枢之后,校验的编排次序直接决定了防御代码的健壮性。生产级别的校验必须严格遵循“先判定类型,再判定范围”的阶梯顺序。
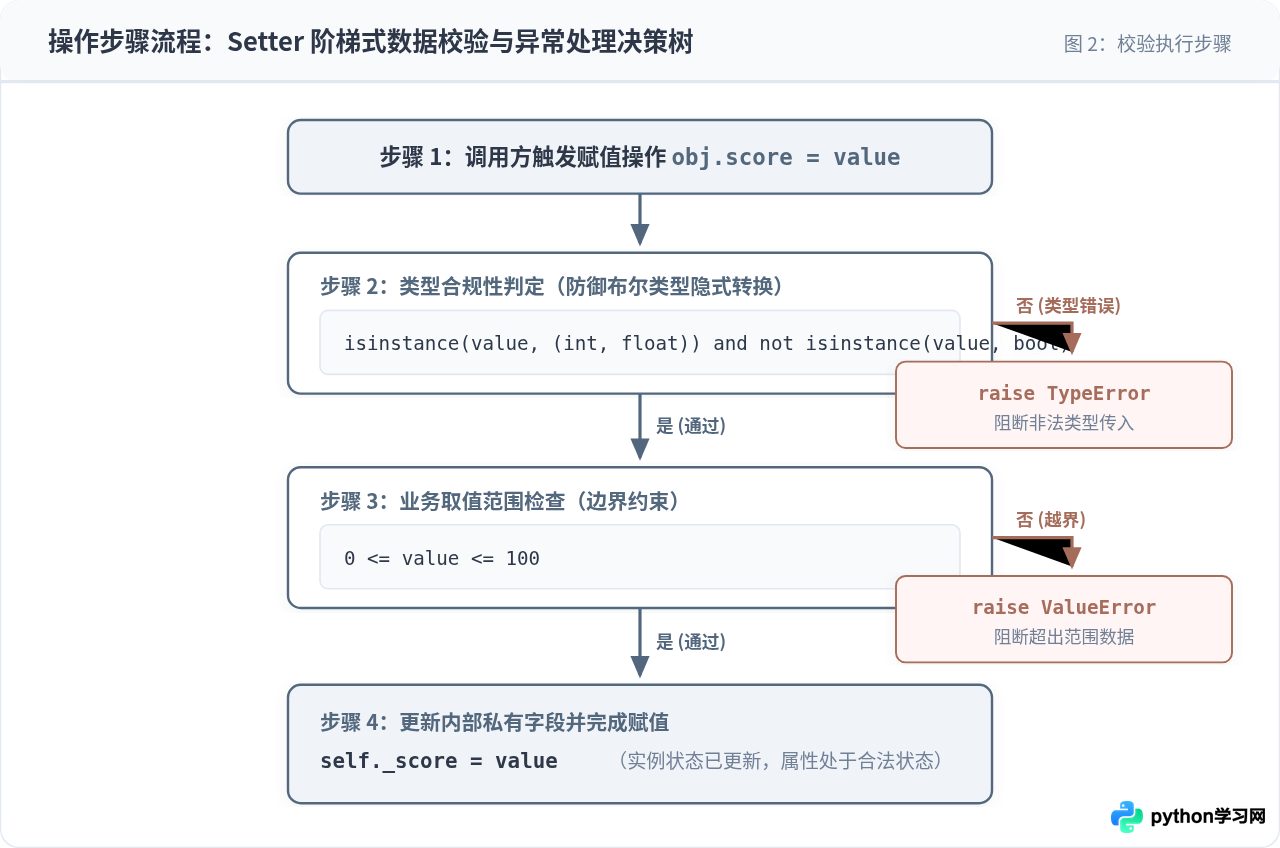
步骤 1:精确类型核验(警惕 Python 的 Bool 继承穿透)
Python 是一门强类型动态语言,类型校验首选内置函数 isinstance(),并且在类型不匹配时显式抛出标准异常 TypeError。
但在检查数值类型(int)时,有一个极易被忽略的语言特性:在 Python 中,bool 是 int 的直接子类!
这意味着如果你在终端输入 isinstance(True, int),返回值是 True;不仅如此,布尔值 True 在数值计算中等价于 1,False 等价于 0。
如果不做额外拦截,当调用方执行 s.score = True 时,纯粹的 isinstance(value, int) 校验将直接放行,最终学生分数被悄悄改成了 1 分。因此严谨的类型判断必须显式排除布尔值:
# 严密的类型检查示范
if not isinstance(value, (int, float)) or isinstance(value, bool):
    raise TypeError(
        f"score 期望类型为 int 或 float,但接收到了 {type(value).__name__} (值: {value!r})"
    )
步骤 2:业务取值范围核验
当数据类型确认合法后,再进入第二道防线:范围检查。若数值超出允许区间,应该抛出 ValueError。
为什么不能先检查范围再检查类型?因为如果调用者传入一个字符串 "95",而你先执行 0 <= value <= 100,在 Python 3 中不同类型的大小比较会直接抛出不受控的 TypeError: '<=' not supported between instances of 'int' and 'str'。这样不仅破坏了我们定制的清晰错误提示,也让代码职责变得混乱。
# 业务范围约束
if not (0 <= value <= 100):
    raise ValueError(
        f"score 取值范围必须在 [0, 100] 之间,当前值 {value} 超出边界"
    )
四、关键细节:解决 __init__ 初始化阶段的绕过漏洞
许多开发者在完成了 property 和 setter 的编写后,往往会在 __init__ 构造函数中写下这样的代码:
def __init__(self, name, score):
    self.name = name
    self._score = score  # 致命隐患:直接对下划线变量赋值,完全绕过了 setter!
这是一个非常隐蔽的反模式:由于直接为底层的 self._score 赋值,实例化时的操作根本不会经过 @score.setter。调用者依然可以通过 Student("张三", -999) 成功创建一个包含脏数据的对象!
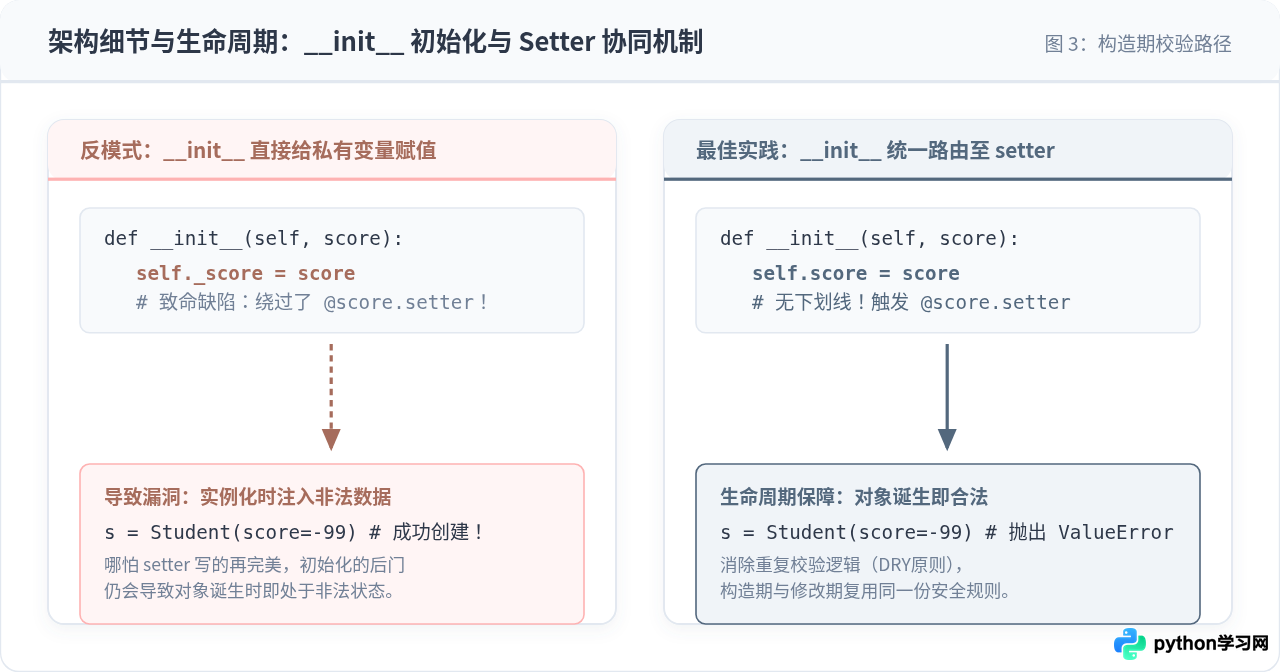
正确做法是:在 __init__ 中统一给公有属性赋值 self.score = score(不带下划线)。
这样做的好处是显而易见的:
- 杜绝逻辑重复(遵循 DRY 原则):校验规则只在 setter 中编写一次,实例化与后续修改共用同一套标准。
- 确保生命周期完整性:无论对象是通过构造函数创建,还是在后续运行中被修改,非法状态在诞生的那一刻就会被立即阻断。
五、完整工程级代码实现与验证
综合以上所有的设计要求,我们来看一个包含完整异常处理与严密边界防线的生产级实现:
class Student:
    """
    具备严密数据校验机制的学生实体类
    使用 property 管理 score 属性,提供类型与范围保障
    """

    def __init__(self, name: str, score: float):
        self.name = name
        # 统一走 property setter,确保初始化即受保护
        self.score = score

    @property
    def score(self) -> float:
        """读取学生成绩"""
        return self._score

    @score.setter
    def score(self, value: float) -> None:
        """
        写入学生成绩时进行双重防御校验:
        1. 必须是 int 或 float,且不能是 bool
        2. 必须处于 [0, 100] 闭区间内
        """
        # 关卡 1:类型核验
        if not isinstance(value, (int, float)) or isinstance(value, bool):
            raise TypeError(
                f"成绩属性 score 必须是数值类型 (int 或 float),"
                f"收到无效类型: {type(value).__name__}"
            )

        # 关卡 2:范围核验
        if not (0 <= value <= 100):
            raise ValueError(
                f"成绩属性 score 超出允许区间 [0, 100],当前传入值: {value}"
            )

        # 全部校验通过后,存入底层实例字段
        self._score = round(float(value), 2)

    def __repr__(self) -> str:
        return f"Student(name={self.name!r}, score={self.score})"
测试用例与执行效果验证
我们编写针对性的测试用例,覆盖正常赋值、类型异常、布尔穿透以及数值越界等多种场景:
# 1. 正常合法数据初始化与修改
s1 = Student("张华", 92.5)
print(s1)  # 示例输出: Student(name='张华', score=92.5)

s1.score = 100
print(s1.score)  # 示例输出: 100.0

# 2. 验证初始化时非法范围拦截
try:
    s2 = Student("李雷", 150)
except ValueError as err:
    print(f"捕获范围错误: {err}")
    # 示例输出: 捕获范围错误: 成绩属性 score 超出允许区间 [0, 100],当前传入值: 150

# 3. 验证布尔隐式穿透防御
try:
    s1.score = True
except TypeError as err:
    print(f"捕获类型错误: {err}")
    # 示例输出: 捕获类型错误: 成绩属性 score 必须是数值类型 (int 或 float),收到无效类型: bool

# 4. 验证字符串类型防御
try:
    s1.score = "满分"
except TypeError as err:
    print(f"捕获类型错误: {err}")
    # 示例输出: 捕获类型错误: 成绩属性 score 必须是数值类型 (int 或 float),收到无效类型: str
六、进阶建议与常见问题答疑
| 应用场景 / 考量点 | 推荐做法 | 反模式 / 需规避的行为 |
|---|---|---|
| 底层存储字段命名 | 使用单下划线前缀 _attr |
与公开属性重名(引发无限递归),或滥用双下划线名称改写机制(增加不必要的继承复杂度) |
| 异常抛出类型 | 类型错用 TypeError,取值越界用 ValueError |
笼统地抛出 Exception,导致调用方捕获时难以区分具体业务意图 |
| 初始化代码组织 | __init__ 中执行 self.attr = val |
在 __init__ 中重写一遍相同的校验逻辑(冗余且难以同步维护) |
| 只读属性设计 | 仅声明 @property,不声明 @setter |
在 setter 中抛出 AttributeError 来假装只读(标准做法是不提供 setter 即可) |
七、总结
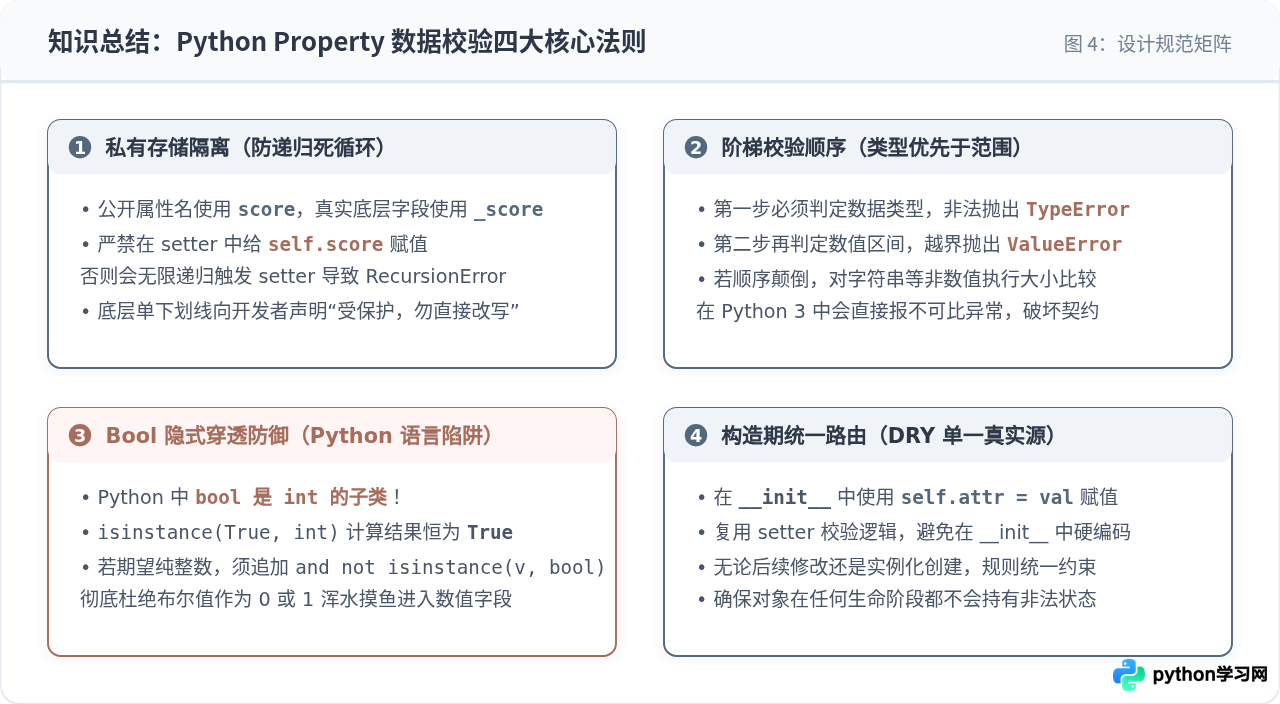
在 Python 中通过 @property 和 setter 实现数据校验,是面向对象设计中最具性价比的可靠性投资:
- 接口兼容性强:对外暴露完全符合直觉的属性操作体验,无论后续校验逻辑如何演进,都不会破坏已有使用者的调用习惯。
- 职责清晰独立:类型核验(
TypeError)与范围核验(ValueError)分层驻守,构建明确的契约界限。 - 全生命周期受控:借助
__init__对公开属性的赋值转发,使实例化与后续动态赋值使用相同的防护通道,从根本上杜绝脏数据进入内存模型。
掌握这一模式后,面对复杂的业务约束与领域模型设计,你都能写出既优雅从容又坚固可靠的 Python 代码。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















