


Python读取CSV表头出现中文乱码怎么办
详细讲解Python读取CSV文件时表头中文出现乱码或KeyError的根本原因与解决方法,包括UTF-8 BOM引起的ufeff前缀处理、GBK/GB18030编码适配、标准库csv与Pandas的修复代码及编码探测技巧。
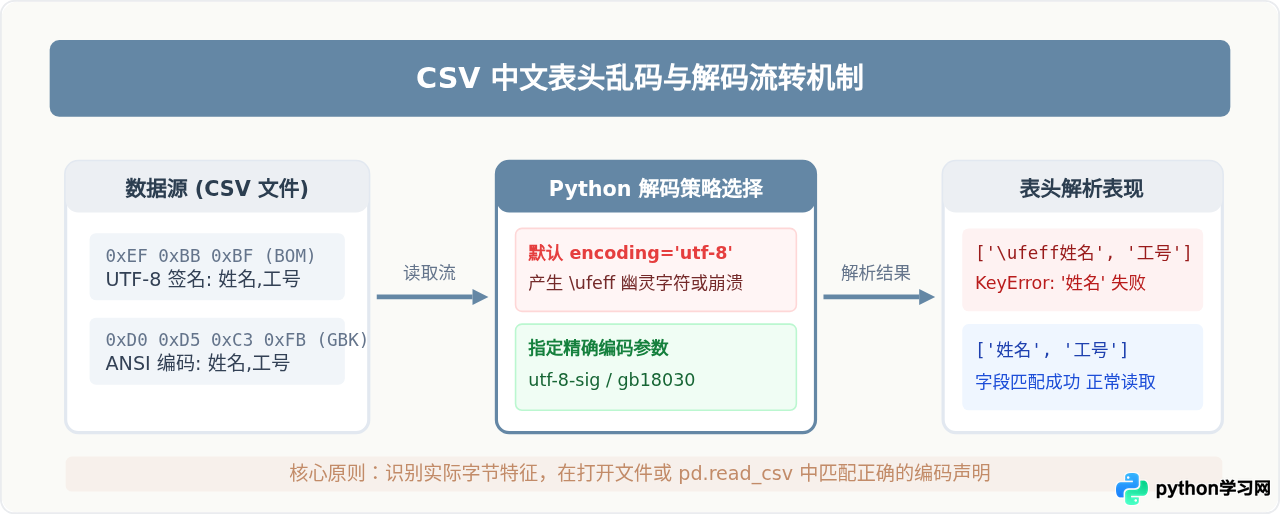
Python 读取 CSV 表头出现中文乱码,绝大多数由两种原因引起:一是文件以带有 BOM(字节顺序标记)的 UTF-8 格式保存,导致首个表头字段前多出不可见的 \ufeff 字符;二是 CSV 文件采用 Windows 系统默认的 GBK/GB2312 编码,而 Python 默认以 UTF-8 尝试解码导致报错或乱码。最直接有效的解决办法是在读取文件时显式声明编码参数:BOM 问题使用 encoding='utf-8-sig',Windows 中文编码问题使用 encoding='gb18030'。
一、两种典型的中文表头乱码表现与根本成因
在日常使用 Python 处理 CSV 数据时,中文乱码并不会以单一形态出现。根据文件保存来源与解码机制的差异,乱码通常体现为两种截然不同的具体表现。
1. 第一列中文看似正常,但索引查询触发 KeyError(BOM 幽灵字符)
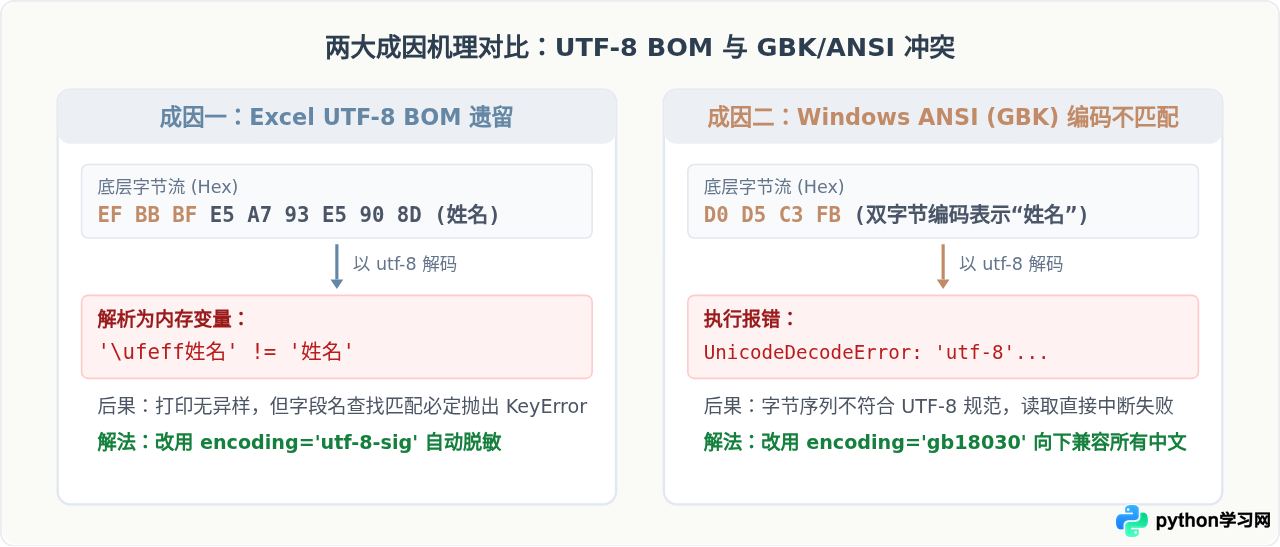
很多读者在用 Excel 导出数据时,选择了“CSV UTF-8(逗号分隔)(*.csv)”选项。Excel 在生成此类文件时,会在文件起始位置写入 3 个隐藏字节:0xEF 0xBB 0xBF,即 UTF-8 BOM 标记。如果直接使用 Python 标准的 encoding='utf-8' 读取,Python 不会自动剔除这三个字节,而是将其解码为 Unicode 零宽无间断空格字符(\ufeff)。
结果是表头列表变成了 ['\ufeff姓名', '年龄', '部门']。在终端打印时,\ufeff 通常不可见,肉眼看到的首列依然是“姓名”,但当执行 row['姓名'] 或 df['姓名'] 时,程序会直接抛出 KeyError: '姓名'。这是最隐蔽、最容易令人困惑的乱码类型。
2. 解码崩溃或直接显示为生僻乱码(GBK/ANSI 编码冲突)
国内许多业务系统、旧版数据库导出程序以及中文版 Windows 下的普通“CSV(逗号分隔)”格式,默认保存的字符集是 ANSI(在简体中文 Windows 下即 GBK 或 CP936 编码)。
当 Python 运行环境以 UTF-8 方式读取此类文件时,GBK 的双字节汉字编码序列不符合 UTF-8 变长字节规范,程序会立刻抛出 UnicodeDecodeError: 'utf-8' codec can't decode byte... 异常;若强行忽略错误或以其他不匹配方式打开,则表头会直接显示为类似 、δ֪ 或 æµè¯ 的无意义符号。
二、乱码排查决策树:如何快速确认具体原因
面对表头乱码或找不到列名时,不需要盲目更换编码尝试。按照下面的决策路径,可以在两分钟内准确定位原因。
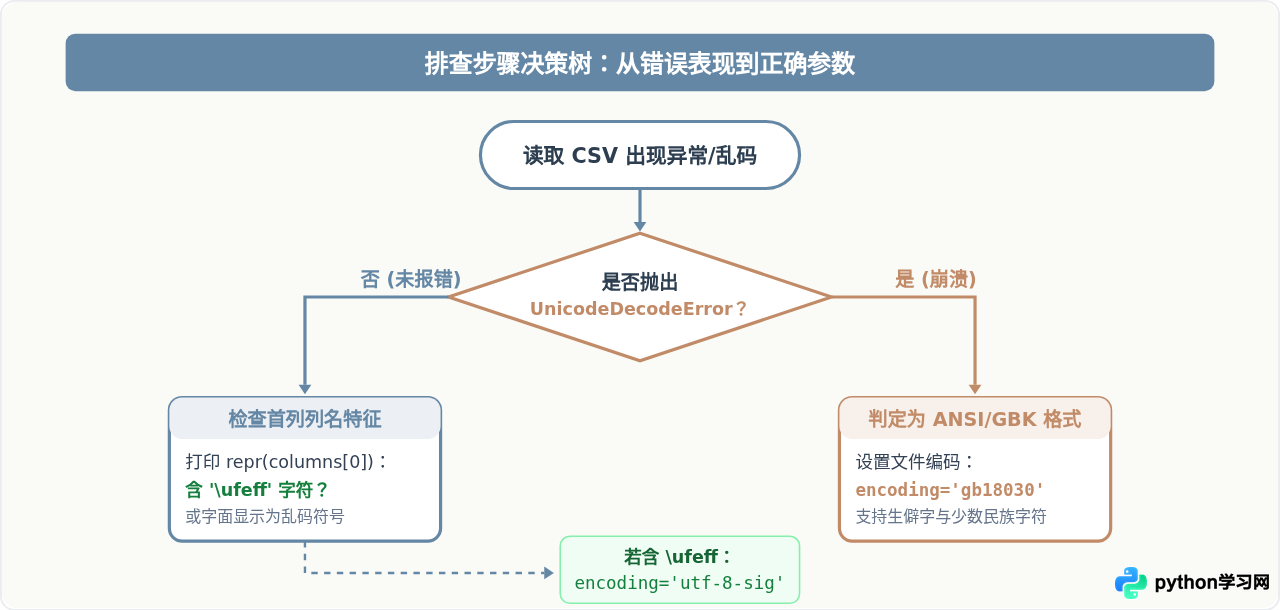
排查自检技巧:在 Python 交互环境或脚本中,不要直接用 print(col) 打印列名,而应使用 print(repr(col))。repr() 会把不可见字符转义输出。如果输出显示为 '\ufeff姓名',即可百分之百断定是 UTF-8 BOM 导致的问题。
三、针对性修复方案与完整代码示例
确认原因后,只需针对当前使用的模块(Python 内置 csv 模块或第三方 pandas 库)修改一行读取参数即可彻底解决。
方案一:Python 标准库 csv 模块的处理方法
使用标准库 csv.reader 或 csv.DictReader 时,编码参数是在内置函数 open() 中指定的,同时建议始终加上 newline='' 避免换行符被二次转义。
import csv

# 场景 1:解决 Excel 导出的 BOM 问题(首列带 \ufeff)
with open('data.csv', mode='r', encoding='utf-8-sig', newline='') as f:
    reader = csv.DictReader(f)
    # 此时 reader.fieldnames 中的首列为标准的 '姓名',无额外前缀
    print("表头字段:", reader.fieldnames)
    for row in reader:
        print(row['姓名'], row['部门'])

# 场景 2:解决 Windows 默认 ANSI/GBK 格式导致的解码错误
with open('data_gbk.csv', mode='r', encoding='gb18030', newline='') as f:
    reader = csv.reader(f)
    header = next(reader)
print("GBK 文件表头:", header)注意:推荐优先使用 gb18030 而非 gb2312 或 gbk。gb18030 是国家强制标准,不仅兼容 GBK 和 GB2312,还收录了大量人名生僻字和少数民族文字。如果使用 gbk,遇到生僻字时仍然可能抛出解码异常。
方案二:Pandas read_csv 的处理方法
数据分析中最常使用的 pandas.read_csv() 支持直接传入 encoding 参数:
import pandas as pd

# 场景 1:消除 BOM 造成的 KeyError
df_utf8 = pd.read_csv('data.csv', encoding='utf-8-sig')
print("DataFrame 列名:", df_utf8.columns.tolist())
# 安全访问列数据,不会再触发 KeyError
print(df_utf8['姓名'].head())

# 场景 2:读取中文 Windows 默认保存的 CSV
df_gbk = pd.read_csv('data_gbk.csv', encoding='gb18030')
print("GBK 列名:", df_gbk.columns.tolist())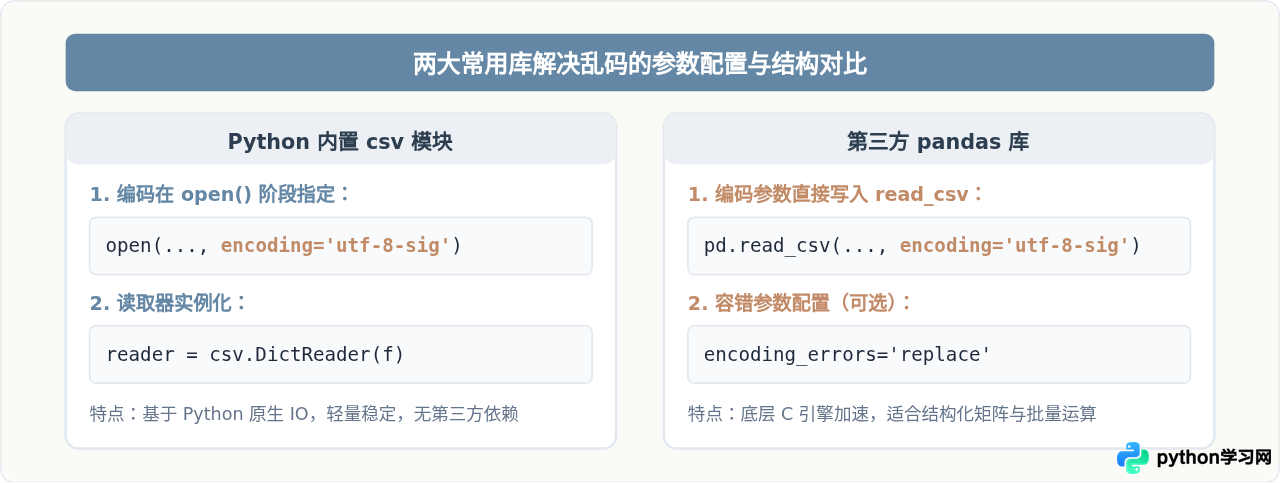
方案三:未知来源 CSV 的自动编码探测
在开发自动化批处理任务时,外部传入的 CSV 编码往往不统一。可以通过 Python 读取文件前几个字节进行特征探测,无需加载整个大文件:
def detect_and_read_csv(file_path):
    # 步骤 1:读取文件开头 3 个字节检查是否存在 UTF-8 BOM
    with open(file_path, 'rb') as f:
        first_3_bytes = f.read(3)

    if first_3_bytes == b'\xef\xbb\xbf':
        encoding = 'utf-8-sig'
    else:
        # 步骤 2:若无 BOM,优先尝试 utf-8,失败则回退到 gb18030
        try:
            with open(file_path, 'r', encoding='utf-8') as f:
                f.read(1024)  # 尝试读取前 1KB 文本验证解码
            encoding = 'utf-8'
        except UnicodeDecodeError:
            encoding = 'gb18030'

    print(f"检测到文件 [{file_path}] 的适用编码为: {encoding}")

    # 步骤 3:使用确定好的编码读取数据
    with open(file_path, 'r', encoding=encoding, newline='') as f:
        reader = csv.reader(f)
        header = next(reader)
        print("解析得到的正确表头:", header)
    return encoding
四、排查总结与生产环境避坑指南
为了在实际项目中彻底杜绝表头乱码带来的线上 Bug,建议遵循以下总结规范:
| 异常表现 | 底层原因 | 标准库推荐写法 | Pandas 推荐写法 |
|---|---|---|---|
打印表头正常,但查询报 KeyError |
包含 UTF-8 BOM (\ufeff) |
open(..., encoding='utf-8-sig') |
pd.read_csv(..., encoding='utf-8-sig') |
报 UnicodeDecodeError 错误 |
文件为 ANSI/GBK/GB2312 编码 | open(..., encoding='gb18030') |
pd.read_csv(..., encoding='gb18030') |
| 包含生僻字(如“䶮”、“赟”)报错 | 使用了过旧的 gb2312 或 gbk |
open(..., encoding='gb18030') |
pd.read_csv(..., encoding='gb18030') |
| 跨系统批处理未知 CSV 文件 | 文件来源异构(不同操作系统导出) | 前置读取 3 字节判断 BOM 后分流 | 结合 encoding='utf-8-sig' 与 try-except |
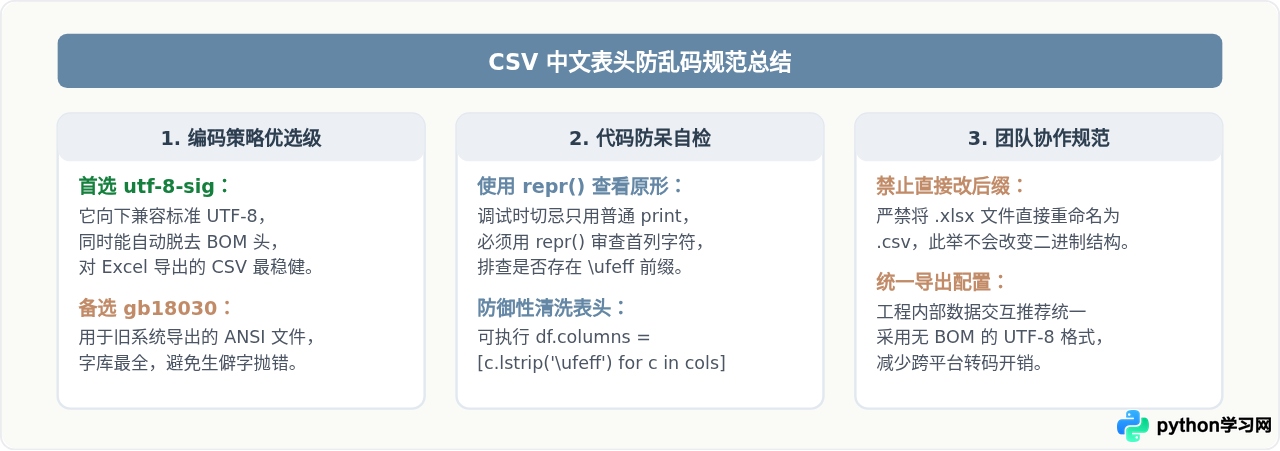
总结来说,Python 读取 CSV 表头乱码的解决逻辑非常明晰:如果首列字段索引报错,改用 encoding='utf-8-sig';如果直接抛出 UnicodeDecodeError 或字符变成乱码符号,改用 encoding='gb18030'。在批量读取不确定来源的文件时,配合前 3 字节的二进制嗅探逻辑,即可让程序具备稳定应对各类 CSV 编码的鲁棒性。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















