


排查Python微服务集群中的序列化错误与网络超时问题
深入解析Python微服务集群中序列化失败引发级联超时的技术根因,提供涵盖Trace关联、py-spy堆栈分析、抓包分析、契约加固与分段超时配置的系统化五步排查实践指南。
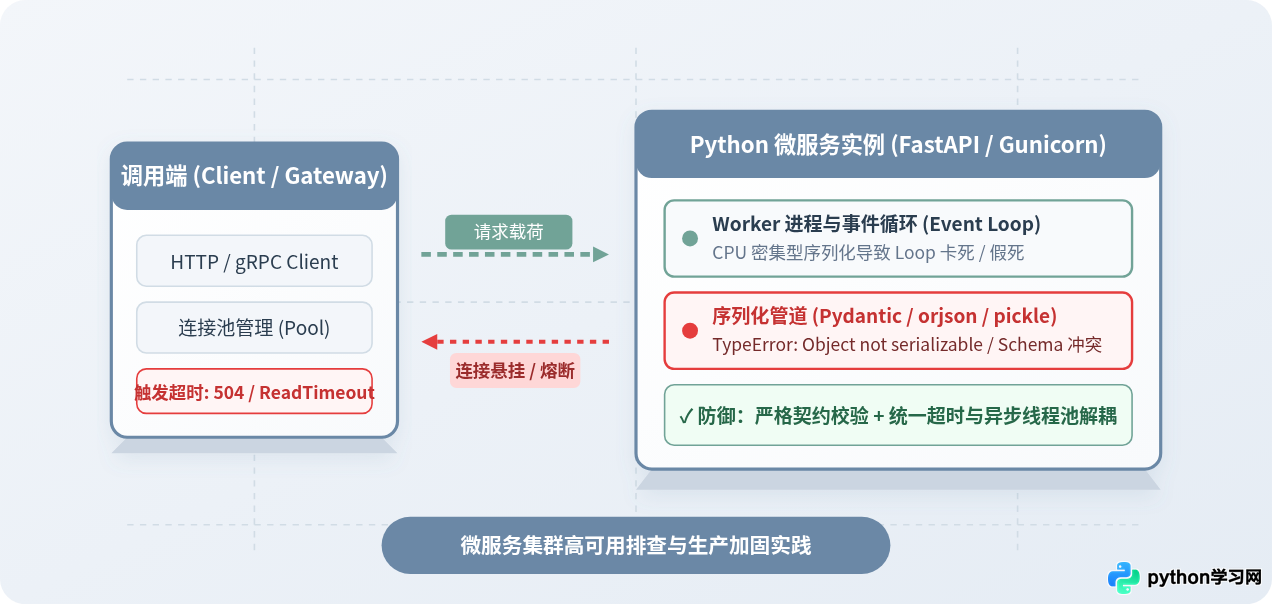
504 Gateway Timeout 或 ReadTimeout 错误。排查此类问题的核心逻辑,在于利用分布式追踪串联两端日志,将“超时表象”解构为“序列化失败”、“事件循环卡死”与“网络参数失配”三种典型场景,并通过统一数据契约、配置精细化分段超时与采用非阻塞高效编码器来根治隐患。
一、故障初现:序列化失败与级联超时的典型表象与关联机制
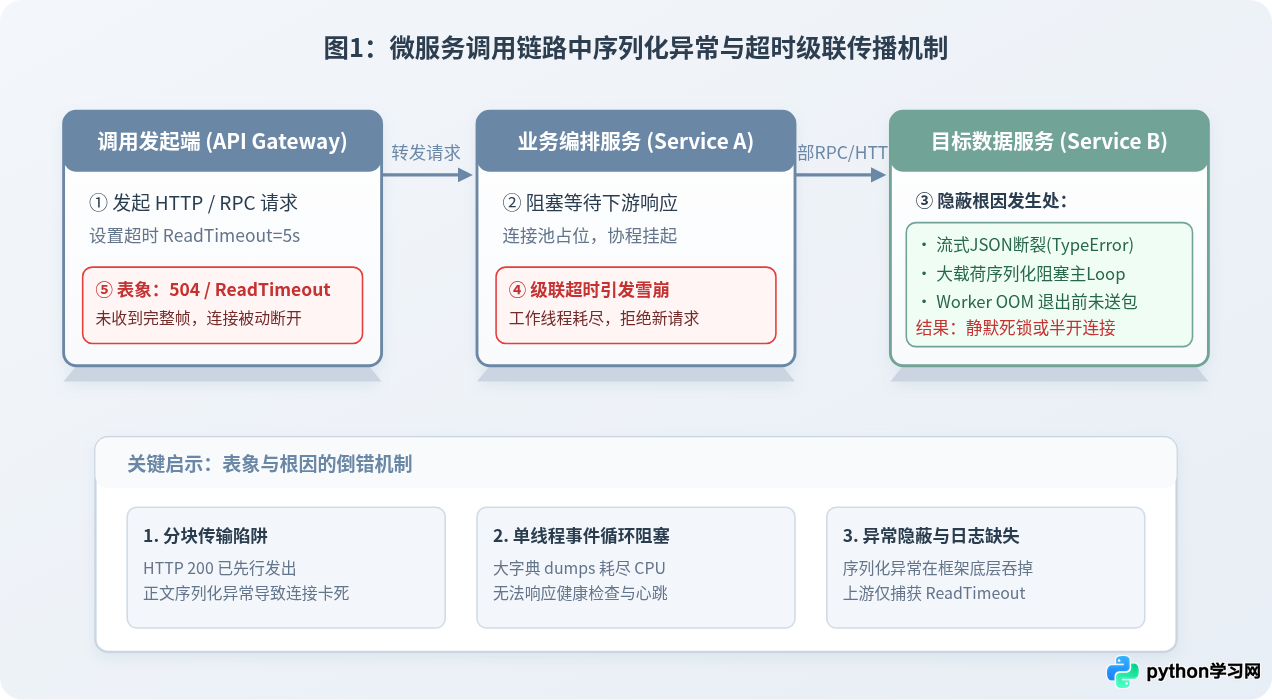
在分布式调用链路中,上游客户端与下游服务端由网络代理、连接池以及 HTTP/gRPC 传输协议所连接。很多研发人员在排查时容易陷入“只看上游报错”的误区,一看到超时就误以为是机房网络波动或数据库慢查询,但实际情况中,序列化异常常常会通过以下三种机制转化为网络超时:
- 机制 A:分块流式传输(Chunked Transfer Encoding)中断
为了降低首字节耗时,很多现代 Web 框架(如 FastAPI、Starlette、aiohttp)在返回大对象或生成器时采用流式传输。此时服务已率先向客户端发送了HTTP 200 OK状态码与响应头;但在向传输套接字写入 JSON 正文的过程中,一旦某个嵌套字段出现无法序列化的对象抛出TypeError,ASGI 运行时只能被迫掐断连接。由于报文未发送标准结束标志位(0),上游网关或客户端只能持续挂起套接字,直到达到预设的读取超时(ReadTimeout),最终向上层抛出504 Gateway Timeout。 - 机制 B:单线程主事件循环(Event Loop)被密集序列化卡死
Python 异步框架(如 Uvicorn + uvloop)以单进程单线程单事件循环为核心运行机制。json.dumps()属于纯 CPU 计算任务,且在 CPython 下持有全局解释器锁(GIL)。如果服务端在一次请求中对包含数十万条记录的 ORM 字典进行同步序列化,主线程可能会持续独占 CPU 达 1~5 秒。在此期间,该 Worker 进程无法调度任何网络 I/O 协程,包括处理新的 TCP 握手请求、响应连接保活探针(Keep-Alive)与读取请求体。由于无法响应心跳,上游 Nginx 或负载均衡器判定该节点未响应并触发重试,进而将流量全部打到其他节点,引发全集群工作进程假死与超时雪崩。 - 机制 C:Worker 进程崩溃重启导致连接悬挂
当微服务反序列化超大 JSON 报文或包含极端嵌套的对象时,极易因内存瞬时暴涨触发操作系统的 OOM Killer,或者因递归层次超限触发 Python 内部机制崩溃。Gunicorn 主进程感知到子进程异常退出后会拉起新进程,但此时已经建立的 TCP 套接字处于不可用状态。由于客户端没有收到合法的 HTTP 响应报文,上游连接池中的链接直接变为半死状态,最终报出Connection reset by peer或ReadTimeoutError。
典型生产报错日志样例对照
排查的第一要务是学会辨识调用方与提供方在同一时刻生成的成对日志:
# 客户端捕获到的通常是抽象的网络超时与连接截断异常
[2026-10-31 14:22:15.102] ERROR [client.py:84] - TraceID: 4bf92f3577b34da6a3ce929d0e0e4736
httpx.ReadTimeout: The read operation timed out after 5.0 seconds
    at httpx._transports.default.ResponseStream.read()
    ...
[2026-10-31 14:22:15.105] WARNING [gateway.proxy:142] - Downstream service B returned HTTP 504 Gateway Time-out
Upstream target: 10.244.3.18:8000, Request duration: 5003ms# 服务端在几秒前或同一毫秒记录了序列化崩溃,或完全无响应日志
[2026-10-31 14:22:10.098] ERROR [uvicorn.error:39] - Exception in ASGI application
Traceback (most recent call last):
File "uvicorn/protocols/http/httptools_impl.py", line 426, in run_asgi
File "fastapi/applications.py", line 1054, in __call__
File "starlette/responses.py", line 256, in stream_response
File "starlette/responses.py", line 58, in render
File "json/__init__.py", line 231, in dumps
File "json/encoder.py", line 199, in encode
TypeError: Object of type Decimal('1894.2000') is not JSON serializable
# 紧接着底层连接出现 Broken pipe
[2026-10-31 14:22:15.103] WARNING [uvicorn.protocols:190] - Client disconnected before response was fully sent (BrokenPipeError)二、根因深度剖析:Python 微服务集群中的三大技术暗礁
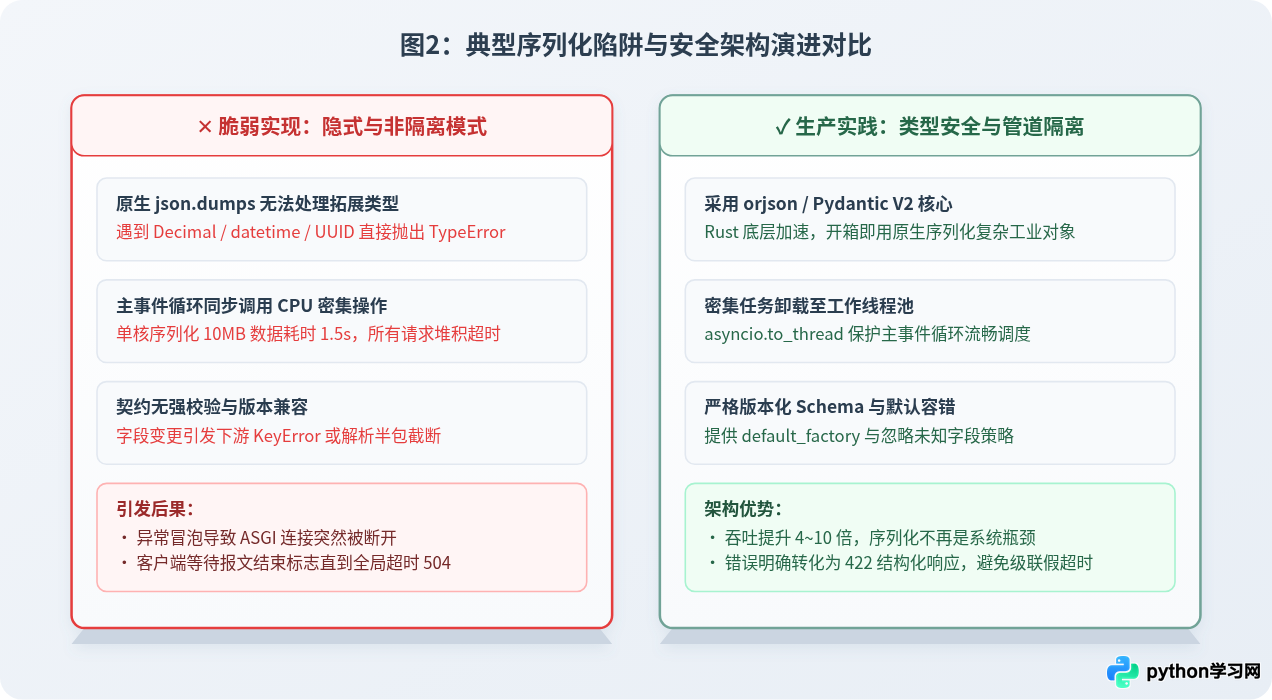
通过对大量微服务故障现场的复盘,可以将序列化引发网络超时的根本技术诱因归纳为三类暗礁:
1. 动态类型的“序列化黑洞”与版本契约漂移
Python 标准库自带的 json 模块只支持基础类型(dict、list、str、int、float、bool、None)。企业级微服务中经常出现的以下对象会触发隐式崩溃:
- 高精度数值
decimal.Decimal:金融结算系统常用,原生序列化报错;若强转为float会丢失精度。 - 带有时区信息的
datetime.datetime与UUID:ORM 层读取后未做规范化处理,直接注入返回体。 - 循环引用与无限嵌套:业务实体在双向关联(如用户与订单互相持有指针)时,序列化器陷入无限递归,抛出
RecursionError: maximum recursion depth exceeded while calling a Python object。 - 灰度发布时的 Schema 契约漂移:老服务未设置“忽略未知字段”(
extra="ignore"),新服务增加了枚举值或改动了数据结构,导致老服务在反序列化验证阶段耗尽 CPU 重试或直接抛出校验失败。
2. 异步运行时下的 CPU 密集型开销死锁
当序列化载荷超过 1MB 时,Python 的序列化开销呈现非线性增长。以 Python 标准库 json.dumps() 为例,序列化一个 20MB 的复杂深层嵌套字典在普通服务器 CPU 上大约需要 800ms~1500ms。在这 1 秒多的时间里:
- 主线程被完全锁死,GIL 阻止任何其他 Python 线程利用多核算力;
- 操作系统的 TCP 接收缓冲区(Receive Buffer)迅速填满,新的请求被内核丢弃或进入等待队列;
- Kubernetes 集群的存活探针(Liveness Probe)由于连续 3 次探测(每次超时 1s)未收到 200 回包,误判定容器已卡死并强制重启 Pod,从而导致正在传输中的长链接全线被杀。
3. 网络超时模型不健全与配置断层
很多工程团队对超时的理解停留在一个全局变量 timeout=30。而在微服务分层调用中,网络耗时由以下几个阶段构成:
- 连接建立超时(Connect Timeout):TCP 三次握手与 TLS 协商耗时,正常内网通常在毫秒级(一般设为 2~3s 防突发阻塞)。
- 首字节读取超时(First Byte / Read Timeout):客户端发送完请求体到接收到响应第一个字节之间的等待时间。如果服务端执行复杂查询或卡在序列化阶段,耗时主要集中在此。
- 分块流式传输间隔超时(Chunk Timeout):两个数据分块之间的时间差。
- 连接池等待超时(Pool Timeout):客户端连接池连接全部被占满时,新请求在队列中的等待时间。
如果调用链各层级的超时配置发生倒挂(例如客户端设置读取超时为 5 秒,而下游 Gunicorn Worker 超时配置为 30 秒,网关层配置为 60 秒),就会产生大量的孤儿请求(Orphan Requests):客户端已断开重试,下游服务端仍在浪费计算资源序列化并抛出异常。
三、系统化排查:五步诊断法与核心工具链
遇到微服务集群突发大面积超时告警时,按照系统化五步排查法,可以快速收敛根因范围:
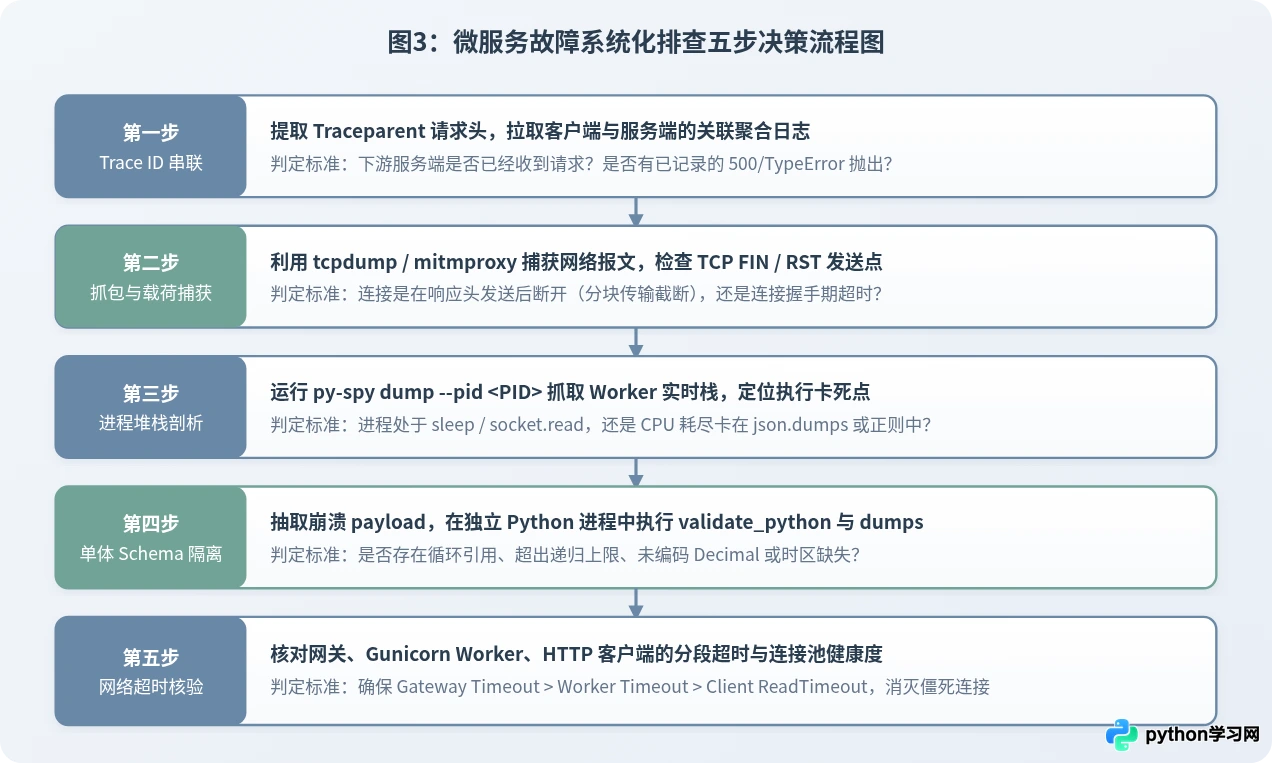
步骤一:提取 Trace ID 串联全链路日志
在分布式微服务架构中,必须保证所有跨服务请求携带符合 W3C Trace Context 规范的 traceparent 请求头。通过日志系统(如 OpenSearch / Loki)检索该 Trace ID:
- 对比时间差:记录客户端发起请求时间戳 $T_1$、客户端判定超时时间戳 $T_2$、服务端接收时间戳 $T_3$ 与服务端返回时间戳 $T_4$。
- 分析判定:如果 $T_3$ 根本不存在,说明请求在网关排队或在客户端连接池即被阻塞;如果 $T_3$ 存在但服务端没有 $T_4$,且时间跨度恰好等于客户端超时阈值,则明确故障瓶颈在下游服务的执行或序列化返回阶段。
步骤二:流量抓包与故障载荷捕获
如果应用层日志没有记录异常,需要通过抓包工具检查网络报文与套接字状态。在下游 Pod 或虚拟机内部执行抓包命令:
# 示例命令:捕获服务监听的 8000 端口并写入 pcap 文件
tcpdump -i any port 8000 -s 0 -w /tmp/debug_network.pcap -vv

# 抓包完成后通过 tshark 快速过滤 TCP 异常标志位(RST 与 FIN)
tshark -r /tmp/debug_network.pcap -Y "tcp.flags.reset == 1 or http.response.status_code >= 500"
Wireshark 关键特征分析:
- 如果看到服务端发送了
HTTP/1.1 200 OK以及部分Data Chunk,紧接着紧随一个TCP RST,说明下游 Python 进程在序列化过程中由于未处理的异常直接崩溃或异常退出了。 - 如果抓包显示服务端长达数秒没有发送任何 TCP 报文,甚至连对客户端数据包的 ACK 回应都有明显延迟,这标志着宿主机或容器的操作系统网络协议栈因 CPU 占用 100% 出现软中断积压。
步骤三:进程级堆栈剖析与事件循环探查
当怀疑 Python Worker 进程卡死在序列化或死循环中时,严禁随意重启进程。推荐使用针对 Python 运行时的非侵入式性能探针 py-spy:
# 1. 查找当前占用 CPU 异常的 Python Worker PID
ps aux | grep gunicorn

# 2. 非侵入式输出该 Worker 当前所有线程的完整调用栈(无需修改代码,无需重启进程)
py-spy dump --pid 42891

# 3. 示例输出:如果卡在序列化,会直接定位到源码行数
# Thread 0x7f9a2b1f8700 (active):
#     encode (json/encoder.py:199)
#     dumps (json/__init__.py:231)
#     render (starlette/responses.py:58)
#     stream_response (starlette/responses.py:256)
#     query_financial_records (services/order_service.py:145)
若堆栈显示长期停留在 json/encoder.py、pydantic_core 或复杂的对象拷贝函数中,即可 100% 确诊为序列化 CPU 耗尽导致主循环停摆。
步骤四:单体 Schema 隔离与边界重放
将抓包或日志中捕获到的实际业务载荷提取为独立的 JSON 文件或 Python 字典,在单机测试环境下编写最小复现脚本:
# reproduce_issue.py
import json
from decimal import Decimal
from datetime import datetime

# 模拟引发生产崩溃的复杂业务载荷
faulty_payload = {
    "order_id": "ORD-2026-99881",
    "created_at": datetime.now(),         # 原生 json 不支持
    "amount": Decimal("1894.2000"),        # 原生 json 不支持
    "metadata": {"tags": {"vip", "promo"}} # set 集合原生不支持
}

def test_std_json():
    try:
        # 复现标准库序列化抛出 TypeError
        json.dumps(faulty_payload)
    except TypeError as e:
        print(f"[复现成功] 标准库序列化异常: {e}")

if __name__ == "__main__":
test_std_json()[复现成功] 标准库序列化异常: Object of type datetime is not JSON serializable步骤五:网络层与连接池配置核对
在确认代码逻辑之余,检查 Linux 宿主机网络套接字指标:
- 执行
ss -s检查系统套接字概览,若timewait或closed数量达数万,说明服务未启用长连接(Keep-Alive),每次调用都在频繁建立与销毁 TCP 连接。 - 检查客户端使用的连接池参数(如 HTTPX 的
limits=httpx.Limits(max_keepalive_connections=20, max_connections=100)),若max_connections设置过小,高并发下新请求将在本地排队等待连接释放,直接吃满PoolTimeout。
四、生产级修复与工程落地方案
解决此类问题需要从“高效安全的序列化实现”、“分段超时规范”与“架构防护机制”三个维度建立长效防御:
1. 代码级加固:全面升级至 orjson 与 Pydantic V2
替换掉效率低下且类型支持受限的原生 json 库。推荐采用由 Rust 编写的高性能 JSON 库 orjson,它原生支持 dataclass、datetime、UUID、numpy 数组以及 Decimal(通过配置项):
# safe_serializer.py
from decimal import Decimal
from typing import Any
import asyncio
import orjson
from fastapi.responses import Response

def default_type_fallback(obj: Any) -> Any:
    """兜底自定义类型序列化器"""
    if isinstance(obj, Decimal):
        # 视业务要求转为字符串避免浮点精度丢失,或转为 float
        return str(obj)
    if isinstance(obj, set):
        return list(obj)
    raise TypeError(f"Type {type(obj)} not serializable")

def safe_dumps(data: Any) -> bytes:
    """使用 orjson 进行高性能二进制序列化"""
    return orjson.dumps(
        data,
        default=default_type_fallback,
        option=(
            orjson.OPT_NON_STR_KEYS |          # 允许非字符串字典键
            orjson.OPT_SERIALIZE_NUMPY |       # 支持 numpy
            orjson.OPT_PASSTHROUGH_DATACLASS  # 支持 dataclass
        )
    )

class FastORJSONResponse(Response):
    """FastAPI 高性能定制响应类,避免阻塞主循环"""
    media_type = "application/json"

    def render(self, content: Any) -> bytes:
        if content is None:
            return b""
        if isinstance(content, bytes):
            return content
        return safe_dumps(content)

async def offload_heavy_serialization(large_data: Any) -> bytes:
    """将超大载荷序列化卸载至异步工作线程池,守护主事件循环流畅调度"""
return await asyncio.to_thread(safe_dumps, large_data)orjson 的序列化与反序列化吞吐量通常是 Python 标准库 json 的 4~10 倍。更重要的是,通过 asyncio.to_thread 将大于 2MB 的复杂载荷序列化任务抛入线程池执行,可以让异步服务的主事件循环彻底摆脱单核 CPU 密集型任务的绑架,即便序列化耗时较长,其他连接的心跳与请求仍能平稳调度。
2. 通信协议层:微服务分段超时黄金矩阵
微服务调用必须严格定义分离式超时,禁止使用单一超时变量。以下为生产级 HTTP 客户端(以 HTTPX 为例)的标准配置:
import httpx

# 生产级精细化超时定义
TIMEOUT_CONFIG = httpx.Timeout(
    connect=2.0,   # 内网 TCP 握手与 TLS 协商:2 秒未建立立即快速失败
    read=6.0,      # 服务端业务执行与传输首包读取:给予合理业务处理缓冲
    write=5.0,     # 向服务端发送大请求体超时
    pool=2.0       # 从本地连接池获取空闲连接的最长排队时间
)

# 连接池健康参数
LIMITS_CONFIG = httpx.Limits(
    max_connections=200,          # 全局最大连接数
    max_keepalive_connections=50,  # 保持长连接池的套接字数
    keepalive_expiry=30.0         # 30秒内复用长连接
)

client = httpx.AsyncClient(
    timeout=TIMEOUT_CONFIG,
    limits=LIMITS_CONFIG,
    http2=True  # 启用 HTTP/2 多路复用,消除队头阻塞
)
超时时间层级递减原则:
为了防止链路各节点“倒挂抢跑”,在调用链路径上,超时配置必须满足:
客户端最长等待 (Client Timeout) < 服务端 Worker 超时 (Gunicorn --timeout) < 网关路由超时 (Gateway proxy_read_timeout)
例如:调用端设置 read=8s;下游 Gunicorn 设置 --timeout 12;API 网关设置 proxy_read_timeout 15s。这样当下游发生异常时,调用方可先决熔断,服务端 Worker 在 12 秒时由看门狗回收,网关最后完成兜底,杜绝孤儿连接堆积。
五、总结与集群高可用防御核对清单
解决 Python 微服务集群中的序列化错误与网络超时问题,核心不在于盲目调大超时时间,而在于建立从数据模型契约、序列化执行隔离到通信参数的体系化防护:
| 治理维度 | 排查检查项 | 推荐生产配置 / 方案 | 防护效果 |
|---|---|---|---|
| 数据契约 | 是否存在 Decimal、datetime、UUID 等非标准类型 | 采用 Pydantic V2 强契约 + orjson 编解码器 | 消灭 TypeError 导致的传输流中断 |
| 事件循环 | 是否在主线程同步序列化 >1MB 的大字典 | asyncio.to_thread 卸载至底层线程池 |
保持 Event Loop 毫秒级心跳,消除假死超时 |
| 客户端超时 | 是否使用单一全局超时 timeout=30 |
分离超时:connect=2s, read=6s, pool=2s |
快速识别网络握手故障,释放连接池阻塞 |
| 进程守护 | Worker 进程是否出现无响应假死 | Gunicorn 启用心跳监测与内存阈值回收 | 防止内存泄漏与阻塞进程永久霸占节点 |
| 链路追踪 | 网关与服务日志能否按请求关联 | 严格透传 traceparent,在日志中打印 TraceID |
实现故障点跨服务 30 秒快速定位 |
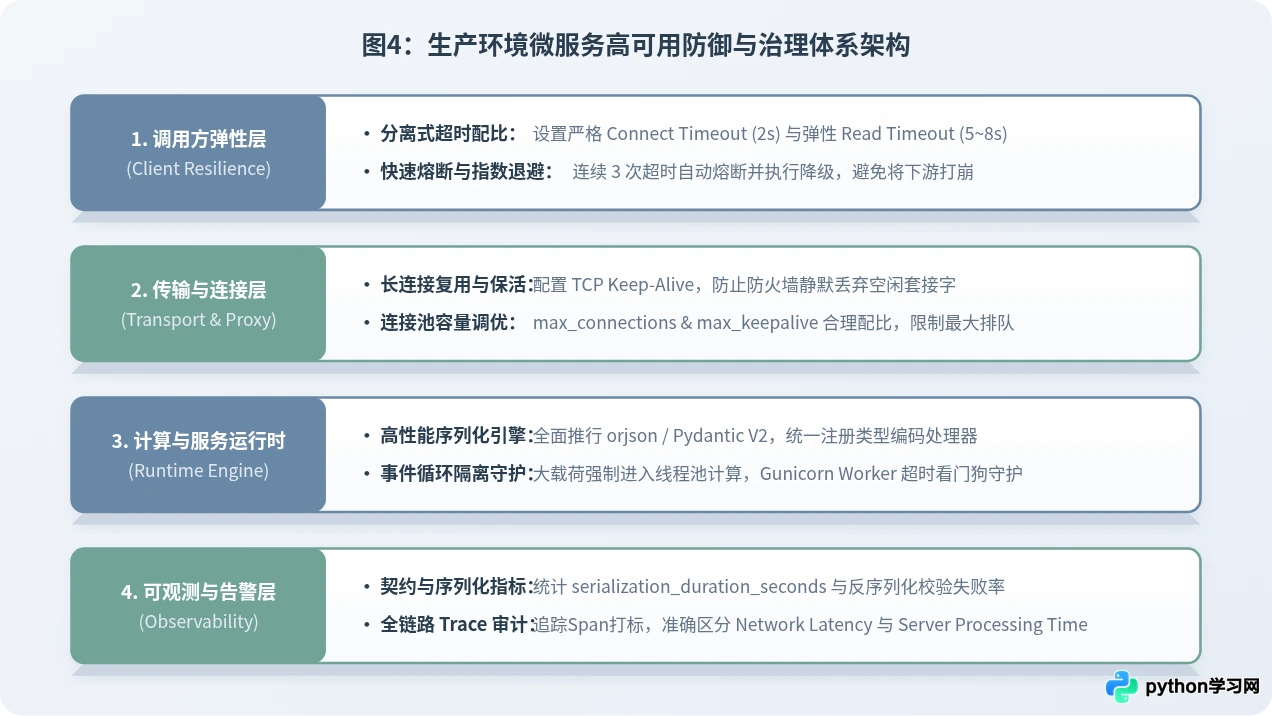
通过遵循上述排查步骤与工程实践,当微服务集群再次出现超时告警时,研发与运维人员能够在第一时间通过 Trace ID 对齐全链路状态,运用 py-spy 与抓包手段准确定位阻塞点,从根本上杜绝序列化异常伪装成网络超时的隐蔽故障,确保集群在高并发场景下的稳健运行。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















