


Python同类库怎么选?常见功能模块的对比与最佳实践

选择 Python 第三方库的本质不是寻找名气最大的库,而是为具体项目的场景边界、性能瓶颈、维护预期与团队技术栈找到最具性价比的平衡点。本文梳理了工程开发中最常面临选型分歧的五大功能模块(网络请求、数据处理、数据校验、Web 框架与命令行工具),提炼出一套可落地的技术选型决策漏斗,并结合实际代码与架构机制给出最佳实践。
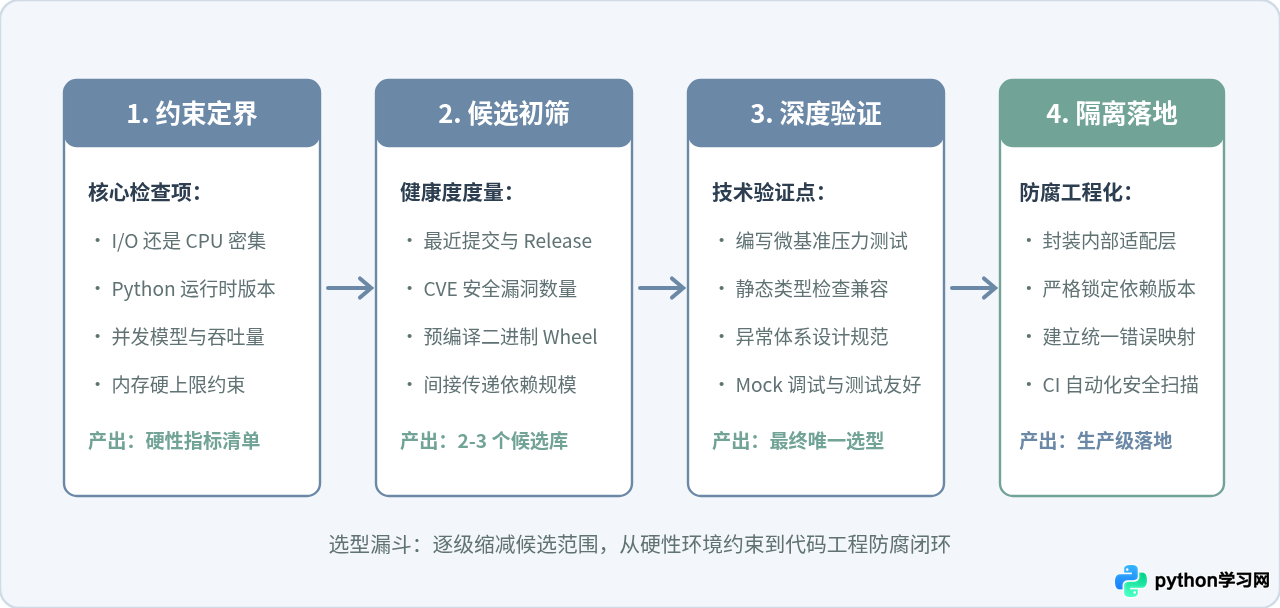
一、第三方库选型的四维决策模型
面对社区中层出不穷的同类库,凭直觉或盲目追新往往会在项目后期带来沉重的重构包袱。一个成熟的工程选型决策应当经过四个阶段的递进评估:
- 场景契合度:明确业务对同步/异步、阻塞容忍度、内存占用以及启动耗时的具体硬性要求。
- 活跃度与供应链安全:评估维护者活跃周期、近半年发布频率、未解决安全漏洞(CVE)以及是否提供预编译轮子(Wheel)。
- 工程与类型体验:检查文档完整度、现代类型注解(Type Hints)支持程度及 API 是否符合直觉。
- 隔离性与迁移成本:核心外部库必须能在业务层建立防腐适配层,避免业务逻辑与特定三方库 API 深度耦合。
二、网络请求库:Requests vs HTTPX vs AIOHTTP
网络请求是各类 Python 应用的核心基础模块。虽然 requests 长期统治这一领域,但在现代异步协程与 HTTP/2 场景下,替代方案展现出了明显优势。
核心差异与运行机制
- Requests:基于
urllib3构建,纯同步阻塞模型,API 极其人性化,社区生态极大,但完全不支持异步协程与 HTTP/2。 - HTTPX:拥有与 Requests 近乎完全兼容的 API,同时原生支持同步客户端(
httpx.Client)与异步客户端(httpx.AsyncClient),原生支持 HTTP/2。 - AIOHTTP:专为高并发异步 I/O 设计的底层网络套件,提供完整的异步 HTTP 客户端与服务端,并发极限性能优于 HTTPX,但 API 偏底层,需严格管理 ClientSession 生命周期。
# 同步/异步统一的现代请求示例(HTTPX)
import httpx
import asyncio

# 同步调用:开箱即用,API风格对齐 requests
def fetch_sync(url: str) -> dict:
    with httpx.Client(timeout=10.0) as client:
        response = client.get(url)
        response.raise_for_status()
        return response.json()

# 异步并发调用:无需切换不同类库
async def fetch_async(url: str) -> dict:
    async with httpx.AsyncClient(http2=True, timeout=10.0) as client:
        response = await client.get(url)
        response.raise_for_status()
return response.json()选型建议:对于脚本、运维自动化、Django 等以同步阻塞为主的应用,保持使用 requests 即可;若项目需要混合调用同步和异步,或正在使用 FastAPI,首选 httpx;若构建的是每秒成千上万请求的高并发爬虫或纯网络网关,建议选用 aiohttp。
三、数据处理与分析:Pandas vs Polars
在大数据和分析脚本场景中,pandas 依然是工业界事实上的标准,但新一代列式计算引擎 polars 正在改写单机数据处理的性能天花板。
核心差异与选型分水岭
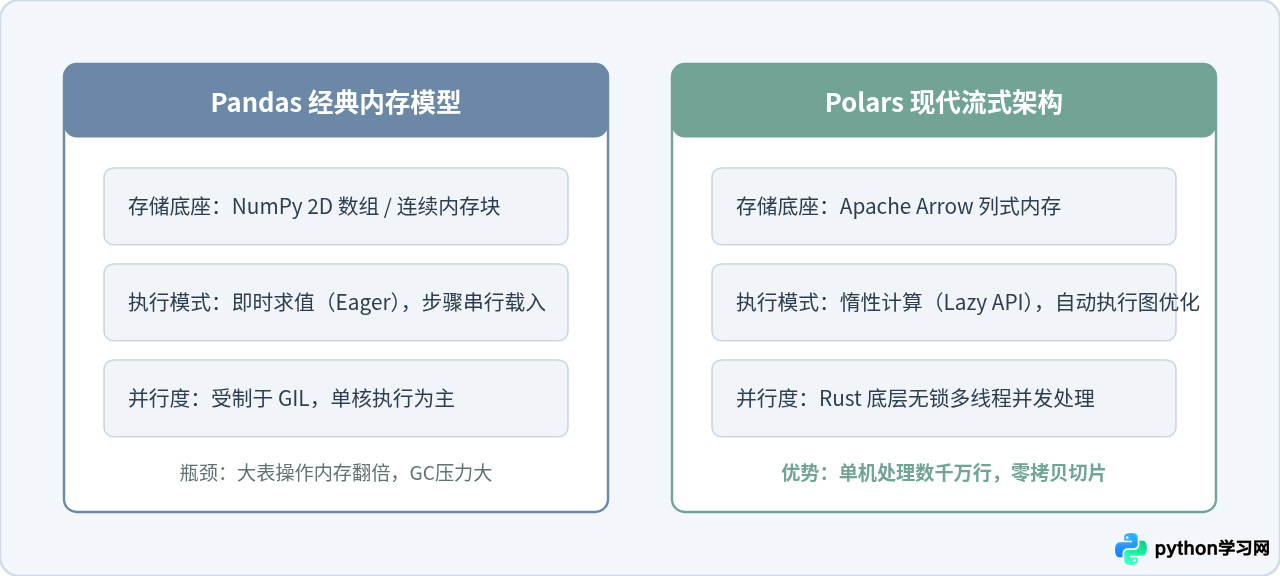
Pandas 在处理 100MB 以内的数据集时表现非常优异,且拥有完备的第三方库支持(如 scikit-learn、matplotlib)。然而,由于其即时执行机制(Eager Execution)和 NumPy 内存布局,在进行过滤、合并或分组聚合时,经常会产生两到三倍于原数据集的内存峰值。
Polars 基于 Rust 开发,原生采用 Apache Arrow 列式存储。通过其 LazyFrame,Polars 能够推迟计算,合并查询计划,下推谓词过滤,并充分利用现代 CPU 的全部核心。
# Polars 惰性查询与优化示例
import polars as pl

# 读取并延迟执行:仅在 collect() 时调度多核流水线
lazy_query = (
    pl.scan_csv("server_logs.csv")
    .filter(pl.col("status") >= 500)
    .group_by("endpoint")
    .agg(pl.len().alias("error_count"))
    .sort("error_count", descending=True)
)

# 执行并输出聚合结果
result = lazy_query.collect()
四、Web 开发框架:FastAPI vs Flask vs Django
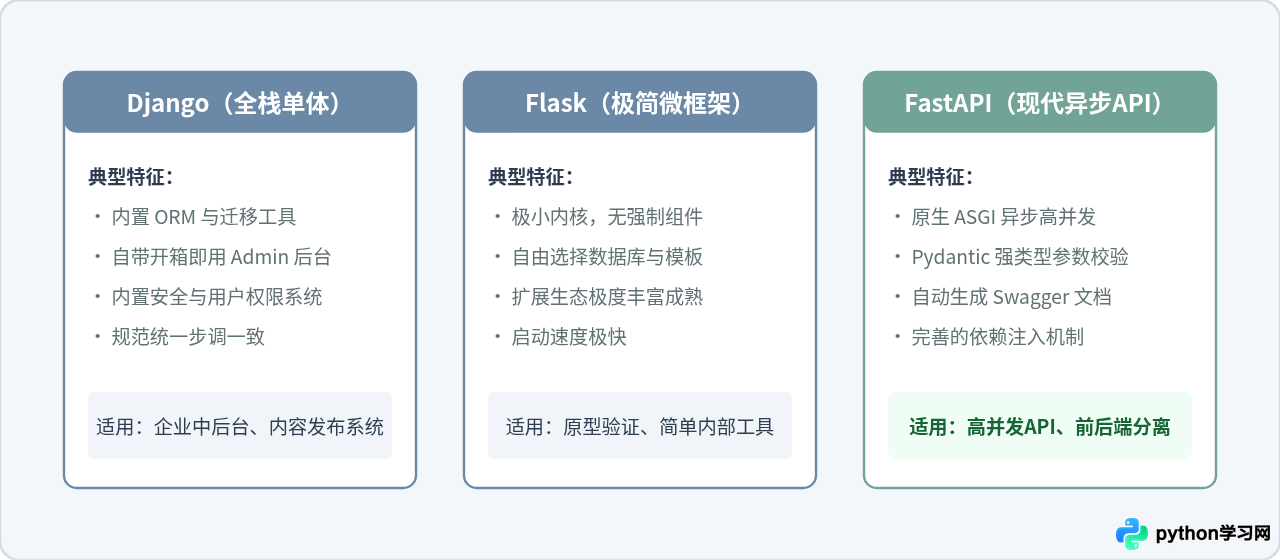
Web 框架的选型直接决定了服务端项目的代码组织形式与长期维护成本。三种主流框架分别代表了三种不同的工程哲学:
维度对比矩阵
| 比对维度 | Django | Flask | FastAPI |
|---|---|---|---|
| 底层架构 | WSGI为主(有ASGI实验支持) | WSGI为主(Werkzeug驱动) | 原生 ASGI(Starlette + Uvicorn) |
| 类型检查与校验 | Django Forms / Serializer | 需外挂 Marshmallow / WTForms | 基于 Pydantic 原生深度绑定 |
| 文档自动化 | 依赖外部插件手动编写 | 依赖 flasgger 等插件 | 开箱即用交互式 OpenAPI/Swagger |
| 学习曲线 | 陡峭(需掌握整套 Django 体系) | 平缓(几行代码起步) | 中等(需熟悉 Python 类型注解与异步) |
五、数据校验与模型:Pydantic vs Dataclasses vs Marshmallow
在数据进入业务逻辑前,对入参的解析、类型转换与错误拦截至关重要。Python 标准库自带了 dataclasses,社区则流行 pydantic 与老牌的 marshmallow。
- Standard Dataclasses:标准库开箱即用,零依赖,极度轻量。但它只做类型标注,不做运行时校验。如果传入错误类型的字段,默认不会引发报错。适合作为应用内部模块间传递数据的纯容器。
- Pydantic (v2):核心逻辑使用 Rust 重写(pydantic-core),性能较 v1 提升 5-15 倍。提供强大的运行时类型强制转换、深度递归校验以及 JSON 序列化,是现代 API 参数网关的绝对主力。
- Marshmallow:历史悠久,配置灵活,但在类型标注与代码补全体验上明显弱于 Pydantic,且执行速度较慢,主要存在于维护期的老项目中。
# Pydantic v2 校验与标准 dataclass 行为对比
from pydantic import BaseModel, Field, ValidationError
from dataclasses import dataclass

@dataclass
class InternalDTO:
    id: int
    name: str  # 传入整数或 None 时不会拦截

class UserRequestSchema(BaseModel):
    id: int = Field(gt=0, description="必须是正整数")
    name: str = Field(min_length=2, max_length=50)

# 校验生效验证
try:
    # 自动转换合法字符串到数字,非法字段直接拦截
    user = UserRequestSchema.model_validate({"id": "101", "name": "Alice"})
    print(f"解析成功: id={user.id}, 类型={type(user.id)}")
except ValidationError as e:
    print(f"数据校验失败: {e}")
六、命令行工具:Argparse vs Click vs Typer
编写 CLI 运维脚本或开发者工具时,选型主要权衡外部依赖与编写效率:
- Argparse:标准库内置。适合运维自动化、Docker 基础镜像构建脚本或对第三方依赖有严格零容忍限制的场景。缺点是编写复杂子命令时样板代码冗长。
- Click:由 Pallets 团队打造,采用函数装饰器设计,命令分发与嵌套非常成熟,支持复杂的补全与上下文参数传递,但需要显式声明参数类型与帮助文字。
- Typer:基于 Click 开发,结合了 Python 3.6+ 的类型注解。不需要重复编写
@click.option,直接根据函数参数签名与默认值推导命令行参数,代码量减少 50% 以上。
七、全景决策树与落地最佳实践
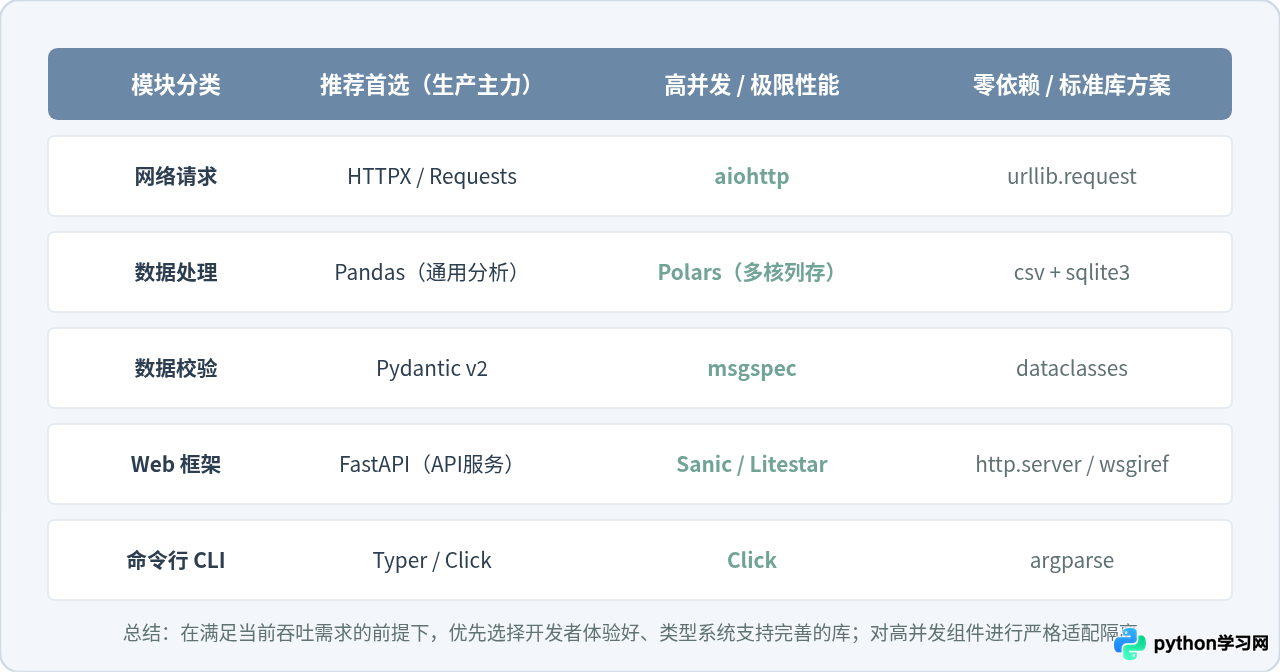
为了让架构决策更直观,下表归纳了常见功能模块在不同开发阶段与业务场景下的选型矩阵:
生产落地的工程规范
- 隔离外部接口,严禁直接贯穿:在业务代码与具体网络库或数据引擎之间,定义一个内部专属的 Client 协议或 Service 类。未来即便需要将
requests替换为httpx,修改范围仅限于适配层文件,业务代码无需联动改动。 - 锁定精准依赖与散列值:使用
poetry.lock或pip-compile锁定所有间接依赖的版本号及 Hash 校验值,避免因上游依赖小版本变更破坏生产构建。 - 定期排查依赖漏洞:将
pip-audit或安全扫描步骤加入持续集成(CI)流水线,建立依赖废弃与迁移的常规评估机制。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















