


Python切片语法详解:[start:stop:step]参数规则与默认值
深入解析Python切片核心语法[start:stop:step]。详解起始边界、终止边界与步长的运行机制,剖析左闭右开区间、正负步长默认值推导、越界容错机制以及底层slice对象原理。
一、切片的基础认知:为什么是“左闭右开”?
在 Python 中,单元素索引(如 s[0])定位的是单个元素,而切片(如 s[1:4])提取的是子序列。初学者最容易产生困惑的是:为什么 s[1:4] 包含索引 1,却不包含索引 4?
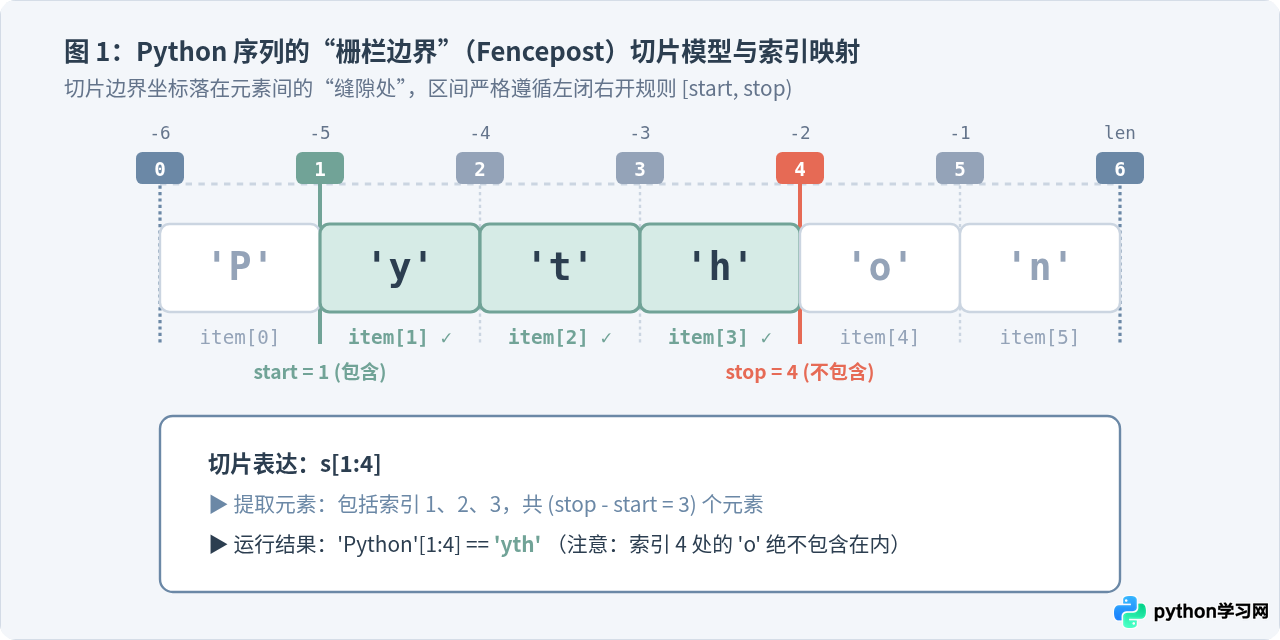
理解这一规则的关键在于 Python 采用的“栅栏边界”(Fencepost / Cut points)模型。不要把索引看作元素本身,而应将其视为元素与元素之间的“缝隙切割线”:
- 索引
0位于序列第一个元素的最左侧边界。 - 索引
1位于第 0 个元素与第 1 个元素之间的缝隙。 - 索引
len(s)位于序列最后一个元素的最右侧边界。
当写下 s[start:stop] 时,Python 实际上是在切割线 start 与切割线 stop 之间划出一刀,将夹在中间的所有元素打包返回。因此,区间必然呈现“包含 start、不包含 stop”的左闭右开特性。
采用左闭右开区间带来三个直观的数学与工程优势:
- 切片长度直接计算:在步长为 1 的情况下,截取结果的长度精确等于
stop - start。例如'Python'[1:4]的长度即为4 - 1 = 3。 - 相邻切片无缝拼接:任意两段相邻切片
s[:i]与s[i:]可以无缝拼接还原原序列(s[:i] + s[i:] == s),既不重叠也不漏项。 - 避免边界减一麻烦:直接提取前 n 个元素写成
s[:n]即可,无需书写易错的s[:n-1]。
二、三参数规则解析:start、stop 与 step
切片完整语法由冒号分隔的三个参数组成:[start:stop:step]。每个参数的具体规则如下:
1. start(起始位置)
指定切片抽取的起始位置(包含此位置元素)。支持正整数、负整数或省略。如果是负数(如 -3),Python 会自动加上序列长度将其转换为有效正向索引(等价于 len + (-3))。
2. stop(终止位置)
指定切片抽取的结束位置(不包含此位置元素)。同样支持正整数、负整数或省略。当遍历指针到达或越过 stop 时,切片动作立即停止。
3. step(步长与行进方向)
step 承担两项至关重要的职责:决定指针每次移动的跨距,以及决定遍历的物理方向。
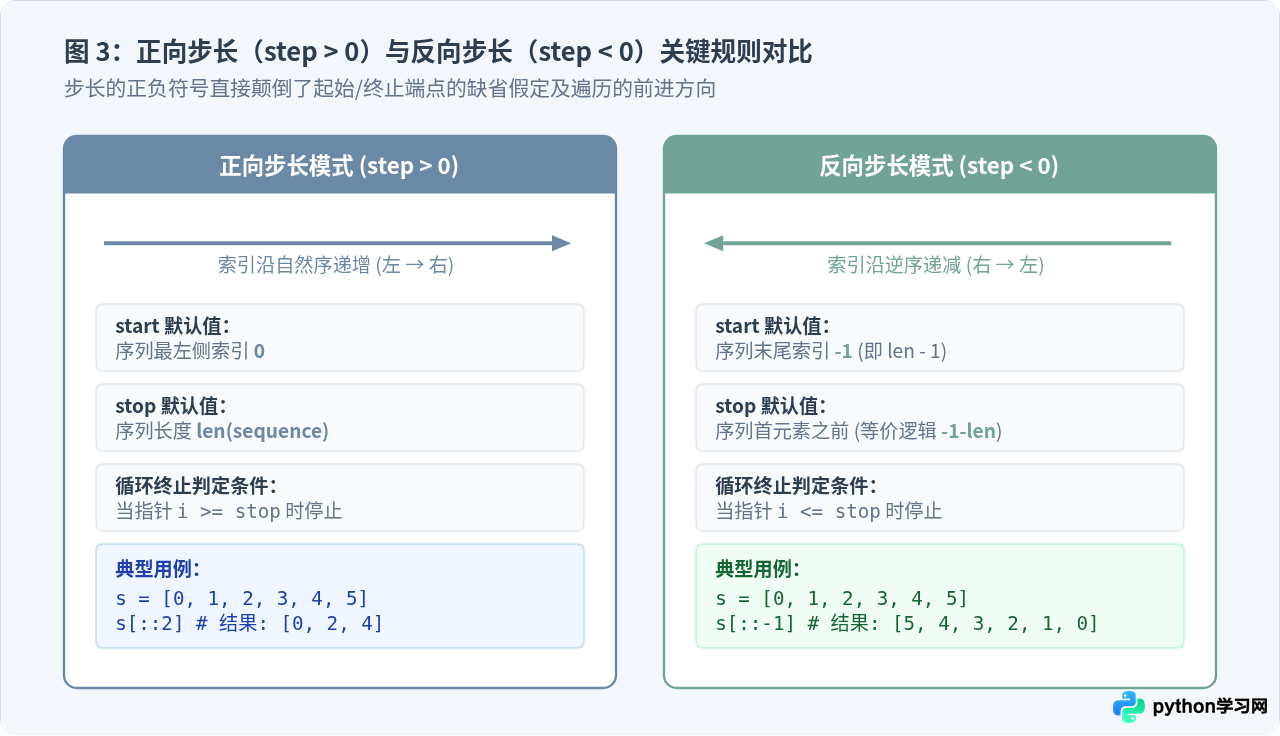
- step > 0(正向步长):指针从左向右移动(索引增加)。每次步进
i += step。 - step < 0(反向步长):指针从右向左移动(索引减小)。每次步进
i += step(因 step 为负,索引持续递减)。 - step == 0:非法参数。Python 会抛出
ValueError: slice step cannot be zero异常。
# 基础切片与步长运行示例
data = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

# 提取索引 2 到 8,步长为 2
result = data[2:8:2]
print("data[2:8:2] =", result)三、参数默认值规则:step 正负决定端点极向
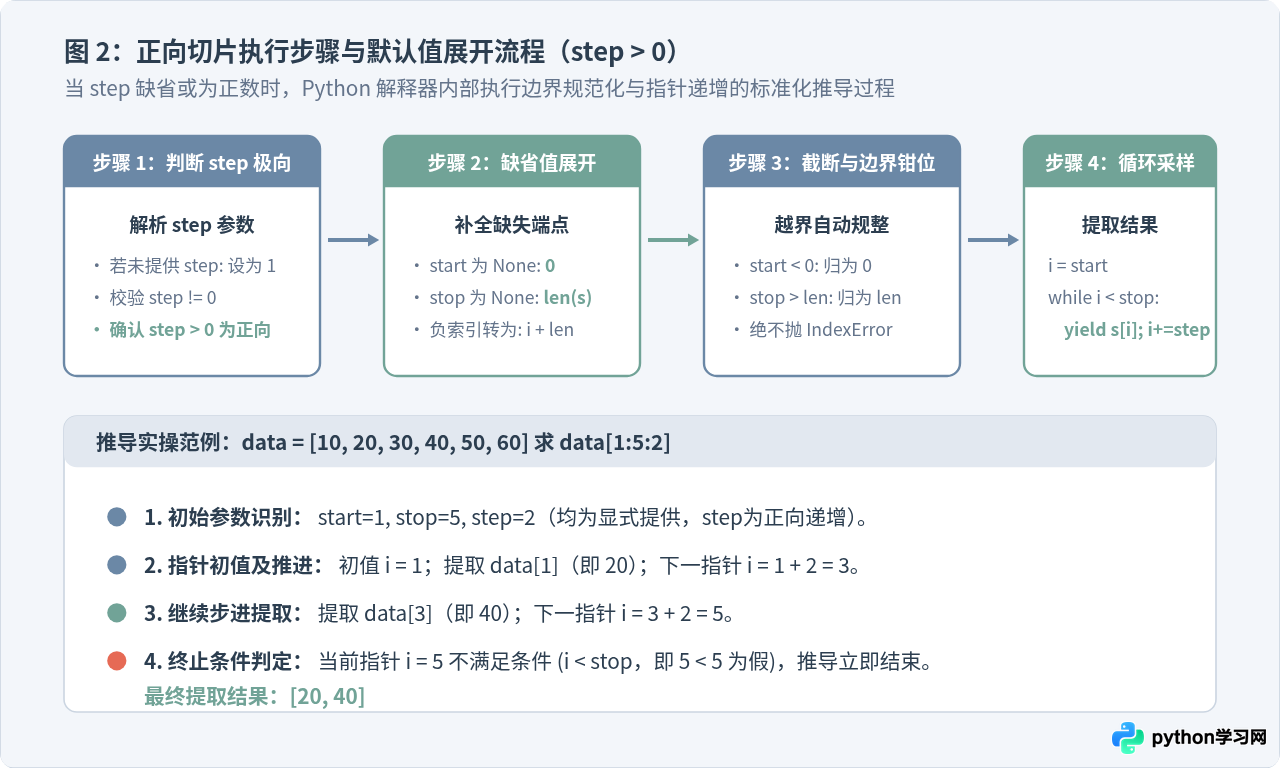
在实际开发中,开发者经常省略参数(如 s[:5]、s[2:]、s[::2] 甚至 s[::-1])。当参数省略(或显式传入 None)时,默认值并非固定不变,而是完全由 step 的符号极向动态决定的。
1. 正向切片(step 省略 或 step > 0)
当 step 为正时,遍历方向为从左向右:
step默认值为1。start默认值为0(序列的最左端开头)。stop默认值为len(sequence)(序列的最右端之外)。
text = "Python"
print(text[:3])    # 等价于 text[0:3:1] -> "Pyt"
print(text[2:])    # 等价于 text[2:6:1] -> "thon"
print(text[::2])   # 等价于 text[0:6:2] -> "Pto"
print(text[:])     # 等价于 text[0:6:1] -> "Python"(完整浅拷贝)
2. 反向切片(step < 0)
当 step 为负时,遍历方向彻底反转,从右向左推进。此时,默认值随之发生对极反转:
start默认值为-1(序列最后一个元素,即len - 1)。stop默认值并不是0,而是序列首元素之前的虚拟位置(逻辑上等价于-(len + 1))。只有这样,反向遍历才能一路包含到索引为 0 的第一个元素。
许多人在尝试反向提取到开头时,误写为 text[4:0:-1],结果发现索引 0 处的元素丢失了。原因在于左闭右开规则始终有效:当 stop=0 时,索引 0 作为开区间端点被排除在外。要想包含索引 0,必须省略 stop(即 text[4::-1])或者设为 None。
# 反向切片包含首元素的正确与错误写法
chars = ['a', 'b', 'c', 'd', 'e']

# 错误写法:stop 设为 0,导致 'a' 被排除
print("chars[4:0:-1]  =", chars[4:0:-1])

# 正确写法:省略 stop,默认延伸至首元素之前
print("chars[4::-1]   =", chars[4::-1])

# 全局逆序标准写法
print("chars[::-1] =", chars[::-1])chars[4::-1] = ['e', 'd', 'c', 'b', 'a']
chars[::-1] = ['e', 'd', 'c', 'b', 'a']
四、越界容错机制与底层 slice 对象
1. 越界宽容性(Silent Bound Clipping)
Python 中的直接单索引访问非常严格,例如访问 data[100] 会立即抛出 IndexError: list index out of range。但切片机制则完全不同:切片语法对越界具有极高的宽容度。
当切片的 start 或 stop 超过序列实际长度范围时,Python 解释器会自动进行“边界钳位”(Clamping):
- 如果正向切片的 start 大于
len,它会被自动截断为len。 - 如果 stop 大于
len,它会被安全截断为len。 - 如果起止范围之间没有任何元素或方向相互矛盾(如
data[5:2:1]),切片不会报错,而是静默返回同类型的空序列(如[]或"")。
# 越界容错示例
items = [1, 2, 3]

# 索引越界会抛异常
# print(items[10]) # 抛出 IndexError

# 切片越界安全截断,不抛出异常
print("items[1:100]  =", items[1:100])
print("items[10:20]   =", items[10:20])
print("items[5:1:-1] =", items[5:1:-1])items[10:20] = []
items[5:1:-1] = [3]
2. 底层 slice 对象与 slice.indices() 原理
在 Python 内部,中括号内的切片语法 seq[start:stop:step] 实际上是 Python 提供的语法糖。解释器在执行时会将其转换为内置的 slice 类对象:
# 二者完全等价
seq[1:5:2]
seq[slice(1, 5, 2)]
slice 对象拥有一个非常实用的内置方法 slice.indices(length)。它接收一个序列长度作为输入,自动计算并返回规范化后的 (start, stop, step) 三元整型元组。所有的越界修正、负数转换与缺省填充逻辑,都在这个底层方法中完成:
# 使用 slice.indices() 观察 Python 底层计算结果
s1 = slice(None, None, -1)
# 针对长度为 6 的序列,展开反向步长默认值
print("针对长度 6 展开 s1:", s1.indices(6))

s2 = slice(2, 100, 2)
# 针对长度为 5 的序列,自动截断越界的 stop
print("针对长度 5 展开 s2:", s2.indices(5))针对长度 5 展开 s2: (2, 5, 2)
五、切片全景决策与排错速查
在日常编程中,切片常用于序列反转、截取前后缀以及数据降采样。为了在复杂边界和负索引情况下迅速排查问题,可参考以下全景逻辑总结:
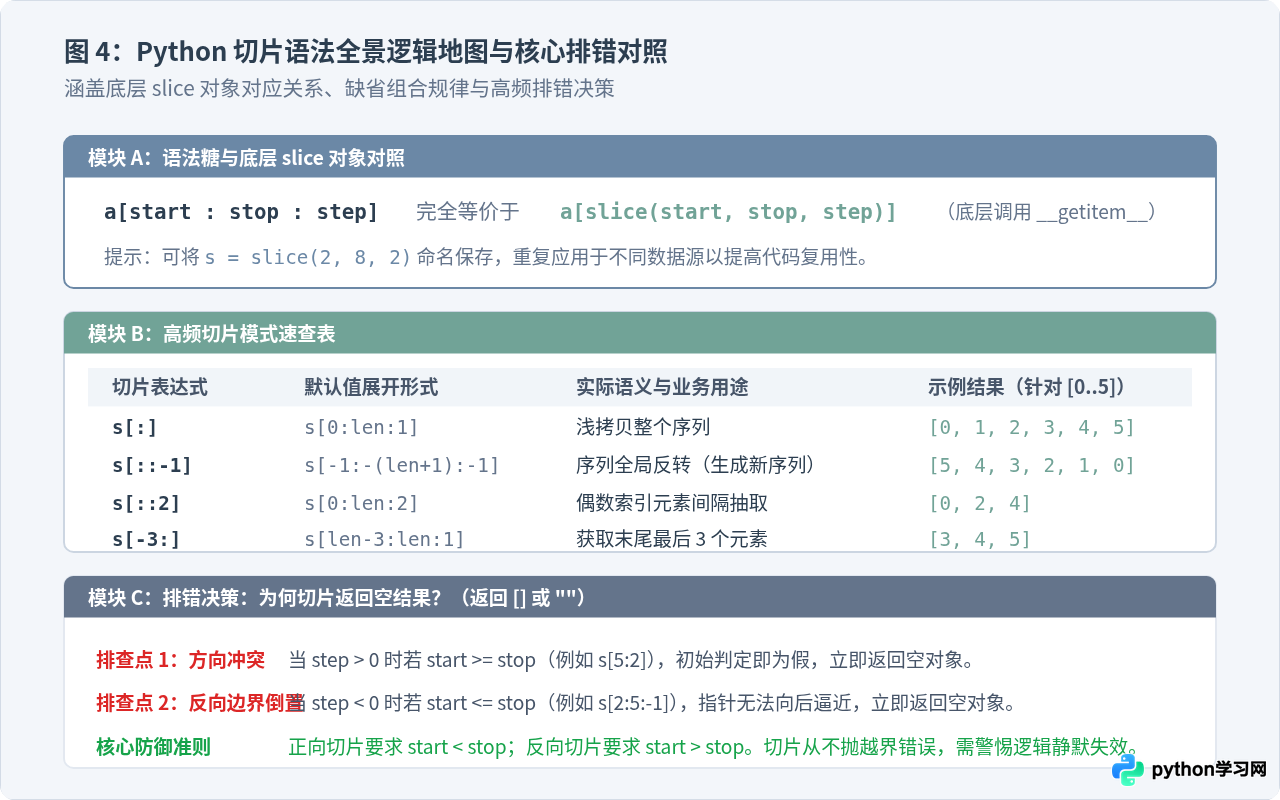
常见切片表达式速查
| 表达式 | 步长符号 | 内部等价形式 | 应用场景说明 |
|---|---|---|---|
s[:] |
正向 (+1) | s[0:len:1] |
创建整个列表或序列的顶层浅拷贝(Shallow Copy) |
s[:k] |
正向 (+1) | s[0:k:1] |
提取前 k 个元素(若 k > len 则提取全部) |
s[k:] |
正向 (+1) | s[k:len:1] |
跳过前 k 个元素,截取剩余所有后缀元素 |
s[-k:] |
正向 (+1) | s[len-k:len:1] |
保留序列最后 k 个尾部元素 |
s[:-k] |
正向 (+1) | s[0:len-k:1] |
移除序列最后 k 个尾部元素 |
s[::-1] |
反向 (-1) | s[-1:-(len+1):-1] |
返回完全倒序的新序列 |
s[::2] |
正向 (+2) | s[0:len:2] |
隔项抽取所有偶数序号元素(索引 0, 2, 4...) |
s[1::2] |
正向 (+2) | s[1:len:2] |
隔项抽取所有奇数序号元素(索引 1, 3, 5...) |
切片排错清单:为什么返回了空列表 []?
- 检查步长与两端大小关系是否逆向:
- 如果
step > 0,必须满足start < stop,否则初始判断i < stop即不成立,立即返回空。 - 如果
step < 0,必须满足start > stop,否则初始判断i > stop即不成立,立即返回空。
- 如果
- 检查负索引换算后的真实顺序:
例如
s[-2:-5]中,step默认为+1,但-2(较靠后)大于-5(较靠前),正向步长无法从靠后位置向靠前移动,结果为空。此时必须显式指定负步长s[-2:-5:-1]才能取到数据。 - 切片修改原地赋值的形状匹配:
当使用
s[start:stop] = iterable进行切片赋值时,如果是带非 1 步长的扩展切片(如s[::2] = [...]),右侧提供的元素数量必须与被替换切片的长度严格相等,否则将抛出ValueError: attempt to assign sequence of size X to extended slice of size Y。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















