


Python列表与字典操作:常用数据结构语法解析
深入解析Python核心数据结构列表与字典的语法规则、底层机理、高频增删改查操作与避坑实践,助你写出高效稳健的Python代码。
一、列表(List):有序序列的常用操作与语法
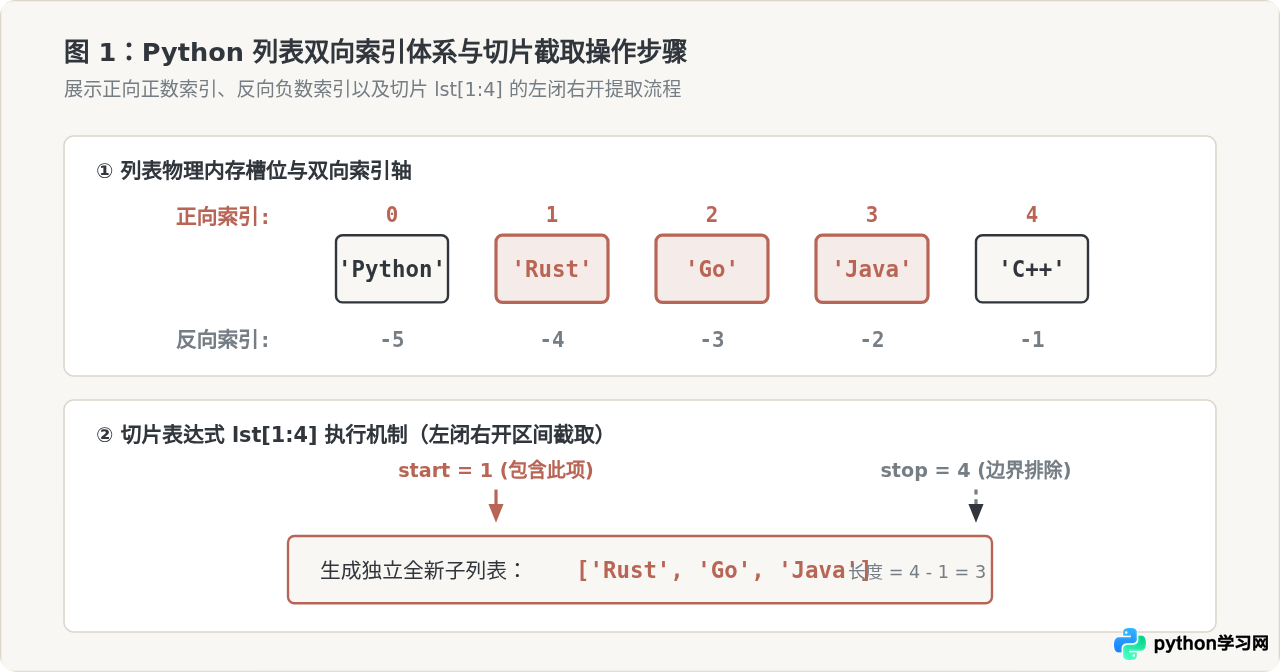
Python 列表本质上是动态指针数组,内部维护着一段连续的内存地址,用于存放指向各数据对象的引用指针。基于这种底层结构,列表在支持正负双向索引和高效尾部追加的同时,也决定了其中间插入与范围切片的运行开销。
1. 元素创建与切片提取
创建列表可以直接使用中括号字面量 [] 或内置构造函数 list()。访问元素除常规的自零起始非负索引外,支持使用负整数从尾部倒序定位(例如 -1 表示最后一个元素)。
切片语法形式为 lst[start:stop:step],截取区间严格遵循“左闭右开”(包含 start,但不包含 stop)规则,且切片始终返回一个独立开辟的浅拷贝新列表,不会修改原列表。
# 列表切片与索引操作示例
languages = ['Python', 'Rust', 'Go', 'Java', 'C++']

# 提取索引 1 到 3 的元素 (排除索引 4)
sub_list = languages[1:4]

# 步长切片:隔项提取与倒序翻转
even_indexed = languages[::2]
reversed_list = languages[::-1]even_indexed: ['Python', 'Go', 'C++']
reversed_list: ['C++', 'Java', 'Go', 'Rust', 'Python']
2. 元素的追加、插入与拼接
在列表生命周期内,向其中补充数据主要有三种方式,它们在性能和语义上存在显著区别:
append(x):将单个元素x追加到列表末尾。平均时间复杂度为 O(1),是构造序列最推荐的高效方法。insert(i, x):在指定索引i处插入元素x。由于该位置之后的所有现有元素都必须在内存中向后平移一位,其平均时间复杂度为 O(N)。若业务频繁在头部插入数据,建议评估collections.deque。extend(iterable):逐一提取可迭代对象中的元素并追加至末端;而使用加号运算符lst1 + lst2则会新建并返回一个合并后的全新列表,产生额外的内存分配。
frameworks = ['Django', 'Flask']

# 尾部快速追加
frameworks.append('FastAPI')

# 指定下标插入(触发后续元素平移)
frameworks.insert(1, 'Tornado')

# 就地合并集合
frameworks.extend(['Pyramid', 'Sanic'])3. 元素的删除与弹出
清理列表元素时应根据“按值删除”还是“按位置删除”选择接口:
pop([i]):弹出并返回指定索引i处的元素,若不传参则默认弹出尾部项(O(1))。弹出首部或中间项为 O(N)。remove(x):从左至右扫描列表,删除首个匹配值为x的元素。如果目标值不存在,将抛出ValueError。del lst[i]/del lst[start:stop]:Python 语法级关键字,直接按索引或切片释放内存引用。
4. 列表推导式(List Comprehension)
推导式是 Python 提供的高可读性语法糖,用于基于已有可迭代对象快速过滤并映射生成新列表。其标准结构为:[expression for item in iterable if condition]。
# 将原始评分数据过滤出及格项并折算为百分制
raw_scores = [68, 45, 92, 58, 84, 76]
standardized = [s * 1.0 for s in raw_scores if s >= 60]二、字典(Dictionary):键值对映射的操作与语法
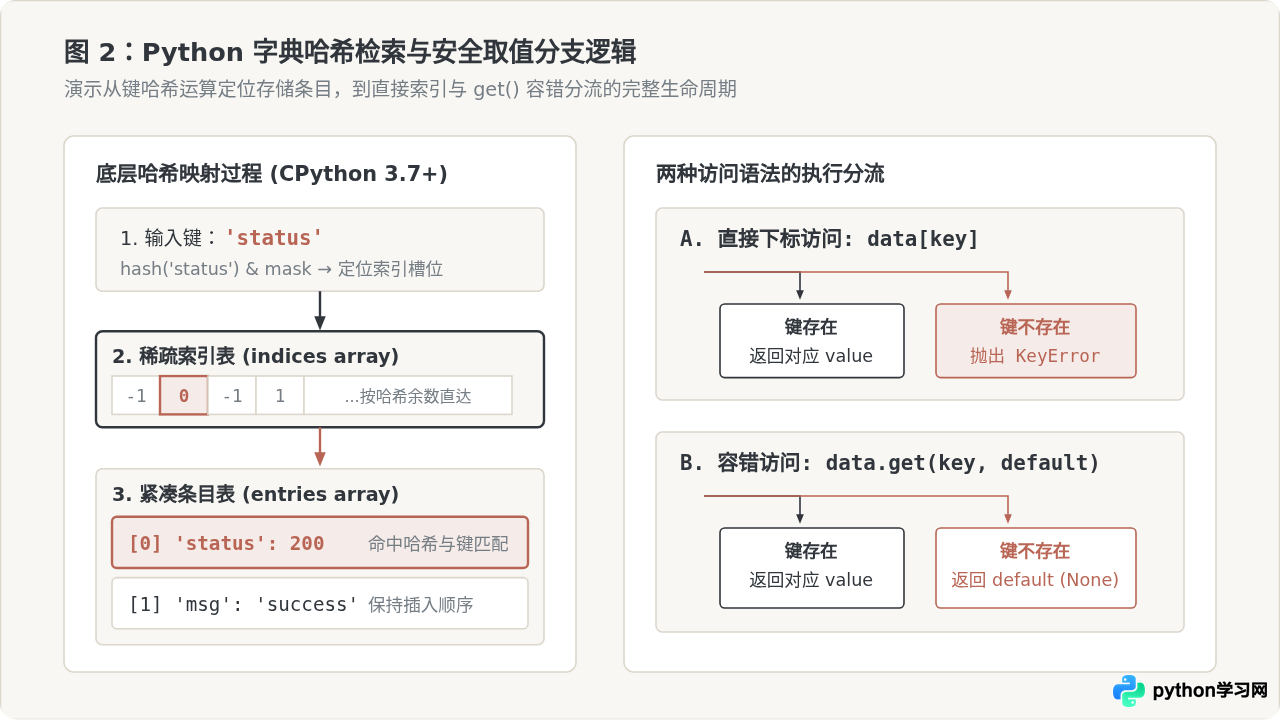
字典是 Python 最核心的映射数据结构。自 Python 3.7 起,标准字典官方保证保留元素的键值插入顺序。在底层实现上,字典通过组合“稀疏哈希索引表”与“紧凑键值条目表”实现了内存紧凑化与极高速的常量级 O(1) 键查找。
1. 字典键的约束:可哈希性(Hashable)
字典的键必须是不可变且实现了 __hash__() 与 __eq__() 方法的对象,例如字符串、数字、元组;而列表、字典或集合等可变容器不能作为键,否则会直接引发 TypeError: unhashable type。字典的值则没有任何类型限制。
2. 键值读取与安全容错访问
直接使用方括号索引 d[key] 是读取字典最直观的方式,但前提是该键必须存在于字典中。若键不存在,程序会直接中断并抛出 KeyError。
在生产环境中,外部传入的数据(例如 JSON 请求载荷)往往存在字段缺失风险,此时应优先使用 d.get(key, default) 方法。当键不存在时,该方法平稳返回指定的默认值(未指定则返回 None),避免逻辑异常。
server_config = {
    'host': '127.0.0.1',
    'port': 8080,
    'debug': True
}

# 存在键正常获取
host_ip = server_config['host']

# 缺失键通过 get 提供安全兜底
timeout_val = server_config.get('timeout', 30)

# get 与直接索引的行为对比
missing_value = server_config.get('ssl_cert') # 返回 Nonetimeout_val: 30
missing_value: None
3. 增改与现代合并语法
为字典更新或添加新键值对只需直接赋值 d[key] = value。针对多个字典的聚合场景,Python 经历了语法演进:
- 传统方法:调用
d1.update(d2)原地修改d1。 - 解包表达式:通过
{**d1, **d2}创建新字典。 - 现代运算符(Python 3.9+):引入了管道合并符
d1 | d2(生成新字典)以及就地合并符d1 |= d2。当存在相同键名时,右侧字典的值将覆盖左侧的值。
base_params = {'env': 'prod', 'threads': 4, 'cache': False}
custom_params = {'threads': 8, 'cache': True, 'region': 'us-west'}

# Python 3.9+ 推荐的合并语法
merged_params = base_params | custom_params4. 字典视图对象遍历
遍历字典时,keys()、values() 与 items() 返回的是动态视图(View Objects),而非独立静态列表。这些视图会实时反映原字典的变化:
user_roles = {'alice': 'admin', 'bob': 'editor', 'charlie': 'viewer'}

# 推荐规范:使用 items() 同时解包键与值
for username, role in user_roles.items():
    # 格式化输出键值对
    pass
三、列表与字典的核心特性对比与选型依据
选用列表还是字典,核心取决于业务数据的逻辑语义与主要的查询维度。不能仅仅因为字典查找快就滥用字典,也不能把本该作为索引映射的数据平铺在列表中。
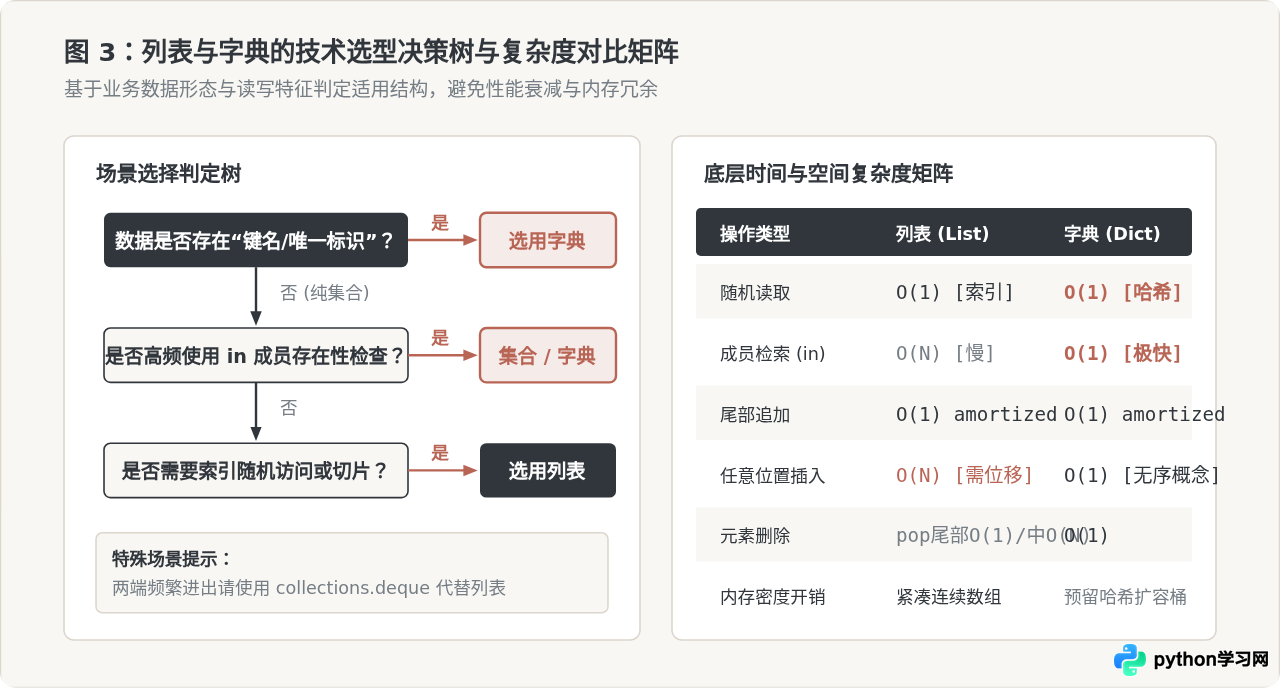
| 对比维度 | 列表 (list) | 字典 (dict) |
|---|---|---|
| 组织范式 | 基于连续下标的有序线性序列 | 基于 Hash 索引的键值对关联映射 |
| 成员检索复杂度 | O(N)(需线性比对全部元素) | O(1)(哈希直达,几乎与集合大小无关) |
| 访问方式 | 整数位置索引(0, 1, -1)及切片 | 可哈希键名检索(字符串、数字、元组) |
| 元素唯一性 | 允许任意重复值 | 键(Key)严格全局唯一,值可重复 |
| 内存开销 | 紧凑数组结构,相对低廉 | 需要维系哈希稀疏表与桶位,内存略高 |
四、高频逻辑陷阱与工业级避坑指南
在实际项目开发中,涉及列表与字典的代码若未遵循语言机理,极易引发难以排查的隐性 Bug。以下归纳了三类最高频的语法陷阱与重构对策。
1. 陷阱一:在迭代过程中直接增删元素
现象分析:对列表进行遍历时若就地调用 remove() 或 pop(),会导致后续元素前移填补空缺,遍历游标因此跳过紧挨的下一个元素;而在遍历字典的 for k in d: 循环中增删键,Python 会直接抛出 RuntimeError: dictionary changed size during iteration。
标准解法:对列表可使用列表推导式重构生成新序列;对字典则应遍历其键的浅拷贝切片副本(如 list(d.keys())),或者同样采用字典推导式筛选。
# 错误写法:遍历中修改字典触发 RuntimeError
# for k in status_dict:
#     if not status_dict[k]:
#         del status_dict[k]

# 正确写法:遍历键的独立列表快照
status_dict = {'server1': True, 'server2': False, 'server3': True}
for k in list(status_dict.keys()):
    if not status_dict[k]:
del status_dict[k]2. 陷阱二:使用可变容器作为函数默认参数
现象分析:Python 函数的默认参数在模块加载定义时仅被计算并初始化一次。如果将空列表 [] 或空字典 {} 写入形参默认值,多次调用该函数时将全部共享同一个内存对象,导致多次调用的残留数据相互污染。
# 危险模式:多次调用累积残留
def append_event_bad(event, event_log=[]):
    event_log.append(event)
    return event_log

# 规范模式:以 None 作为哨兵值并在函数体内动态初始化
def append_event_safe(event, event_log=None):
    if event_log is None:
        event_log = []
    event_log.append(event)
    return event_log
3. 陷阱三:嵌套容器的浅拷贝穿透
现象分析:调用列表切片 lst[:]、lst.copy() 或 dict.copy() 仅完成一层 shallow copy。当容器内部包含子列表或子字典时,拷贝出来的只是指向子对象的内存地址。修改副本中的深层数据,原容器对应的内部对象也会被同步篡改。
标准解法:对于多层级嵌套的数据实体,涉及独立隔离修改时必须引入 copy 模块的 copy.deepcopy() 进行完整深拷贝。
五、总结
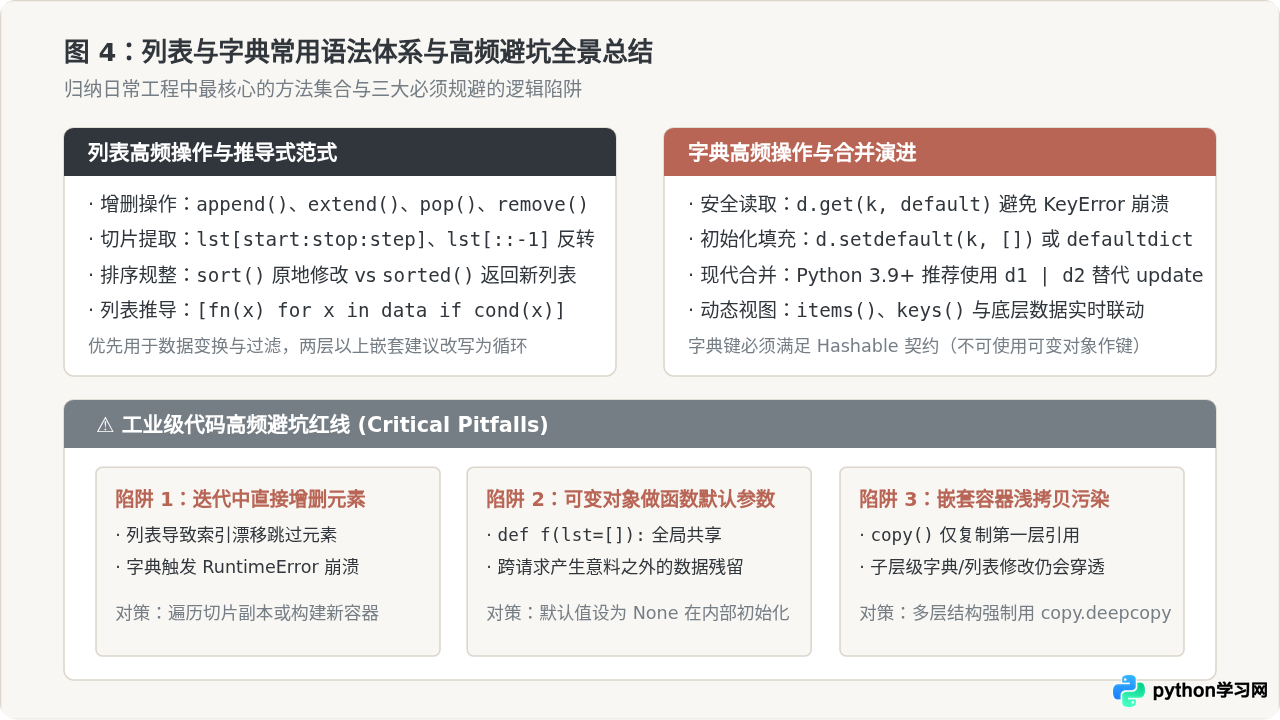
列表与字典分别代表了 Python 处理序列型数据与关联型数据的基石。列表利用物理数组的连续性,以极低的结构开销换取高效的尾部扩展与快速下标检索;字典则依托精心优化的哈希表机制,以略高的内存占用实现了近乎常数级的键名映射与检索速度。
在日常工程中,深刻理解列表的双向索引、切片语义、以及字典的可哈希约束与视图联动机制,并时刻防范迭代中变动、默认参数共享与浅拷贝穿透等经典陷阱,是编写健壮、高效 Python 代码的必备基本功。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















