


Python基础知识思维导图:变量、数据类型到面向对象全景梳理
系统梳理Python从变量底层引用模型、基础标量与复合容器、控制流与函数作用域,到面向对象类与实例封装的全景思维导图与核心知识体系,帮助读者建立连贯的编程认知网络。
一、Python 知识演进全景:四阶认知递进路线
许多初学者在学习 Python 时容易陷入“孤立记忆语法”的误区:学完变量学列表,学完列表学函数,接触到类与对象时又感觉脱节。实际上,Python 的核心设计理念是高度自洽的——“一切皆对象”贯穿始终。从最微观的变量赋值,到宏观的系统建模,存在着一条清晰的演进递进脉络。
整套知识体系可以划分为四个紧密相连的台阶:第一阶段是底层基石,核心是搞清楚变量与堆内存对象的引用标签关系;第二阶段是数据组织,区分可变容器与不可变标量,理解哈希表与动态数组的性能特性;第三阶段是逻辑驱动,通过流程控制、迭代协议和 LEGB 作用域完成函数级逻辑解耦;第四阶段是高阶范式,将离散的数据与操作封装为类与对象,依靠方法分发与鸭子类型驾驭复杂系统。
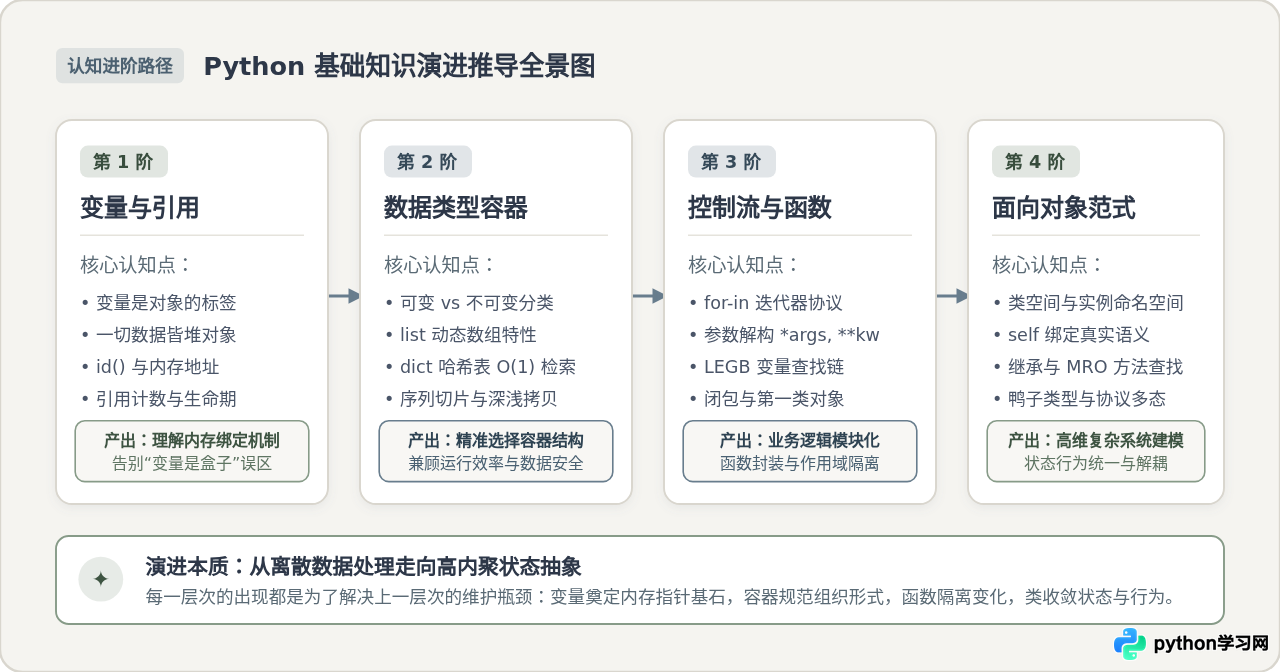
沿着这条推导路线,后续每个章节的知识点都不再是孤立的概念,而是前一个阶段解决不了现实工程痛点时的自然延伸。接下来,我们从最容易产生误解的底层机制——变量与内存模型切入。
二、变量与内存模型:贴标签机制与可变/不可变本质
在很多静态类型语言(如 C 或 Java)中,变量常被比作一个“固定大小的盒子”,声明变量即分配内存格子,赋值则是把具体数值倒进格子里。但在 Python 中,这种心智模型会导致严重理解偏差。在 Python 里,变量从来不是容器,而是一张贴在对象上的“名字标签”(Name Binding)。
当执行 x = 100 时,Python 解释器在堆内存中分配一个整型对象 100,并把标识符 x 作为一个指针绑定到该对象地址。通过内置函数 id(x) 可以直接查看其内存地址,而 is 运算符比较的是两个变量是否绑定同一内存地址(身份同一性),== 运算符比较的则是两个对象的内容值是否相等。
关键机制对比:不可变类型 vs 可变类型的内存行为与影响
理解 Python 变量的核心在于划分不可变对象(Immutable)与可变对象(Mutable)。在一致的变量传递与修改条件下,两者的内存行为有着截然相反的表现,直接决定了代码是否存在潜在的副作用:
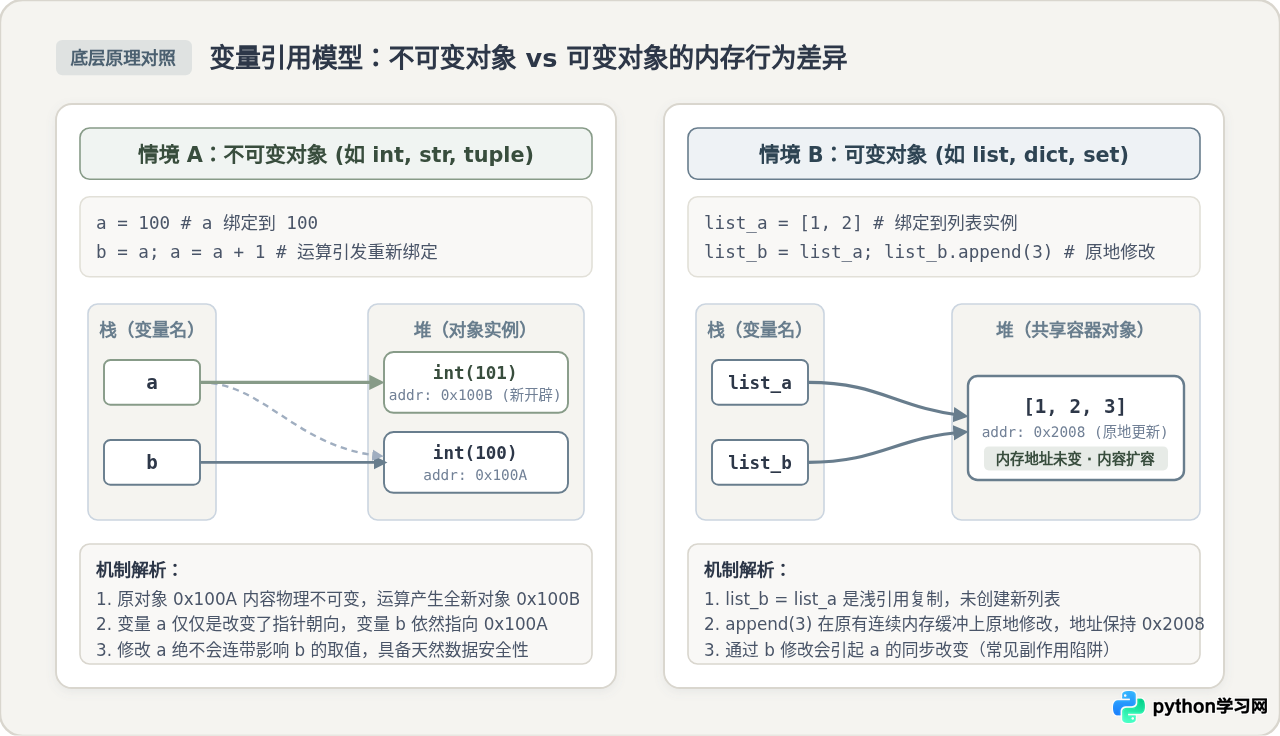
为了具体看清这两者的关键差异,我们通过相同的赋值与修改操作进行对照实验:
# 对照组 1:不可变对象(int, str, tuple)
a = 100
b = a          # a 与 b 暂时绑定同一地址 0x100A
a = a + 1      # 运算不会修改原对象,而是新建 int(101) 并将 a 重定向到 0x100B
print(a)       # 示例输出:101
print(b)       # 示例输出:100 (b 依然引用旧对象,安全隔离不受影响)

# 对照组 2:可变对象(list, dict, set)
list_a = [1, 2]
list_b = list_a      # list_a 与 list_b 共享同一列表对象地址 0x2008
list_b.append(3)     # 原地修改列表缓冲区,内存地址保持 0x2008 不变
print(list_a)        # 示例输出:[1, 2, 3] (list_a 同步发生变化!)
print(list_b)        # 示例输出:[1, 2, 3]
不可变与可变类型的差异在函数默认参数中体现得尤为致命。如果将空列表作为默认参数 def append_item(val, target=[]),由于函数定义本身也是一个对象,默认参数 target 在函数编译加载阶段就已完成绑定。后续每次调用若省略传参,所有调用都在修改同一块内存列表,导致历史数据相互污染。正确的做法是使用不可变的 None 作为哨兵值,在函数体内部执行 if target is None: target = []。
三、核心数据类型体系与选用策略
建立在可变与不可变的分类基础上,Python 提供了丰富的高级容器结构。针对具体业务场景选用最恰当的数据类型,是写出高效、清晰代码的前提。
| 数据类型 | 可变性 | 有序性 | 底层实现特征 | 主要应用场景 |
|---|---|---|---|---|
int / float / bool |
不可变 | - | C 结构体,高精度整型自动扩容 | 标量计数、浮点度量、布尔逻辑开关 |
str |
不可变 | 有序 | 紧凑 ASCII/UCS 字符数组 | 文本处理、不可变常量标签 |
list |
可变 | 有序 | 动态指针数组,尾部增删摊还 O(1) | 变长元素集合、顺序队列与栈操作 |
tuple |
不可变 | 有序 | 固定大小指针数组,轻量开销 | 结构化记录(如经纬度)、字典的复合键 |
dict |
可变 | 按插入保序 | 紧凑哈希表,平均查询时间复杂度 O(1) | 实体属性映射、高频关联索引查找 |
set |
可变 | 无序 | 仅包含 Key 的哈希表,自动去重 | 成员资格测试 (in)、并交差集合代数运算 |
容器的深浅拷贝边界
在处理嵌套容器(例如二维列表或字典列表中包含列表)时,简单的切片拷贝 data[:] 或 dict.copy() 仅为浅拷贝(Shallow Copy):外层容器创建了新对象,但内部元素仍然是对子对象的引用指针。一旦修改子对象,原数据仍会被污染。如果需要完全割裂关联,必须借助 copy.deepcopy() 进行深度递归复制。
四、控制流与函数抽象:逻辑调度与作用域隔绝
有了数据与容器之后,程序的本质就是对数据的转换与运算。Python 的控制流除了常规的 if-elif-else 分支外,其核心特色在于迭代器协议(Iterator Protocol)。
在 Python 中,for item in iterable: 并非依赖下标索引自增,而是通过底层的 iter() 获取迭代器,并不断调用 next() 直至捕获 StopIteration 异常。这使得无论是内存中的列表、大型日志文件流,还是无限序列生成器,都能以完全统一、节省内存的语法进行遍历。
变量作用域查找链:LEGB 原则
当函数内部使用一个变量名时,解释器遵循严格的四级作用域自内向外层层检索,一旦在某一级别命中即刻停止:
- L (Local):当前执行函数内部声明的局部命名空间。
- E (Enclosing):外层嵌套函数的闭包命名空间(如闭包函数中的外部环境)。
- G (Global):当前模块文件最外层定义的全局命名空间。
- B (Built-in):解释器内置命名空间(如
len,range,ValueError等)。
需要特别注意:在局部作用域内如果对未加声明的全局变量执行赋值操作(如 counter = counter + 1),Python 会在编译期直接将其标记为 Local 变量,导致在计算右侧表达式时报出 UnboundLocalError: local variable referenced before assignment。若要修改外层变量,必须显式使用 global 或 nonlocal 关键字声明意图。
五、面向对象编程(OOP):从数据集合到状态与行为抽象
当业务逻辑从单段脚本增长到包含多种业务实体和复杂状态流转时,单纯依靠散装字典和独立函数会导致函数入参臃肿、数据与操作割裂。面向对象编程(OOP)的核心目标就是将状态(数据属性)与操纵状态的行为(方法)捆绑在统一的命名实体内部。
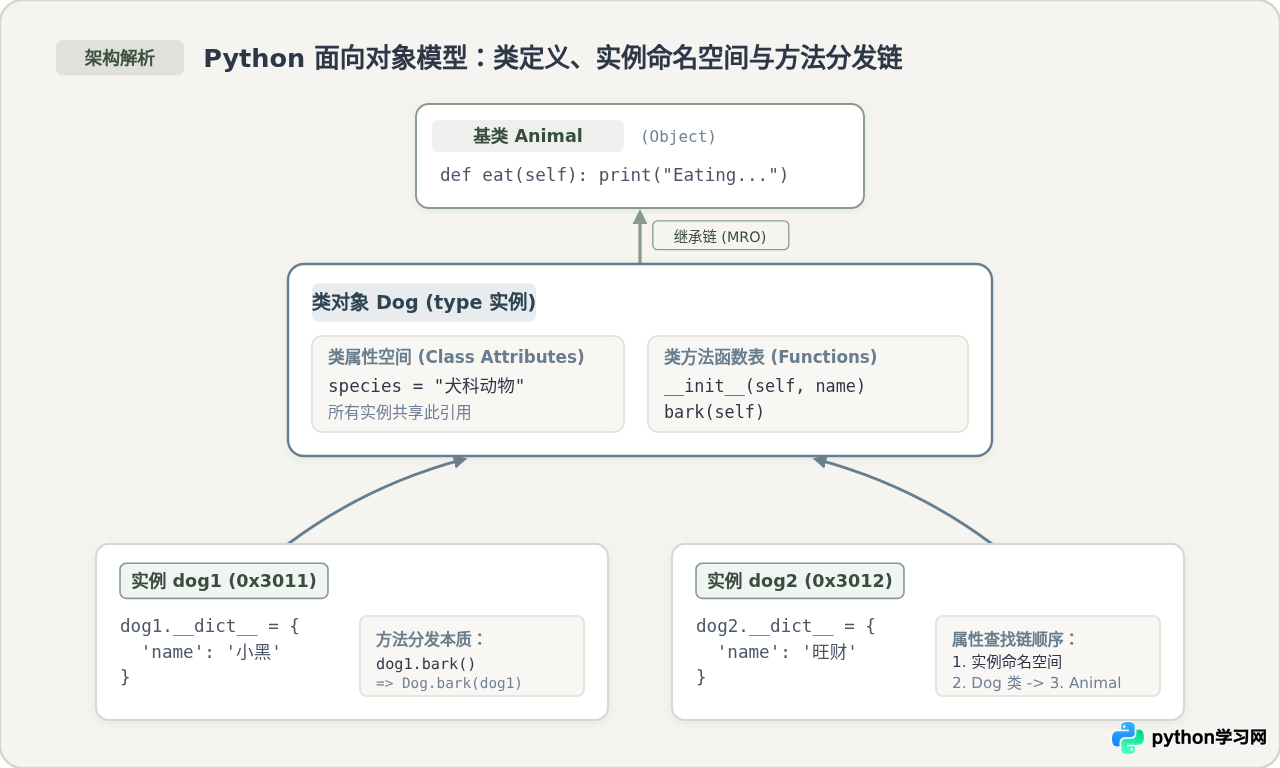
1. 类与实例的本质与 self 的运行秘密
在 Python 中,类本身也是内存里的一个对象(它是 type 的实例)。类对象维护着属于整个类的属性空间以及函数方法表。通过调用 Dog("旺财") 创建实例时,解释器执行以下标准流程:
- 调用
__new__分配一片干净的堆内存,创建新的实例对象。 - 将新建的实例作为第一个参数
self,连同外界实参传入__init__构造器。 - 在
__init__中通过self.name = name,将属性写入实例私有的字典instance.__dict__。
理解 self 的关键在于记住语法糖转换:当我们编写 dog1.bark() 时,解释器在底层实际执行的是 Dog.bark(dog1)。实例只是通过类指针把自身的引用显式传递给了类中的通用函数代码段。
2. 封装、继承与多态的 Pythonic 实践
与 C++ 或 Java 严格的私有权限关键字不同,Python 秉持“成年人哲学”(We are all consenting adults here):
- 封装控制:以单下划线开头的属性(如
_protected_val)是约定俗成的内部实现保护标记;双下划线开头的属性(如__private_val)会触发名称改写机制(Name Mangling),自动变形为_ClassName__private_val,以防止子类意外覆盖。 - 继承与 super() 协同:当存在复杂多继承时,Python 采用 C3 线性化算法生成确定性的 MRO(Method Resolution Order) 列表。通过
super().method()能严格按 MRO 顺位逐层调用基类方法,避免“菱形继承”带来的重复初始化问题。 - 多态与鸭子类型(Duck Typing):“如果一只鸟走起来像鸭子、叫起来也像鸭子,那么它就是鸭子”。Python 的多态不强求继承自同一个父类,只要一个自定义类实现了
__iter__就可以被for遍历,实现了__enter__和__exit__就可以接入with上下文管理器。
# 面向对象落地示例:封装、继承与多态协议
class Animal:
    def __init__(self, name: str):
        self._name = name  # 受保护属性

    def speak(self) -> str:
        raise NotImplementedError("子类必须实现 speak 方法")

class Dog(Animal):
    def speak(self) -> str:
        return f"{self._name}:汪汪!"

class Cat(Animal):
    def speak(self) -> str:
        return f"{self._name}:喵呜~"

# 多态调用:无需关心具体子类类型,只依赖统一的行为协议
def make_sound(animal: Animal):
    print(animal.speak())

# 示例调用
pets = [Dog("旺财"), Cat("花咪")]
for pet in pets:
    make_sound(pet)
# 示例输出:
# 旺财:汪汪!
# 花咪:喵呜~
六、全景思维导图总结与避坑速查
掌握 Python 的知识架构,最有效的方式是将离散的概念收敛到统一的思维全景图中。从最底层的内存标签引用,经过标量与复合容器的数据塑形,再到流程控制与函数抽象,最终在面向对象体系中实现高内聚的状态行为管理。
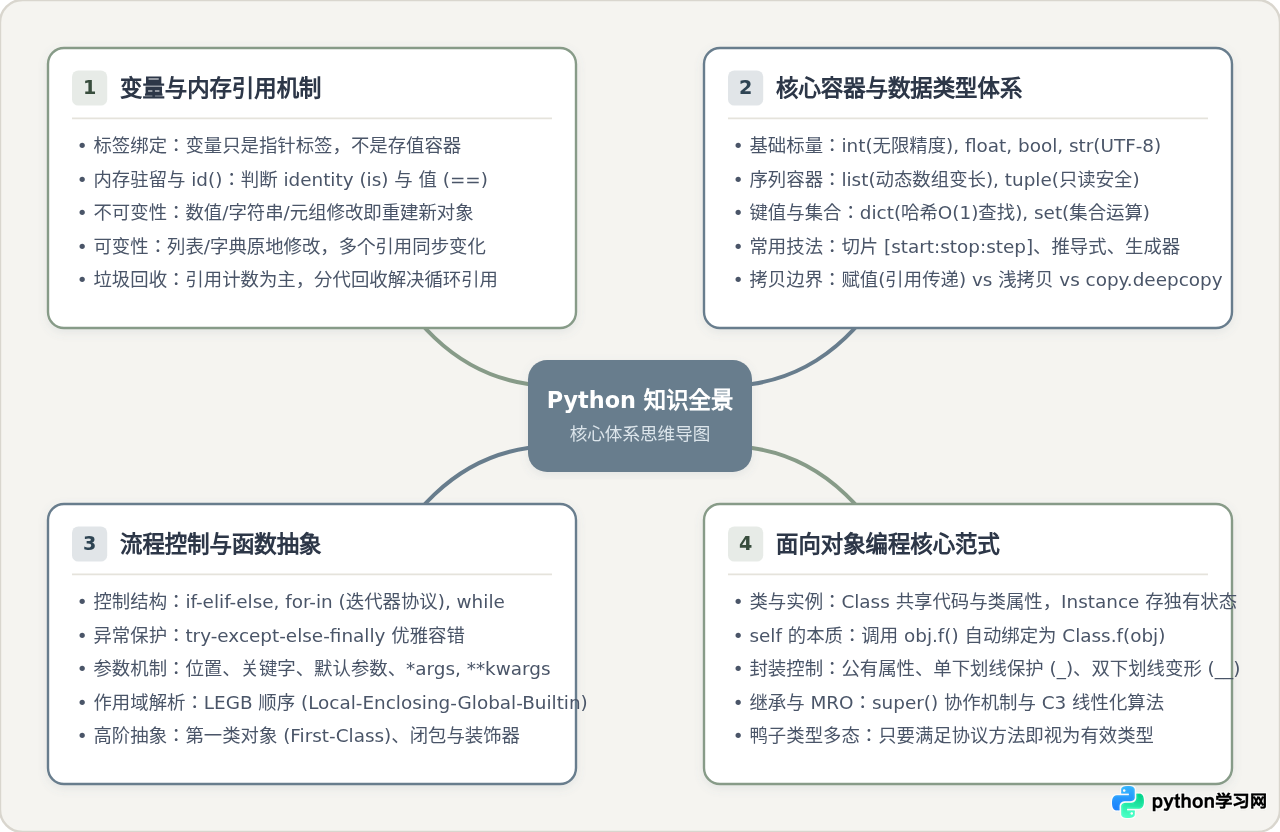
基础阶段四大高频避坑清单
- 误把引用复制当对象克隆:在需要独立副本的场合,切忌直接使用
b = a,必须依据容器层级选用copy()或copy.deepcopy()。 - 在循环遍历容器时动态修改其长度:直接对正在用
for item in my_list:遍历的列表执行remove()或del会导致底层索引偏移跳过元素,稳妥做法是遍历其副本my_list[:]或使用列表推导式重构新列表。 - 滥用全局作用域:过度使用
global会破坏函数的纯洁性与可测性,使变量变化追踪极度困难;尽量保持函数“输入全靠参数、输出全靠返回值”。 - 过度设计面向对象继承层次:继承关系若超过三层往往会大幅提升维护成本,工程中应当优先遵循“组合优于继承”的原则,仅在具有真正的全量行为契约关系时使用继承。
通过理清这一条自底向上的主线脉络,编写 Python 代码时就能对变量背后的内存开销、数据传递时的潜在副作用、以及代码模块的扩展边界做到心中有数。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















