


怎么用Python读取和写入TXT文件?基础IO代码
详细介绍如何使用Python标准库进行TXT文本文件的读取与写入操作。解析open函数、with上下文管理器、不同打开模式(r、w、a)的区别,并提供常用代码示例及常见报错排查方案。
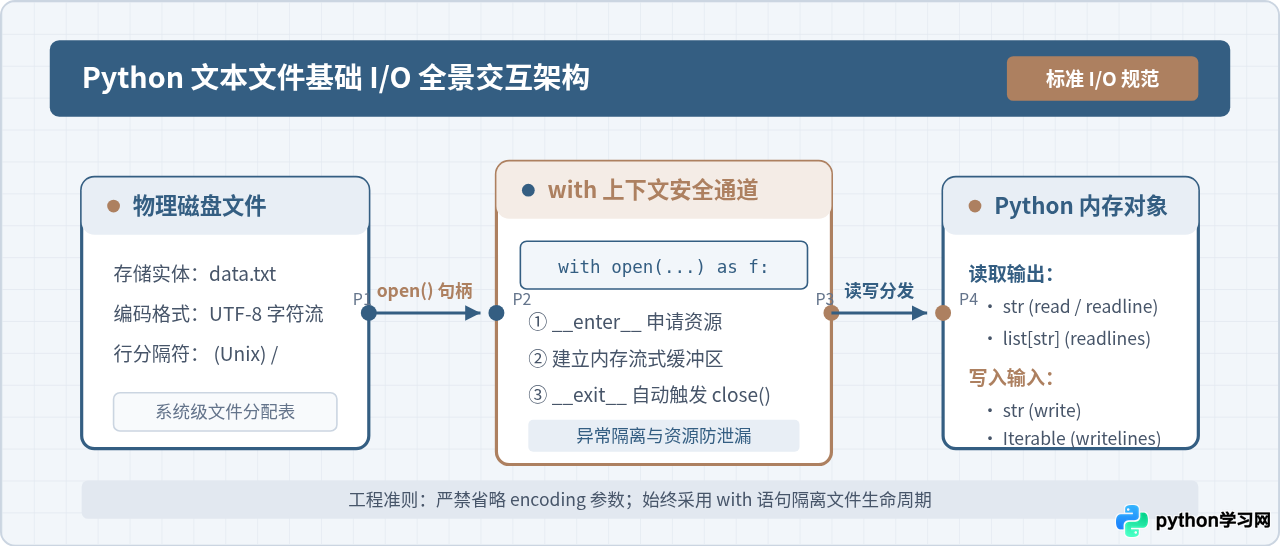
open() 函数配合 with 上下文管理器。使用 with open(...) as f: 语法,无需手动编写关闭文件的清理代码,即可在操作完成后或程序发生异常时自动释放系统文件资源。本文将直接展示读取与写入的标准基础代码,解析常见模式与方法,并说明排查编码与路径问题的规范做法。
一、核心标准范式:两组高频基础代码
日常开发中90%以上的文本文件操作,都遵循下面这两套标准模板。编写时建议始终显式声明字符编码为 encoding='utf-8',以避免在不同操作系统(特别是默认使用GBK编码的Windows系统)之间出现乱码或解析崩溃。
1. 读取TXT文件的标准代码
# 读取完整文本内容
with open('data.txt', 'r', encoding='utf-8') as f:
    content = f.read()

print("读取到的内容:")
print(content)Python基础IO操作
文本第一行数据
文本第二行数据
2. 写入TXT文件的标准代码
# 覆盖写入文本内容(原文件若存在将被清空)
text_to_save = "Python基础IO操作\n这是通过代码写入的第一行。\n这是第二行。\n"

with open('data.txt', 'w', encoding='utf-8') as f:
    f.write(text_to_save)

print("文件写入完成。")二、理解生命周期:为什么必须使用 with open
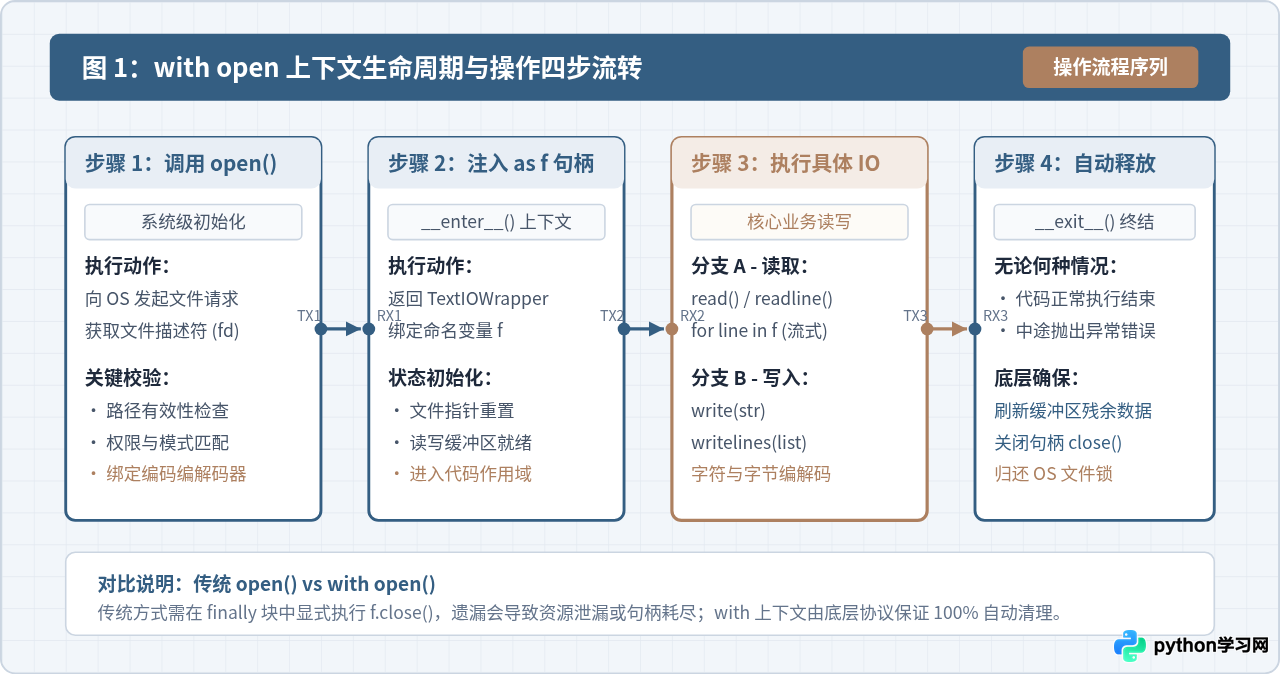
操作系统对打开的文件数量有严格的上限限制(即文件描述符 File Descriptor 配额)。如果使用传统的 f = open(...) 方式,在发生未捕获异常或提前 return 时,后续的 f.close() 可能无法执行,从而导致文件被进程长期锁定或缓冲区数据未能完全刷写到磁盘。
with 语句实现了Python的上下文管理器协议(Context Management Protocol)。当程序进入 with 作用域时,自动调用底层 __enter__() 方法建立数据流连接;当代码执行离开该作用域(无论是正常结束还是遭遇报错中断),Python均保证自动调用 __exit__() 执行清理操作,无缝执行刷盘并关闭句柄。
三、基础读取操作:三种方法的场景选择
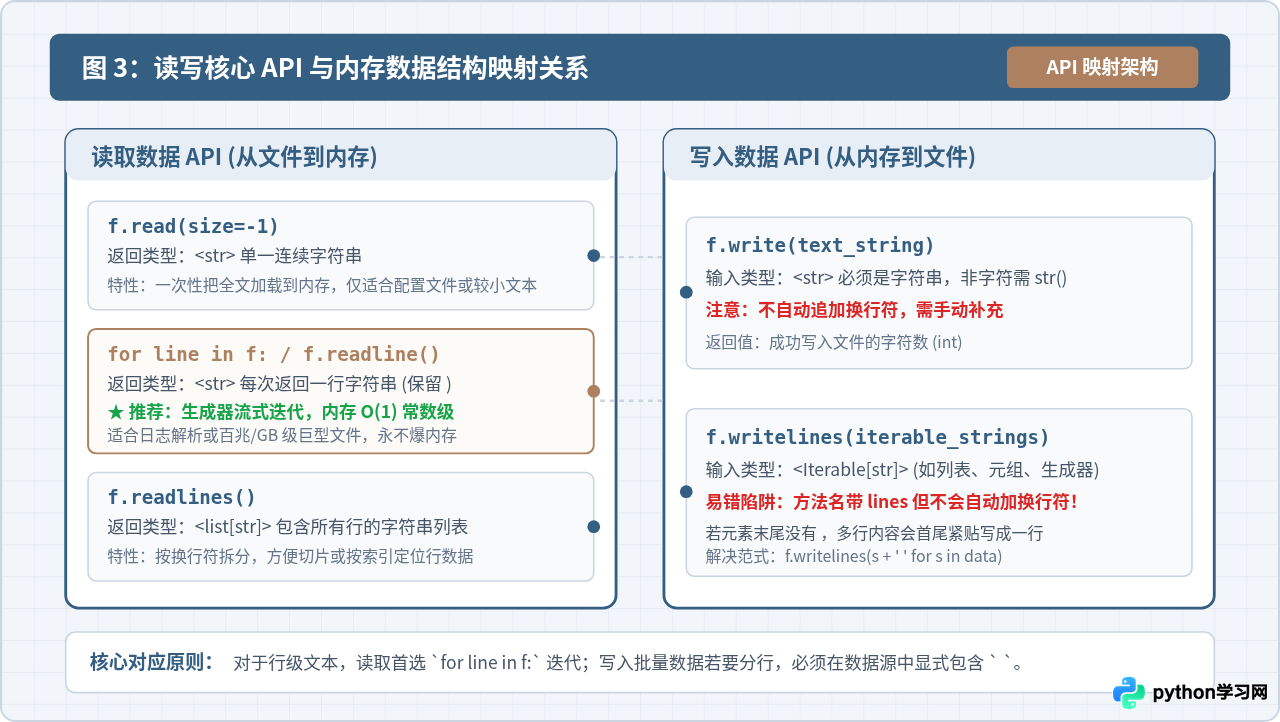
读取TXT文件时,主要根据文件体积以及数据处理形式,在 read()、逐行迭代和 readlines() 之间进行选择。
1. 整体读取:read()
read() 方法会把文件的所有内容一次性读入为一个单独的字符串变量中。如果文件只有几十KB或几兆字节,这是最简便的读取方式。
with open('data.txt', 'r', encoding='utf-8') as f:
    full_text = f.read()

print(f"字符总数: {len(full_text)}")
2. 逐行迭代:for line in f(推荐规范)
当处理大型日志文件或百兆以上的大文本时,一次性载入内存会导致RAM消耗暴增。Python的文件对象本身就是一个可迭代对象,使用 for line in f 能够以流式生成器的方式逐行按需加载,内存占用恒定保持在常数级 O(1)。
line_count = 0
with open('data.txt', 'r', encoding='utf-8') as f:
    for line in f:
        line_count += 1
        # 读取到的line末尾自带换行符\n,可通过 strip() 清理
        clean_line = line.strip()
print(f"[第{line_count}行] {clean_line}")[第2行] 文本第一行数据
[第3行] 文本第二行数据
3. 列表读取:readlines()
readlines() 会遍历整个文件,把每一行作为独立的字符串元素放入列表中返回(即 list[str])。这种方式适合需要根据行号下标随机访问、切片操作(例如跳过前两行表头)的场景。
with open('data.txt', 'r', encoding='utf-8') as f:
    lines = f.readlines()

print(f"总行数: {len(lines)}")
if lines:
print(f"第一行内容: {repr(lines[0])}")第一行内容: 'Python基础IO操作\n'
四、基础写入操作:覆写与追加的区别
写入TXT文件时,决定文件原有内容去留的关键在于 open() 函数的第二个参数 mode。最常用的写入模式是 'w' 和 'a'。
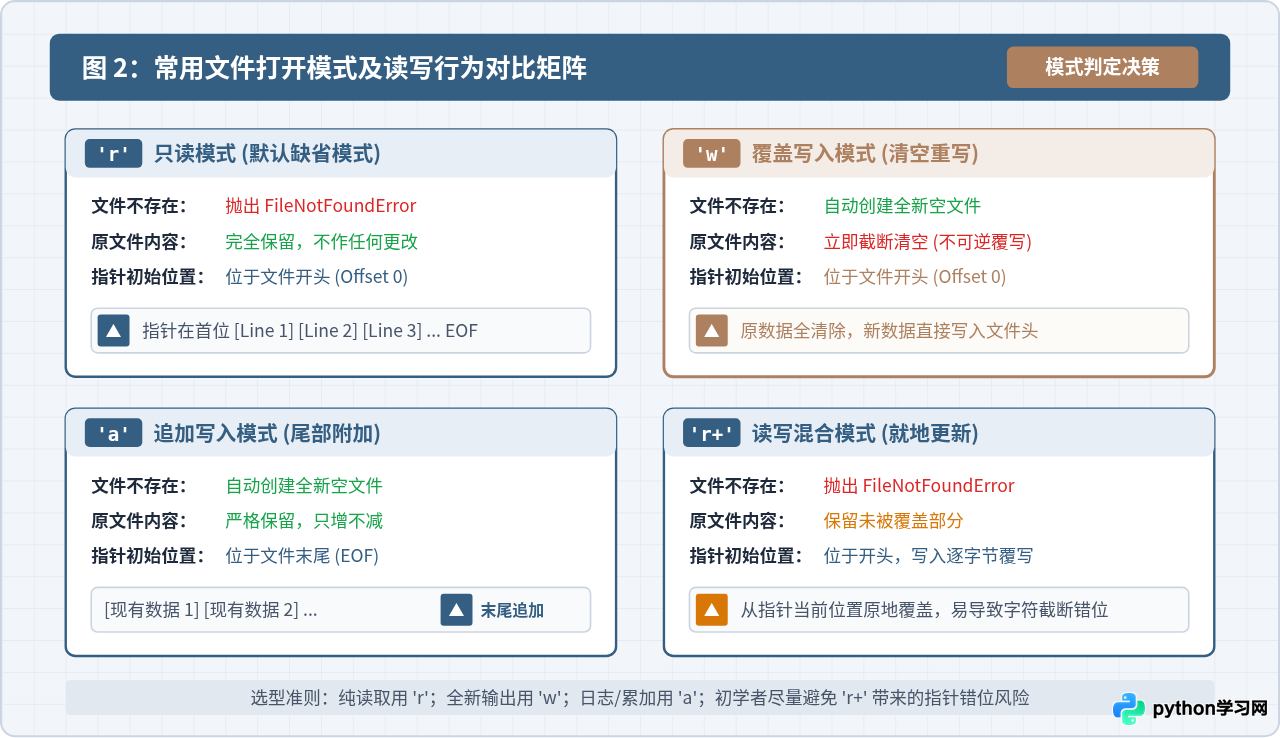
1. 覆盖写入模式:'w' (Write)
模式 'w' 表示写入。如果目标文件不存在,Python会自动在磁盘上新建空文件;如果目标文件已经存在,Python会在打开文件的瞬间将文件大小截断为0字节(即清空历史内容),随后写入新数据。因此若想保留原数据,切勿使用该模式。
items = ["苹果", "香蕉", "橙子"]

with open('fruits.txt', 'w', encoding='utf-8') as f:
    for item in items:
        # write() 不会自动添加换行,必须手动拼接 \n
        f.write(item + "\n")
2. 追加写入模式:'a' (Append)
模式 'a' 表示追加。如果文件不存在,会自动创建新文件;如果文件已存在,原有内容会完好无损地保留,新数据会自动写入到文件的最末尾。该模式非常适用于记录运行日志、抓取增量结果等场景。
import datetime

log_entry = f"[{datetime.datetime.now().strftime('%Y-%m-%d %H:%M:%S')}] 任务执行完毕\n"

with open('app.log', 'a', encoding='utf-8') as f:
    f.write(log_entry)

print("日志已追加至末尾。")3. 批量写入多行:writelines() 的注意事项
writelines() 接收一个字符串列表或迭代器并将其逐项写入文件。需要特别注意的是:该方法虽然名称包含 lines,但内部并不会自动在字符串末尾补充换行符。如果传入的列表元素本身不带 \n,所有内容将紧贴在同一行。
data = ["第一项内容", "第二项内容", "第三项内容"]

# 正确做法:在生成式中显式拼接换行符
with open('output.txt', 'w', encoding='utf-8') as f:
    f.writelines(line + "\n" for line in data)
五、工程避坑:三个高频错误与排查方法
在实际执行TXT文件IO操作时,初学者最容易遇到字符乱码、文件找不到以及格式错位三类问题。按照以下规范可以针对性规避:
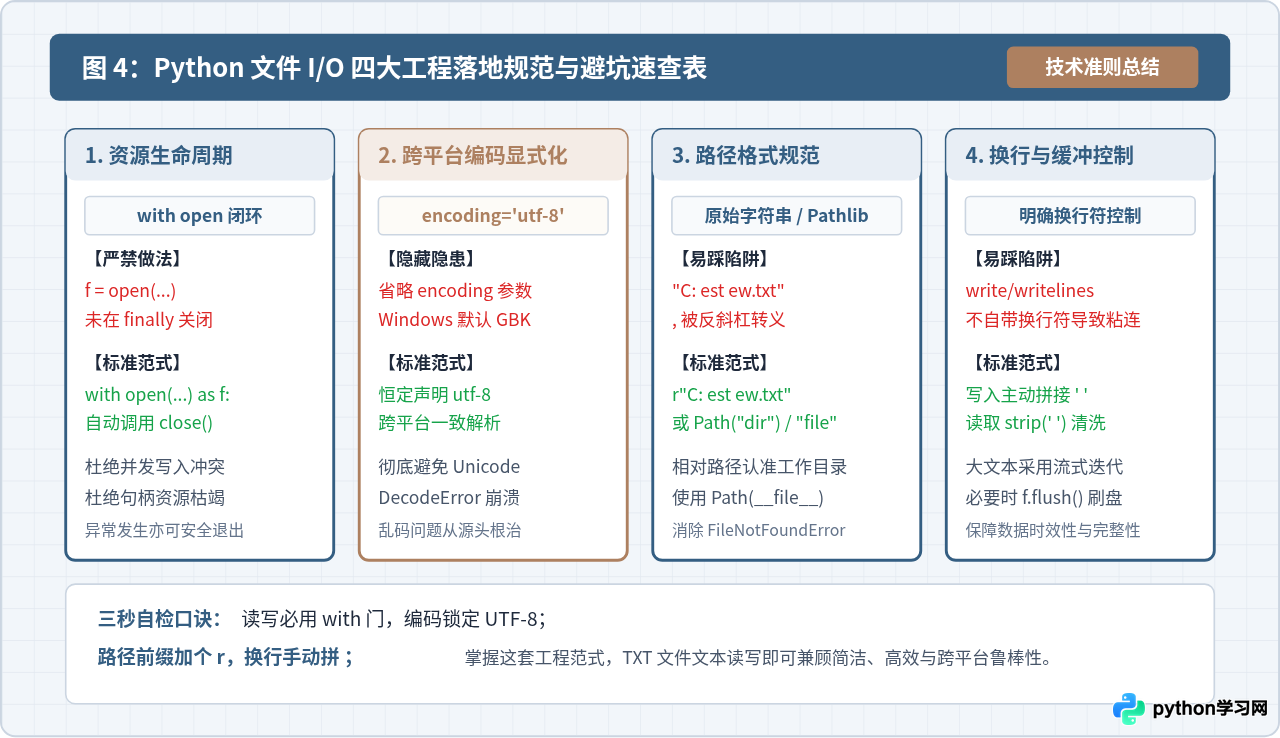
1. 解决 UnicodeDecodeError 编码报错
表现:在Windows系统下读取UTF-8格式的TXT文件时,报 UnicodeDecodeError: 'gbk' codec can't decode byte... 错误。
原因:如果在 open() 中不指定 encoding 参数,Python会默认采用操作系统当前平台的默认编码。Windows系统在简体中文环境下默认为 cp936 (GBK),无法识别以UTF-8存储的中文字符。
解决方案:无论在哪个平台写代码,统一传入 encoding='utf-8'。如果面对的是古老系统生成的GBK/GB2312旧文件,则相应设置 encoding='gbk'。
2. 解决 FileNotFoundError 文件路径报错
表现:代码提示 FileNotFoundError: [Errno 2] No such file or directory: 'data.txt',但文件明明就在同级目录中。
原因:相对路径并不是相对于当前Python脚本所在的目录,而是相对于终端启动执行时所在的当前工作目录 (Current Working Directory)。
解决方案:使用Python内置的 pathlib 模块,基于当前脚本的绝对路径来定位目标文件,同时在Windows路径中使用原始字符串 r"..." 防止转义:
from pathlib import Path

# 获取当前 py 脚本所在的父级绝对目录
BASE_DIR = Path(__file__).resolve().parent
target_file = BASE_DIR / "data.txt"

with open(target_file, 'r', encoding='utf-8') as f:
    print(f.read())
3. 解决读取时出现的“空行翻倍”现象
表现:用 for line in f: print(line) 输出文本时,原本紧凑的内容在终端中每行之间多出了一个空行。
原因:文本文件自身的每一行行末已经包含了一个 \n 换行符,而Python的 print() 函数默认也会在末尾输出一个 \n,两者叠加导致出现双重换行。
解决方案:可以在输出时禁用print的尾部换行 print(line, end=''),或者在处理前使用 line.rstrip('\n') 剥离原有行末换行符。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















