


Python进行t检验前怎么用Shapiro-Wilk和Levene检验验证前提条件
详细讲解在Python中进行独立双样本t检验与配对t检验前,如何使用SciPy库的Shapiro-Wilk检验验证正态性、Levene检验验证方差齐性,包含代码实现、p值判定标准及违背前提时的应对方案。
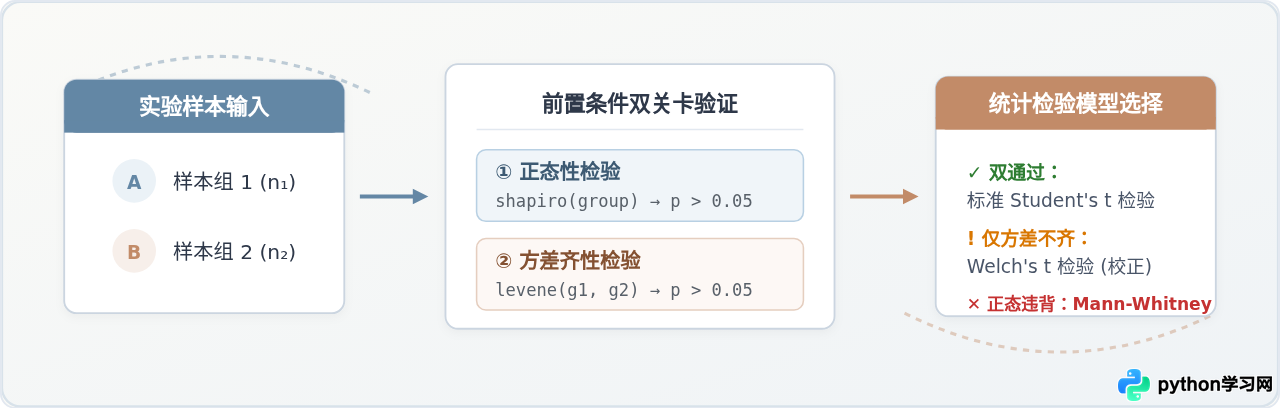
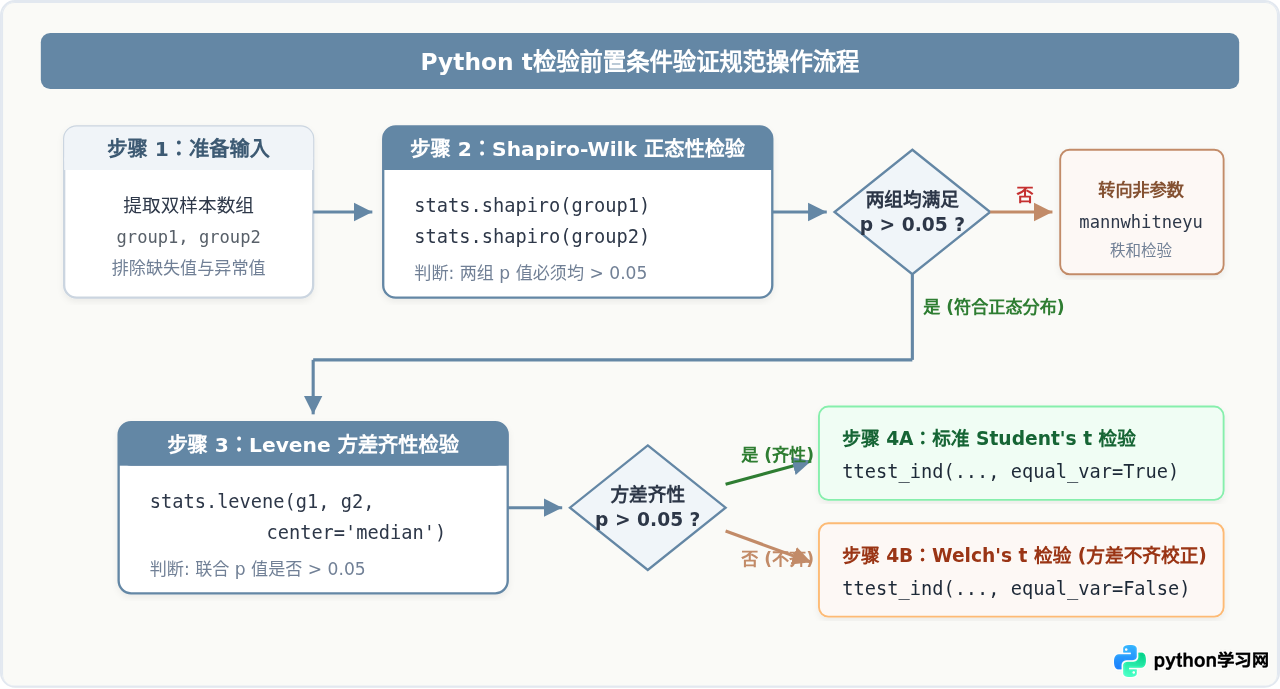
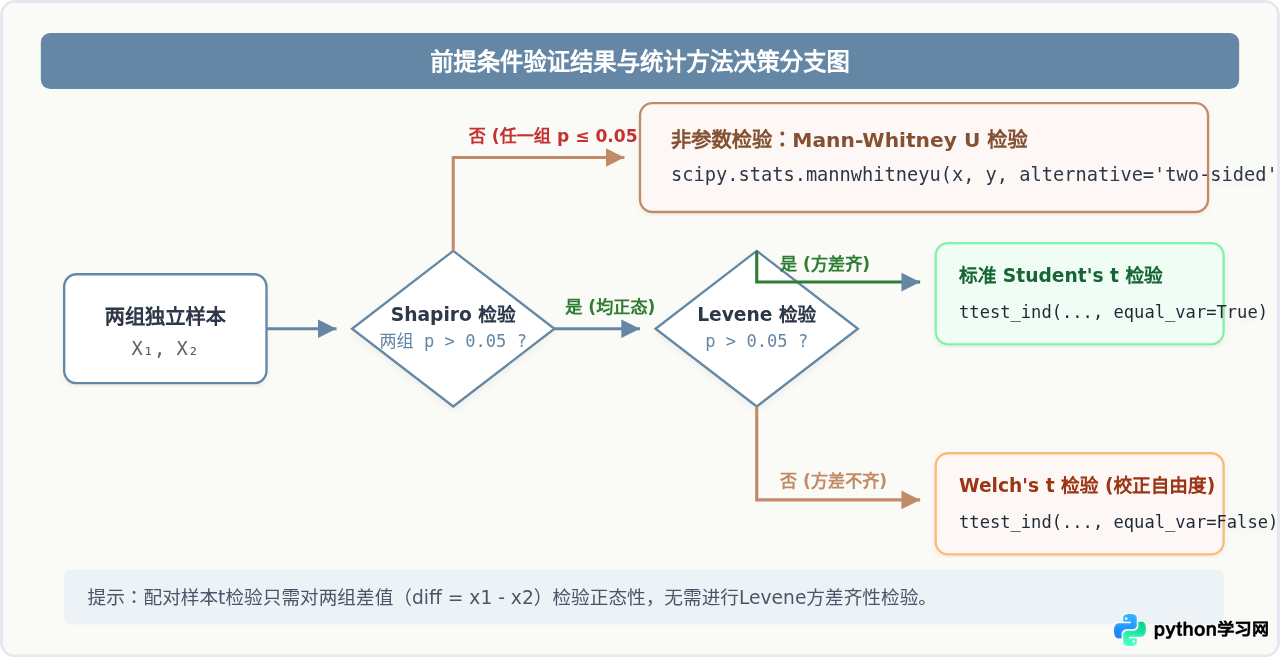
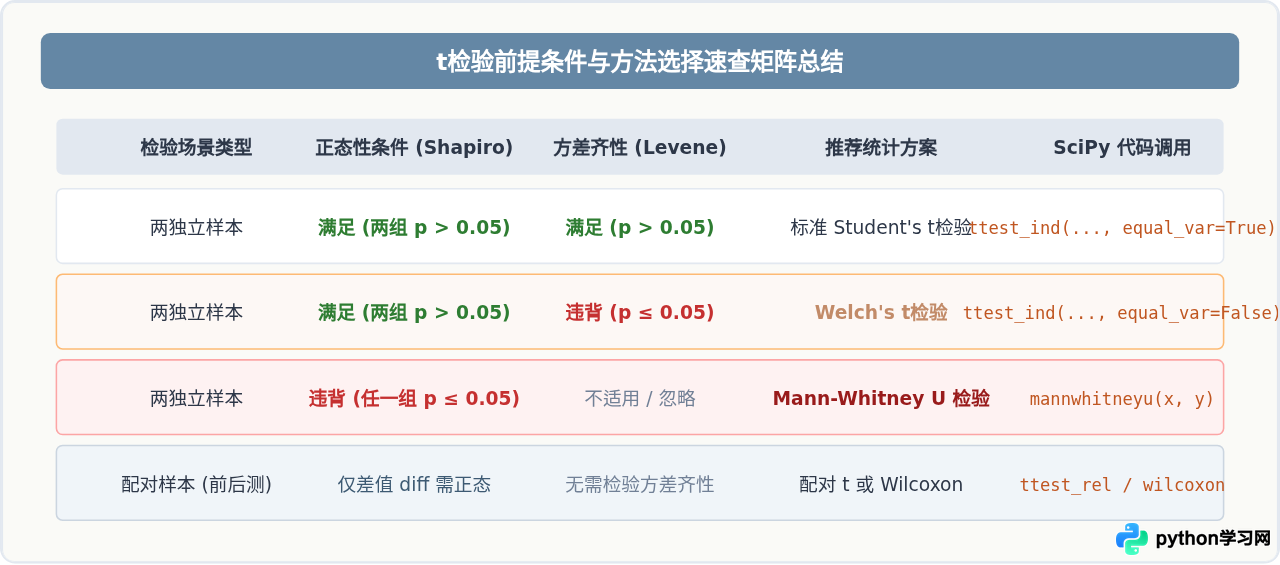
scipy.stats.shapiro 对每组样本分别进行正态分布检验;若均满足正态性,再通过 scipy.stats.levene 检验两组方差是否相等。只有两个检验的显著性指标(p值)均大于所选显著性水平(通常为0.05),才能安全执行标准Student's t检验;若方差不齐,需改用Welch's t检验;若偏离正态分布,则需改用非参数Mann-Whitney U检验。
一、为什么t检验必须先验证正态性与方差齐性
Student's t检验(学生氏t检验)是数据分析中比较两组连续型变量均值差异最常用的参数检验方法。但t检验公式中的统计量推导,建立在严格的数学假设之上。若直接在未检验的数据上调用 ttest_ind,可能得出严重失真的分析结论。
t检验的有效性依赖以下三个基础假设:
- 独立性假设:样本观测值之间互不干扰,抽样必须彼此独立。这是由实验设计或数据采集方案决定的,无法依靠统计检验公式修正。
- 正态性假设(Normality):各组总体必须服从正态分布。若样本严重偏态或存在尖峰厚尾,t分布的临界值计算将不再准确,导致第一类错误率(虚报显著性)显著上升或检验功效(Power)大幅削弱。
- 方差齐性假设(Homogeneity of Variance):两个总体的方差必须相等(即 $\sigma_1^2 = \sigma_2^2$)。标准t检验在计算合并方差(Pooled Variance)时假设两组波动程度一致;若方差相差悬殊而样本量不平衡,自由度估算将产生重大偏差。
因此,在Python中执行 scipy.stats.ttest_ind 之前,通过标准化工具链验证正态性与方差齐性,是保证实证分析严谨性的法定步骤。
二、使用Shapiro-Wilk检验验证正态性
在统计学中,检测连续变量样本是否来自正态总体的方法包括 Shapiro-Wilk、Kolmogorov-Smirnov (K-S)、D'Agostino's K-squared 等。对于中小样本($N < 5000$),Shapiro-Wilk 检验被公认为检验功效(Statistical Power)最高的正态性检测算法。
1. 统计假设与判定规则
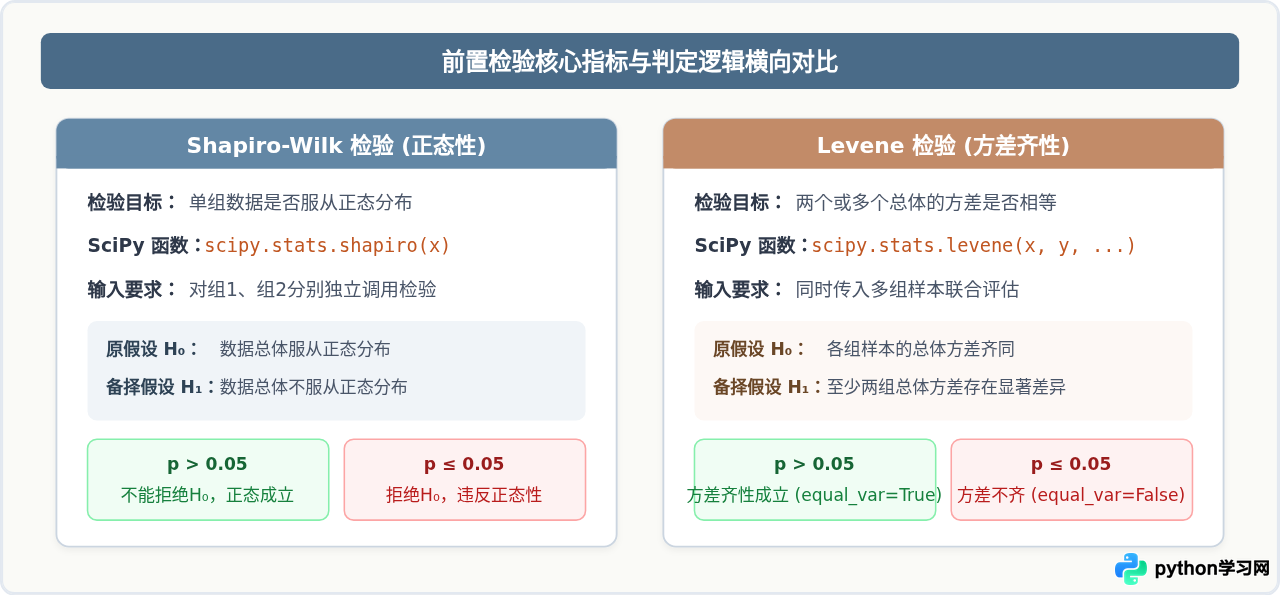
Shapiro-Wilk 检验建立在如下原假设和备择假设基础之上:
- 原假设($H_0$):样本数据来自服从正态分布的总体。
- 备择假设($H_1$):样本数据不服从正态分布。
判断核心依据是输出的 p值(p-value):
- 当 $p > 0.05$ 时:在 $lpha=0.05$ 的检验水准下,无法拒绝原假设。数据没有表现出显著偏离正态分布的统计证据,可以认定满足正态性前提。
- 当 $p \le 0.05$ 时:拒绝原假设,表明数据显著偏离正态分布,不满足标准t检验的分布假设。
注意:独立双样本t检验要求两个样本组分别满足正态分布,必须分别对每一组运行一次 shapiro 检验,只要任意一组 $p \le 0.05$,该前提即告违背。
2. Python实现代码
在 Python 的科学计算库 scipy.stats 中,正态性检验由 shapiro 函数提供:
from scipy import stats
import numpy as np

# 构造模拟数据:组1与组2均为正态分布数据
np.random.seed(42)
group1 = np.random.normal(loc=50, scale=8, size=40)
group2 = np.random.normal(loc=54, scale=8, size=40)

# 对组1执行 Shapiro-Wilk 检验
stat1, p_val1 = stats.shapiro(group1)
print(f"组1 Shapiro-Wilk 统计量: {stat1:.4f}, p值: {p_val1:.4f}")

# 对组2执行 Shapiro-Wilk 检验
stat2, p_val2 = stats.shapiro(group2)
print(f"组2 Shapiro-Wilk 统计量: {stat2:.4f}, p值: {p_val2:.4f}")

# 判断两组是否均满足正态性
alpha = 0.05
is_normal = (p_val1 > alpha) and (p_val2 > alpha)
print(f"两组数据是否同时满足正态性前提: {is_normal}")
示例输出:
组1 Shapiro-Wilk 统计量: 0.9856, p值: 0.8841
组2 Shapiro-Wilk 统计量: 0.9782, p值: 0.6225
两组数据是否同时满足正态性前提: True
三、使用Levene检验验证方差齐性
在方差齐性检验领域,传统的 Bartlett 检验对非正态性极其敏感,一旦数据稍微偏离严格正态,Bartlett 检验就会给出极小的 p 值误报方差不齐。相比之下,Levene 检验对分布形态具有极强的稳健性(Robustness),是现代统计学和数据分析首选的方差齐性检验方法。
1. 统计假设与参数选择
- 原假设($H_0$):所有对比组的总体方差相等($\sigma_1^2 = \sigma_2^2$)。
- 备择假设($H_1$):各对比组的总体方差不相等。
在 scipy.stats.levene(*samples, center='median') 中,参数 center 决定了中心趋势的衡量方式:
center='median'(默认推荐):即 Brown-Forsythe 检验变体。当数据存在一定偏态或潜在离群值时,以中位数计算残差最为稳健。center='mean':经典 Levene 检验,适用于对称的轻尾分布。center='trimmed':截尾均值,适用于重尾分布。
2. Python实现代码
from scipy import stats

# 传入组1与组2进行方差齐性检验
stat_lev, p_val_lev = stats.levene(group1, group2, center='median')
print(f"Levene 统计量: {stat_lev:.4f}, p值: {p_val_lev:.4f}")

# 判断方差是否齐同
if p_val_lev > 0.05:
    print("p > 0.05: 满足方差齐性,后续可使用标准独立t检验 (equal_var=True)")
else:
    print("p <= 0.05: 方差不齐,后续需使用 Welch's t检验 (equal_var=False)")
示例输出:
Levene 统计量: 0.1245, p值: 0.7251
p > 0.05: 满足方差齐性,后续可使用标准独立t检验 (equal_var=True)
四、配对样本t检验的特殊前提验证
很多初学者容易在这里产生误区:认为配对样本t检验(如同一受试者实验前后的得分对比)也需要对两组分别做正态性检验并做Levene方差齐性检验。
这是统计学上的经典错误:
- 不需要方差齐性检验:配对样本t检验在数学实质上等于“差值序列(Difference)的单样本t检验”,只有一个变量(差值变量),根本不存在两个独立组之间的方差对比,因此完全不需要 Levene 检验。
- 正态性检验的对象是“差值”:配对t检验只要求差值数据 $d_i = x_{1i} - x_{2i}$ 服从正态分布,即使前测数据和后测数据各自偏离正态,只要差值服从正态分布,配对t检验完全有效!
配对样本前提验证的 Python 代码示例如下:
# 配对样本前置验证示例
np.random.seed(101)
before = np.random.normal(70, 10, 30)
after = before + np.random.normal(5, 2, 30)  # 存在系统增益

# 计算差值
diff = after - before

# 仅需对差值做 Shapiro-Wilk 检验
stat_pair, p_pair = stats.shapiro(diff)
print(f"配对差值 Shapiro 检验 p值: {p_pair:.4f}")

if p_pair > 0.05:
    print("差值满足正态性,执行配对t检验: stats.ttest_rel(after, before)")
    t_res = stats.ttest_rel(after, before)
    print(f"配对t检验结果: t={t_res.statistic:.4f}, p={t_res.pvalue:.4e}")
else:
    print("差值不服从正态分布,改用 Wilcoxon 符号秩检验: stats.wilcoxon(after, before)")
    w_res = stats.wilcoxon(after, before)
    print(f"Wilcoxon 检验结果: stat={w_res.statistic:.4f}, p={w_res.pvalue:.4e}")
五、工业级自动化验证与检验决策流水线
在实际工程和自动化数据分析流水线中,手动编写多个 if-else 既冗长又容易遗漏。下面封装一个完整的工业级函数 auto_ttest_pipeline,自动完成正态性检验、方差齐性检验,并选择最优的统计方案输出结果:
import numpy as np
from scipy import stats

def auto_ttest_pipeline(group1, group2, alpha=0.05, paired=False):
    """
    自动完成前提条件验证并执行对应假设检验的流水线
    :param group1: 第一组数值数据 (array-like)
    :param group2: 第二组数值数据 (array-like)
    :param alpha: 显著性水平,默认0.05
    :param paired: 是否为配对样本
    :return: 包含诊断信息与检验结果的字典
    """
    g1 = np.asarray(group1)
    g2 = np.asarray(group2)

    # 清理 NaN
    g1 = g1[~np.isnan(g1)]
    g2 = g2[~np.isnan(g2)]

    results = {
        "paired": paired,
        "alpha": alpha,
        "diagnostics": {},
        "selected_test": None,
        "statistic": None,
        "p_value": None,
        "conclusion": ""
    }

    if paired:
        if len(g1) != len(g2):
            raise ValueError("配对样本的数据长度必须严格一致!")
        diff = g1 - g2
        _, p_shapiro = stats.shapiro(diff)
        results["diagnostics"]["shapiro_diff_p"] = p_shapiro

        if p_shapiro > alpha:
            test_res = stats.ttest_rel(g1, g2)
            results["selected_test"] = "Paired Student's t-test"
            results["statistic"] = test_res.statistic
            results["p_value"] = test_res.pvalue
        else:
            test_res = stats.wilcoxon(g1, g2)
            results["selected_test"] = "Wilcoxon Signed-Rank Test"
            results["statistic"] = test_res.statistic
            results["p_value"] = test_res.pvalue
    else:
        # 独立样本检验
        _, p_s1 = stats.shapiro(g1)
        _, p_s2 = stats.shapiro(g2)
        normality_ok = (p_s1 > alpha) and (p_s2 > alpha)

        _, p_levene = stats.levene(g1, g2, center='median')
        variance_equal = p_levene > alpha

        results["diagnostics"]["group1_shapiro_p"] = p_s1
        results["diagnostics"]["group2_shapiro_p"] = p_s2
        results["diagnostics"]["levene_p"] = p_levene
        results["diagnostics"]["normality_met"] = normality_ok
        results["diagnostics"]["equal_var_met"] = variance_equal

        if normality_ok:
            if variance_equal:
                # 均满足 -> 标准 Student's t-test
                test_res = stats.ttest_ind(g1, g2, equal_var=True)
                results["selected_test"] = "Independent Student's t-test (equal_var=True)"
            else:
                # 方差不齐 -> Welch's t-test
                test_res = stats.ttest_ind(g1, g2, equal_var=False)
                results["selected_test"] = "Welch's t-test (equal_var=False)"
            results["statistic"] = test_res.statistic
            results["p_value"] = test_res.pvalue
        else:
            # 正态性不满足 -> Mann-Whitney U 检验
            test_res = stats.mannwhitneyu(g1, g2, alternative='two-sided')
            results["selected_test"] = "Mann-Whitney U Test"
            results["statistic"] = test_res.statistic
            results["p_value"] = test_res.pvalue

    # 结论判定
    if results["p_value"] < alpha:
        results["conclusion"] = f"差异显著 (p={results['p_value']:.4e} < {alpha})"
    else:
        results["conclusion"] = f"未见显著差异 (p={results['p_value']:.4e} >= {alpha})"

    return results

# 测试调用
sample_a = [23.1, 24.5, 22.8, 25.1, 24.9, 23.8, 24.2, 25.5]
sample_b = [26.2, 27.5, 25.9, 28.1, 27.3, 26.8, 27.0, 28.5]
res = auto_ttest_pipeline(sample_a, sample_b)
print("自动化流水线评估结果:", res)
六、实操中的常见问题与注意事项
1. 样本量非常大时的“p值过度敏感”现象
当样本量 $N > 5000$ 甚至达到数万时,Shapiro-Wilk 检验的统计功效极高,即使分布与标准正态只有微不可察的微小偏离,检验得出的 p 值也会显著小于 0.05。在此类超大样本场景下:
- 结合中心极限定理(CLT):当样本量足够大时,样本均值的抽样分布会自然趋向正态分布,t检验对正态性轻微偏离具有极强的耐受性;
- 配合图形法诊断:通过
stats.probplot(data, plot=plt)绘制 Q-Q 图或直方图核密度曲线,从偏度(Skewness)与峰度(Kurtosis)维度进行实际业务评估,避免因机械套用 p 值而拒绝合理的参数检验。
2. 为什么方差不齐时 Welch's t检验 优于数据转换
过去有些做法倾向于通过对数变换($\log$)或平方根变换来强行稳定方差。但数据转换会改变变量的原有量纲和物理含义,使得回归分析或均值差值的置信区间解释变得极其困难。现代统计学普遍推荐直接调用 ttest_ind(g1, g2, equal_var=False),Welch-Satterthwaite 公式会自动调整有效自由度,在几乎不损失统计功效的前提下完美解决方差不齐的问题。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















