


根据实验设计选择Python中的单样本、独立样本或配对t检验
针对实验数据分析需求,系统解析如何根据实验设计类型(单组基准对比、独立组间对比、自身前后配对)准确选择Python中scipy.stats的单样本、独立样本与配对t检验,涵盖前提假设排查、完整代码实现与典型混淆辨析。
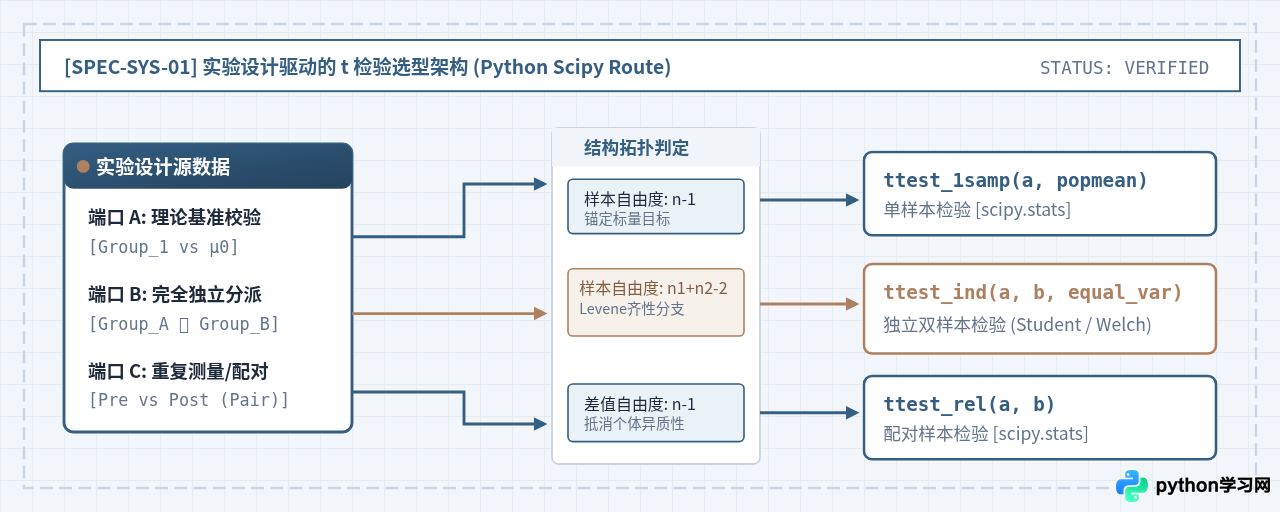
在Python中进行假设检验时,选用哪一种t检验严格取决于实验方案的数据组织形态:单样本t检验(scipy.stats.ttest_1samp)用于单个受试组与理论固定常数的对比;两独立样本t检验(scipy.stats.ttest_ind)用于完全互斥、两组互不相干个体间的横向均值对比;配对样本t检验(scipy.stats.ttest_rel)则用于同一受试群体的前后重复测量或物理条件严格对等的配对组设计。
一、为什么必须由实验设计决定t检验类型
很多初学者在拿到两列或多列数据时,容易直接调用 scipy.stats.ttest_ind,忽视了数据的产生机制。t检验本质上检验的是均值差异在抽样误差背景下的统计学显著性。每一种t检验计算自由度(Degrees of Freedom)以及组间/组内方差估计的方式完全不同:
- 自由度与方差分配机制不同:如果对自身前后测的数据错误使用独立双样本t检验,模型会认为两个组别来自2n个独立个体,导致自由度被错误虚增为2n-2,同时无法剔除受试者本身的固有体质差异,导致检验效能(Power)严重降低。
- 观测独立性假设的破坏:若对完全独立的随机分组(例如A组与B组患者)误用配对t检验,算法会强行将第一行的A组个体与第一行的B组个体绑定,这种人为虚构的相关性会使得标准误失真,导致I类错误率急剧上升。
- Python函数的底层参数差异:例如
ttest_ind默认执行学生氏t检验(假定方差齐性),若实际方差非齐性则需明确显式配置equal_var=False(即Welch's t检验)。
二、三种t检验的实验设计特征与适用场景
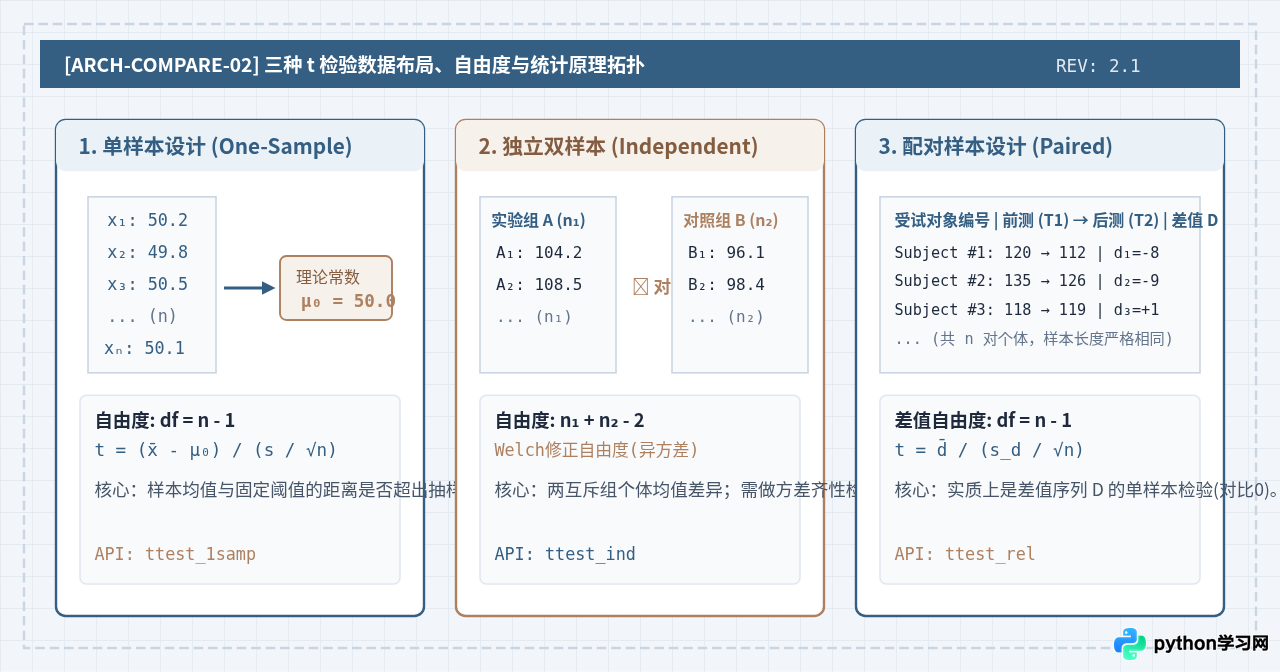
实验设计决定了数据的结构。在动手写Python代码前,应根据以下特征明确研究分类:
1. 单样本t检验(One-Sample t-Test)
实验特征:仅采集一组连续变量的样本数据,实验目的并非对比两个组别,而是检验该样本均值是否在统计学上偏离一个已知的特定参考值、理论阈值或历史常数($\mu_0$)。
典型工业与科研场景:
- 机械加工中,检测一批次零件的直径是否精确维持在标称规格
50.0 mm。 - 环境检测中,测量某河流下游20个采样点的溶解氧均值是否符合国家标准下限
6.5 mg/L。 - 算法优化中,测试新算法在30个基准测试集上的响应耗时是否显著低于既有旧系统承诺的
120 ms。
2. 独立样本t检验(Independent Two-Sample t-Test)
实验特征:数据包含两个独立的实验组,两组中的受试单元完全没有交集,满足相互独立假设。两组样本量可以相等($n_1 = n_2$),也可以不等($n_1 eq n_2$)。
典型工业与科研场景:
- A/B测试:将访客随机且无重复地分流给界面A(对照组)与界面B(实验组),对比两组的停留时长均值。
- 临床药物试验:两批病情相当的不同受试者,一组服用新药,另一组服用安慰剂,对比4周后的生理指标差异。
- 农业育种:随机选择两块不同地块分别种植品种甲和品种乙,对比收获期的单株产量。
3. 配对样本t检验(Paired Samples t-Test)
实验特征:数据由成对的观测值组成。两列数据必须具有完全相同的大小(即样本对数均为n),并且每一行的两笔数据之间存在生物学、时间序列或几何上的强绑定关系。最常见的是同一受试对象的“前测 - 后测”(Pre-Post)或孪生/属性严格匹配对。
典型工业与科研场景:
- 同一批员工在参加专业培训前、后的业务技能考核得分对比。
- 同一批高血压患者服用降压药前2小时与服药后2小时的收缩压数值对比。
- 汽车同一轴线左右两只轮胎在经历相同里程测试后的磨损深度测量(左右轮自然配对)。
三、实验设计决策步骤与选择流程
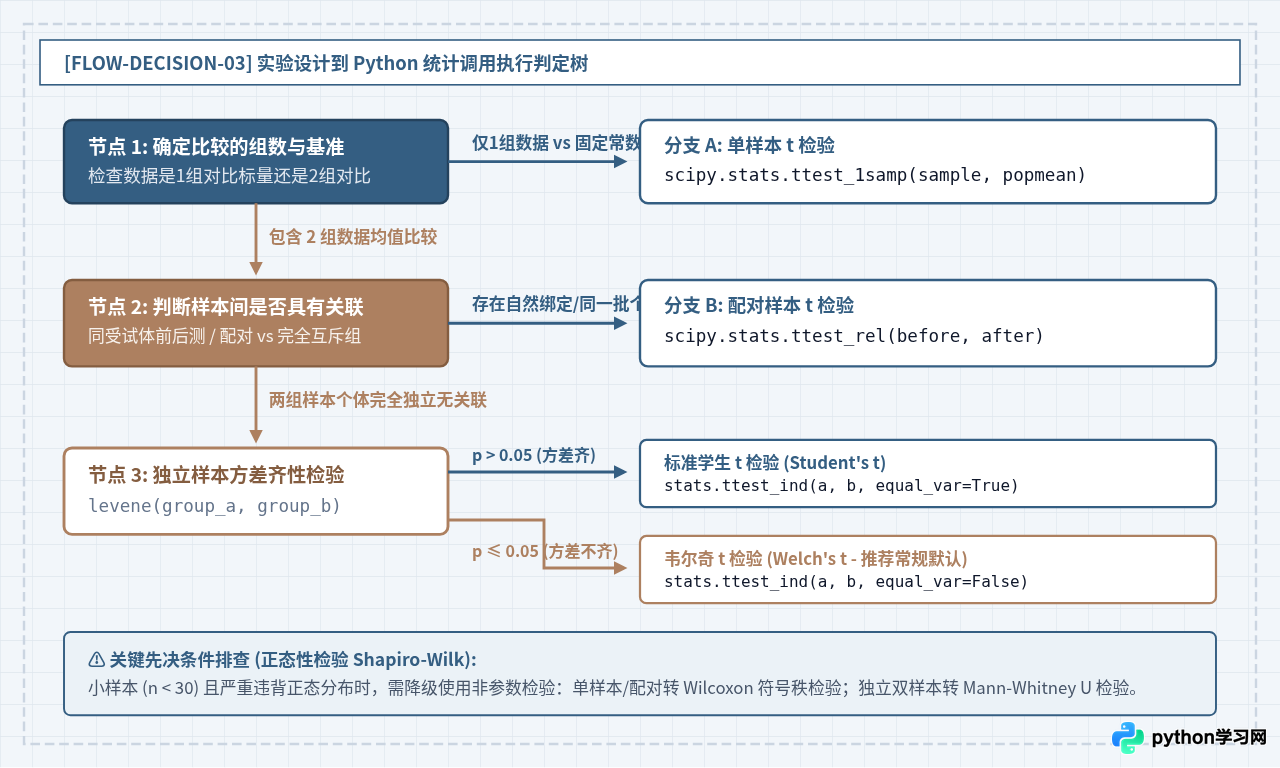
在面对未知实验数据时,按照以下决策流程逐步确认。下图清晰展示了从原始实验设计走向对应Python代码分支的具体判定节点:
四、Python代码实现与检验执行流水线
进行t检验通常包含三个标准步骤:数据完整性校验 → 前提假设检验(正态性与齐性) → 执行对应t检验函数并解析结果。下图给出了在Python中组织该统计计算流水线的标准工程架构:
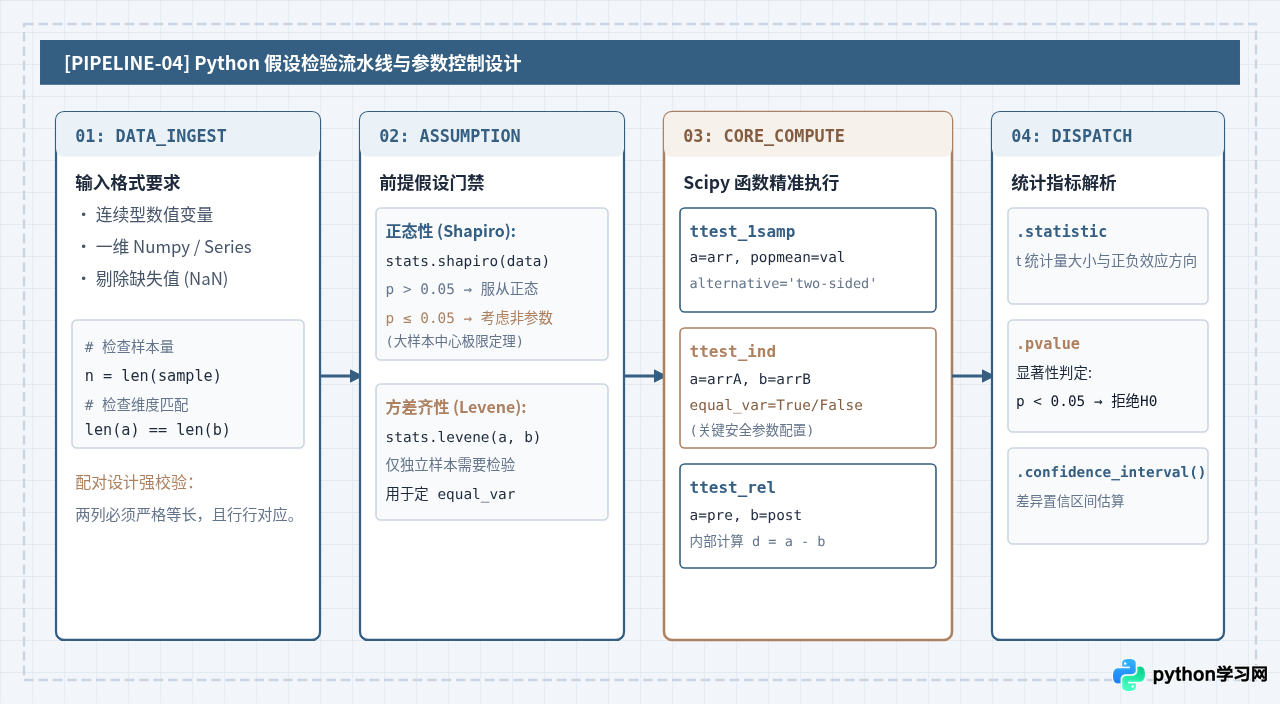
完整Python实战代码演示
以下代码提供在单样本、独立样本和配对实验设计下的完整实现范例,包括环境依赖、数据构造、前提检查与t检验执行:
# 执行环境: Python 3.8+, 需安装 numpy 与 scipy
# 执行位置: 本地脚本或 Jupyter Notebook 均可
import numpy as np
from scipy import stats

# ===============================================================
# 场景 1: 单样本 t 检验 (One-Sample t-Test)
# 实验设计: 检查某车间生产的轴承内径是否符合标准规格 50.00 mm
# ===============================================================
diameters = np.array([50.02, 50.05, 49.98, 50.01, 50.04,
                      50.03, 49.97, 50.06, 50.02, 50.01])
target_mean = 50.00

# 正态性校验 (小样本采用 Shapiro-Wilk 检验)
shapiro_p = stats.shapiro(diameters).pvalue
if shapiro_p > 0.05:
    res_1samp = stats.ttest_1samp(diameters, popmean=target_mean)
    print(f"[单样本] t统计量: {res_1samp.statistic:.4f}, p值: {res_1samp.pvalue:.4f}")

# ===============================================================
# 场景 2: 两独立样本 t 检验 (Independent Samples t-Test)
# 实验设计: 网页A/B测试,随机分流两组独立用户,对比页面停留时长(秒)
# ===============================================================
group_A = np.array([45.2, 52.1, 48.9, 60.3, 55.8, 49.0, 51.2])
group_B = np.array([58.4, 64.2, 59.8, 72.1, 61.5, 63.0])

# 独立样本必须进行方差齐性检查 (Levene 检验)
levene_stat, levene_p = stats.levene(group_A, group_B)
is_equal_var = levene_p > 0.05

# 若方差不齐(p <= 0.05),设置 equal_var=False 启动 Welch's t-test
res_ind = stats.ttest_ind(group_A, group_B, equal_var=is_equal_var)
print(f"[独立样本] 方差齐性p值: {levene_p:.4f}, equal_var={is_equal_var}")
print(f"[独立样本] t统计量: {res_ind.statistic:.4f}, p值: {res_ind.pvalue:.4f}")

# ===============================================================
# 场景 3: 配对样本 t 检验 (Paired Samples t-Test)
# 实验设计: 8位学员参加专业冲刺训练前后的编程测验得分(百分制)
# ===============================================================
scores_pre  = np.array([65, 72, 58, 80, 69, 74, 61, 70])
scores_post = np.array([78, 85, 70, 88, 76, 83, 72, 81])

# 校验差值的正态性
diff = scores_post - scores_pre
diff_shapiro_p = stats.shapiro(diff).pvalue

if diff_shapiro_p > 0.05:
    res_rel = stats.ttest_rel(scores_pre, scores_post)
    print(f"[配对样本] t统计量: {res_rel.statistic:.4f}, p值: {res_rel.pvalue:.4f}")
代码示例控制台输出(参考示例):
[单样本] t统计量: 2.2283, p值: 0.0528
[独立样本] 方差齐性p值: 0.5892, equal_var=True
[独立样本] t统计量: -3.5126, p值: 0.0048
[配对样本] t统计量: -18.7845, p值: 0.0000
解释:在显著性水平 $lpha = 0.05$ 下,单样本 p > 0.05 表明未发现显著偏离 50.00 mm;独立样本 p < 0.01 表明B界面停留时间显著高于A;配对样本 p < 0.001 表明培训后得分显著提升。
五、极易混淆的实验设计陷阱与排查清单
在实际业务中,许多统计错误并非源于Python语法,而是由于混淆了实验设计的本质。以下是最常见的两个认知陷阱:
陷阱 1:把“前后测重复测量”当作“独立样本”
错误表现:追踪了50名用户使用新功能前和使用新功能后的活跃度,直接将两列数据传入 stats.ttest_ind(pre, post)。
危害与后果:由于同一名用户在“前测”和“后测”中保持着个体特质(比如重度用户前后活跃度都很高,轻度用户前后都较低),这种用户固有的个体间变异(Between-Subject Variance)会被错误地计入独立样本的误差项中,导致分母上的标准误(Standard Error)被大幅放大,使得本应显著的实验效果变得“不显著”(严重丧失统计检验力)。正确的做法是使用 stats.ttest_rel,通过差值计算直接对消掉每个个体固有的基线差异。
陷阱 2:把“匹配配对设计”强行拆成“独立样本”
错误表现:在生物医药或心理学研究中,研究者采用“配对分流”(按年龄、性别、基线指标1:1严格匹配),但分析时却使用了独立样本t检验。
纠正规则:只要实验设计阶段存在人工配对或自然绑定的对应关系,必须严格按照配对对数提取差值序列进行配对t检验。
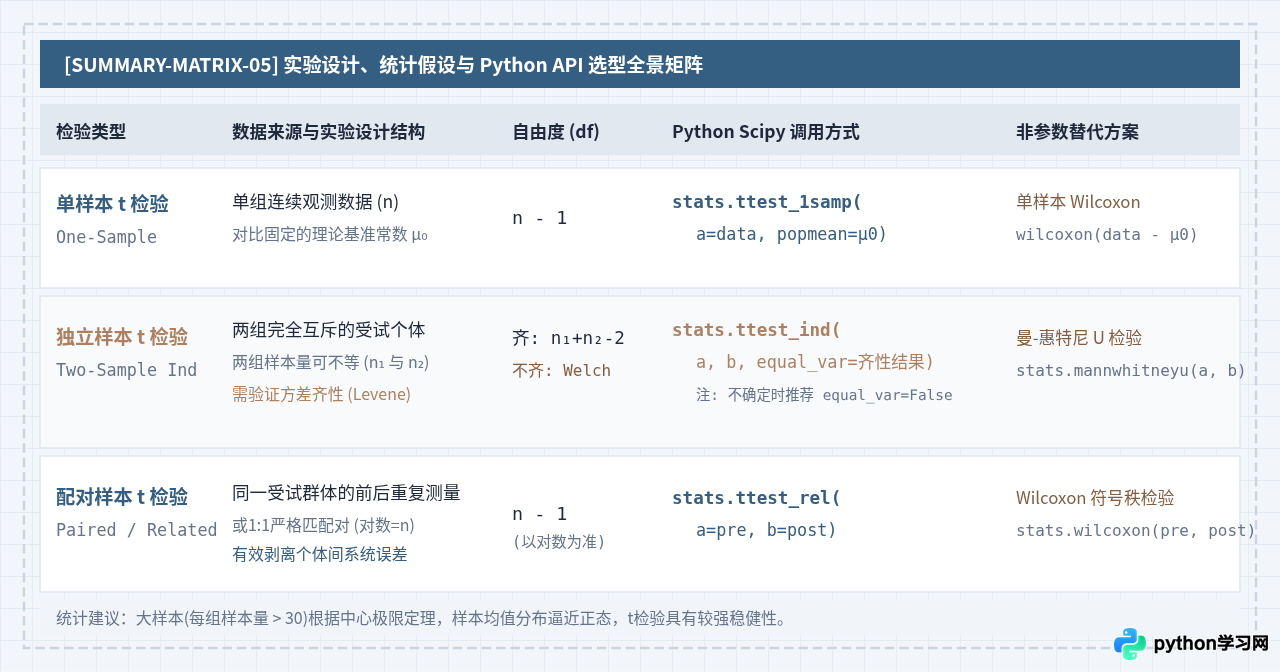
六、总结与快速决策清单
准确选择t检验并不依赖复杂的记忆,只需在动手编写代码前向自己确认以下三个核心问题:
- 比较的靶标是什么?如果只有一组样本,需要和已知的理论标准值对比,立即选用
scipy.stats.ttest_1samp。 - 两组数据是否有联系?如果数据来自完全独立随机分组的不同受试对象,选用
scipy.stats.ttest_ind,并配合scipy.stats.levene检查方差齐性(若方差不齐务必设置equal_var=False);如果是同一个体的前后测或严格匹配对,则选用scipy.stats.ttest_rel。 - 数据是否满足前提?在小样本下运行
scipy.stats.shapiro,一旦严重偏态或出现极值,及时降级为对应的 Wilcoxon 或 Mann-Whitney U 等非参数检验方法。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















