


Python字符串切片实战:提取后缀与格式化文本
深入解析Python字符串切片机制,围绕文件后缀提取与文本格式化两大实战场景,提供清晰的坐标映射、完整代码示例、边界防御策略与全套内联矢量图解。
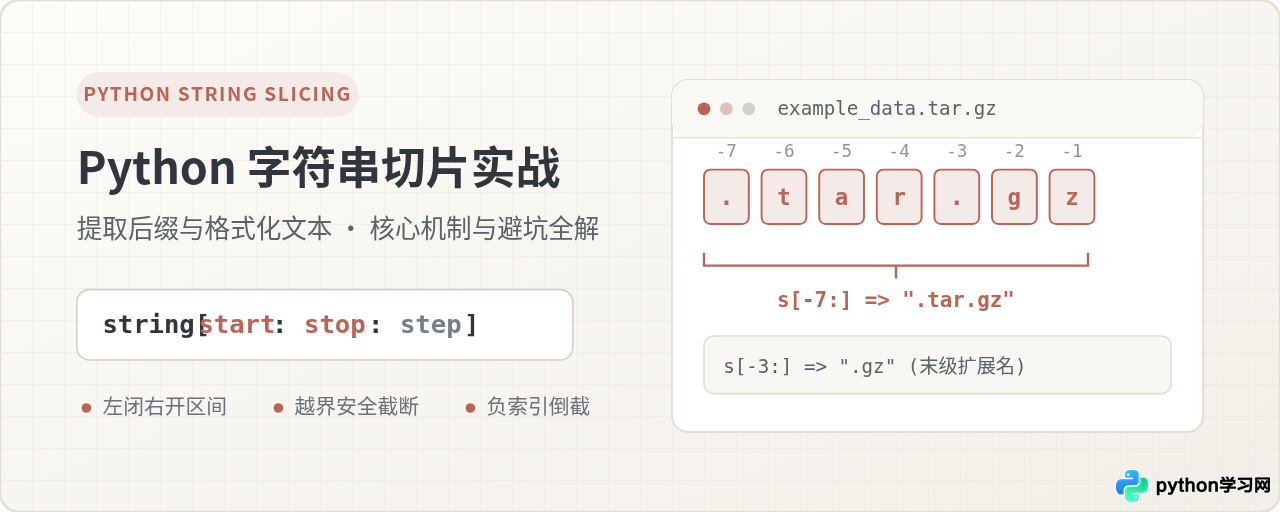
一、字符串切片的核心机制与坐标模型
Python 字符串属于不可变序列(Immutable Sequence)。切片操作允许我们以 string[start:stop:step] 的形式从原字符串中按指定区间和步长提取子序列。与单字符索引直接访问元素不同,切片在概念上更贴近于“沿字符之间的缝隙进行裁切”。
1. 双向索引与左闭右开区间
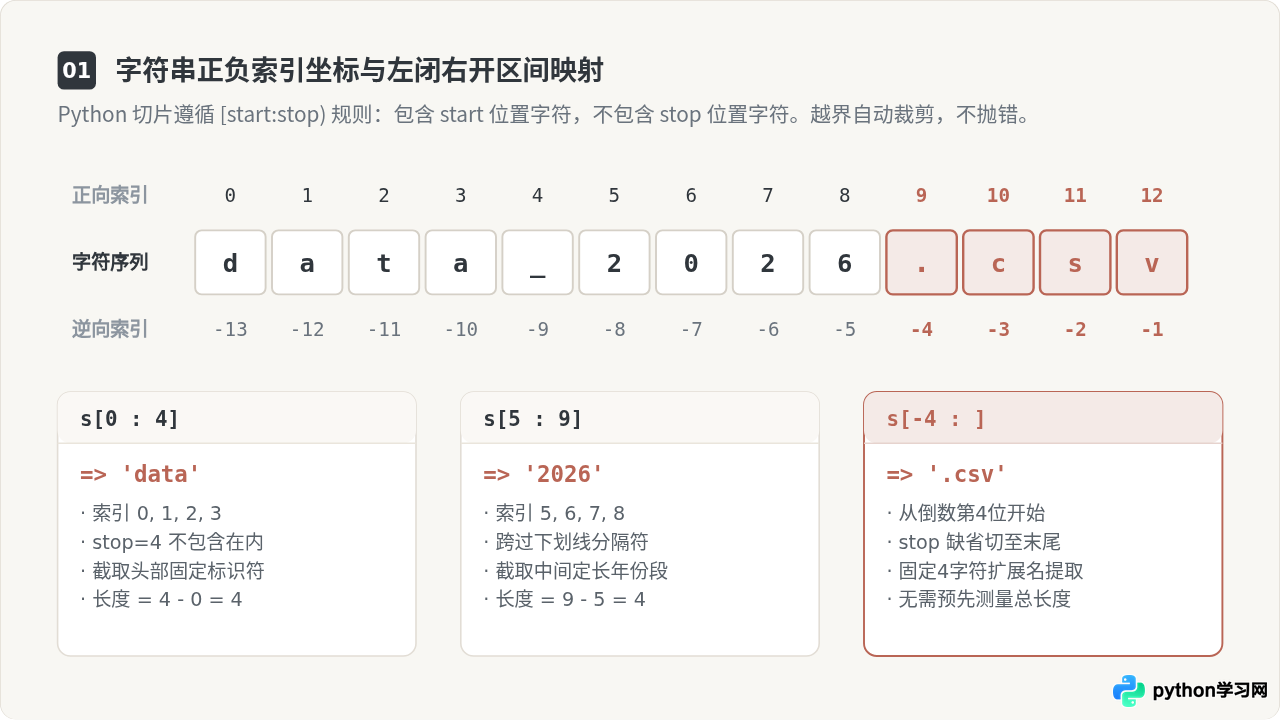
理解切片的第一原则是左闭右开(Half-open Interval):结果包含位置 start 处的字符,但严格不包含位置 stop 处的字符。这种设计的最大优势在于:切片截取的字符总数恒等于 stop - start(在步长为 1 的情况下),且两个相邻区间 s[:k] 与 s[k:] 能够无缝拼接复原整个原字符串。
同时,Python 为字符串提供了双向索引支持:从前往后的正向索引以 0 为起点,从后往前的逆向索引以 -1 表示最后一个字符。负索引消除了“必须预先调用 len() 计算长度再倒推偏移”的冗长代码。
2. 越界保护机制:切片与单索引的关键分水岭
初学者最容易产生困惑的边界问题是:为什么直接访问超出范围的下标会报错,而切片却不会?这是 Python 语言层面的设计区分:
- 单索引访问
s[index]:要求该索引必须真实存在于当前序列中。一旦index >= len(s),Python 立即抛出IndexError: string index out of range。 - 区间切片
s[start:stop]:遵循容错裁剪规则。无论start或stop多大或多小,Python 会自动将其限制在[0, len(s)]的有效区间内。当切片范围完全位于字符串之外或起止反向时,静默返回空字符串""。
# 演示切片的容错裁剪特性
text = "python"

# 1. 单字符索引越界 -> 触发异常
# print(text[100])  # IndexError: string index out of range

# 2. 切片越界 -> 自动截取至末尾,绝不抛出异常
safe_chunk = text[2:100]
print(f"安全切片结果: '{safe_chunk}'")

# 3. 完全超出范围 -> 静默返回空字符串
empty_chunk = text[100:200]
print(f"超出范围结果: '{empty_chunk}'")超出范围结果: ''
二、实战场景一:提取文件后缀与扩展名
在处理批量上传文件、数据转换或静态资源归档时,准确提取后缀名是前置文件分类的前提。针对不同复杂度、命名规范的文件,我们需要选择匹配的切片策略。
1. 已知格式的定长倒序切片
在特定业务流水线中,如果输入来源已经过前置过滤(例如系统限定仅接收 .csv 或 .png 文件),可以直接利用负索引切片截取固定长度的末尾字符串。
filename = "report_q3_final.csv"

# 截取倒数第4位至末尾(包含点)
ext_with_dot = filename[-4:]

# 截取倒数第3位至末尾(不包含点)
ext_pure = filename[-3:]

print(f"带点后缀: {ext_with_dot}")
print(f"纯后缀: {ext_pure}")纯后缀: csv
filename[-4:] 仅在后缀长度恒定为 4(如 .jpg, .csv, .png)时可靠。遇到 .jpeg、.html 或多级扩展名 .tar.gz 时会截断错误,因此通用场景必须配合动态分隔符定位。
2. 动态分隔符定位与安全切片封装
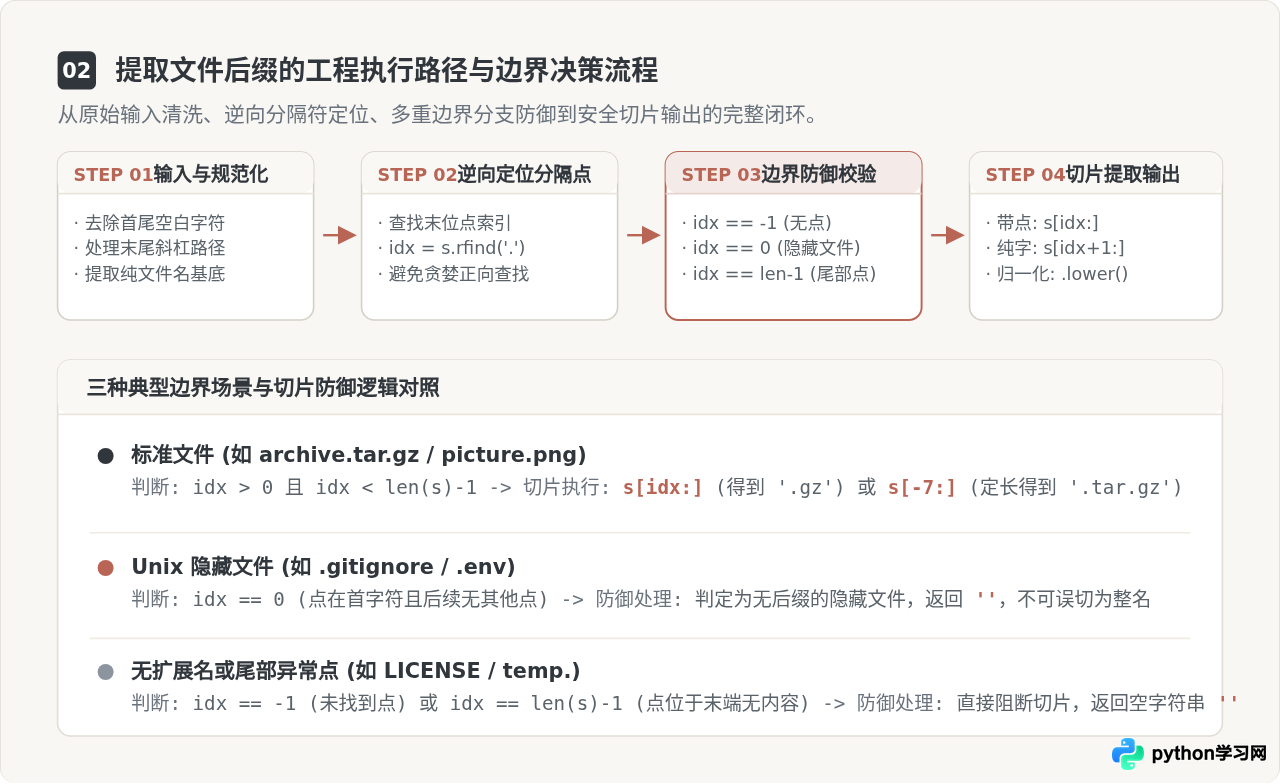
通用的后缀提取应当通过 rfind('.') 从右向左搜寻最后一个点的位置。在此基础上,必须对三种特殊边界进行防御:
- 完全无点文件:如
LICENSE、Makefile,rfind返回-1,应直接返回空字符串。 - Unix 隐藏文件:如
.gitignore、.env,点出现在首位(index == 0),本质上是文件名本身而非扩展名,应返回空字符串。 - 末尾悬挂点:如
temp.,点出现在末尾(index == len(s) - 1),切片无有效后缀字符,应返回空字符串。
def get_file_extension(filename: str, keep_dot: bool = True) -> str:
    """安全提取文件名后缀,充分防御各类边界情况。"""
    # 1. 规范化清洗首尾空白
    clean_name = filename.strip()

    # 2. 逆向定位最后一个句点的位置
    dot_index = clean_name.rfind('.')

    # 3. 边界防御:无点、点在首位(隐藏文件)、点在末端
    if dot_index == -1 or dot_index == 0 or dot_index == len(clean_name) - 1:
        return ""

    # 4. 根据入参决定是否保留句点
    return clean_name[dot_index:] if keep_dot else clean_name[dot_index + 1:]

# 针对多种典型文件名进行测试
test_cases = [
    "analysis.xlsx",
    "web_page.final.html",
    "archive.tar.gz",
    ".gitignore",
    "README",
    "backup."
]

for item in test_cases:
    ext = get_file_extension(item, keep_dot=True)
print(f"文件名: {item:<22} => 提取后缀: '{ext}'")文件名: web_page.final.html => 提取后缀: '.html'
文件名: archive.tar.gz => 提取后缀: '.gz'
文件名: .gitignore => 提取后缀: ''
文件名: README => 提取后缀: ''
文件名: backup. => 提取后缀: ''
三、实战场景二:文本截断、格式化与数据脱敏
字符串切片不仅用于“拆解”,更是各种文本重塑与排版组合的核心原语。下面针对生产中最典型的四类文本格式化需求逐一解析。
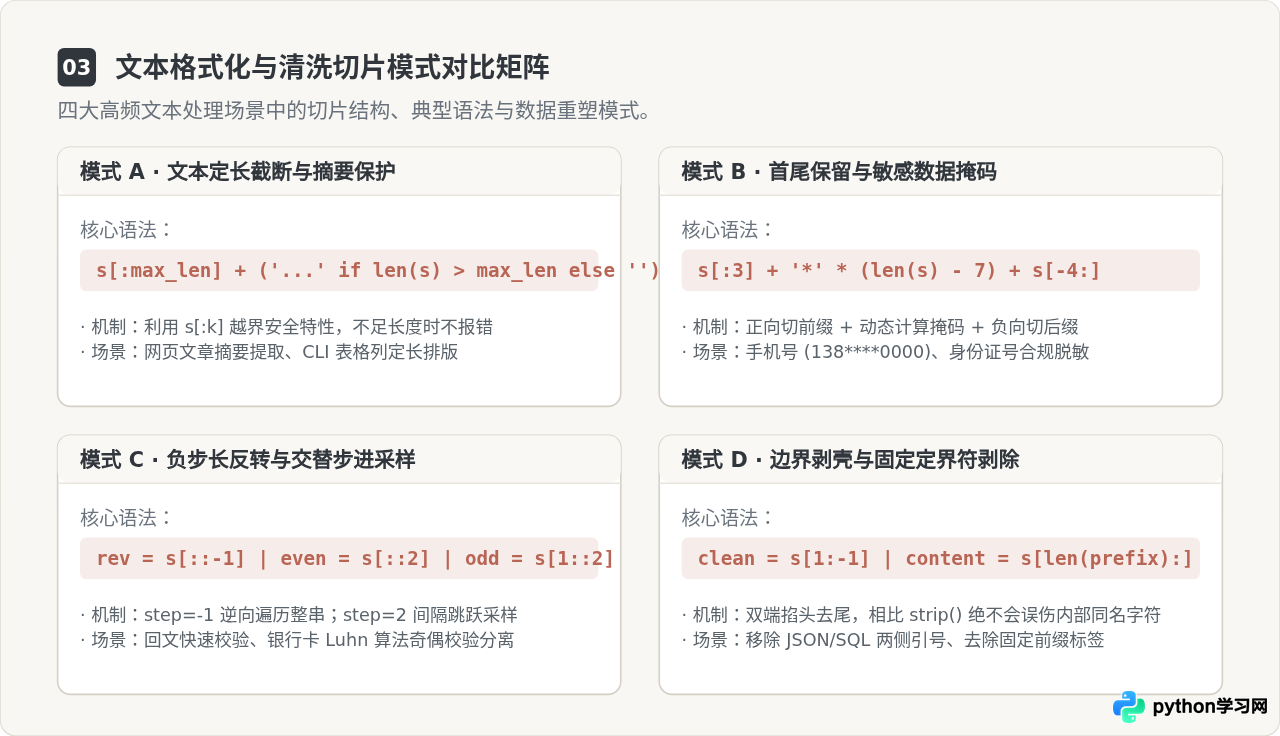
1. 摘要定长截断与省略号拼合
在界面展示或控制台列表排版时,固定宽度的文本截取不可避免。切片的右边界超出保护使截取逻辑极其清爽:不需要显式截取循环,仅需比对长度决定是否追加缩略标志。
def truncate_text(text: str, max_chars: int = 20, ellipsis: str = "...") -> str:
    """对超长文本进行定长截断并安全拼合省略符。"""
    if len(text) <= max_chars:
        return text
    # 扣除省略符长度后进行切片截取
    cut_length = max(0, max_chars - len(ellipsis))
    return text[:cut_length] + ellipsis

title_a = "Python切片入门"
title_b = "Python高阶特性深入剖析:字符串切片与内存视图优化"

print(truncate_text(title_a, 20))
print(truncate_text(title_b, 20))Python高阶特性深入剖析:字符...
2. 敏感信息脱敏(首尾切片与掩码重组)
依据合规要求,手机号、身份证号、银行卡号等信息往往需要部分打码后呈现。结合正向切片提取保留前缀、负向切片提取保留后缀,中间通过计算字符差动态填充掩码,即可写出鲁棒的脱敏函数。
def mask_sensitive_data(val: str, prefix_len: int = 3, suffix_len: int = 4, mask_char: str = "*") -> str:
    """保留指定首尾位数的通用数据脱敏处理。"""
    total_len = len(val)
    # 若总长度不足以保留首尾,直接返回全掩码保护数据
    if total_len <= prefix_len + suffix_len:
        return mask_char * total_len

    mask_count = total_len - prefix_len - suffix_len
    return val[:prefix_len] + (mask_char * mask_count) + val[-suffix_len:]

phone = "13800138000"
id_card = "110101199003072345"

print("脱敏手机号:", mask_sensitive_data(phone, 3, 4))
print("脱敏身份证:", mask_sensitive_data(id_card, 4, 4))脱敏身份证: 1101**********2345
3. 步长 step 高级技巧:逆序反转与交替采样
切片的第三个参数 step 控制取值方向与跨度。当 step 为负数时,提取方向从右向左:
s[::-1]:实现整串反转,常用于回文字符串检验或特定倒序校验码生成。s[::2]与s[1::2]:分别提取所有偶数索引位与奇数索引位字符。
word = "level"
is_palindrome = (word == word[::-1])
print(f"单词 '{word}' 是否回文: {is_palindrome}")

# 提取奇偶位序列
code_str = "A1B2C3D4"
letters = code_str[0::2]  # 从 0 开始,步长为 2
digits = code_str[1::2]   # 从 1 开始,步长为 2

print(f"偶数位字母: {letters}, 奇数位数字: {digits}")偶数位字母: ABCD, 奇数位数字: 1234
4. 定长结构剥壳:剥离引号与协议头
在清洗 CSV 字段、JSON 文本或日志键值时,经常需要剥除被引号包围的外壳(如 "content"),或剥除固定的协议前缀(如 http://)。
使用切片 s[1:-1] 能精准剥除两端各 1 个字符。相比 s.strip('"'),切片绝不会误伤内容内部的同名字符(例如内部合法的转义引号 "a"b")。
# 场景:精准去引号(仅移除首尾定界符)
raw_token = '"auth_bearer_token"'
clean_token = raw_token[1:-1] if raw_token.startswith('"') and raw_token.endswith('"') else raw_token
print("剥离后 Token:", clean_token)

# 场景:固定前缀安全切除
url = "https://internal.service.io"
prefix = "https://"
clean_host = url[len(prefix):] if url.startswith(prefix) else url
print("剥离协议头后域名:", clean_host)剥离协议头后域名: internal.service.io
四、避坑指南、底层机制与选型对比
虽然切片语法直观,但在不同数据规模与复杂工程体系下,掌握其底层行为与边界陷阱是写出高可靠代码的必备素养。
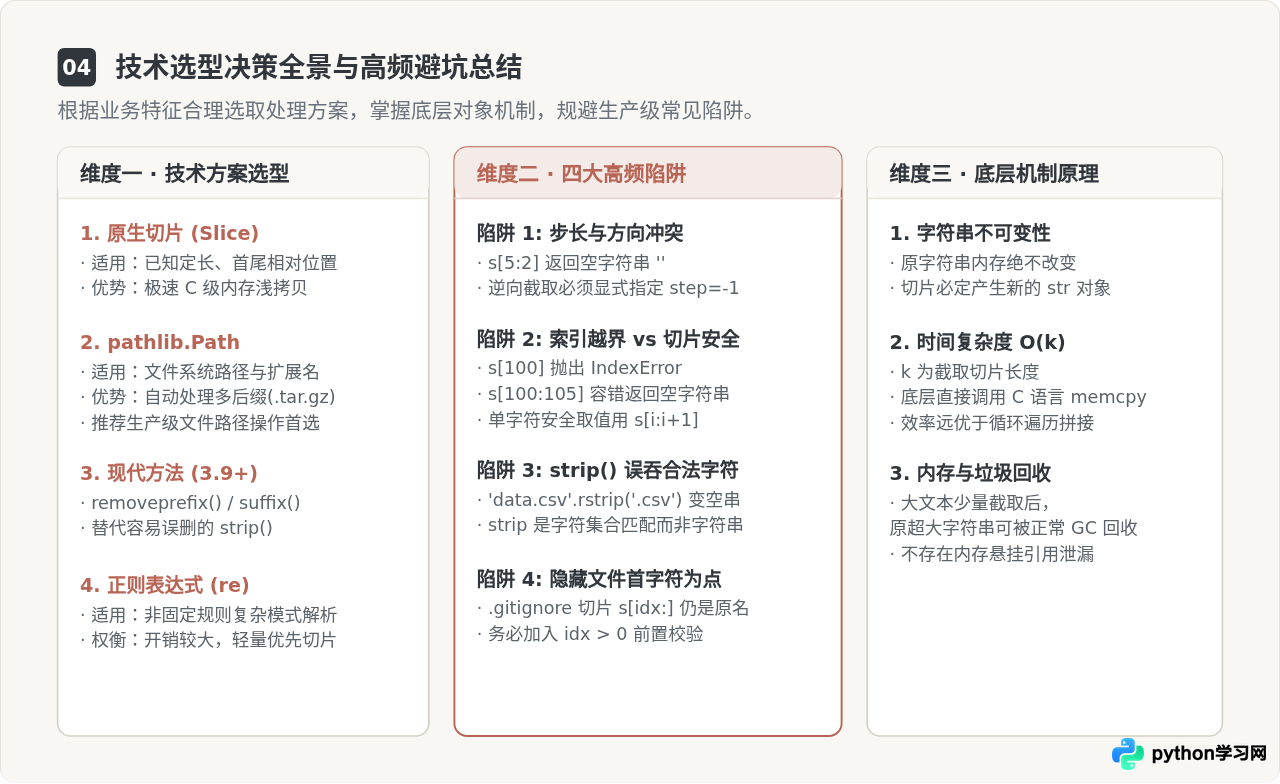
1. 常见陷阱与防范
| 陷阱类型 | 典型错误代码 | 实际运行表现 | 根本原因与正确解法 |
|---|---|---|---|
| 步长方向矛盾 | s[5:2] |
得到空字符串 "" |
默认 step=+1 向右搜寻,但 stop 小于 start;倒序提取必须声明 s[5:2:-1]。 |
| strip() 误吞字符 | "data.csv".rstrip(".csv") |
得到 "dat"(丢失 'a') |
strip 参数为字符集而非字符串模式,'a' 包含在匹配集合中。应使用切片或 removesuffix。 |
| 隐藏文件误判 | ".bashrc"[s.rfind('.'):] |
误提取出 ".bashrc" |
点位于首位被当成了扩展名。必须判断 dot_index > 0。 |
| 多重后缀漏提 | "node.tar.gz"[s.rfind('.'):] |
仅提取到 ".gz" |
单点截取无法感知打包复合格式。复合后缀需结合特定扩展名白名单或 pathlib。 |
2. 底层性能与内存拷贝原理
在 CPython 的底层实现中,字符串对象(PyUnicodeObject)是内存连续存储的字节数组。每次执行切片 s[start:stop] 时,CPython 并不会在原地修改原字符串,而是通过 C 语言级别的 memcpy 将指定内存段快速拷贝至一个新分配的 PyUnicodeObject 中。
- 时间复杂度:提取长度为
k的子串,时间复杂度为严格的O(k)。由于无需在 Python 解释器层循环逐字处理,其性能表现远高于列表追加或拼接。 - 内存回收独立性:切片产生的是全新对象。如果在超大文本(例如 500MB 的日志内容)中仅切片截取了前 100 字节,只要原始的大字符串引用被解除,500MB 的内存即可被 Python 垃圾回收器(GC)完整释放,不会因少量残留切片而造成长期的内存驻留。
3. 工具选型决策建议
在实际项目架构中,并非所有字符串提取都必须使用切片。应根据场景灵活搭配:
- 固定相对偏移与已知结构:优先使用原生切片(如
s[:3]、s[-4:]),语法最简练,执行效率最高。 - 本地文件路径解析:生产环境中强烈推荐使用标准库
pathlib.Path(如Path(p).suffix与Path(p).suffixes),它能原生跨平台兼容 Windows 反斜杠与 Linux 正斜杠,并完美识别.tar.gz复合后缀。 - 确定前缀/后缀剥离:Python 3.9+ 推荐优先使用
removeprefix()/removesuffix(),其语义明确且不会误伤内部字符。 - 复杂多变模式提取:涉及多种可选分隔符、动态数字规则时,使用
re(正则表达式)模块进行模式匹配。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















