


Python机器学习常用第三方库入门:TensorFlow与PyTorch区别
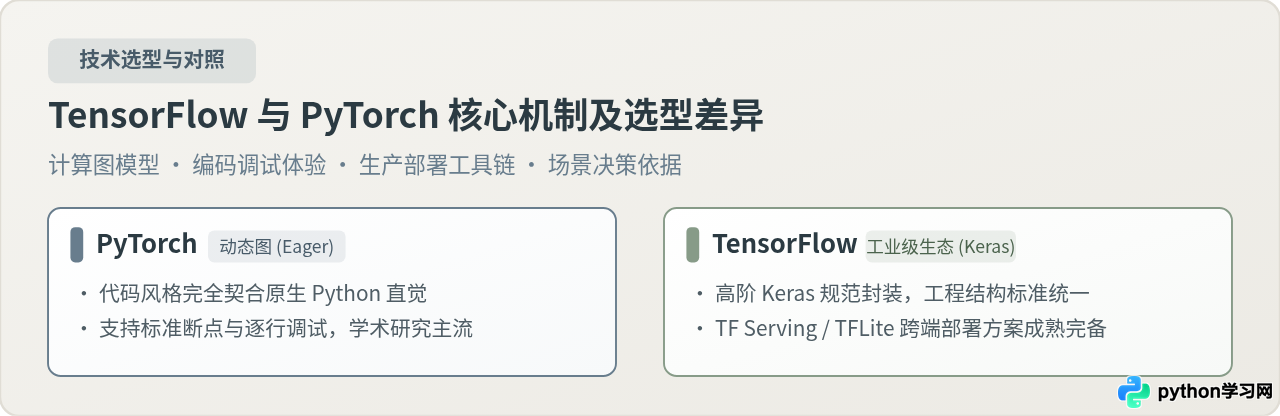
本文系统解析Python机器学习核心库TensorFlow与PyTorch的本质区别,从底层计算图机制、编码调试直觉、生产部署生态到选型建议,提供具体步骤、完整代码对照与避坑要点。
@tf.function),拥有从服务器高并发到移动嵌入式端开箱即用的完整部署工具链。理解这两个库的底层机制差异与编码工作流,能够帮助开发者根据具体场景准确选型。
一、核心计算图机制:动态图与静态追踪的运作差异
深度学习框架的核心职责是管理张量运算,并在前向传播过程中记录计算依赖,以便通过反向传播算法自动求解梯度。在处理这个核心任务时,PyTorch 与 TensorFlow 采取了不同的技术路径。
PyTorch 从设计之初就坚持动态计算图(Define-by-Run)范式。当 Python 解释器执行到某行张量算子时,系统会立即在底层 C++ 端完成该算子的数值求值,同时将该运算节点动态挂载到内存中的计算图里。前向传播结束后,调用 loss.backward() 沿该临时图反向传导梯度,随后图结构被销毁。这意味着每次迭代循环都可以自由重构网络结构,支持任意原生的 Python if 分支与 while 循环,开发者可以在任意行插入 print() 或直接借助 Python 原生调试器 pdb 检查张量内容。
TensorFlow 在 1.x 时代采用纯粹的静态计算图(Define-and-Run),必须先在 Python 中完成整个符号网络的拓扑搭建,编译冻结为图结构后,再将数据塞入会话(Session)中运行。TensorFlow 2.x 全面引入了即时执行(Eager Execution)作为默认模式,大幅降低了日常编码门槛。但在需要极致性能和生产导出时,TensorFlow 依赖 @tf.function 装饰器进行计算图追踪(Tracing)。Python 代码仅在初次调用或参数类型变化时被执行一次,随后被转换编译为静态计算图,并交由底层 C++ 引擎运行。这种方式赋予了模型极高的序列化优化空间,但图追踪模式下无法直接使用常规的 Python 断点和动态变长逻辑。
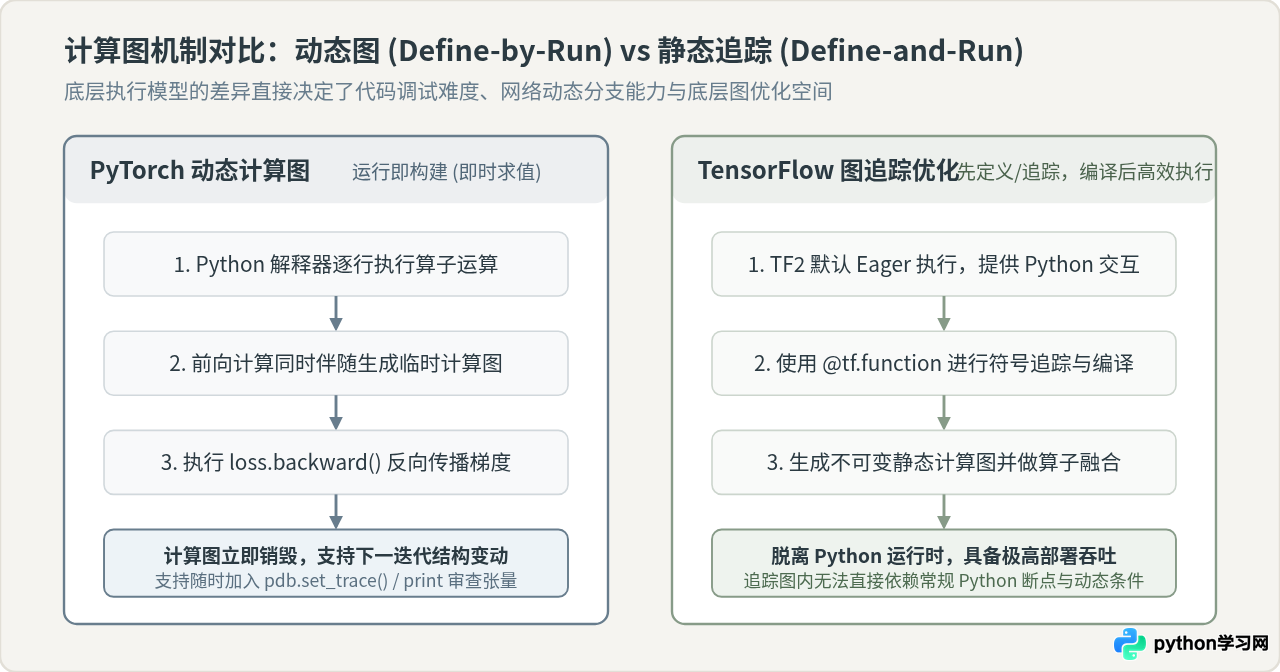
@tf.function 包装训练步骤时,如果在函数内部写入了标准的 print(),该语句只会在图构建追踪(Tracing)阶段打印一次,后续执行编译图时将不会输出任何内容。若需要在运行期观测中间张量,必须使用专门的 tf.print() 算子。而在 PyTorch 中,原生 print() 在每个迭代步都会如实输出。
二、基础语法与典型模型开发流程对照
为了直观展现两者在实际代码组织上的差异,我们以一个标准的“单层线性回归(拟合线性函数 $y = 2x + 1$)”为例,对比二者在张量初始化、模型定义和训练循环中的具体语法实现。
1. 张量构建与自动微分对比
在张量创建与梯度追踪的声明方式上,两者存在细微但直接的区别:
PyTorch 张量与梯度追踪示例:
import torch

# 创建输入张量,指定 requires_grad=True 以追踪梯度
x = torch.tensor([2.0], requires_grad=True)

# 定义前向运算 y = x^2 + 3x + 1
y = x ** 2 + 3 * x + 1

# 触发反向传播计算 dy/dx
y.backward()

# 查看梯度数值(理论值: 2x + 3 = 2*2 + 3 = 7)
print(f"PyTorch 计算梯度 dy/dx: {x.grad.item()}")TensorFlow 张量与 GradientTape 示例:
import tensorflow as tf

# 创建输入张量
x = tf.Variable(2.0)

# 使用上下文管理器显式记录操作梯度
with tf.GradientTape() as tape:
    y = x ** 2 + 3 * x + 1

# 显式求解 y 对 x 的偏导数
grad = tape.gradient(y, x)
print(f"TensorFlow 计算梯度 dy/dx: {grad.numpy()}")2. 典型网络构建与训练执行步骤
在网络构建与训练的宏观流程上,两者遵循一致的五个核心阶段,但在代码风格上表现出“显式过程控制”与“高度封装装配”的明显分歧。
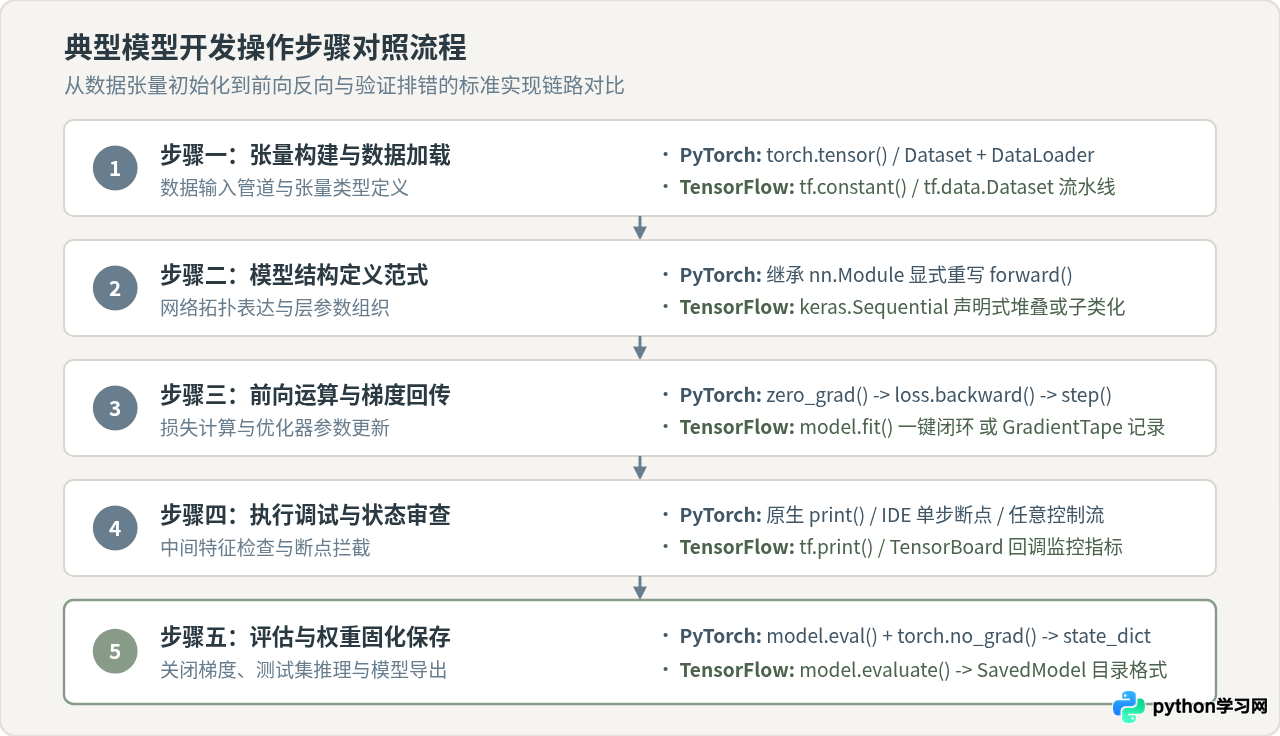
以下是在相同数据条件下,构建可运行线性回归模型的完整实现对照:
PyTorch 完整模型构建与显式训练循环(必须显式清空梯度与执行单步优化):
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 准备合成训练数据
X_train = torch.tensor([[1.0], [2.0], [3.0], [4.0]], dtype=torch.float32)
y_train = torch.tensor([[3.0], [5.0], [7.0], [9.0]], dtype=torch.float32)

# 2. 定义模型:继承 nn.Module 并重写 forward 方法
class LinearRegressionModel(nn.Module):
    def __init__(self):
        super(LinearRegressionModel, self).__init__()
        self.linear = nn.Linear(in_features=1, out_features=1)

    def forward(self, x):
        return self.linear(x)

model = LinearRegressionModel()
criterion = nn.MSELoss()
optimizer = optim.SGD(model.parameters(), lr=0.05)

# 3. 显式训练循环
for epoch in range(100):
    model.train()
    optimizer.zero_grad()       # 关键步骤:清空历史累计梯度
    predictions = model(X_train) # 前向计算
    loss = criterion(predictions, y_train)
    loss.backward()             # 反向传播计算各权重梯度
    optimizer.step()            # 根据梯度更新权重

# 4. 验证与测试
model.eval()
with torch.no_grad():
    test_x = torch.tensor([[5.0]])
    pred = model(test_x)
print(f"PyTorch 预测 x=5 时 y 的值: {pred.item():.2f}")TensorFlow Keras 声明式组装与高阶拟合(一键调用内置生命周期):
import tensorflow as tf
from tensorflow import keras
from tensorflow.keras import layers

# 1. 准备合成训练数据
X_train = tf.constant([[1.0], [2.0], [3.0], [4.0]], dtype=tf.float32)
y_train = tf.constant([[3.0], [5.0], [7.0], [9.0]], dtype=tf.float32)

# 2. 声明式堆叠模型结构
model = keras.Sequential([
    layers.Dense(units=1, input_shape=(1,))
])

# 3. 编译配置损失函数与优化算法
model.compile(optimizer=keras.optimizers.SGD(learning_rate=0.05),
              loss='mean_squared_error')

# 4. 启动拟合循环(内置数据批次流转与梯度更新)
model.fit(X_train, y_train, epochs=100, verbose=0)

# 5. 验证与测试
test_x = tf.constant([[5.0]])
pred = model.predict(test_x, verbose=0)
print(f"TensorFlow 预测 x=5 时 y 的值: {pred[0][0]:.2f}")zero_grad()、求导 backward()、参数步进 step())都必须由开发者按序显式编写,这种机制虽然代码量略多,但便于随时在任意阶段注入对抗扰动、梯度裁剪或自定义损失权重;TensorFlow Keras 提供了高度工业化的 model.compile() 与 model.fit(),开箱即用度极高,同时也支持通过 tf.GradientTape 编写与 PyTorch 风格完全类似的自定义训练循环。
三、生态系统与工业部署工具链差异
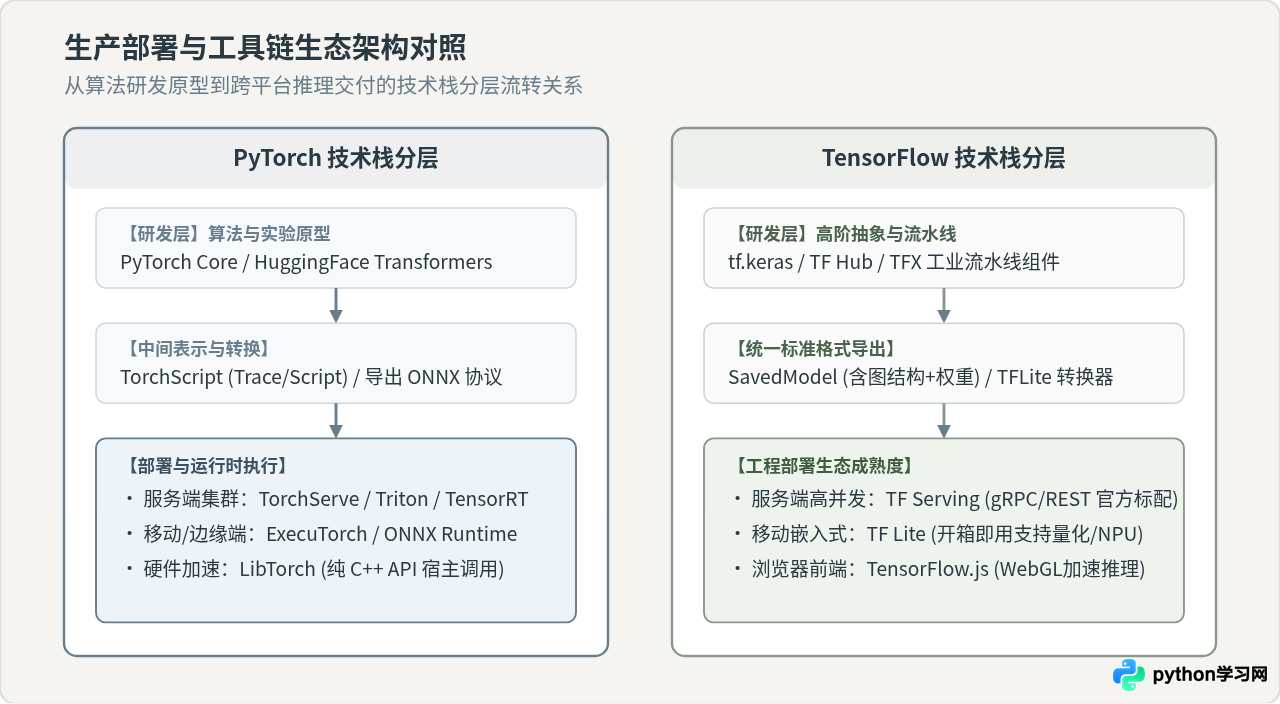
在算法原型开发完毕后,如何将模型交付至线上生产环境(如高并发微服务、移动应用 App、边缘计算设备),是衡量机器学习框架实用价值的关键维度。在这个环节,两个框架展现出截然不同的生态侧重。
1. TensorFlow 的工业工程体系
TensorFlow 在工业部署领域的积累非常深厚,其技术体系以标准化格式 SavedModel 为核心枢纽:
- TensorFlow Serving:基于 C++ 编写的高性能推理服务框架,原生支持模型版本热加载、批处理请求聚合(Dynamic Batching)、gRPC 与 RESTful 双协议接口,能够在无需 Python 运行时的环境下承载每秒数万次的生产推理请求。
- TensorFlow Lite (TFLite):专为 Android、iOS 和嵌入式 Linux 设计的超轻量推理引擎,具备完善的模型量化工具包(可直接将 FP32 模型量化为 INT8 格式,体积缩减 75%),并能深度调用手机端的 NPU 与 GPU 硬件加速。
- TensorFlow.js:支持直接在浏览器页面中通过 WebGL 加速运行机器学习模型,实现纯前端的零后端依赖交互体验。
2. PyTorch 的工程进化与部署方案
PyTorch 早期曾因强依赖 Python 解释器而受到工业部署便利性的诟病。随着版本演进,PyTorch 建立了一套立体的部署方案:
- TorchScript (JIT):通过代码跟踪(Tracing)或脚本编译(Scripting),将 Python 定义的模型转换为与 Python 解耦的中间表示,可在纯 C++ 环境(LibTorch)中直接加载执行。
- ONNX 互操作性:PyTorch 对开放神经网络交换格式(ONNX)具备极佳的原生导出支持。在工业落地中,PyTorch 导出的 ONNX 模型常常作为通用桥梁,直接交由 NVIDIA TensorRT 或 ONNX Runtime 实现极致推理加速。
- ExecuTorch 与 TorchServe:近年来 PyTorch 推出了官方服务化框架 TorchServe,并发布了专攻移动端和边缘设备微控制器的 ExecuTorch,大幅弥补了在端侧嵌入式场景中的工程短板。
四、关键维度对比与初学者选型决策指南
为了让不同诉求的学习者明确选择方向,下表从语法直觉、调试难度、论文生态和部署成熟度四个核心维度对两库进行总结对比:
| 对比维度 | PyTorch | TensorFlow (2.x / Keras) |
|---|---|---|
| 计算图机制 | 原生 Define-by-Run 动态图,每次迭代即时构图 | 默认 Eager 即时执行,生产模式通过 @tf.function 编译静态图 |
| 代码风格 | 高度 Pythonic,类面向对象定义,显式训练循环 | Keras 标准化声明式堆叠为主,接口层次分明 |
| 代码调试排错 | 极佳。支持原生 pdb 断点与 print 逐行检查 |
基础模式易调试,涉及图编译追踪时报错堆栈复杂 |
| 学术论文与前沿生态 | 压倒性优势。顶会(CVPR、NeurIPS、ICLR)开源代码 80%+ 首选 | 成熟工业经典模型库丰富,但前沿最新论文复现率较低 |
| 生产部署与轻量化 | 依赖 TorchScript、ONNX 或 TensorRT 转换组合交付 | TF Serving、TFLite、TF.js 官方套件开箱即用,工具链平滑 |
| 适用人群画像 | 高校学生、算法研究员、需要理解底层原理与深度定制者 | 需要快速搭积木验证的工程师、专注于端侧与现有工业系统者 |
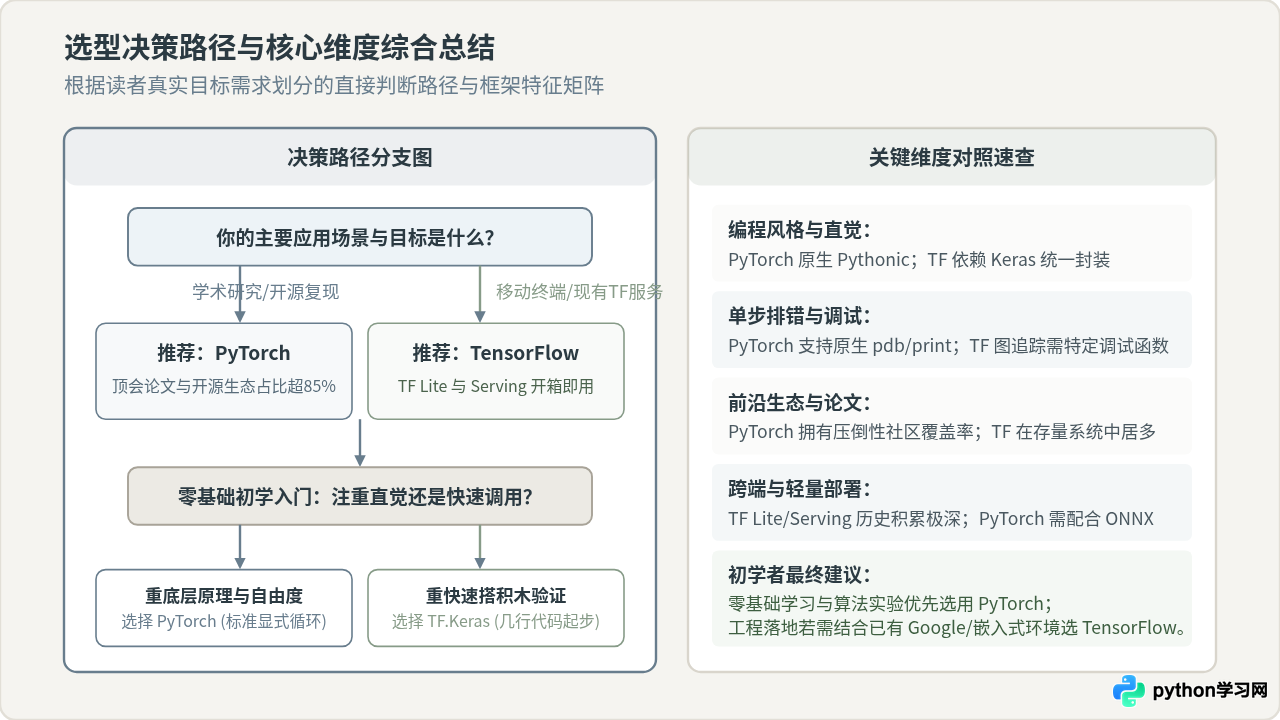
具体选型建议路径:
- 如果你是高校学生、科研工作者或算法岗求职者:直接首选 PyTorch。目前学术界几乎所有最新大语言模型(LLM)、计算机视觉和多模态工作(如 HuggingFace 开源生态)均基于 PyTorch 构建,熟悉 PyTorch 是阅读和复现前沿论文的必备基础。
- 如果你是纯零基础入门,希望用最少代码快速搭建模型做概念验证:建议从 TensorFlow 中的 tf.keras 入手。Keras 封装极其规范,十几行代码即可完成模型搭建、编译与拟合,不需要一开始就处理复杂的反向传播细节。
- 如果你的核心业务需要在手机端 App、单片机或树莓派等设备直接离线运行:优先考虑 TensorFlow (TFLite)。TFLite 在量化支持、文档案例和主流硬件适配方面的成熟度依然具有显著优势。
- 关于知识迁移:两者的核心概念(张量、通道顺序、学习率衰减、卷积与全连接层、反向传播)是 100% 通用的。只要在一个框架中扎实掌握了深度学习的运行本质,未来切换到另一个框架通常仅需几天查阅 API 手册的时间。
本站声明
本文内容仅供参考,不代表本站观点。转载或引用请注明出处。如发现内容问题,请通过联系我们页面反馈。















